ARTICLE · 1258958
代码一周发一版,文档全在仓库里——这不是进度,是风险
交付加速是好事。但当团队尝到 AI 辅助开发的甜头后,一个更隐蔽的问题开始露头——而它比写不出代码更致命。
你大概率见过这个景象:
项目跑了大半年,每周一版,CI 全绿,BDD 防线没崩。但某天你问业务方的同事“现在的系统长什么样”,对方想了半天,打开 3 个月前写的一版需求文档,指着其中的某个模块说,“大概吧”——
不对,不是大概,肯定不对。因为这三周迭代了三轮逻辑。
这不是个别团队的问题,它正在成为“AI 加速”模式下的新常态。
一、先看一个真实翻车现场
某产研团队在用上 Code Agent 工作流后,交付周期从三周缩到一周,Bug 率在 BDD 的保护下没显著上升——看上去一切正常。
但半年后回头看,系统里有四个看起来差不多、本质各异的实体:
产品 · 型号 · 物料 · 系列
这四个词一摆出来,任何一个后端工程师都知道完蛋了——数据结构层面的屎山已经长成了。它们彼此关联,但边界模糊,冗余字段横飞,谁都说不清“我该用哪个”。
但我想说的重点是:你没法用“迭代半年后的结果”来审判之前的每个决策。
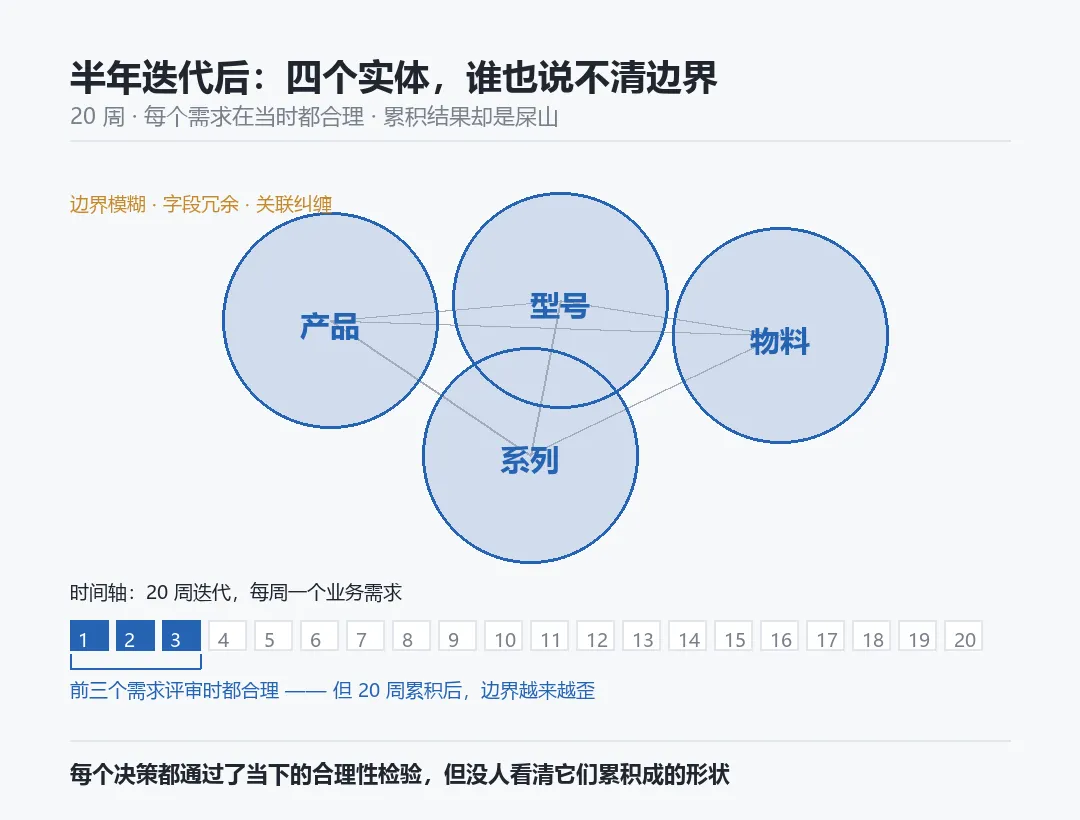
20 周的迭代链条里,每个业务需求在当时的场景下都有相当充分的合理性。第一次需要区分“产品”和“型号”是为了满足客户 A 的 SKU 管理;第二次加“物料”是因为供应链系统对接不得不另开一个实体;第三次“系列”是为了营销侧的打捆促销。单独看每一步,都对。
但累积 20 周之后,四个实体成了比“亲兄弟”还复杂的关系。这些年每个团队都经历过的事,大家心知肚明。
这就好比拿着今天的 K 线图回到半年前去炒股,人人都能当股神——“你当时怎么不买?”“早就告诉你要卖!”事后看全是机会,但身在其中每个决策都有你没看到的信息约束。
业务模糊是屎山工程的起点。Code Agent 不是屎山的制造者,它只是加速了这个过程。
二、文档也需要分“开发侧”和“业务侧”
说“写文档”太笼统。在企业级开发里,文档至少应该分两类:
一类是开发过程文档。包括 spec(规格说明)、intent(需求意图描述)、feature(BDD 测试基线)、业务配置文件(权限 / 角色 / 流程配置)。这类文档和代码一起进 git,AI 工具可以直接消费它来生成测试、辅助编码——这是目前行业热点集中砸资源的地方。
另一类是业务文档。或者叫“生产事实文档”。它不面向开发流程,而是面向业务人员:现在的模块有哪些?数据权限怎么分的?走什么流程?它本质上是用户手册的加强版——只是用户手册从来也没好好写过。
问题在于:Code Agent 时代之前,业务文档普遍写得不好但还能糊弄;现在一周一版,糊弄的空间没了。之前的 GJB / ISO 质量体系下还能塞一塞,现在直接交给 Code Agent 去“生成”业务文档,写出来的东西颗粒度先放一边,大量接口和操作是幻想出来的。
三、行业在忙什么——都在搞开发侧,没人管业务侧
如果你去看最近几家大厂发布的最佳实践:
OpenAI 的 Engineering Harness 思路——围绕开发过程做结构化编码;
https://openai.com/zh-Hans-CN/index/harness-engineering/
GitLab 的 Agent Principles——定义 Code Agent 的行为边界;
https://docs.gitlab.com/development/agent_principles/
GitHub 的 Spec-Kit——把 spec 变成可执行的开发输入;
https://github.github.com/spec-kit/
Microsoft 的 Spec-Driven Development——强调先写规范再写代码。
https://developer.microsoft.com/blog/spec-driven-development-ai-native-engineering/
它们的方向高度一致:让开发过程文档更规范、更结构化,让 Code Agent 更好用。
但回到业务侧,业务人员拿到的是一个 Harness Web 页面,或者继续在群里口头沟通。不是他们的错——是没有人把“系统现在的样子”用业务语言写给他们。
一轮接一轮,需求的业务质量越来越差。根因在这里。
四、我们的做法——让事实说话
这里简单说说我们正在做的事情,我们的业务核心系统基于Django 3.2。思路概括一句话:能基于事实生成的,就不要让人写。事实指的是代码本身、数据库表结构、路由声明、配置文件——这些不是观点,不应该被“描述”。
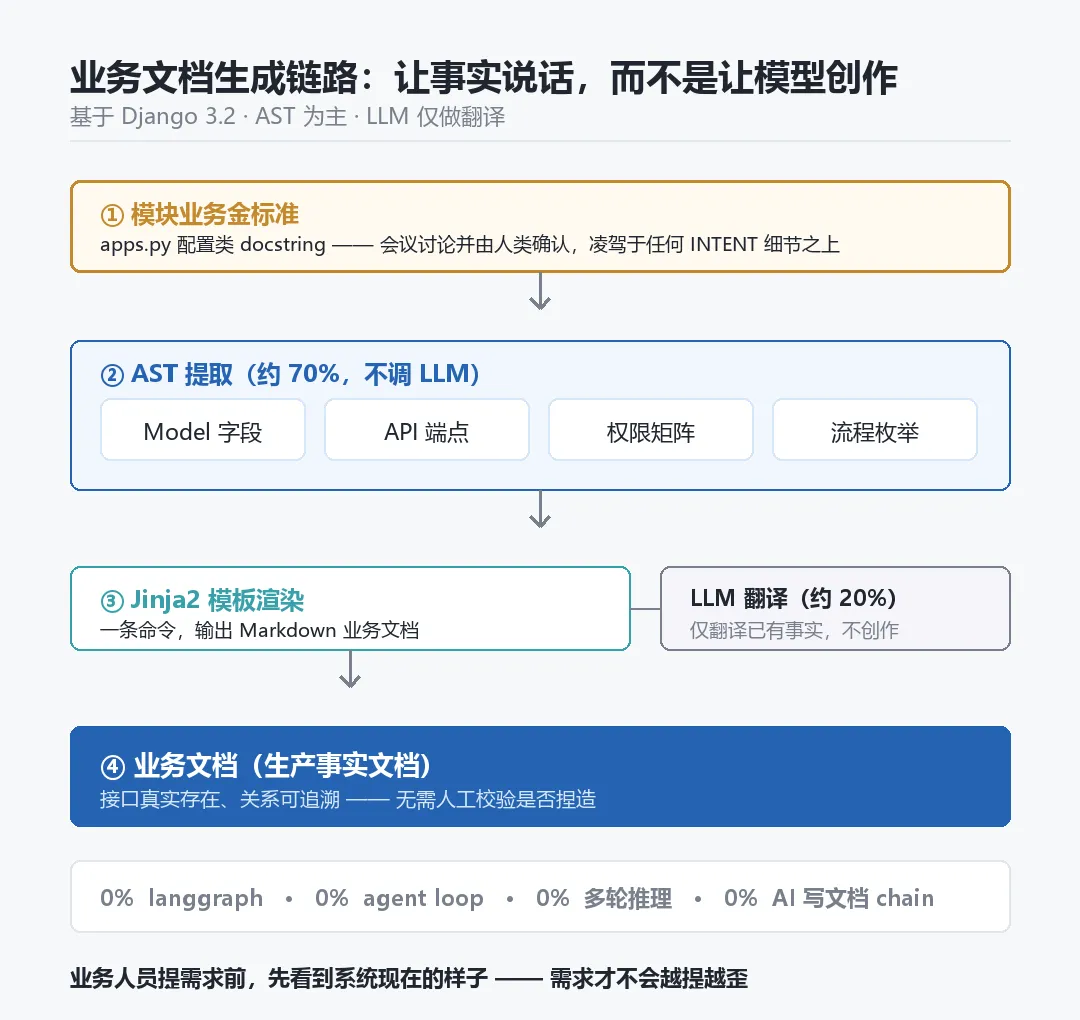
1. 基于 AST 直接生成的(占 70%):
先从模块描述开始。每个 Django app 的 apps.py 里都有一段落了 docstring 的配置类——这行 docstring 是团队在需求评审会上反复讨论、由人类确认过的模块核心宗旨。它定义了“这个模块到底是干什么的”,是凌驾于任何 INTENT 细节之上、开发侧和业务侧都必须对齐的业务金标准。
我们的生成链路第一件事,就是从 apps.py 的配置类中提取这条 docstring,放在该模块所有文档的最前面。无论下面有多少字段、接口、权限配置,阅读者在看任何细节之前,先看到一句话:这个模块的设计意图是什么。然后才是 AST 提取的结构性内容:
· Model 字段文档:用 Python 的 ast 模块解析 models.py,提取每个 model 的字段名、类型、help_text、verbose_name、choices、外键关系,直接按业务分类排列,输出 markdown 表格。
· API 端点清单:解析 urls.py 和 views 的 @action 装饰器,提取所有路由的 method(GET / POST / PUT / DELETE)和对应的 viewset 类名,自动聚合出“哪些模块暴露了哪些接口”。
· 权限与角色矩阵:解析配置文件中 Permission 和 Role 的定义,输出谁(角色)能做什么(module:action)。
· 流程枚举:解析 state_machine / status_field 的 choices 定义和状态迁移约束,生成“当前系统支持哪些流程节点、节点间允许哪些跳转”的描述。
所有这些都不调 LLM。AST 提取 + Jinja2 模板渲染,一条命令,出文档。
2. 调用了 LLM backend 的(约 20%):
· 已有 BDD feature 文件的摘要转换:把 gherkin 格式的 .feature 文件转述为人类可读的“系统功能列表”。这是传统用户手册的核心内容,与BDD测试中的e2e场景完全对齐,也就是我们端到端用BDD跑过什么,翻译成更易懂的业务语言,直接呈现出来。
· 字段语义增强:当 model 的 help_text 为空或过于简短时,将字段名 + 类型 + choices 组织成一条 prompt,调一次 LLM API 生成“面向业务人员的解释”。注意 LLM 的输入是 AST 提取的真实字段定义,不是凭空想象——它只做翻译,不做创作。
· 关系描述:对外键和 M2M 关系,LLM 用自然语言描述“这张表怎么关联到另一张”,例如“一个订单可以包含多个商品,一个商品属于一个店铺”。
3. 完全没有上的(目前 0%):
没有 langgraph / 没有 agent loop / 没有多轮推理 / 没有 AI 写文档 chain。
效果很好。生成的业务文档不需要人工校验“有没有捏造接口”——因为每个接口都是从 urlpatterns 和 views 中 AST 提取的,不存在幻想问题。LLM 的部分被严格限定在“翻译已有事实”的范畴,不承担“创作”职能。
有人可能会问:代码质量、测试基线、权限准确性——这些不是问题吗?
这里需要说清楚我们定位的前提。
代码质量、BDD feature 的完整性、权限数据的准确落地,这些是一年来所有企业级 Code Agent 工程工具和 Harness 工程的工作重点。我们假定这些已经做完了——或者至少,团队对此已经有成熟的流程来保证。
在我们的场景里,上述“产品 / 型号 / 物料 / 系列”的问题,并不是“业务需求被错误地实现了”——开发侧每次都正确地实现了业务方提的需求,CI 过的,测试绿的。问题在于:在多轮密集迭代中,业务需求本身越提越歪。
第一周说“需要区分产品和型号”,开发侧做对了。第二周说“再加一个物料属性”,也做对了。但到了第二十周回头看,当初的需求组合在一起,已经远远偏离了最初的业务模型。这就是“局部最优导致全局混乱”——每个决策都通过了当下的合理性检验,但没有人能从全局视角看清它们累积成的形状。
业务文档自动化的目的,就是在业务人员提需求这个环节,让他能准确看到系统现在的样子。看到目前已经有哪些实体、它们的边界是什么、各负责什么——这样他提出的“再加一个分类”就会变成“我知道已经有型号了,我需要的是型号下的一个子分组”,而不是又一个新实体。
文档不是帮开发侧写代码的,是帮业务侧别跑偏的。
五、文档自动化,不止是开发效率的事
回过头来想,我们讨论了 Code Agent 加速交付、开发过程文档跟上去了、但业务文档拖了后腿,然后我们在 Django 3.2 上实践了一套“基于 AST 和 LLM 翻译”的生成链路。
但这件事情的底层逻辑,似乎已经超出了传统 SDLC(系统开发生命周期)的范畴。
今天的 Claude Code、Codex、WorkBuddy——我猜到明年初这一轮 Agent 工具之争一定能分出胜负,开发侧的工具链最终会趋同,就像十年前的前端框架之争最终归到 React / Vue 两极一样。但一个系统从被交付到真正产生价值,开发和交付只占了半个环节。
更大的闭环是:业务方把需求输入系统 → 开发侧实现 → 系统上线 → 业务方使用并反馈 → 下一轮需求输入。在这个完整的闭环里,“业务侧的输入和使用”才是循环的基础动力。而要让这个循环健康运转,业务文档——准确、实时、可读的生产事实描述——就是那个不可或缺的“知识接口”。
有意思的是,这件事很可能很难产品化。每个企业级系统的业务模型、权限粒度、流程定义都不同,没有一套通用的“业务文档生成器”能安装即用。它更可能是一个服务形态的东西——深度嵌入某个行业的实施流程,由熟悉该领域的人配合自动化工具来交付。
但无论最终形态是什么,业务文档自动化一定是未来几年企业数字化和智能化建设的核心议题之一。因为 AI 加速的是“做”的速度,而文档决定的是“做对”的概率。后者正在从前者的影子中走出来,成为一个独立的价值命题。
如果你们的团队也踩过“四个实体说不清”的坑,欢迎在留言区说说你们是怎么处理的。