ARTICLE · 1269182
走向高效可信的文档智能|MiniCPM家族首个OCR系列模型发布并开源
合同、票据、病历、论文、档案——世界上相当一部分知识,至今仍沉淀在纸张与图像里。OCR 是把它们“唤醒”的技术,也是大模型走进千行百业的第一道入口。
但这项发展了几十年的技术,至今仍有两个没有被真正解决的缺口:一是效率——在法律、金融、政务这些对数据隐私高度敏感的场景里,模型不仅要在端侧本地跑起来,还要在有限算力下跑得又快又准;二是信任——评测基准上的高分是宏观平均分,它无法担保任何一份具体文档的解析结果没有差错,于是“人工逐页核验”这个最耗时的人力环节,始终无法从流程里拿掉。
今天,面壁智能正式发布并开源首个面向高效文档解析与文字识别的 MiniCPM-OCR 系列模型:
MiniCPM-OCR 1.0(1.3B):MiniCPM 家族首个 OCR 专用模型,在 Real5-OmniDocBench 与 OCRBench v2 两项基准上取得双 SOTA,处理效率同步领先;
MiniCPM-OCR Jev(2B):业内首个 OCR 解析结果判别决策模型,专门判断“解析结果到底可不可信”。
MiniCPM-OCR系列概览视频
在此,我们想完整回答五个问题:
为什么做这件事?
做到了什么水平?
是怎么做到的?
真实场景如何?
以及,下一步去哪里。
01 为什么:使命指向的那块“硬骨头”
面壁智能的品牌使命是“让智能融入每个产业、装进每个终端、惠及每个人”,定位是“专注高效智能的基座大模型公司”。这句话不是墙上的标语,它直接决定了我们的研究选择和投入方向:不打参数规模的军备竞赛,而是在有限的算力与体积里追求更高的能力密度,追求真实场景里“用得上”的智能。
顺着这个方向看,文档智能是一块绕不开的硬骨头。
几乎所有知识密集型行业,核心信息都沉淀在文档里。在被结构化之前,这些信息只能被“查看”,无法被高效检索、传递、计算,更无法交给大模型处理。可以说,OCR 是智能融入产业的第一道关口——这道关口的通过成本,直接决定了后面所有智能化环节的高度。
而现实中的这道关口,有三道坎:
第一道坎,是隐私与算力的双重约束。法律、金融、政务场景要求数据不出域,模型必须能在本地乃至端侧运行;与此同时,这些场景的文档动辄以万页计,对解析精度和吞吐效率的要求都极为苛刻。
第二道坎,是评测分数与信任之间的缺口。机器解析一页不到一秒,人工核对一页却要几分钟。只要无法预知哪一页可能出现漏字、公式错误或表格错行,用户就只能采取最保守的策略——全量人工核验。系统的效率瓶颈,悄悄从“解析”转移到了“核验”。
第三道坎,是真实世界的采集条件。理想中的文档平整清晰,现实中流转的文档却会弯曲、倾斜、带阴影,翻拍屏幕还会有摩尔纹。只在标准扫描件上表现好的模型,落地时必然付出高昂的预处理成本。
使命所要求的“高效”与“可信”,恰好都指向这里。这就是我们做 MiniCPM-OCR 的原因:它不是对热点的跟随,而是使命落到产品上的一次具体兑现——用极致高效的解析模型跨过第一道和第三道坎,再用一个独立的判别模型跨过第二道坎。
02 做到了什么水平:双 SOTA,加一位“AI 质检员”
先看解析模型 MiniCPM-OCR 1.0。
能力上,是两项 SOTA。在专门考察真实拍摄场景(涵盖扫描、拍照、弯曲、倾斜、翻拍五类条件)的 Real5-OmniDocBench 上,MiniCPM-OCR 1.0 取得 93.68 分的 SOTA 成绩;在综合性通用 OCR 评测 OCRBench v2 上,以 54.7 分取得 SOTA,领先对比范围内的次优模型 7.7 分。在与 14 款主流 OCR 模型的横向对比中,MiniCPM-OCR 1.0 在 6 项基准的 4 项中取得第一名——Real5-OmniDocBench(93.68)、Wild-OmniDocBench(92.39)、CHAOS-Bench(29.78)、OCRBench v2(54.7),其余两项也处于第一梯队。
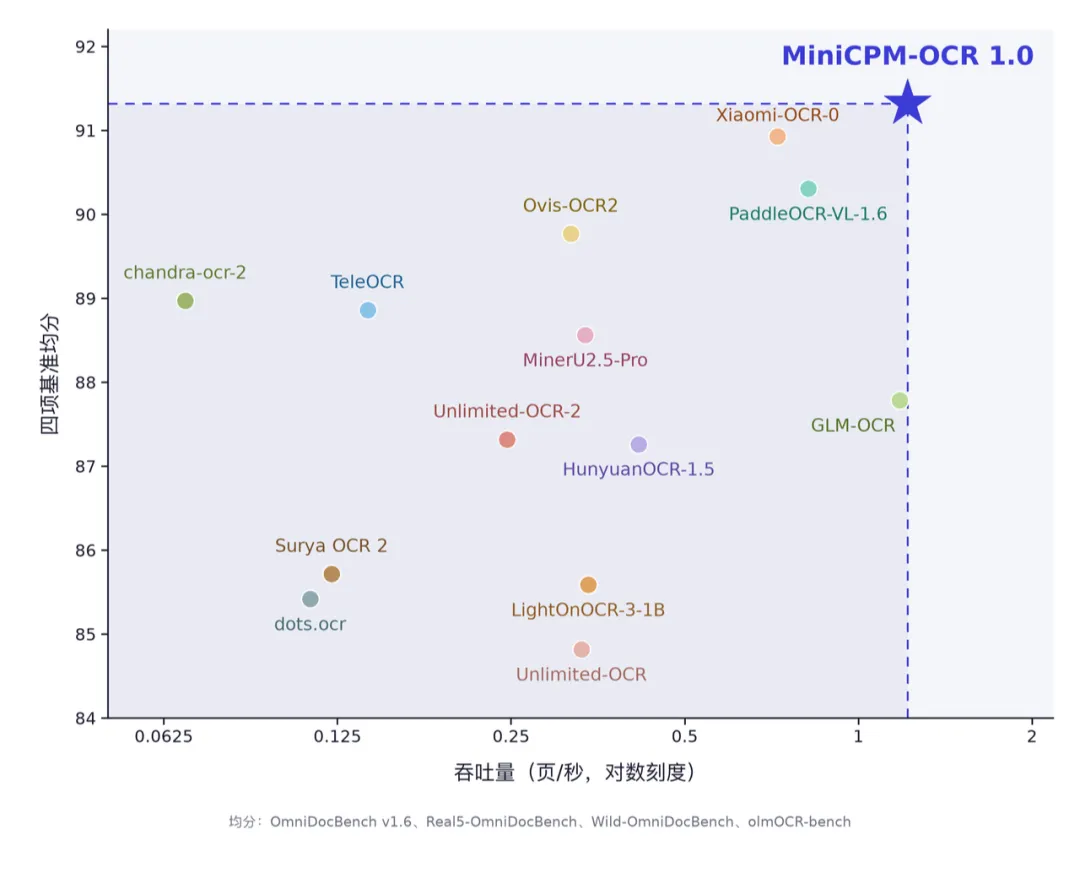
开源OCR模型效率与效果的综合对比:横轴为吞吐量,纵轴为四项基准平均分,MiniCPM-OCR 双维领先
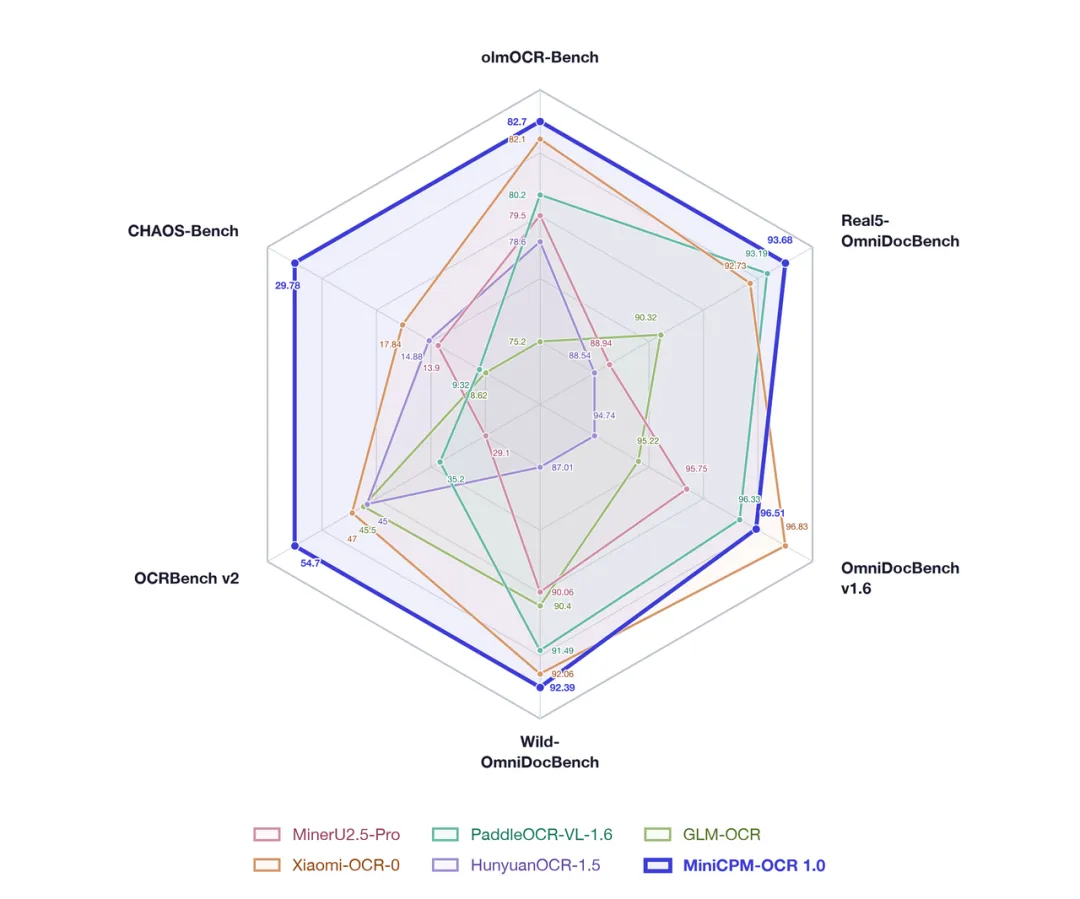
六项基准雷达图:MiniCPM-OCR 1.0 综合轮廓最大
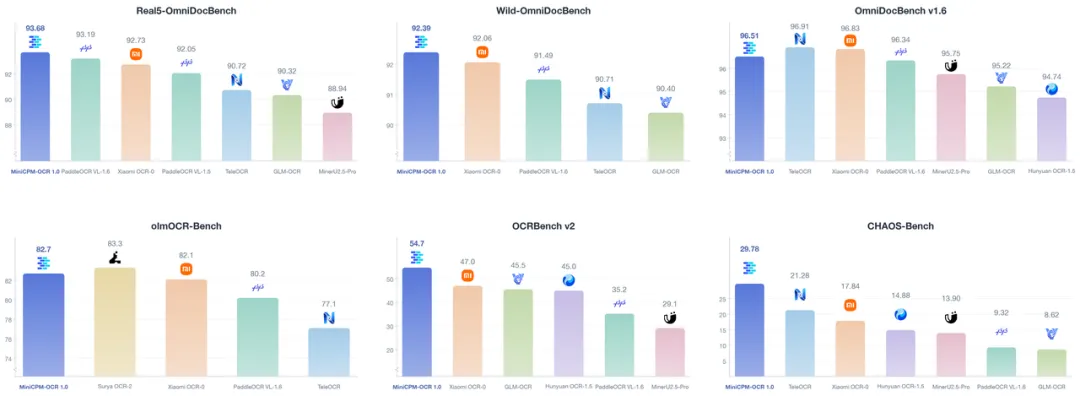
六项基准分场景柱状图:MiniCPM-OCR 1.0均处于第一梯队,并在四项中取得第一
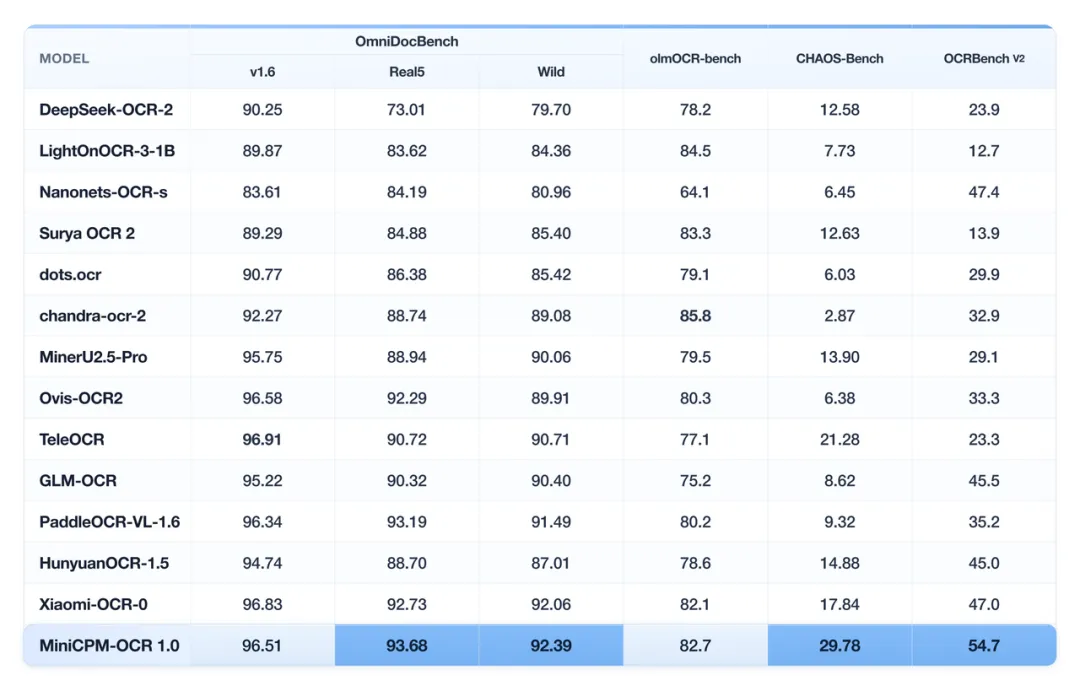
14 款主流 OCR 模型、六项基准完整对比:MiniCPM-OCR 1.0均处于领先位置,并在四项中取得第一
效率上,同样站在最前面。引入自研 DSpark 解码加速后,MiniCPM-OCR 1.0 的端到端处理效率提升 55%,实际吞吐达到原有的 1.6 倍。在统一硬件与数据基准下实测(NVIDIA RTX 5090,OmniDocBench v1.6 完整数据集 1,651 张图像,各系统官方 SDK 默认配置,图片级并发度为 1),MiniCPM-OCR 1.0 的吞吐量达到 1.217 页/秒,约为 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍。在前文的效率—性能散点图中,它是唯一一个同时占据“最快”与“最准”两个方向的模型。
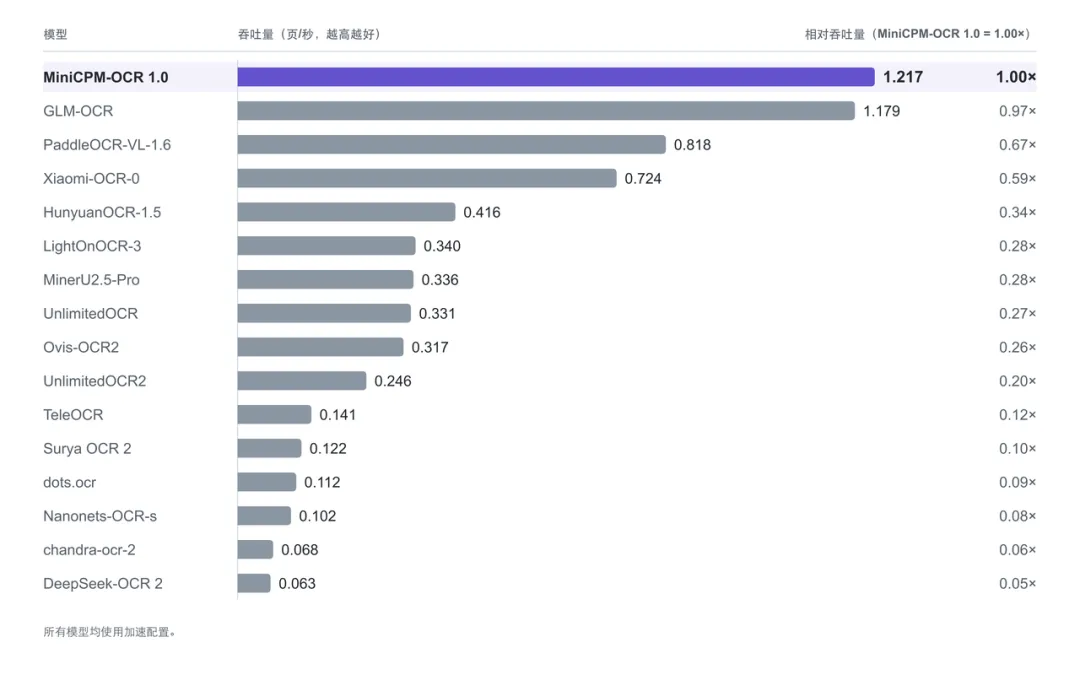
吞吐量对比:MiniCPM-OCR 1.0 达 1.217 页/秒(所有参测模型均采用加速配置)
再看这次发布真正特别的部分——MiniCPM-OCR Jev。
Jev 是一个不解析文本的 OCR 模型。它的输入是原始图像和对应的 OCR 解析结果,输出是一个 0–1 的质量评分,覆盖文本、公式与表格三类内容。它的职责只有一个:判断这份解析结果靠不靠谱。
在OCR解析结果决策评测 JevOCRBench 上,仅 2B 参数的 MiniCPM-OCR Jev 整体 AUROC 达到 93.6(文本 94.6 / 公式 93.1 / 表格 91.1),超越专用判别模型 JEV-35B-A3B(90.1)等一众 35B 级模型,逼近参数量远在其上的 Qwen3.5-397B-A17B(93.8)的判别水准。更重要的是它的泛化能力:Jev 的判别不绑定任何特定解析模型,在 MiniCPM-OCR 1.0、GLM-OCR、PaddleOCR-VL-1.6、Xiaomi-OCR-0 的解析结果上,AUROC 稳定在 91.9~93.4 之间——它可以即插即用地接入各类既有 OCR 系统,当一名独立的“质检员”。
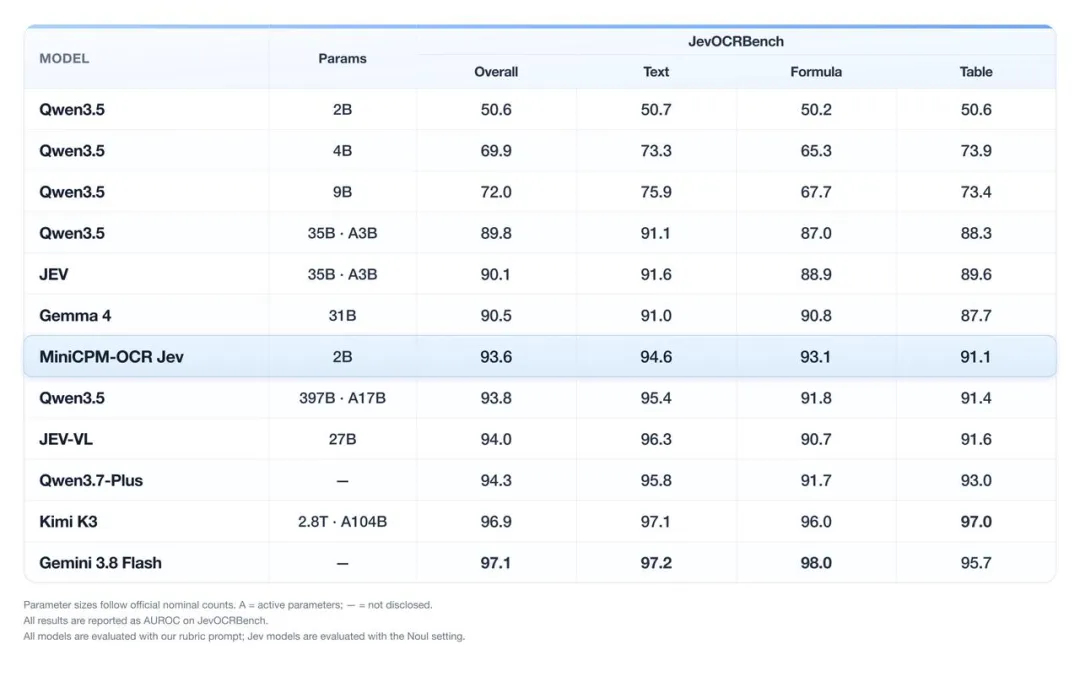
JevOCRBench 完整对比:2B 参数的 MiniCPM-OCR Jev 超越 35B 级判别模型
Jev 带来的改变,落到业务流程里是两种具体用法:
用法一:自动筛选,把人力从全量核验里解放出来。按业务的准确率要求设置评分阈值,超过阈值的结果自动入库,只有被标记存疑的少数内容推给人工。在内部 900 块人工标注图块的统计中,当免检部分准确率稳定接近 100% 时,法律文书最高可免检 85.0%,财务票据可免检 56.2%,复杂文档可免检 35.1%——核验精力第一次可以只花在刀刃上。
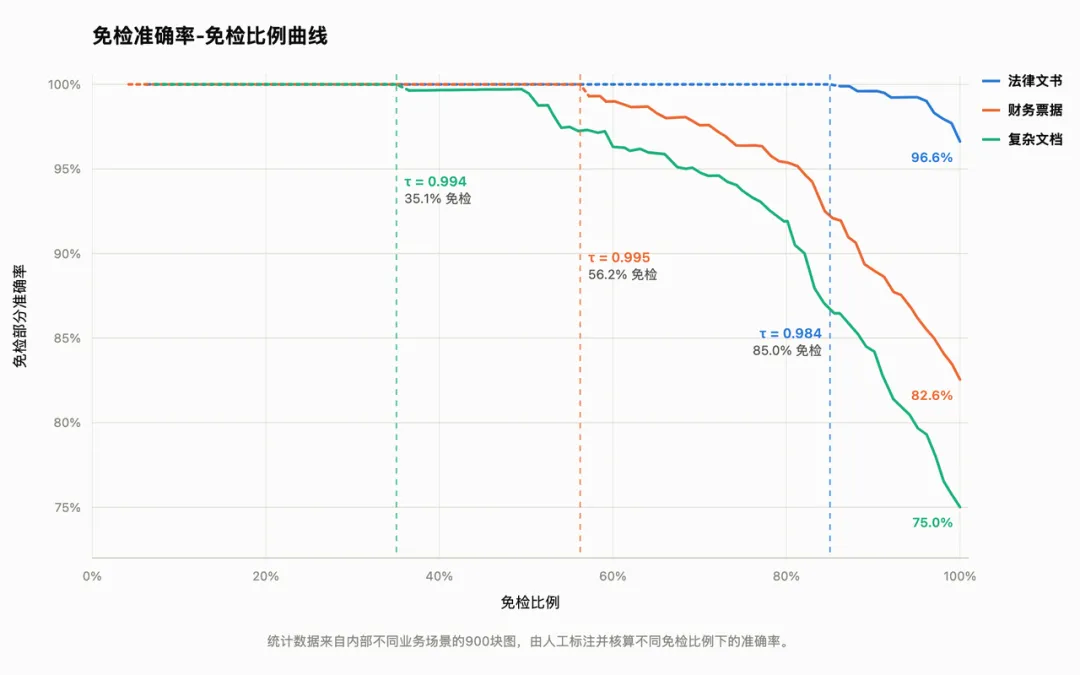
自动筛选:不同阈值下的免检比例与免检准确率曲线
用法二:多模型择优,把解析质量再往上抬一截。基于同一份版面分割结果,让多个 OCR 模型分别解析,再由 Jev 对各区域候选结果评分、逐区选出最高分并组合输出。在 OmniDocBench v1.6 上的实验中,这套“解析 + 裁决”的组合相比单一模型独立解析,整体得分最高可提升 0.25。
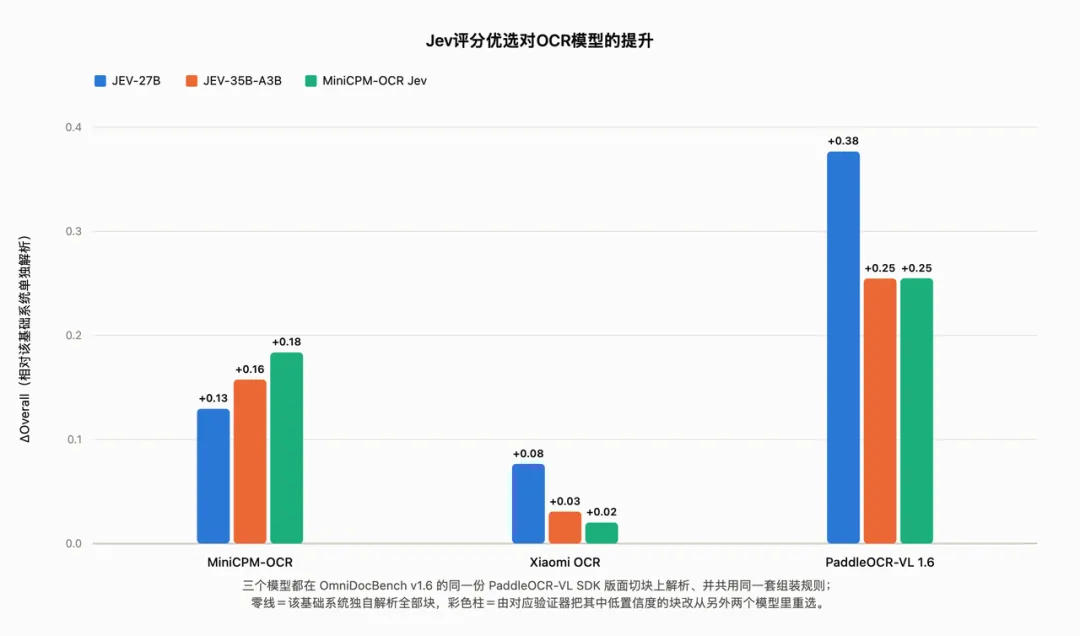
多模型择优:Jev 评分优选为不同 OCR 基础系统带来的提升
03 如何做到:1.3B 参数,撑起高密度能力
解析模型这边,靠的不是某一个单点技巧,从基座、架构、数据到推理,每一个环节都在为“能力密度”服务。
第一环是“强大基座”。MiniCPM-OCR 1.0 并非从零开始,而是基于多模态模型 MiniCPM-V 4.6 训练,并复用了 MiniCPM-V/o 系列基座积累的大规模高质量文档预训练数据。因此,模型在进入 OCR 专项训练之前,就已经具备扎实的图像与文档理解能力,后续训练可以集中在识别精度和结构化输出上。
第二环是“精巧架构”。 文档图像往往分辨率高、文字密集,模型既要看清细节,又不能让计算量随图像尺寸膨胀。MiniCPM-OCR 1.0 采用 LLaVA-UHDv4 高效视觉分片方案,即使面对超大图像,编码依然高效。同时,模型在架构上集成了自动 Upright 与自适应 Upsize 两项设计:前者自动判断并纠正输入图像的朝向,旋转、倒置的文档无需人工摆正;后者通过自适应上采样,提升对密集文字和细小数字的解析能力。
第三环是“真实数据与强化学习”。真实世界中的文档差异很大:版式不同,领域不同,采集条件也不同,单靠人工标注很难覆盖这些长尾情况。为此,我们从大量不同的真实场景中收集种子数据,再通过 Agentic 合成的方式规模化扩展。这样得到的训练数据,既保留了真实文档的特征,也具备足够的规模和多样性。在此基础上,我们基于真实复杂场景开展了大规模强化学习,持续提升模型在复杂样本上的解析质量。
第四环是“高效推理”。MiniCPM-OCR 1.0 引入了 DSpark 解码加速技术,由轻量草稿模块一次提出多个候选 token,再由主模型一次性并行验证,减少逐个生成带来的等待。在不牺牲解析质量的前提下,端到端处理效率提升 55%,大规模文档解析的时间开销随之降低。
Jev 这边,关键在路线选择:走“快思考”,不走“长推理”。
心理学家丹尼尔·卡尼曼在《思考,快与慢》中将人类的认知分为两种模式:System 1 是快速、直觉式的判断,System 2 则是缓慢、分步推演的慢思考。近年来,以长链推理为代表的 System-2 模型在复杂推理任务上取得了显著进展;但在工业流水线的质检环节,每一页解析输出都需要经过检验,如果质检模型需要展开冗长的推理生成,其耗时与算力成本将超过解析本身,反而制造出新的拥堵。
所以 Jev 被设计成一个标准的 System-1 模型:它不生成任何文本,只做单次前向 prefill 计算、不需要自回归解码,延迟极低,可以作为一个高频门禁节点,拦在昂贵的人工复核之前。
判别能力则来自扎实的训练方式:模型基于真实人工标注的块级解析正确性标签训练。分数不只是排序依据,而是可以直接拿来做业务阈值的可信度。
04 真实场景 Cases
数字之外,来看模型在真实文档上的表现。MiniCPM-OCR 面向金融、财税、法务、医疗等以文档为主要业务载体的行业,已在多类客户场景中部署应用。
模型可在本地完成票据、单据、合同、流水、报表等文档的解析与结构化:还原版面与表格结构,跨页内容可合并输出,结果以 Markdown 或字段化数据交付,供业务系统调用。对解析结果的质量校验,可配合 MiniCPM-OCR Jev 决策模型完成。
中文场景:手写笔记、复杂矩阵公式、多栏报纸、财务宽表、带公章的公文、插图转结构化表格、印章遮挡下的关键信息抽取(KIE),七类高频场景一览:
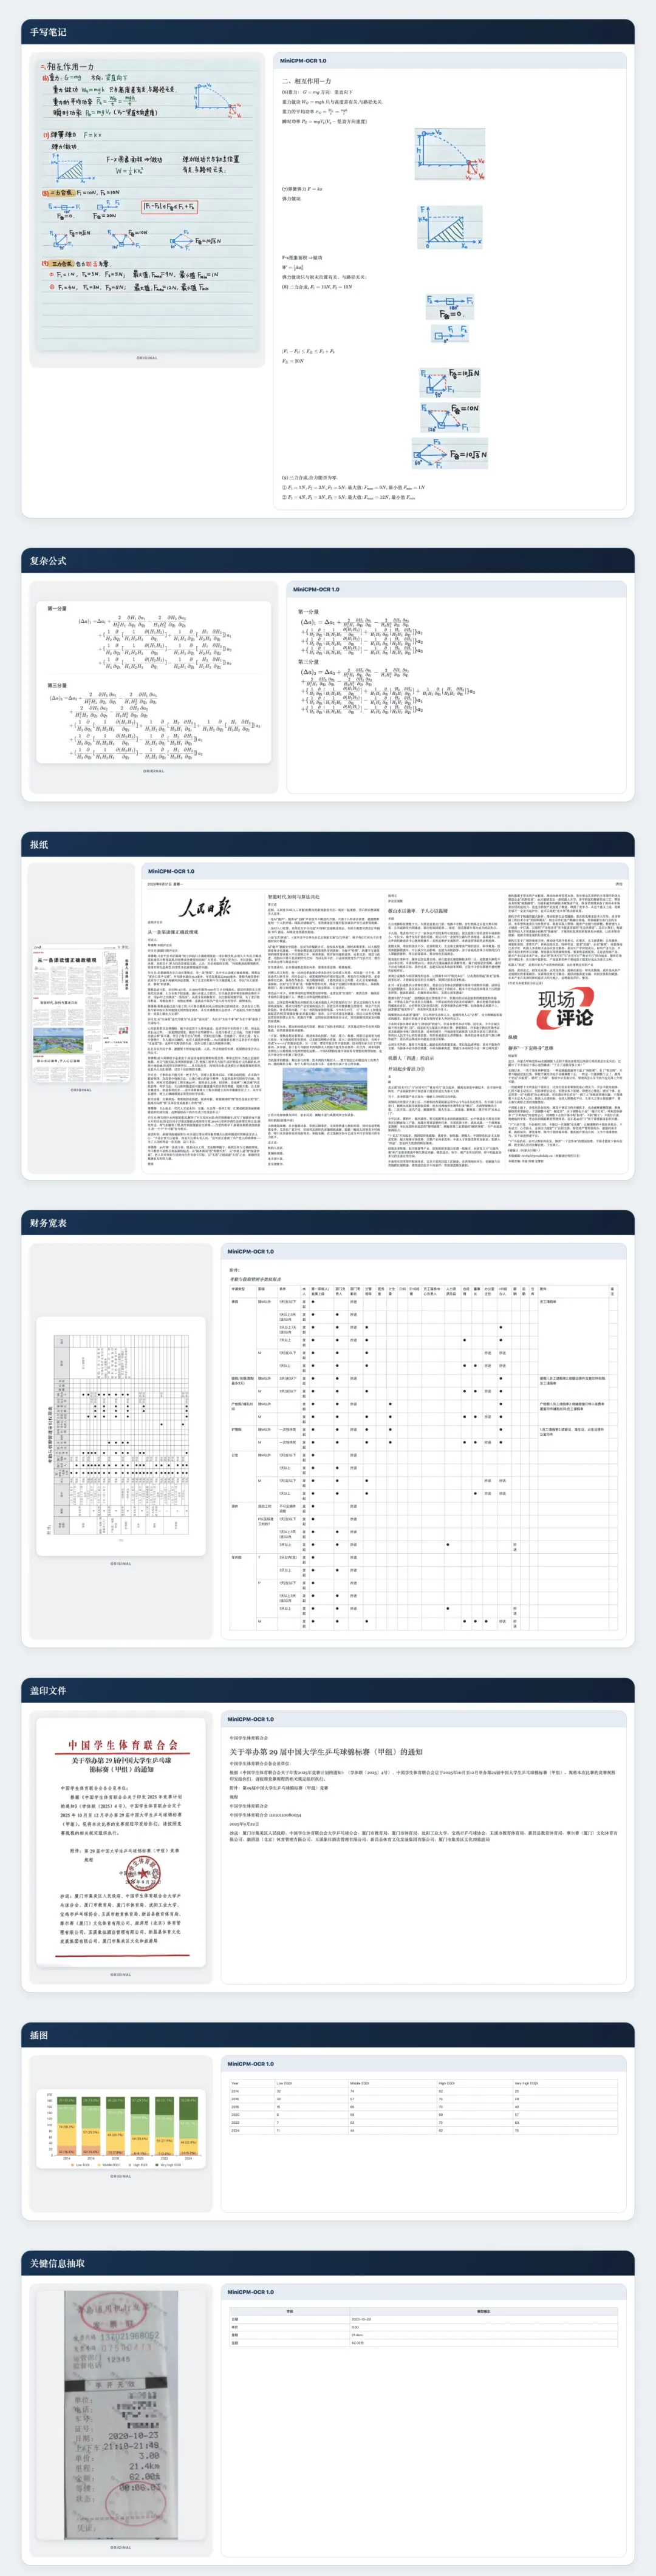
中文场景案例集(图片):手写笔记、复杂公式、报纸、财务宽表、盖章公文、插图表格化、关键信息抽取
中文场景的实现过程——从原图、Layout 框图(印章与文本区域检测)到结构化 Markdown 渲染:
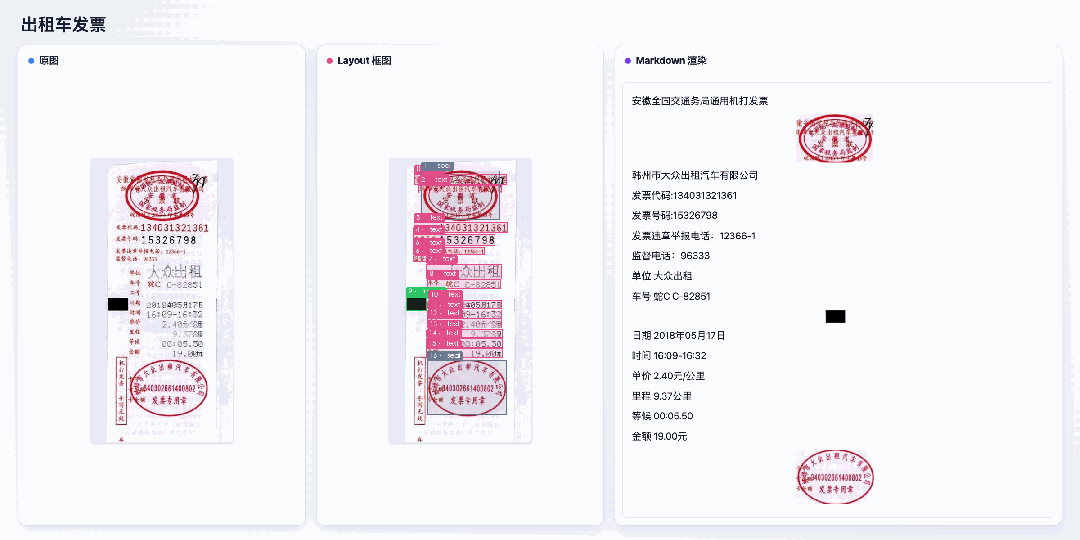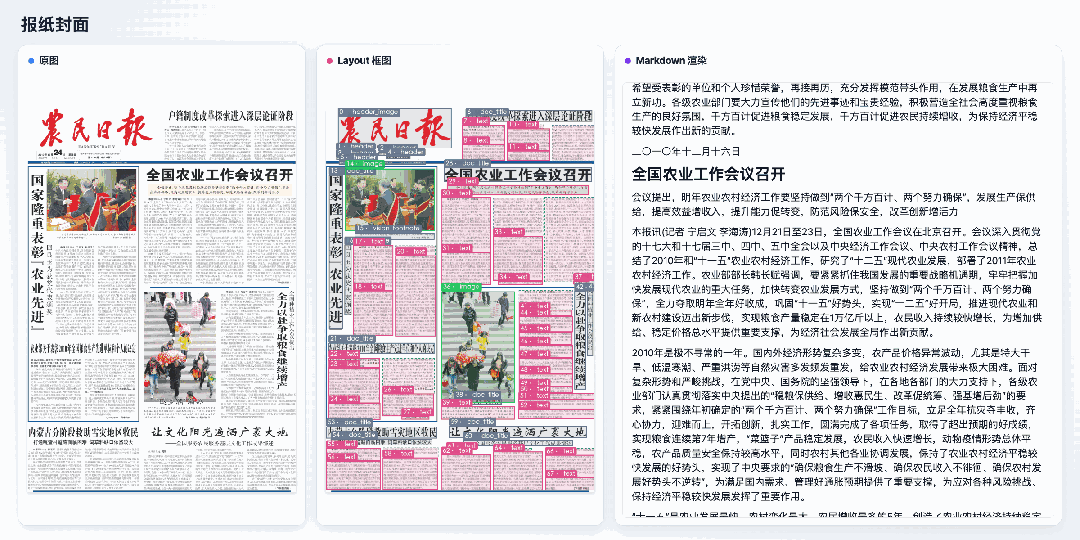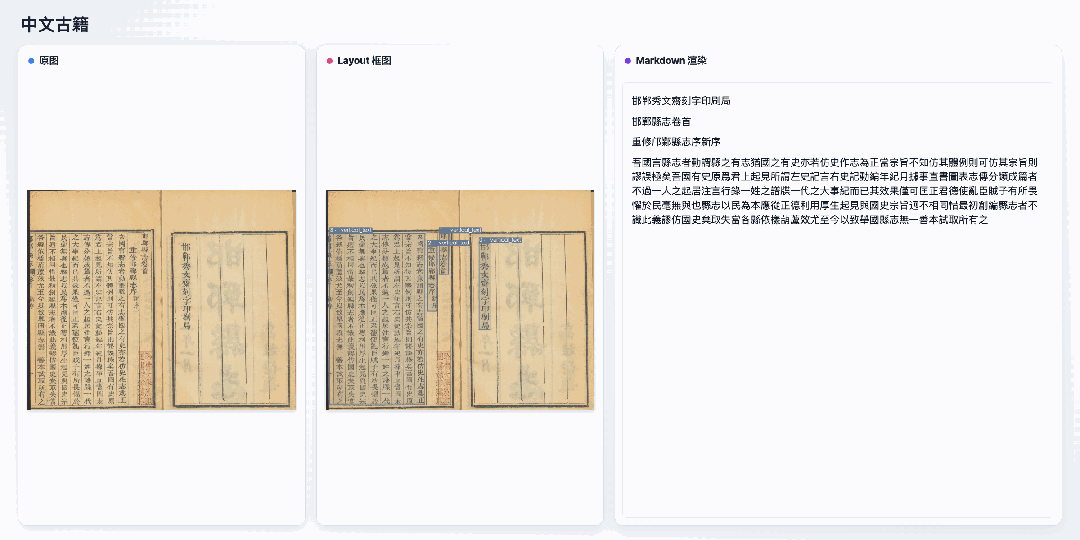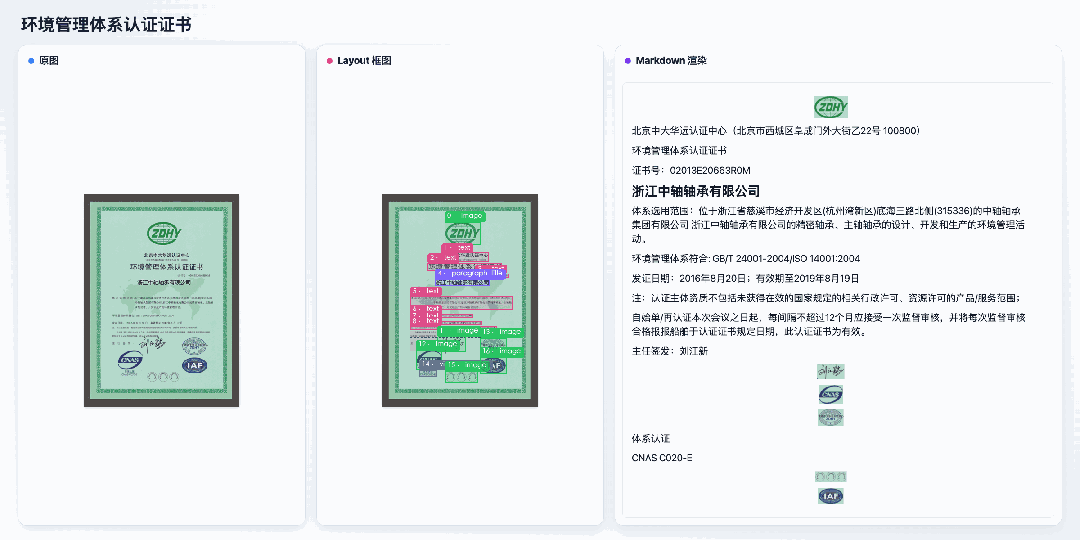
中文场景案例集(GIF):原图—版面检测—结构化输出全流程
英文场景:手写物理笔记、泛黄历史文献、扫描公文、多版面新闻报纸、多财年财务报表、热敏小票关键信息抽取:
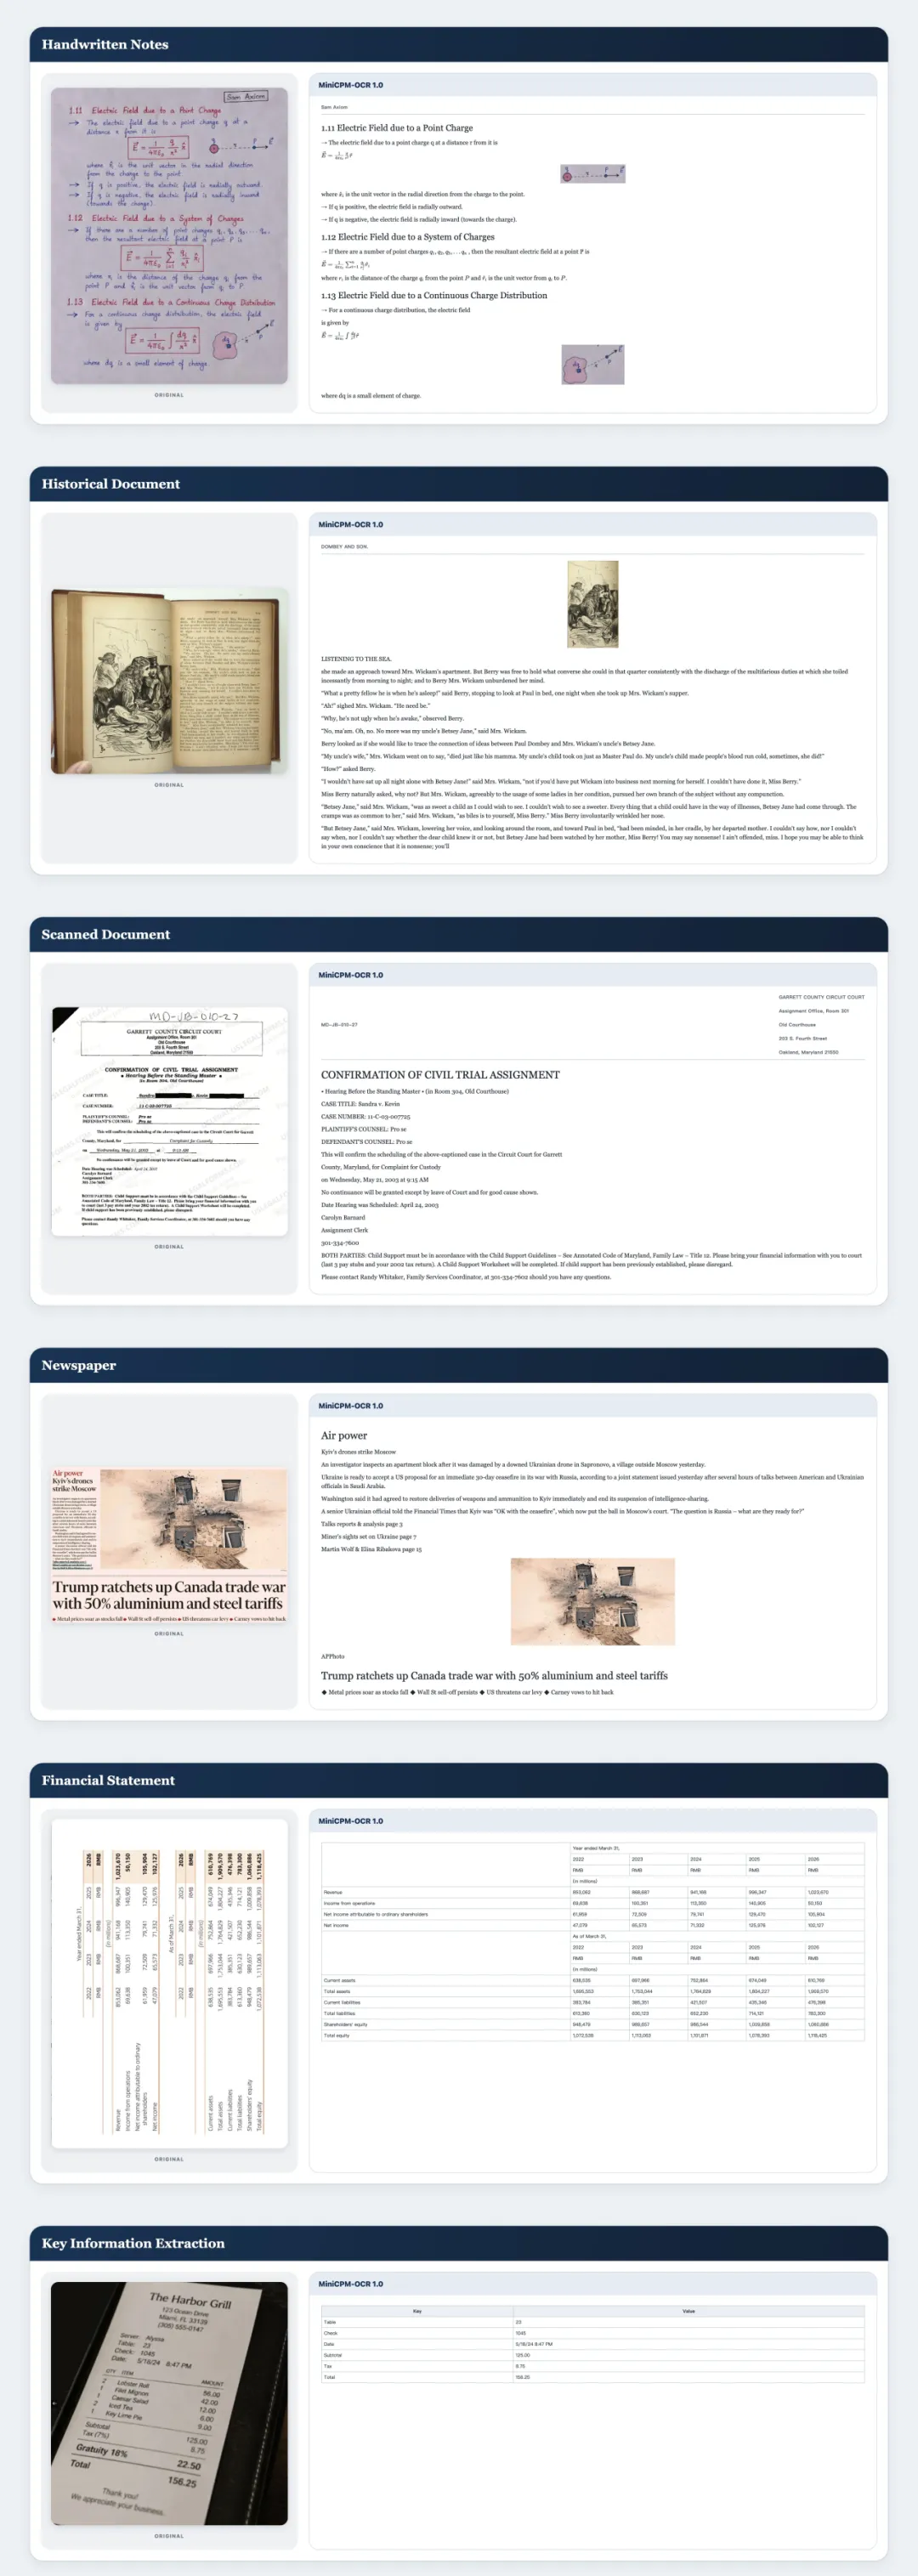
英文场景案例集:手写笔记、历史文献、扫描公文、报纸、财务报表、小票信息抽取
英文场景的解析和输出过程:
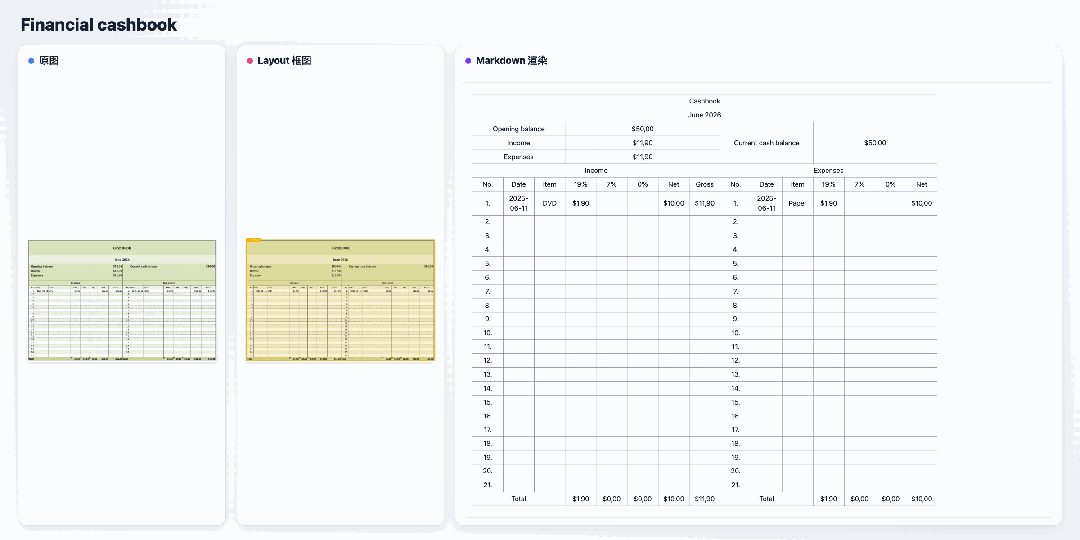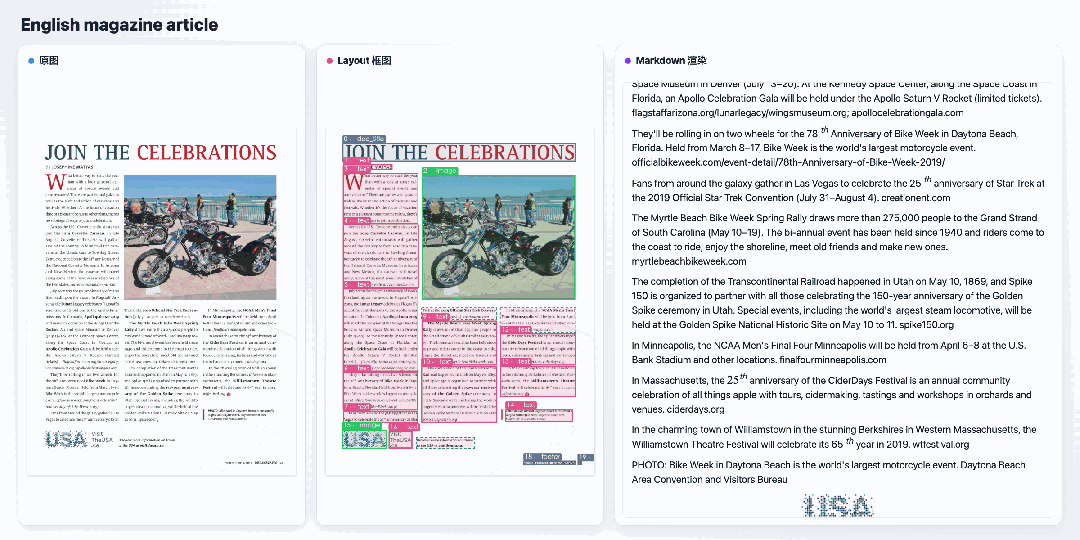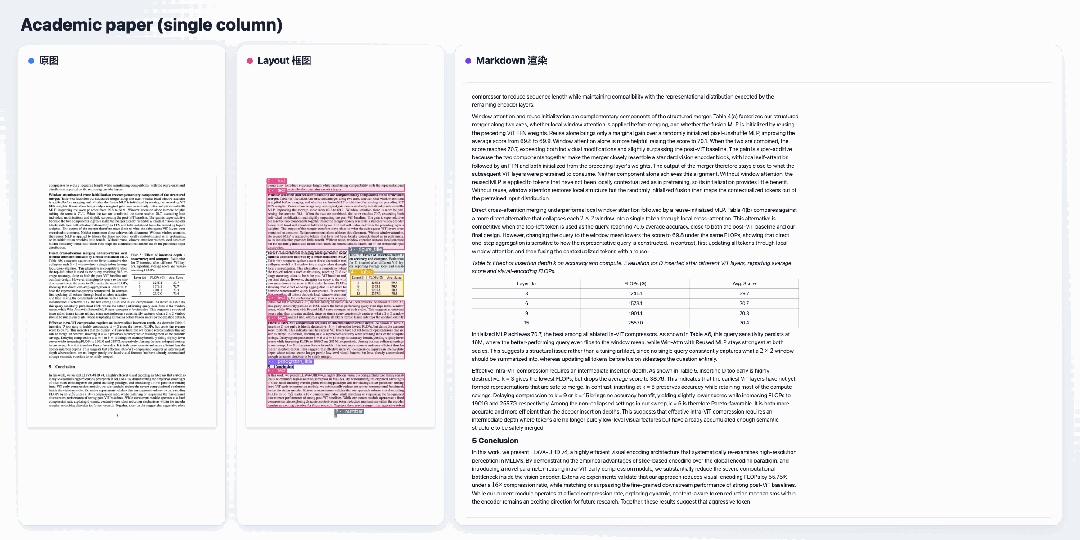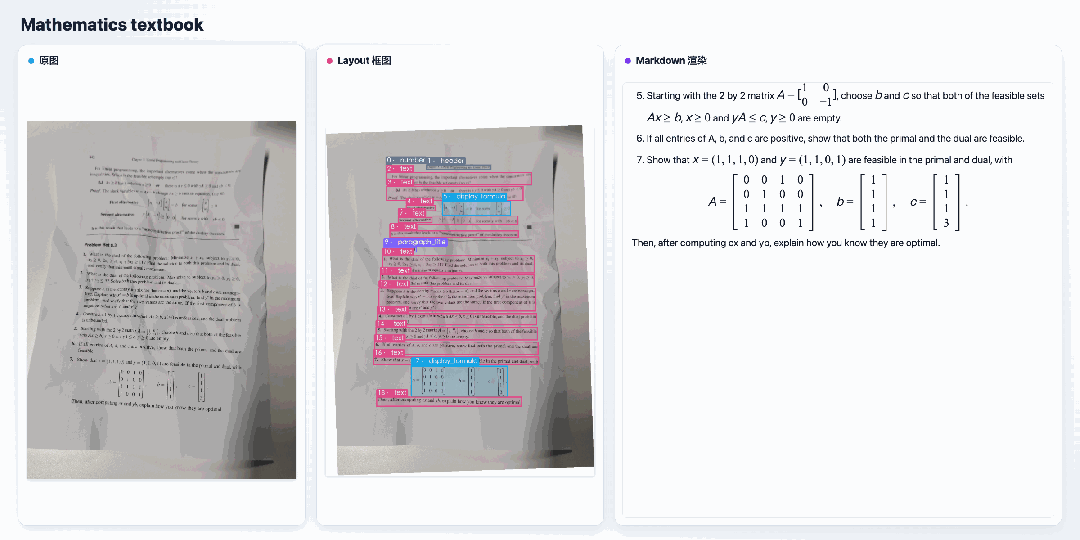
英文场景案例集(GIF):原图—版面检测—结构化输出全流程
再看 Jev 的判别效果。同一张原图、两份候选解析结果,Jev 的评分与真实质量几乎完全对齐:中文场景下,含多处字义错误的候选只得 0.0067 分,而准确版本得 0.984 分;公式与表格场景同样泾渭分明。英文场景下规律一致——错误集中、结构错乱的候选被压到 0.1 分以下,可靠结果稳定在 0.8 以上。这意味着业务侧可以直接用分数划线:线上自动入库,线下只查低分。
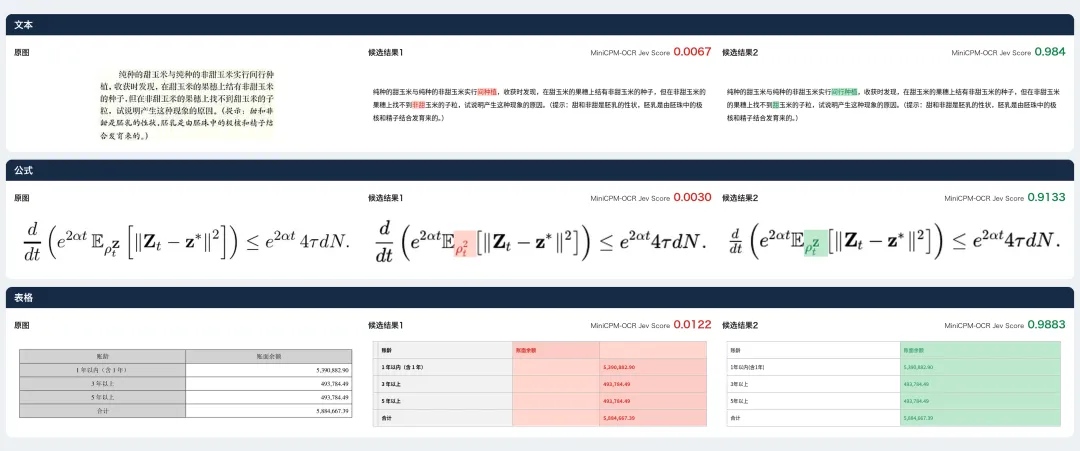
Jev 中文判别案例(图片):文本、公式、表格三场景评分对比
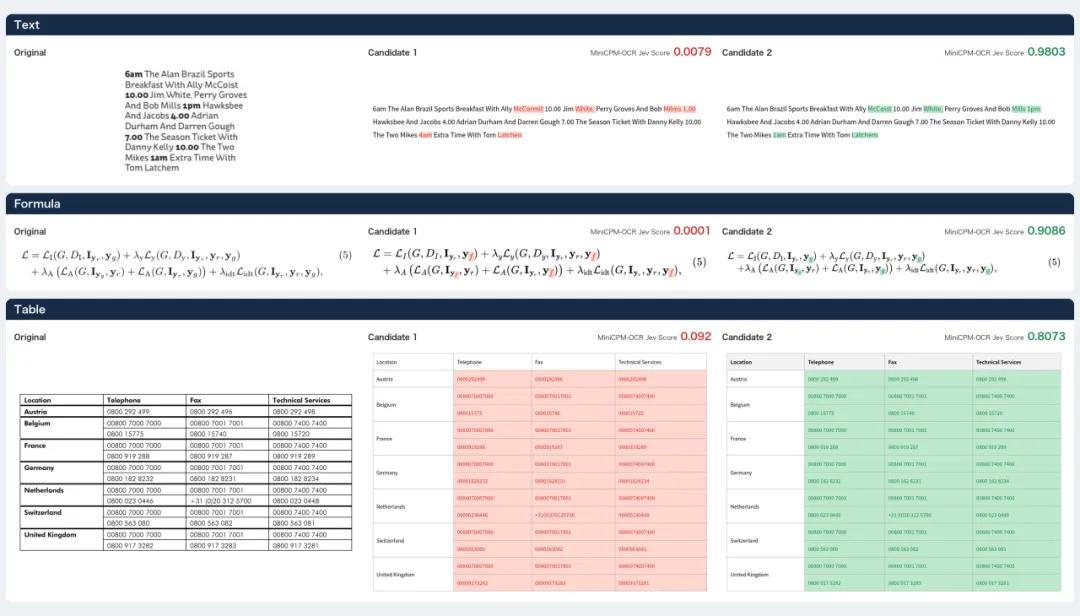
Jev 英文判别案例(图片):文本、公式、表格三场景评分对比
05 下一步:回到那句话
MiniCPM-OCR 系列延续了面壁“开源、高效、开发者友好”的技术基因,发布首日即完成全面的生态适配:
模型权重全量开放,MiniCPM-OCR 1.0 与 MiniCPM-OCR Jev 同步开源;
推理框架首日适配 vLLM、SGLang、llama.cpp、Ollama,同步提供多芯片适配与多种量化版本;
调用与集成一步到位:Hugging Face CLI、pip SDK、功能完备的 API、成熟的 Agent Skill 封装,并提供流畅的 WebDemo 在线体验;
支持二次微调,开源微调支持同步上线,方便开发者面向垂直文档场景定制。
依托长期构建的芯片合作生态,MiniCPM-OCR 已完成与 Arm、后摩智能、Intel、NVIDIA 等厂商的 Day 0 级适配。此外,众智 FlagOS 社区基于统一多芯片 AI 系统软件栈,为 MiniCPM-OCR 1.0 与 MiniCPM-OCR Jev 完成 Day0 跨芯适配,覆盖此芯科技、华为昇腾、海光信息、天数智芯、昆仑芯、沐曦、摩尔线程、曦望、平头哥、清微智能、英伟达及 Mac(ARM),共 12 个平台。
接下来,MiniCPM-OCR 系列会持续演进:更多语言、更复杂的版面与采集条件、更深的行业流水线适配;Jev 的“质检”能力也将继续打磨,并探索把它接入更广泛的文档处理链路。我们也会在高效端侧大模型的方向上继续深耕,与开发者和行业伙伴一起,进一步拓宽文档智能的能力边界。
回到开头那句话——让智能融入每个产业、装进每个终端、惠及每个人。
把纸张与图片变成干净、可信的结构化文档,让工作人员从成千上万页的人工核验中抽身,看起来是数字化最基础的一步,却正是智能化大厦的地基。MiniCPM-OCR 想做的,就是把这块地基做得更普惠、更可靠、更触手可及。
智能惠及每个人,从认真读懂每一页纸开始。