ARTICLE · 1285101
AI 能帮你收集信息,但怎样才能让数据真正为你所用?
从外部信息到可持续使用的业务能力
假设你正在研究一个品类。
今天,你发现一个新品,收集了商品信息、用户评论和相关内容;明天,又看到一个竞争品牌推出了新产品;过几天,某个渠道出现了新的产品趋势。
你让 AI 总结信息、提取卖点、分析评论。速度确实快了,资料也整理得更整齐了。
但一个月后,当你想继续研究这个品类时,可能仍然要重新搜索、重新整理、重新判断。上次发现的新品后来怎么样了?它与现有产品有什么关系?当时关注的用户需求有没有变化?哪些判断经过了验证?
信息越来越容易获得,真正能够持续使用的业务认知,却不一定随之增加。
问题不在于 AI 不够强,而在于我们经常把每次获取的信息当成一次性材料,没有把它们组织成能够识别、关联、更新和复用的数据。
这就引出了一个值得认真讨论的问题:AI 能帮我们收集信息,但怎样才能让数据真正为我们所用?
一、信息收集,不等于形成积累
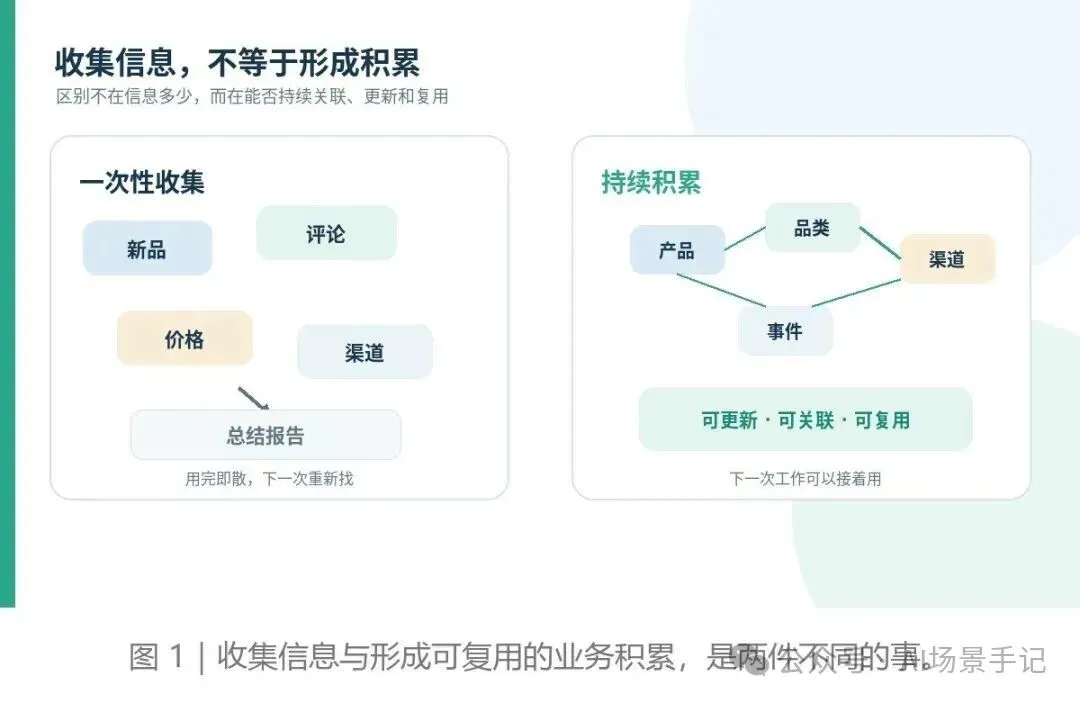
我们很容易把“找到信息”当成工作完成。搜到新品、整理评论、生成竞品报告,每一步都有清晰的交付物。但如果下一次遇到类似问题,仍然要从头开始,这些工作就没有真正形成可复用的能力。
真正有价值的积累,不只是把资料保存下来,而是让它们具有稳定的身份、明确的来源、可理解的关系,以及能够持续更新的状态。
例如,关于一款新品的信息,不应该只是一份文档。它应该能被识别为一个具体的产品,关联到品牌、品类、渠道和相关用户反馈;后续价格变化、商品上下架、评论趋势,也能继续归到同一个对象上。
这样,新信息不是覆盖旧信息,也不是孤立地增加一条记录,而是在已有认知上补充变化。下一次研究时,才有东西可以接着用。
二、外部信息要治理什么?
过去,很多企业的数据治理主要围绕内部经营展开:主数据管理客户、产品、供应商和组织;交易数据记录订单、销售、采购和库存;指标数据定义收入、成本、利润和转化率。
这些工作依然重要。它们帮助企业把自己的经营活动记录清楚、把内部口径统一起来。但业务世界并不只存在于企业内部。
线上会不断出现新品和新商家,线下可能新增渠道和门店,平台会调整商品分类或经营规则,产品价格、上架状态和用户讨论也会持续变化。企业可能需要关注这些信息,却不一定已经在内部系统中为它们建立了记录。
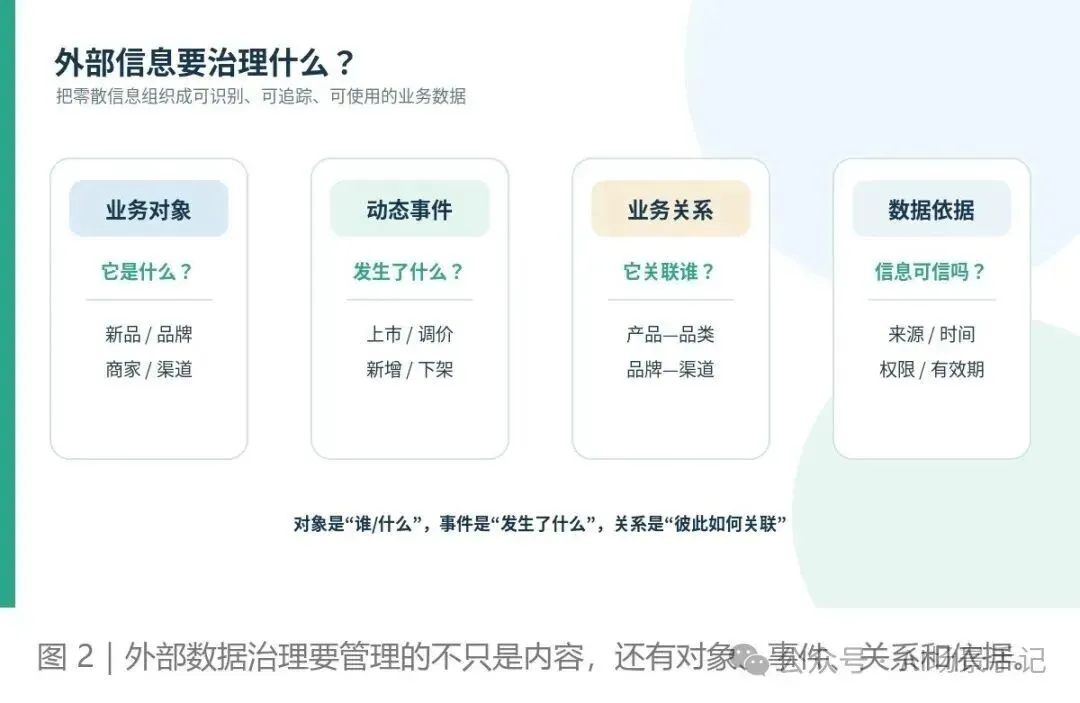
面对这些动态信息,至少要分清四类内容:
第一,业务对象——它是什么?例如新品、品牌、竞品、商家、渠道或用户群体。需要识别身份、分类,并尽可能避免重复记录或错误合并。
第二,动态事件——发生了什么?例如新品上市、价格变化、渠道新增、商品下架或规则调整。需要记录事件时间、来源、状态和有效期限,而不是只保留一张静态快照。
第三,业务关系——它与什么有关?例如外部商品属于哪个品类,与企业现有产品有什么区别,在哪些渠道出现,相关评论指向什么需求。
第四,数据依据——这些信息是否可信?需要知道信息来自哪里、何时获取、经过什么处理、是否过期、是否有权使用,以及对象匹配的结果有多确定。
所以,外部数据治理不是把网上的信息收集起来,而是把与业务有关的对象、事件和关系,组织成可持续管理的数据。
三、怎样让外部数据与自己的业务连接起来?
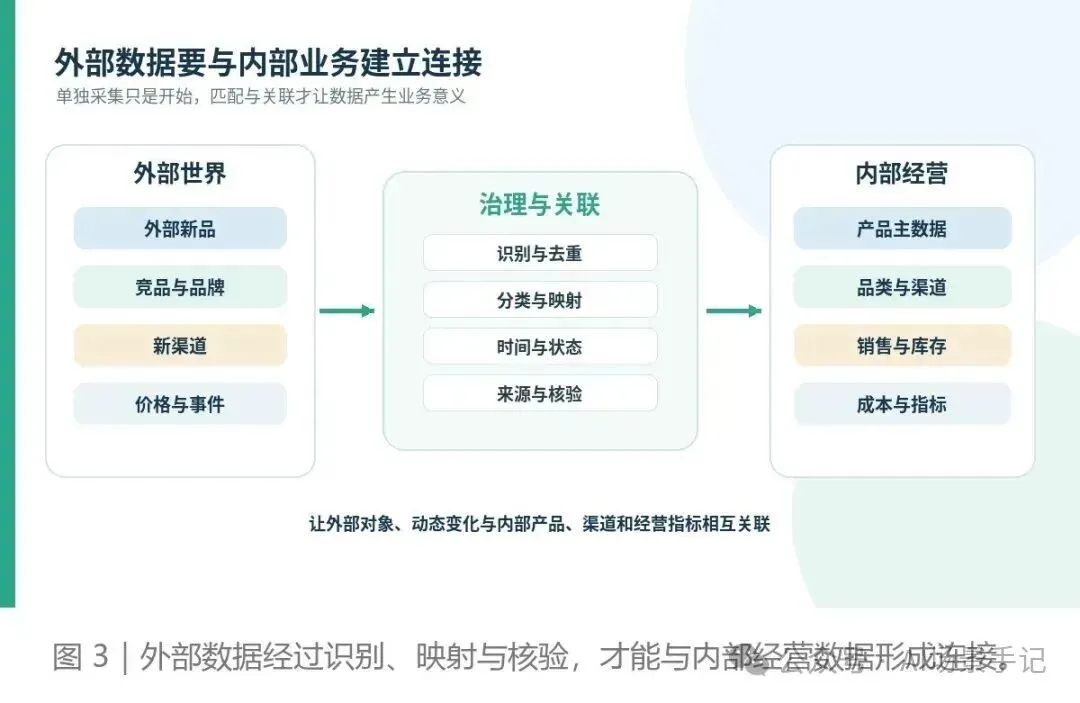
外部数据单独存在时,往往只是信息。它与企业内部的产品、品类、渠道、成本、销售和经营指标建立关系后,才更有机会支持业务判断。
假设外部平台上的一个商品使用了不同的名称、编码和分类。企业需要判断它是不是已有产品,是一个新竞品,还是一个完全不同的对象;还需要将外部平台的类目映射到自己的品类体系,并记录匹配的依据和不确定性。
这不是简单地把两张表拼在一起。它涉及对象识别、去重、分类映射、关系管理、时间更新和来源追溯。匹配不确定时,系统应当保留待确认状态,而不是强行合并。
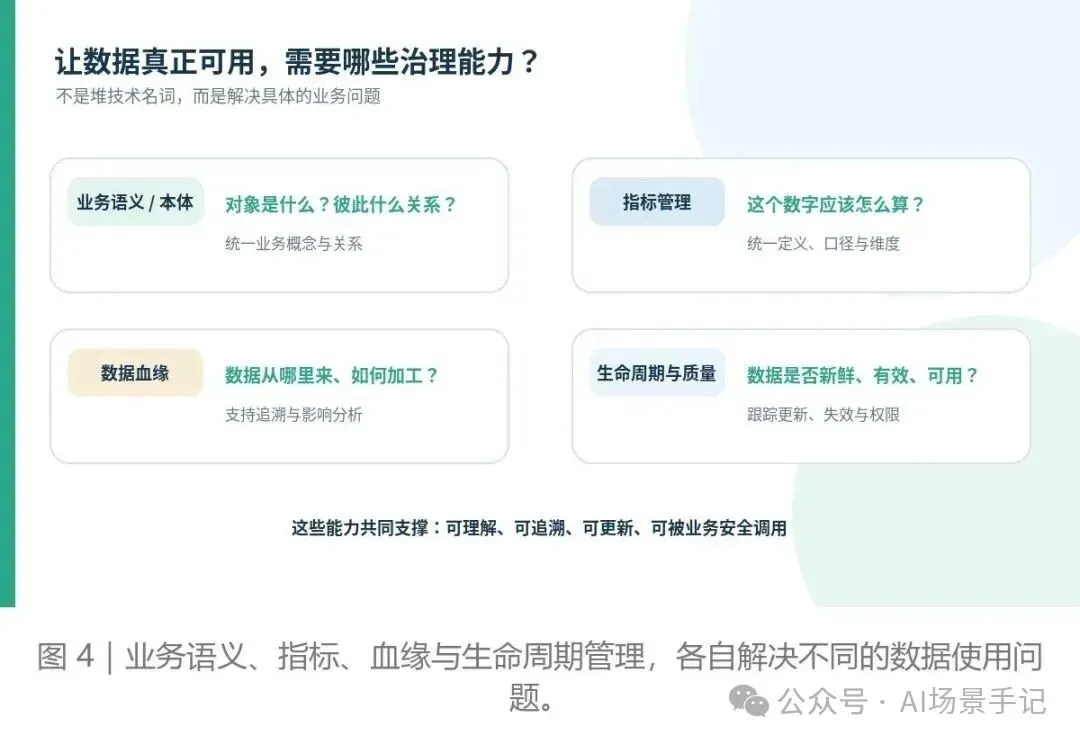
这时,几项传统的数据治理能力依然重要,只是应用范围不应只局限于内部数据。
数据本体或业务语义模型,帮助描述业务对象、概念和关系,让系统知道产品、品类、品牌和渠道之间如何关联。数据血缘帮助追溯数据从哪里来、经过了什么加工,支持问题定位和结果核验。指标管理则让销售额、毛利、转化率等经营指标有明确的定义、计算口径和适用范围。
还需要管理外部数据的时效、质量、生命周期和使用权限。价格可能每天变化,商品可能下架,某条信息可能失效;这些都不能只靠一份静态数据目录解决。
因此,数据治理的重点不是把所有信息放进同一个平台,而是让重要数据具有清楚的含义、可靠的来源、明确的关系,并能在需要时被更新和使用。
四、AI 如何让这些数据真正参与工作?
数据治理不是最终交付。治理后的数据还需要进入具体的业务过程,才能发挥作用。
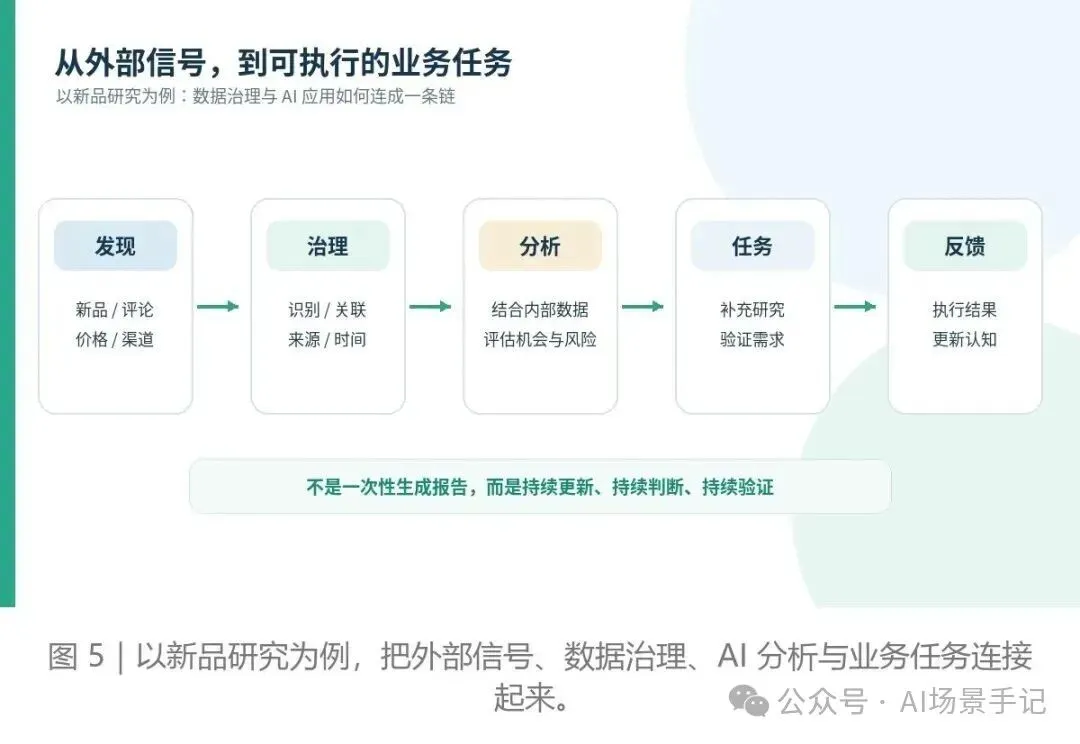
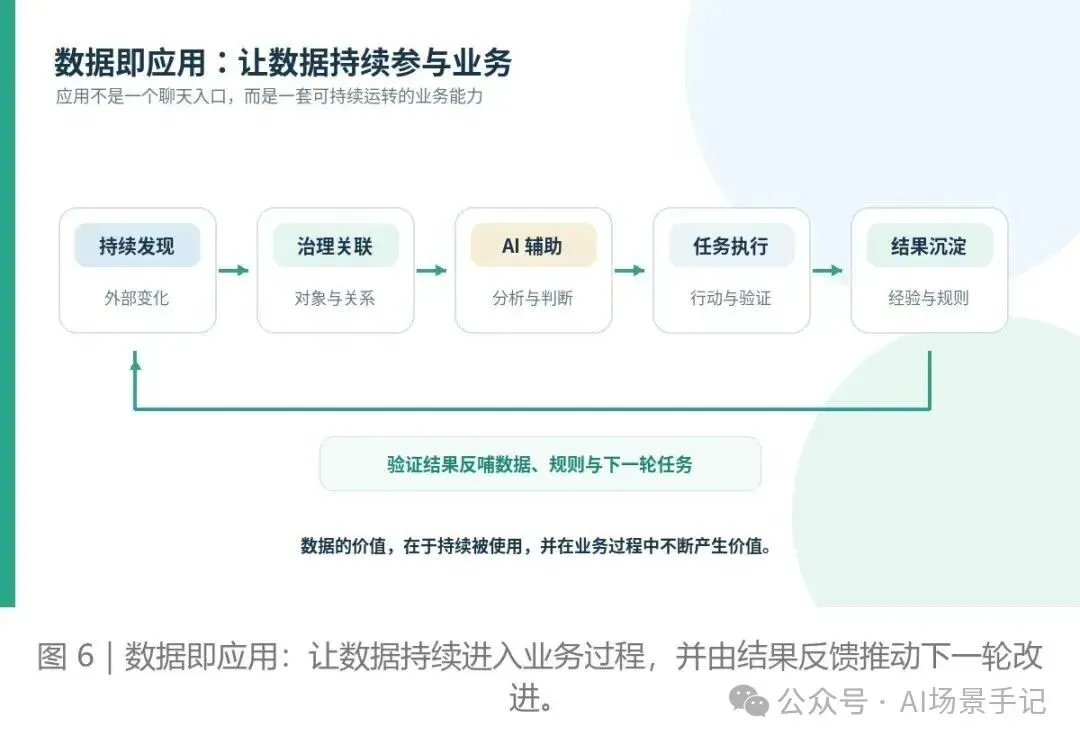
以新品研究为例,第一步是持续发现外部新品、价格、渠道和用户反馈;第二步是识别对象、去重分类、记录来源和时间,并与内部产品及品类建立关联;第三步是让 AI 结合选品目标、成本、现有产品和经营指标,整理机会、风险与信息缺口。
接下来,系统不应该只生成一份报告就结束。对于值得继续研究的候选产品,可以形成具体任务:补充评论样本、验证用户需求、研究竞品价格、确认供应链条件,或者评估进入某个渠道的可行性。
任务执行后,再把验证结果记录下来:原来的判断哪些成立,哪些不成立,缺少了什么证据,哪些条件值得持续跟踪。这些结果又可以帮助下一轮研究。
这条链路里,AI 可以帮助发现、整理、匹配和分析信息,但不能把未经核验的外部信号直接当成事实,也不能替代业务人员对风险、资源和经营目标的判断。
五、这才是“数据即应用”
如果数据治理的结果只是一个数据目录、一套报表或一个更方便提问的聊天入口,业务仍然可能需要反复找数据、解释口径、整理材料和手动跟进。
我们真正想要的,是数据能力能够直接参与业务:外部信息持续进入,业务对象可以识别,内外部关系可以复用,AI 能够在适当权限和规则下调用数据,分析结果能够进入任务、执行、验证与复盘。
这并不意味着所有数据都必须先治理完,也不意味着每个业务场景都要建设一套复杂平台。更可行的方式,是先选择一个有实际价值的场景,明确需要哪些数据和关系,补齐关键治理能力,再用业务结果验证投入是否值得。
同一套底层能力,也可以逐步服务于新品研究、竞品分析、渠道评估、客户洞察等不同应用。底层数据能力可以复用,面向业务的应用则应该根据任务和目标而设计。
数据的价值,不仅在于被记录和管理,更在于能否被持续使用,并在真实的业务过程中不断产生价值。
最后
AI 让获取和处理信息变得更容易,但信息不会自动变成业务能力。只有当数据能够被识别、关联、更新、核验,并持续进入实际工作,它才不只是一次性的输入,而会成为下一次判断与行动的基础。
这也是“数据即应用”真正想表达的意思:让数据不止被管理,更能够被持续使用。