ARTICLE · 1318277
排序:V8 TimSort 源码解析/快排/归并/稳定性全解(面试收藏级)
面试官翻了翻简历,随口问了一句:「你们项目里那个药品列表,
sort用的什么算法?」你答「快排吧」,他点点头,接着问:「那它稳定吗?」你愣了一下——「稳定?排序还有稳不稳定这一说?」——这一愣,基本就宣告了这场面试的结局。更扎心的是,就算你答对了「V8 现在用的是 TimSort」,他下一句往往是:「为什么不用快排了?」这篇文章,就是把这四层追问一次性拆干净:**sort稳不稳定 → 为什么有的稳定有的不稳定 → 比较排序为什么快不过 O(n log n) → V8 到底怎么实现的**。
🎯 这篇文章解决什么问题
这是「前端数据结构与算法」系列的第 10 篇。前九篇走完了线性结构和非线性结构,从这一篇开始进入算法基础:排序 → 搜索 → 递归。
排序是算法的「基本功」,也是最容易被轻视的一块——很多人觉得「我调 arr.sort() 不就行了」,但面试里排序的追问深度,往往能直接把候选人分层:
第一层:知道有十种排序,能背出各自复杂度 第二层:能现场手写快排 / 归并,跑得过 912 题 第三层:能讲清稳定性为什么重要、快排最坏情况怎么触发、怎么优化 第四层:知道 V8 的 Array.prototype.sort到底怎么写的,为什么在 2018 年从快排换掉
绝大多数人停在第二层。这篇文章的目标,是把你带到第四层。
全篇围绕三条主线推进:
稳不稳定:稳定性的定义、实际影响、哪些算法稳定、怎么利用稳定性做多键排序 快不快:十种排序的时间空间全景,以及「比较排序为什么突破不了 O(n log n)」这个下界证明 V8 怎么做:从 2018 年的快排 → TimSort 切换,到 TimSort 的 run 识别、minRun、归并栈不变量,再到 2026 年最新换上的 PowerSort
一、场景切入:sort 到底稳不稳定
先从一段你天天写、但可能从没验证过的代码说起。
药品列表排序的三个常见需求
🔧 真实场景:药品列表页要支持三种排序——按价格、按销量、按首字母。运营还会叠加筛选条件,比如「只看内科用药」。这时候列表的排序逻辑就变成了:
用户点了「按优先级」→ 调一次 sort用户又点了「按科室」→ 再调一次 sort
看起来完全正常。但如果 sort 不稳定,第二次排序会把第一次的结果搅乱。
什么是「稳定」
先给定义,后面所有讨论都建立在这句话上:
稳定排序:如果
a原本在b前面,且排序时a和b相等,排序之后a仍然在b前面。不稳定排序:排序之后,
a可能会出现在b的后面。
注意关键词是「相等」。稳定性讨论的从来不是「谁大谁小」,而是「一样大的时候,谁在谁前面」。
稳定性的实际影响:多键排序
为什么这件事重要?因为稳定排序是做多键排序的基础。
你要「先按科室排,再在科室内部按优先级排」,标准做法是从次要键排到主要键:
const drugs = [ { name: '药品A', dept: '内科', priority: 1 }, { name: '药品B', dept: '外科', priority: 1 }, { name: '药品C', dept: '内科', priority: 2 },];// 第一趟:按科室(次要键)排序const byDept = [...drugs].sort((a, b) => a.dept < b.dept ? -1 : a.dept > b.dept ? 1 : 0);// 第二趟:按优先级(主要键)排序const byPriority = byDept.sort((a, b) => a.priority - b.priority);跑出来的结果是:
药品A/内科/1 | 药品B/外科/1 | 药品C/内科/2注意 药品A 和 药品B 的 priority 都是 1——它们相等。因为它们在第一趟排序后 内科 在 外科 前面,而第二趟排序是稳定的,所以这个相对顺序被完整保留下来,最终 内科 的 药品A 排在 外科 的 药品B 前面。
如果第二趟排序不稳定呢?药品A 和 药品B 的先后完全可能被翻转成 药品B/外科/1 | 药品A/内科/1——业务上就变成了「同优先级的药,科室顺序乱了」。这在药品展示、订单列表、合同条款这类有明确分组语义的场景里,是肉眼可见的 bug。
一趟一个键: sort(科室) → 内科A, 外科B, 内科C sort(优先级) → 稳定:A(内科,1), B(外科,1), C(内科,2) ✅ 同优先级内科室顺序保留 → 不稳定:B(外科,1), A(内科,1), C(内科,2) ❌ 内科/外科被颠倒这就是为什么「稳定」不是一个学术概念,而是业务正确性的一部分。
ES2019 之前的混乱
更麻烦的是历史遗留。ES2019 之前,Array.prototype.sort 规范根本没有要求稳定性——每个引擎自己决定:
V8(Chrome / Node)当时用的是快排 + 短数组插入排序,不稳定 不同浏览器跑同一段代码,结果可能不一样
这意味着你的多键排序代码在 Chrome 上是对的,在别的浏览器上可能就错了,而且这种 bug 极难复现——你本地怎么跑都是对的。
ES2019 之后,TC39 在规范里明确规定 Array.prototype.sort 必须是稳定排序。所以今天你可以放心地写多键排序,不用自己带 index 做二次比较。
💬 面试官:
Array.prototype.sort是稳定的吗?从什么时候开始稳定的?✅ 标准答案:现在(ES2019 之后)规范强制要求稳定。ES2019 之前规范没有规定,各引擎实现不同——V8 当时用的是不稳定的快速排序,所以同样的代码在不同浏览器上可能出现「相等元素的相对顺序被改变」的差异。从 V8 v7.0 / Chrome 70 开始,V8 换成了 TimSort,稳定是它的核心特性之一。
🎁 加分答案:能补三点——① 稳定性对多键排序是硬需求:先按次要键排、再按主要键排,主键相等时靠稳定性保留次键顺序,不用写「携带原始 index 做二次比较」的兜底代码;② 老代码里常见的
arr.map((v,i)=>[v,i]).sort(...)这种写法,就是为了在不稳定引擎上模拟稳定排序,现在可以删掉了;③ 能顺带说一句「Array.prototype.toSorted(ES2023)返回新数组、不改原数组,但稳定性要求和sort一致」。
二、排序基础:稳定性 / 内外部排序 / 复杂度全景
在逐个拆解算法之前,先把几个贯穿全篇的基础概念讲清。
常见的排序算法
前端需要认识的十大经典排序:
冒泡排序 选择排序 插入排序 希尔排序 归并排序 快速排序 堆排序 计数排序 桶排序 基数排序等
这十个可以按「复杂度档位」分成三组,后面三节就按这个顺序推进:
平方阶 O(n²):冒泡、选择、插入(希尔介于 O(n²) 和 O(n log n) 之间) 线性对数阶 O(n log n):快排、归并、堆 线性阶 O(n):计数、桶、基数(这三个不靠比较)
时间复杂度与空间复杂度
时间复杂度:对排序数据的总操作次数,反映当 n 变化时,操作次数呈现什么规律。
平方阶 O(n²):各类简单排序——直接插入、直接选择和冒泡排序线性对数阶 O(n log₂n):快速排序、堆排序和归并排序O(n^(1+§)),§ 是介于 0 和 1 之间的常数:希尔排序线性阶 O(n):基数排序,此外还有桶、箱排序
空间复杂度:算法在计算机内执行时所需存储空间的度量,它也是数据规模 n 的函数。
这里有两个名词必须记住,因为它们会直接出现在面试答案里:
In-place(原地):占用常数内存,不占用额外内存 Out-place(非原地):占用额外内存
先记住一句话:快排、堆排、冒泡、选择、插入、希尔是 In-place;归并、计数、桶、基数是 Out-place。这个区分在「内存敏感场景该选谁」的追问里是直接得分点。
复杂度全景表
下面这张表把十种排序放一起,是面试前最该背下来的一张图:
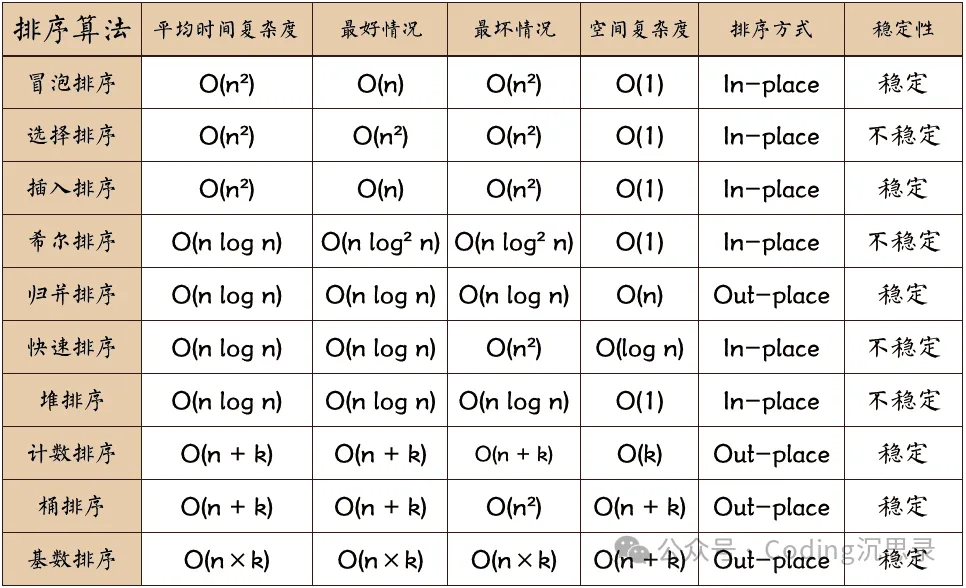
图里几个名词解释:
n:数据规模k:「桶」的个数
稳定性:谁稳定,谁不稳定
稳定的排序算法:冒泡排序、插入排序、归并排序、基数排序(还有计数排序、桶排序,表里标注都是稳定)。
不稳定的排序算法:选择排序、快速排序、希尔排序、堆排序。
这个清单不要死记,要用「它有没有做过远距离的交换」来理解。下面这张表把「谁稳定、为什么」一次讲清:
一句话记牢:凡是只做「相邻」操作的都稳定,凡是做「远距离/跳跃」交换的都不稳定。 后面第四节会逐个给出具体反例,这里先建立直觉。
内排序 vs 外排序
内排序:所有排序操作都在内存中完成 外排序:由于数据太大,把数据放在磁盘中,排序通过磁盘和内存的数据传输才能进行
今天你写的 arr.sort() 全是内排序——数据都在内存里。但外排序并不是「只有后端才需要」的东西:当你要处理一份几十万行的药品导入 Excel,一次性全读进内存会撑爆标签页,正确的做法就是分片读入 → 每片内存排序 → 多路归并写出,这就是标准的外排序思路。
一套可复用的比较抽象
工具函数,先放在这里,后面每段代码都会用到它:
exportenum Compare { LESS_THAN = -1, BIGGER_THAN = 1, EQUAL = 0}export const defaultCompare = (a: any, b: any) => { if(a === b) {return Compare.EQUAL; } return a < b ? Compare.LESS_THAN : Compare.BIGGER_THAN;}export functionswap(array: any[], a: number, b: number) {/* const temp = array[a]; array[a] = array[b]; array[b] = temp; */ [array[a], array[b]] = [array[b], array[a]];}expor tfunctionreverseCompare(compareFn: Function): Function{ return(a: any, b: any) => compareFn(b, a);}export functionfindMaxValue(array: any[], compareFn: Function = defaultCompare) { if(array && array.length) {let max = array[0];for (let i = 1; i < array.length; i++){if(compareFn(max, array[i]) === Compare.LESS_THAN) { max = array[i]; } }return max; } return undefined;}export functionfindMinValue(array: any[], compareFn: Function = defaultCompare) { return findMaxValue(array, reverseCompare(compareFn));}这段代码里有个非常值得学的设计:**reverseCompare 把「逆序」抽象成了「把比较函数的入参交换」**。这样一来,「升序排」和「降序排」不需要写两份算法,只要换一个比较器就行——这正是第 1 篇讲的 ADT(抽象数据类型)思想:算法只依赖「比较接口」,不依赖「比较实现」。
findMinValue 更是把「找最小」直接复用成「把比较器反过来后找最大」,一行代码搞定。
📚 知识点:这就是策略模式在算法库里的经典用法——把会变的部分(比较规则)抽出来作为参数传入,把不变的部分(排序流程)固定在算法里。React 的
shouldComponentUpdate、Array.prototype.sort的compareFn、Java 的Comparator,底层都是同一个思路。
💬 面试官:选择排序为什么不稳定?举个例子说明。
✅ 标准答案:选择排序每轮会找到最小值,然后和当前位置做一次远距离交换。如果被换走的那个元素是「和某个相等元素成对出现的」,它就会被交换到相等元素的后面,相对顺序被破坏。例如
[5a, 5b, 2]:第一轮找到最小值2,和下标 0 的5a交换,数组变成[2, 5b, 5a]——原本5a在5b之前,现在5a跑到了5b后面,稳定性被破坏。
🎁 加分答案:能总结出「稳定性的本质是:算法有没有让相等元素发生远距离、跨越式的移动」。冒泡、插入只做相邻交换,相等元素永远不会越过彼此;归并、计数、基数在合并时按顺序取左边,天然稳定;而选择、快排、堆排、希尔都存在跳跃式移动,所以不稳定。能给出这个统一视角,比背「哪些稳定哪些不稳定」高一个层次。
三、简单排序(O(n²))
冒泡排序
算法思路:
比较所有相邻元素,如果第一个比第二个大,则交换它们 一轮下来,可以保证最后一个数是最大的 执行 n - 1 轮,就可以完成排序了
算法步骤:
比较相邻的元素,如果第一个比第二个大,就交换他们两个 对每一对相邻元素作同样的工作,从开始第一对到结尾的最后一对,这步做完后,最后的元素会是最大的数 针对所有的元素重复以上的步骤,除了最后一个 持续每次对越来越少的元素重复上面的步骤,直到没有任何一对数字需要比较
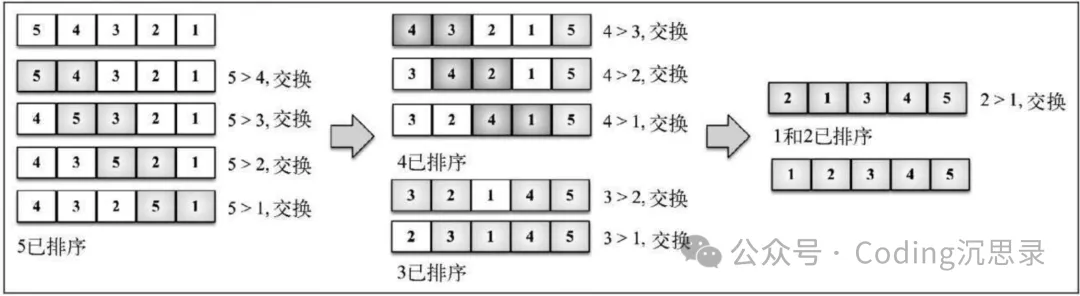
为什么要叫「冒泡」?因为每一轮里,最大的元素会像气泡一样,一步步「浮」到末尾——它每碰到一个比自己小的元素就交换一次,于是一路向后挤到最右边。
import { defaultCompare, swap, Compare } from'../../util'export functionbubble(array: Array<number>, compareFn: Function = defaultCompare): Array<number> { console.time('冒泡排序耗时'); const { length } = array; for (let i = 0; i < length; i++) {for (let j = 1; j < length - i; j++){// console.log(array[j-1], array[j])if(compareFn(array[j - 1], array[j]) === Compare.BIGGER_THAN) { swap(array, j - 1, j); } }// console.log(`i====`, i) } console.timeEnd('冒泡排序耗时'); return array;}import { describe, it } from'mocha';import { expect } from'chai';import { bubble } from'../bubble';import { defaultCompare, reverseCompare } from'../../../util';describe('冒泡排序 测试', () => { it('冒泡排序-正序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [2, 3, 4, 5, 15, 19, 26, 27, 36, 38, 44, 46, 47, 48, 50]; expect(bubble(arr)).to.be.deep.equal(res); }); it('冒泡排序-倒序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [50, 48, 47, 46, 44, 38, 36, 27, 26, 19, 15, 5, 4, 3, 2]; expect(bubble(arr, reverseCompare(defaultCompare))).to.be.deep.equal(res); });})算法分析:
两个嵌套循环 最佳情况: O(n),当输入数据已经是正序时最差情况: O(n²),当输入数据是反序时平均情况: O(n²)空间复杂度: O(1)
补一个关键细节:上面这版实现,即使数组已经有序,内层循环依然会完整跑一遍所有比较——**因为它没有「提前退出」的判断,实际耗时恒为 O(n²)**。上面说「冒泡最好情况 O(n)」,指的是加了优化开关的版本:
exportfunctionbubbleOptimized(array: number[]): number[] { for (let i = 0; i < array.length - 1; i++) {let swapped = false; // 👈 本轮是否发生过交换for (let j = 0; j < array.length - 1 - i; j++) {if (array[j] > array[j + 1]) { [array[j], array[j + 1]] = [array[j + 1], array[j]]; swapped = true; } }if (!swapped) break; // 👈 一轮下来没有任何交换,说明已有序 } return array;}有了 swapped 标记,已经有序的数组只需要跑一轮(n-1 次比较)就退出,这才是「最好情况 O(n)」的来源。这是一个极容易被面试追问的点:说「冒泡最好 O(n)」没错,但要能说清这个 O(n) 的前提是实现了提前退出。
选择排序
算法思路:
找到数组中的最小值,选中它并将其放置在第一位 接着找到第二小的值,选中它并将其放置到第二位 以此类推,执行 n - 1 轮
算法步骤:
首先在未排序序列中找到最小(大)元素,存放到排序序列的起始位置 再从剩余未排序元素中继续寻找最小(大)元素,然后放到已排序序列的末尾 重复第二步,直到所有元素均排序完毕
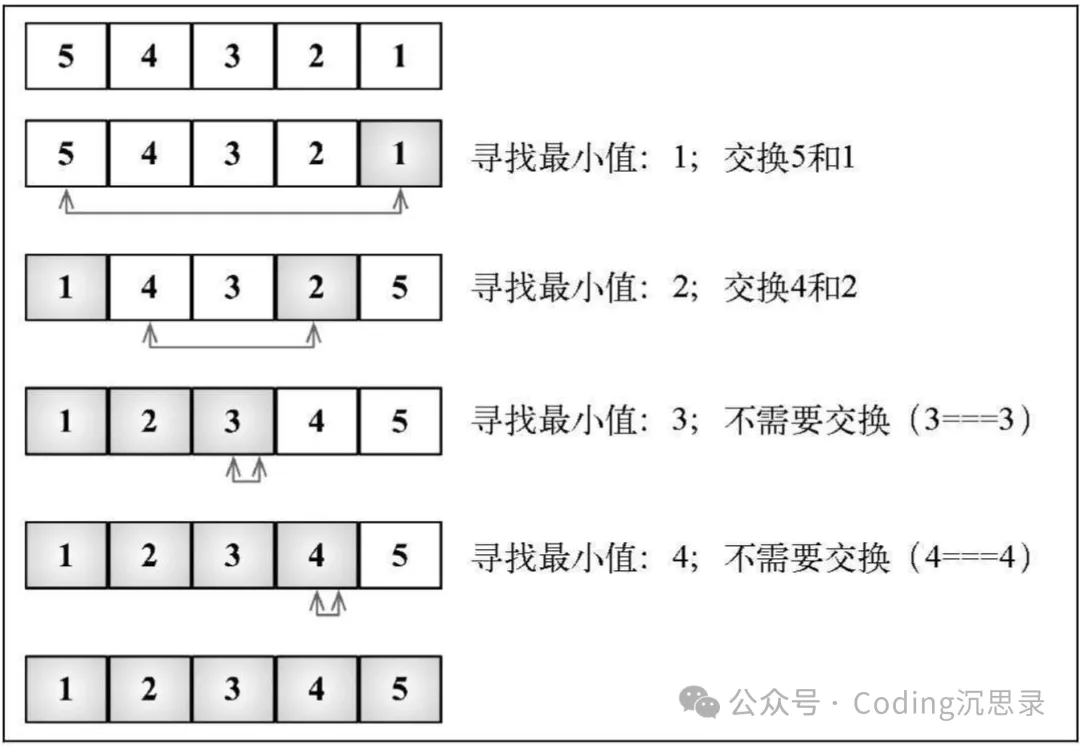
把选择排序和冒泡放在一起看,差别非常清晰:冒泡是「边找边换」,选择是「先找完再换」。选择排序每轮只交换一次,交换次数是 O(n),比冒泡的 O(n²) 次交换少得多——所以在「交换代价很大」(比如交换的是磁盘上的大对象)的场景里,选择排序反而可能更划算。
import { defaultCompare, swap, Compare } from'../../util'export functionselection(array: Array<number>, compareFn: Function = defaultCompare): Array<number> { console.time('选择排序耗时'); let minIndex; const { length } = array; for (let i = 0; i < length - 1; i++) { minIndex = i;for (let j = i + 1; j < length; j++) {// console.log(array[minIndex], array[j]);if(compareFn(array[minIndex], array[j]) === Compare.BIGGER_THAN) { minIndex = j; } }if(i !== minIndex) { swap(array, i, minIndex); }// console.log(`i ===> `, i); } console.timeEnd('选择排序耗时'); return array;}import { describe, it } from'mocha';import { expect } from'chai';import { selection } from'../selection';import { defaultCompare, reverseCompare } from'../../../util';describe('选择排序 测试', () => { it('选择排序-正序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [2, 3, 4, 5, 15, 19, 26, 27, 36, 38, 44, 46, 47, 48, 50]; expect(selection(arr)).to.be.deep.equal(res); }); it('选择排序-倒序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [50, 48, 47, 46, 44, 38, 36, 27, 26, 19, 15, 5, 4, 3, 2]; expect(selection(arr, reverseCompare(defaultCompare))).to.be.deep.equal(res); });})算法分析:
两个嵌套循环 最佳情况: O(n²)最差情况: O(n²)平均情况: O(n²)空间复杂度: O(1)
注意这里三档全是 O(n²)——选择排序没有「最好情况」。因为无论数据是否有序,它都必须完整扫描剩余元素才能确认「这是最小值」,这个扫描无法省略。这一点是它和冒泡、插入最大的区别。
不稳定性的具体反例(前面提过,这里跑一遍验证):
const arr = [{ v: 5, tag: 'A' }, { v: 5, tag: 'B' }, { v: 2, tag: 'C' }];// 第一轮:找到最小值 v=2(下标 2),和下标 0 的 {v:5,tag:'A'} 交换// 结果:[{v:2,C}, {v:5,B}, {v:5,A}]// A 和 B 相等,但 A 从 B 前面跑到了 B 后面 ❌console.log(arr.map(x => x.tag).join('')); // 输出 CBA插入排序
算法思路:
从第二个数开始往前比 比它大就往后排 以此类推进行到最后一个数
算法步骤:
从第一个元素开始,该元素可以认为已经被排序 取出下一个元素,在已经排序的元素序列中从后向前扫描 如果该元素(已排序)大于新元素,将该元素移到下一位置 重复步骤 3,直到找到已排序的元素小于或者等于新元素的位置 将新元素插入到该位置后 重复步骤 2~5
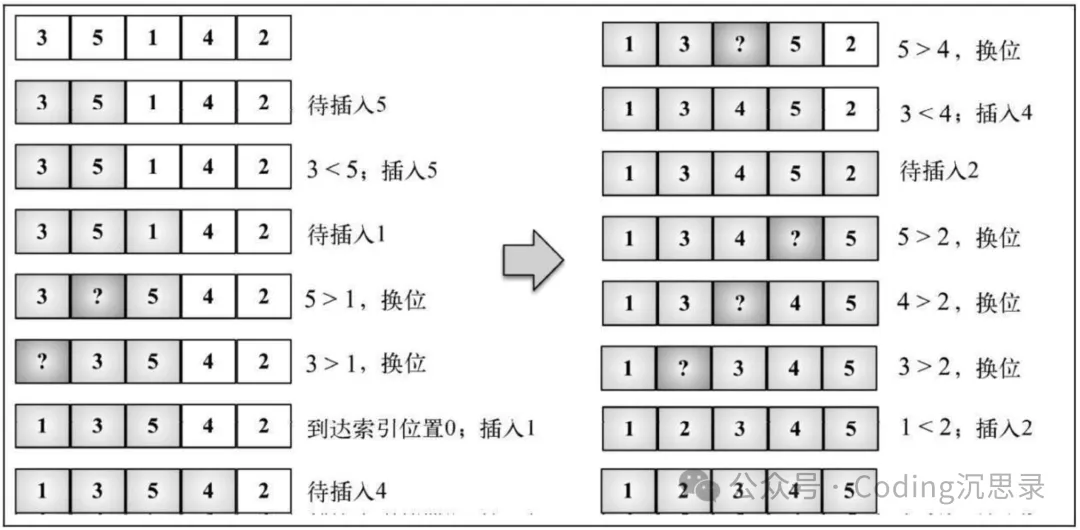
理解插入排序最好的类比是打扑克理牌:左手已经是一手排好的牌,右手每次摸一张新牌,从右往左比对,插到合适的缝隙里。左手永远是有序的——这就是「已排序区间」和「未排序区间」的划分。
import { defaultCompare, swap, Compare } from'../../util';export functioninsertion(array: Array<number>, compareFn: Function = defaultCompare): Array<number> { console.time('插入排序耗时'); const { length } = array; for (let i = 1; i < length; i++) {let j = i;const temp = array[i]; // 记录要插入的数据while(j > 0 && compareFn(array[j - 1], temp) === Compare.BIGGER_THAN) { // 从已经排序的序列最右边的开始比较,找到比其小的数// console.log(temp, array[j - 1]); array[j] = array[j - 1]; j--; } array[j] = temp; // 存在比其小的数,插入// console.log(`i ====> `, i, array); } console.timeEnd('插入排序耗时'); return array;}这段实现有个容易忽略的细节:内层循环用的是 array[j] = array[j - 1](向后赋值)而不是 swap(交换)。区别在于:交换需要三次赋值,向后赋值只需要一次——插入排序只做「搬移」,不做「交换」,常数因子更小。这是它在小数组上比冒泡快得多的直接原因。
import { describe, it } from'mocha';import { expect } from'chai';import { insertion } from'../insertion';import { defaultCompare, reverseCompare } from'../../../util';describe('插入排序 测试', () => { it('插入排序-正序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [2, 3, 4, 5, 15, 19, 26, 27, 36, 38, 44, 46, 47, 48, 50]; expect(insertion(arr)).to.be.deep.equal(res); }); it('插入排序-倒序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [50, 48, 47, 46, 44, 38, 36, 27, 26, 19, 15, 5, 4, 3, 2]; expect(insertion(arr, reverseCompare(defaultCompare))).to.be.deep.equal(res); });})算法分析:
两个嵌套循环 最佳情况: O(n),当输入数据已经是正序时——这版的 O(n) 是真实成立的,因为内层while第一次比较就失败、直接退出最差情况: O(n²),当输入数据是反序时平均情况: O(n²)空间复杂度: O(1)
这就是插入排序最值钱的地方:它天生对「基本有序」的数据敏感。数据越接近有序,内层 while 就越早退出,性能就越接近 O(n)。这个特性,正是 TimSort 把插入排序选作底层算法、以及把「自然有序段」当作第一等公民的根本原因——第七节会看到,V8 的 TimSort 里那个 BinaryInsertionSort 就是它的升级版。
希尔排序:插入排序的进化
简介:
1959 年 Shell 发明,第一个突破 O(n²) 的排序算法,是简单插入排序的改进版 它与插入排序的不同之处在于,它会优先比较距离较远的元素 希尔排序又叫缩小增量排序
算法思路:
先将整个待排序的记录序列分割成为若干子序列分别进行直接插入排序 待整个序列中的记录「基本有序」时 再对全体记录进行依次直接插入排序
算法步骤:
选择一个增量序列 t1,t2,…,tk,其中 ti > tj,tk = 1 按增量序列个数 k,对序列进行 k 趟排序 每趟排序,根据对应的增量 ti,将待排序列分割成若干长度为 m 的子序列,分别对各子表进行直接插入排序。仅增量因子为 1 时,整个序列作为一个表来处理,表长度即为整个序列的长度
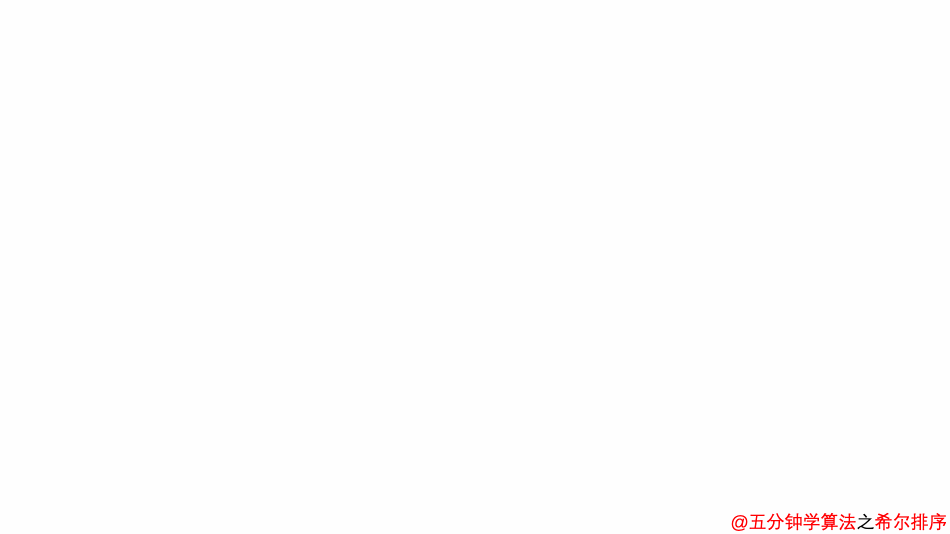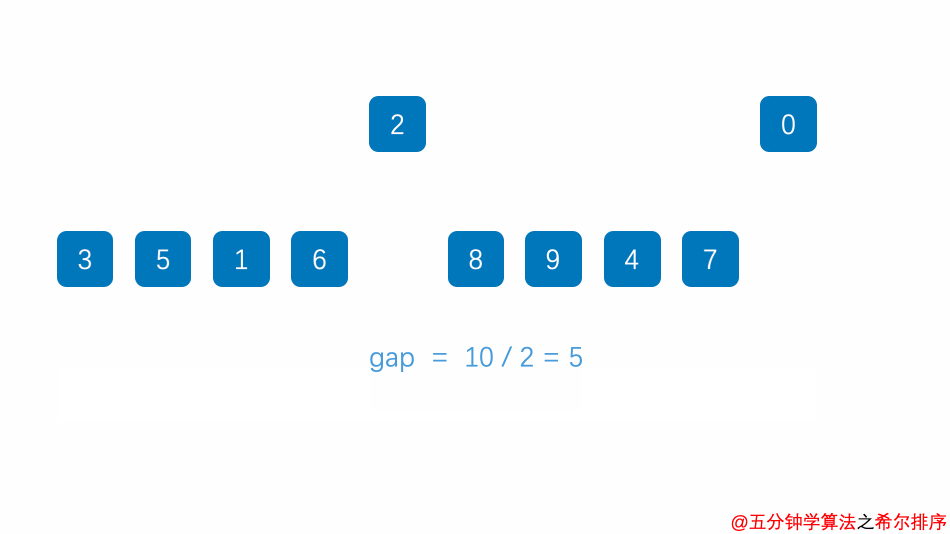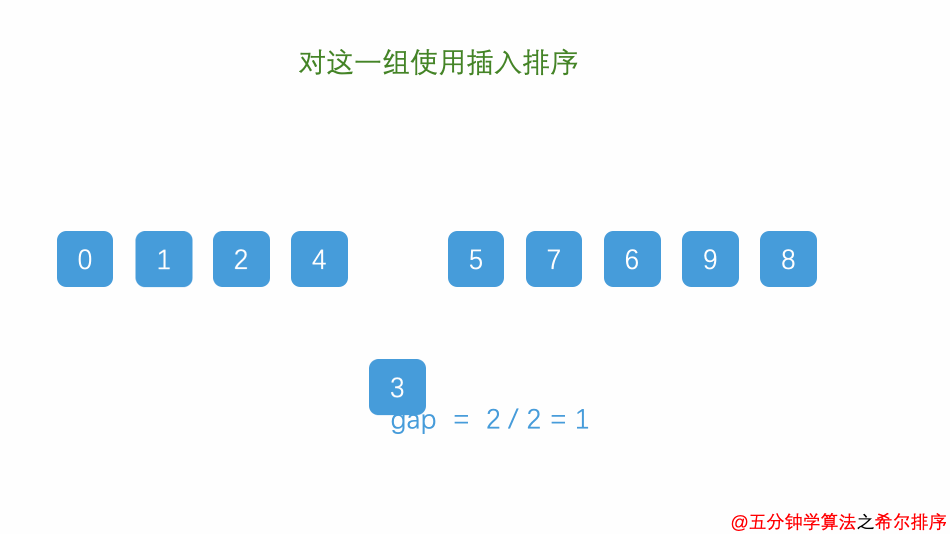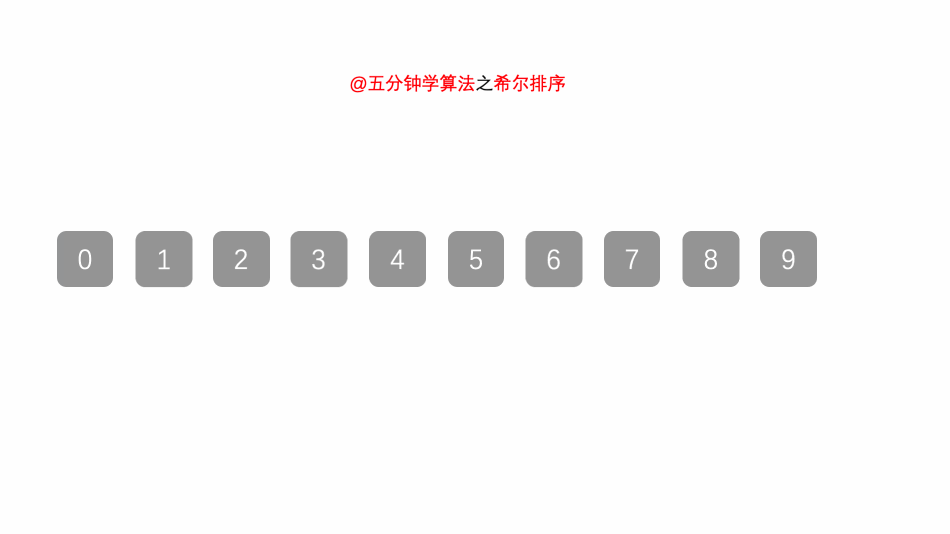
希尔排序的巧妙之处,是把上面那句话变成可执行的策略:插入排序在「基本有序」时极快,那我就先想办法让它变基本有序。做法是先按大增量做「粗调」(让远距离的元素先就位),增量逐步缩小做「精调」,最后增量退化成 1 时,整个数组已经接近有序,最后一趟插入排序几乎只做 O(n) 的扫描。
import { Compare, defaultCompare } from'../../util';export functionshell(array: any[], compareFn: Function = defaultCompare) { let increment = Math.floor(array.length / 2); while (increment > 0) {for (let i = increment; i < array.length; i++) {let j = i;const temp = array[i];while (j >= increment && compareFn(array[j - increment], temp) === Compare.BIGGER_THAN) { array[j] = array[j - increment]; j -= increment; } array[j] = temp; } increment = Math.floor(increment / 2); } return array;}把这段和上面的 insertion 对着看,你会发现结构几乎一模一样——唯一的差别是:所有出现 1 的地方,都换成了 increment。这就是「希尔排序 = 带增量的插入排序」这句话的代码级证据。
import { describe, it } from'mocha';import { expect } from'chai';import { shell } from'../shell';import { defaultCompare, reverseCompare } from'../../../util';describe('希尔排序 测试', () => { it('希尔排序-正序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [2, 3, 4, 5, 15, 19, 26, 27, 36, 38, 44, 46, 47, 48, 50]; expect(shell(arr)).to.be.deep.equal(res); }); it('希尔排序-倒序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [50, 48, 47, 46, 44, 38, 36, 27, 26, 19, 15, 5, 4, 3, 2]; expect(shell(arr, reverseCompare(defaultCompare))).to.be.deep.equal(res); });});算法分析:
最佳情况: O(nlog²n)最差情况: O(nlog²n)平均情况: O(nlogn)空间复杂度: O(1)
这里必须补一句重要的修正:希尔排序的复杂度完全由增量序列决定,不同序列的结论完全不同:
n/2, n/4, …, 1(Shell 原始序列,即上面代码) | O(n²) | |
2^k - 1(Hibbard 序列) | O(n^1.5) | |
(3^k - 1)/2(Knuth 序列) | O(n^1.5) | |
1, 5, 19, 41, 109(Sedgewick 序列) | O(n^1.33) |
上面代码用的是 Shell 原始序列(每次折半),这个序列有个著名缺陷:所有增量都是 2 的幂,彼此不互质,导致某些特殊输入下小的增量可能完全不起作用,最坏退化到 O(n²)。所以严格来说:
用 Shell 原始序列:最好/最坏 O(n²),平均约O(n^1.3)用 Hibbard / Knuth 序列:最坏 O(n^1.5)笔记里写的 O(nlog²n),对应的其实是另一种增量选择下的结论
面试时如果被问到希尔排序复杂度,最稳的回答是:「希尔排序的复杂度取决于增量序列,Shell 原始序列最坏 O(n²),Hibbard/Knuth 序列可以做到 O(n^1.5),这也是它比简单插入排序强的地方——但无论怎么选,它都不是稳定排序。」
💬 面试官:工程里为什么小数组宁可用插入排序,而不是快排?
✅ 标准答案:插入排序在 n 很小时常数因子极小——没有递归调用、没有函数栈开销、只做「向后搬移」而不做交换(每次搬移一次赋值),而且内存访问是完全顺序的、缓存命中率极高。快排虽然复杂度更优,但每次递归都有栈开销,n=10 时这个开销可能比比较本身还大。所以几乎所有生产级排序库(V8 的 TimSort、Java 的
Arrays.sort、C++ 的std::sort)都会在小数组上退化为插入排序。
🎁 加分答案:能补三个层次——① 插入排序对基本有序的数据天然敏感,数据越有序越快(接近 O(n)),这是它能当「归并/快排的底座」的本质原因;② V8 里具体怎么切的:
kMinTimSortLen = 10,元素少于 10 个直接走BinaryInsertionSort(二分查找插入位置,把「找位置」的 O(n) 降到 O(logn),但「搬移」仍是 O(n));③ 二分插入排序仍然是稳定的,源码注释原话是「if there are elements equal to pivot, left points to the first slot after them -- that's why this sort is stable」——二分会精确地把新元素插到「所有相等元素的后面」。
四、进阶排序(O(n log n))
从这一节开始,算法真正进入 O(n log n) 档位。这三个算法(归并、快排、堆排)是面试的绝对重点——既要能手写,也要能讲清各自的适用场景。
归并排序
算法思路:
分:把数组劈成两半,再递归地对子数组进行分操作,直到分成一个个单独的数 合:把两个数合并为有序数组,再对有序数组进行合并,直到全部子数组合并为一个完整数组
算法步骤:
申请空间,使其大小为两个已经排序序列之和,该空间用来存放合并后的序列 设定两个指针,最初位置分别为两个已经排序序列的起始位置 比较两个指针所指向的元素,选择相对小的元素放入到合并空间,并移动指针到下一位置 重复步骤 3 直到某一指针达到序列尾 将另一序列剩下的所有元素直接复制到合并序列尾
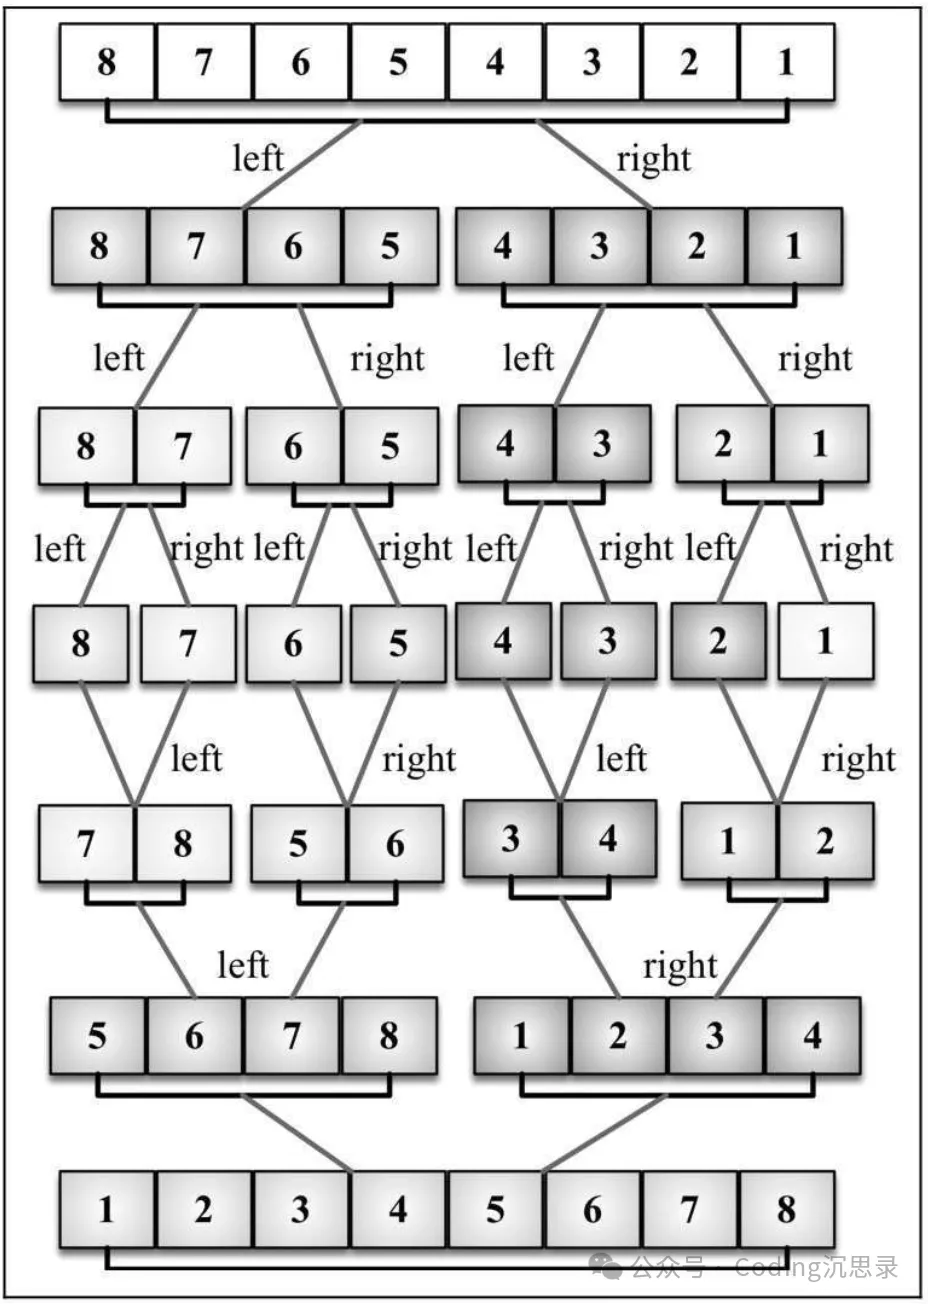
看图时的两个关键观察:
「分」是自上而下画的(从顶部的完整数组一分为二、二分为四),但「合」是自下而上执行的(先两两合并成有序小段,再四四合并,最后整体合并) 每一步「合」,合并的都是两个已经有序的片段——这才是合并能 O(n) 完成的前提
import { defaultCompare, swap, Compare } from'../../util';const mergeSort = (left: Array<number>, right: Array<number>, compareFn: Function) => { const result: number[] = []; let l = 0; let r = 0; while(l < left.length && r < right.length) { result.push(compareFn(left[l], right[r]) === Compare.BIGGER_THAN ? right[r++] : left[l++]) } return result.concat(l < left.length ? left.slice(l) : right.slice(r));}export functionmerge(array: Array<number>, compareFn: Function = defaultCompare): Array<number> { if(array.length > 1) {// 分const { length } = array;const middle = Math.floor(length / 2);const left = merge(array.slice(0, middle), compareFn);const right = merge(array.slice(middle), compareFn);// 合 array = mergeSort(left, right, compareFn); } return array;}归并排序的稳定性就藏在这一行里:
result.push(compareFn(left[l], right[r]) === Compare.BIGGER_THAN ? right[r++] : left[l++])只有当 left[l]严格大于right[r](BIGGER_THAN)时,才取右边的元素。也就是说,当左右两边元素相等时,走的是 else 分支,取左边的。左边那一段在原数组中本来就在右边那段的前面——「相等时优先取左边的」这一条规则,就是稳定性的全部来源。
import { describe, it } from'mocha';import { expect } from'chai';import { merge } from'../merge';import { defaultCompare, reverseCompare } from'../../../util';describe('归并排序 测试', () => { it('归并排序-正序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [2, 3, 4, 5, 15, 19, 26, 27, 36, 38, 44, 46, 47, 48, 50]; expect(merge(arr)).to.be.deep.equal(res); }); it('归并排序-倒序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [50, 48, 47, 46, 44, 38, 36, 27, 26, 19, 15, 5, 4, 3, 2]; expect(merge(arr, reverseCompare(defaultCompare))).to.be.deep.equal(res); });})算法分析:
「分」的层数是 O(logn)(每次砍一半,共 log n 层),每一层的切片操作加起来是O(n)「合」的时间复杂度是 O(n)——每一层合并都要把所有 n 个元素过一遍两者相乘,总时间就是 O(nlogn)最佳情况: O(nlogn)最差情况: O(nlogn)平均情况: O(nlogn)空间复杂度: O(n)——合并时需要额外的临时数组
注意「三档全是 O(n log n)」这一点:归并排序的性能完全不依赖输入数据的样子——无论已排序、逆序还是随机,都是 n log n。这既是优点(没有性能悬崖、可预测),也是缺点(已经有序也不会更快,白白浪费了信息)。
快速排序
算法思路:
分区:从数组中任意选择一个「基准」,所有比基准小的元素放在基准前面,比基准大的元素放在基准后面 递归:递归地对基准前后的子数组进行分区
算法步骤:
从数列中挑出一个元素,称为「基准」(pivot) 重新排序数列,所有元素比基准值小的摆放在基准前面,所有元素比基准值大的摆在基准的后面(相同的数可以到任一边)。在这个分区退出之后,该基准就处于数列的中间位置。这个称为分区(partition)操作 递归地把小于基准值元素的子数列和大于基准值元素的子数列排序
下面是完整的分区推演过程,五张图连着看,就是一个数组被快排彻底排好的全过程:
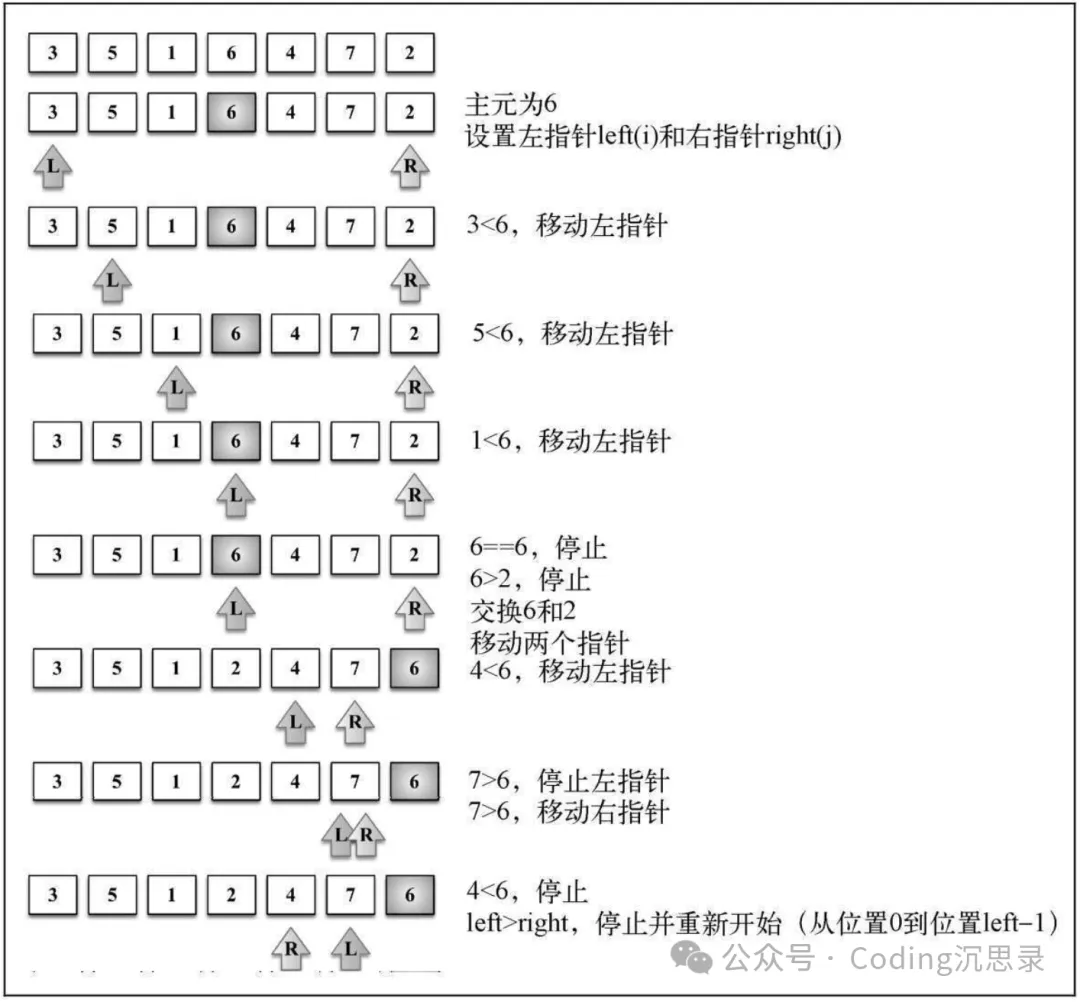
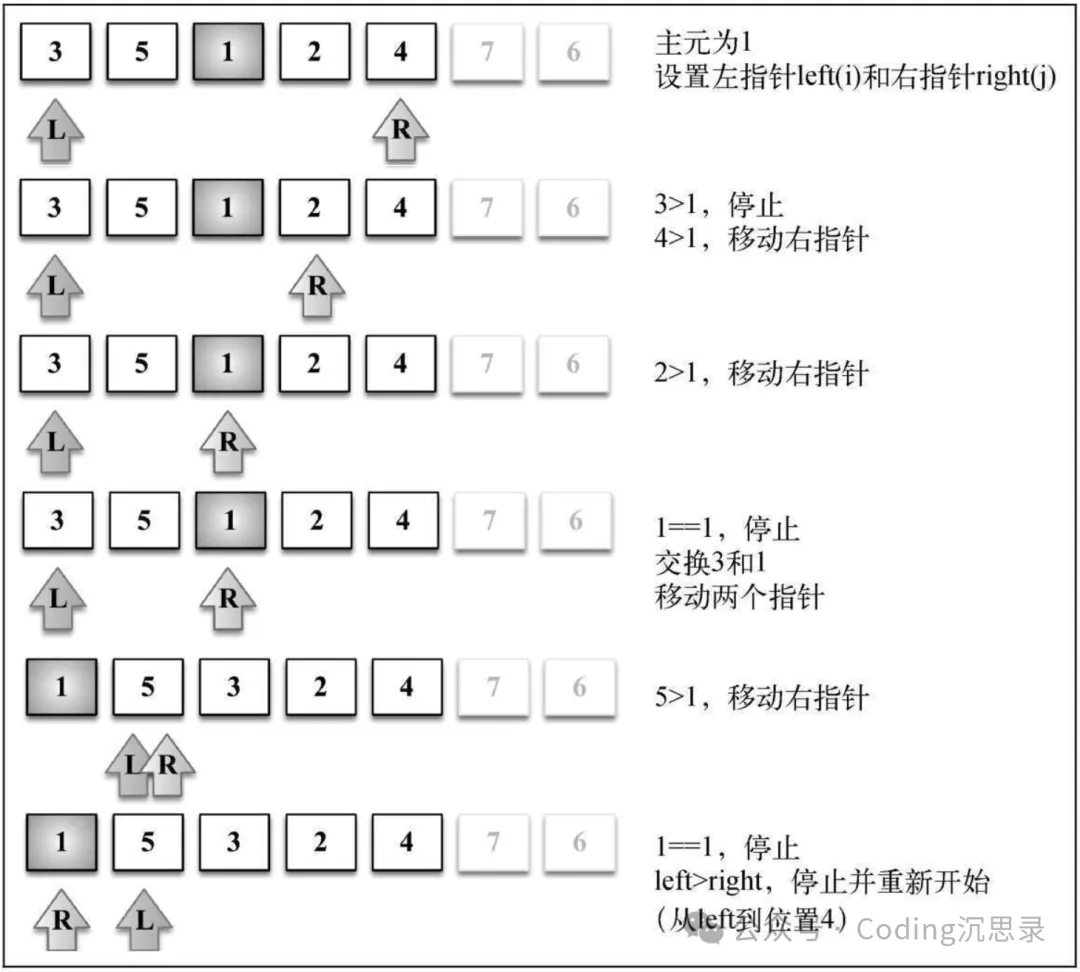
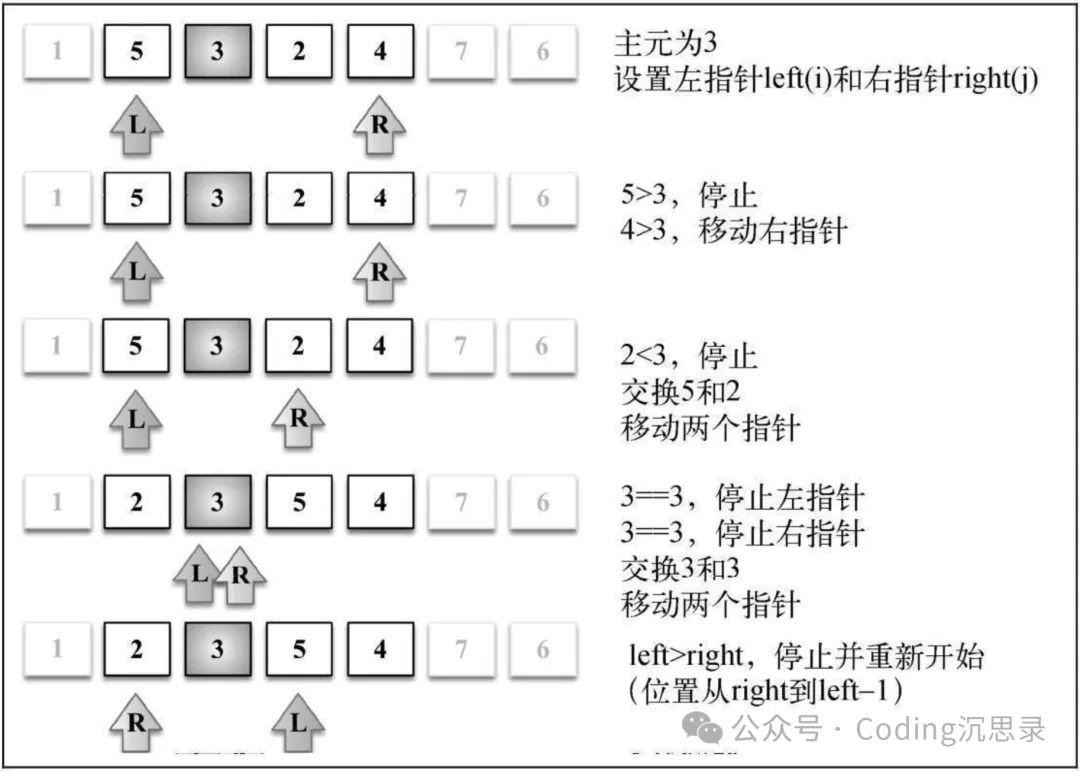
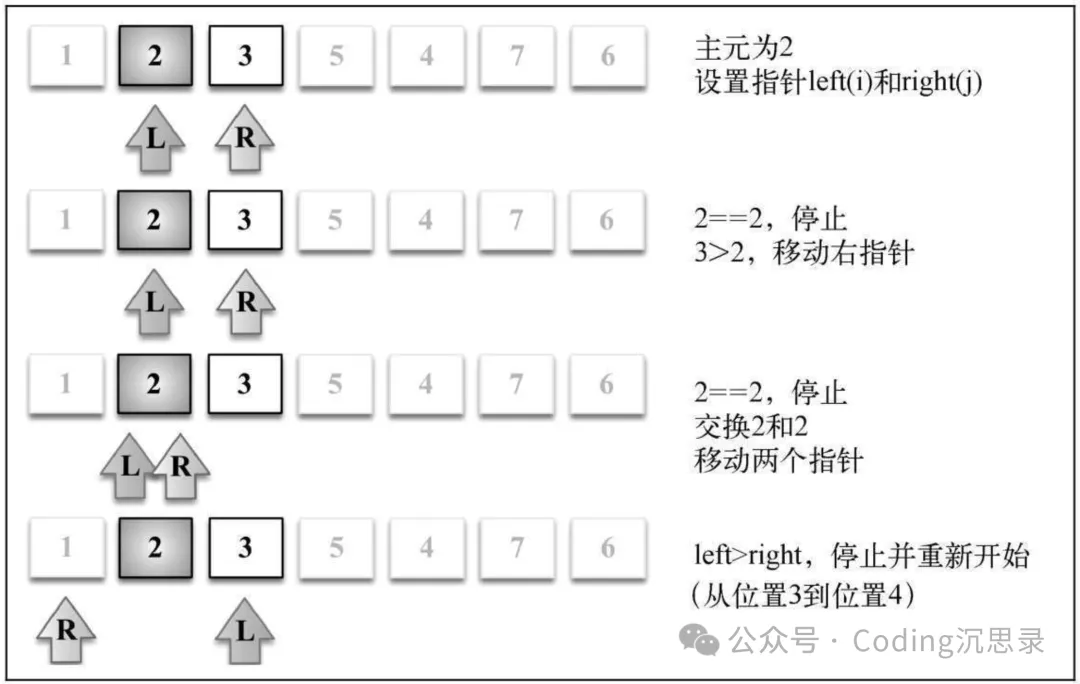
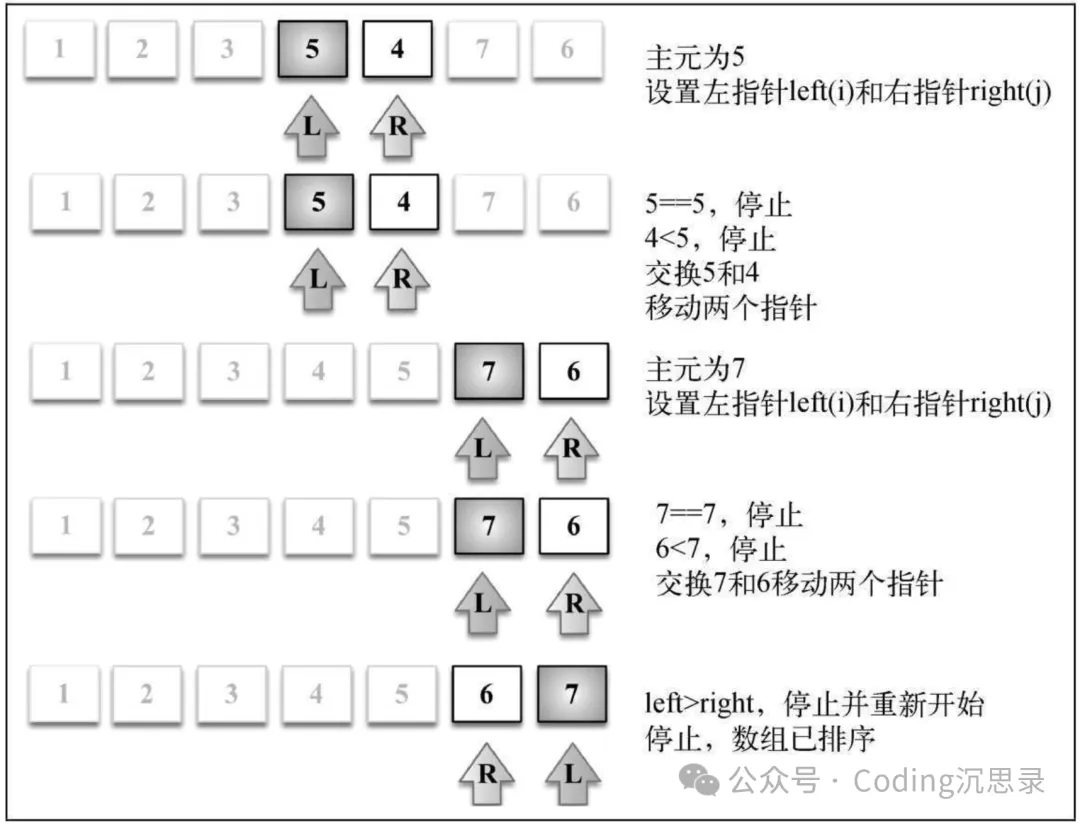
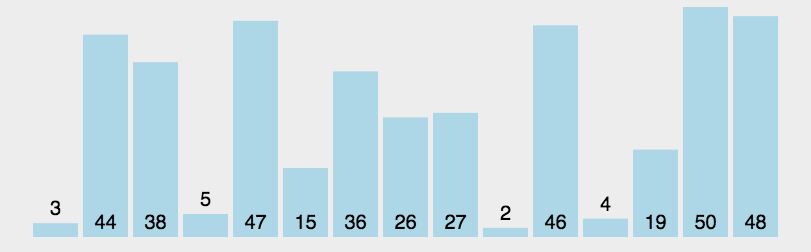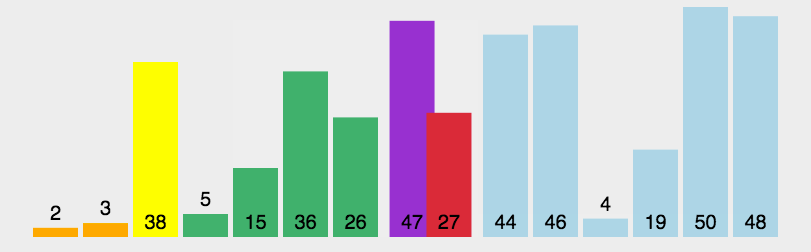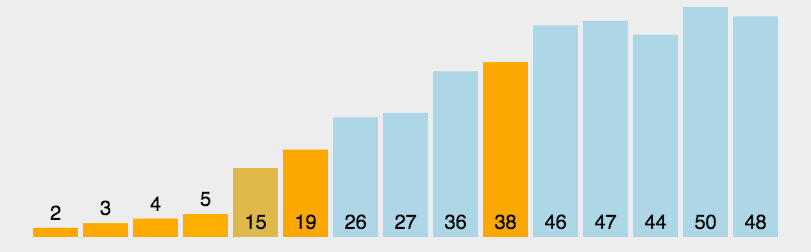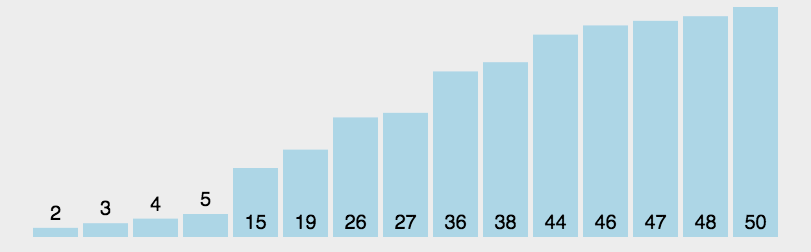
快排和归并的分工正好相反:
归并是「先分后合」:不管数据什么样子,先无脑劈开,代价在「合」的时候花在合并上 快排是「先治后分」:先用一次分区把数据按基准分成两半,这一次分区做完了,基准就在最终位置上了,然后再分别处理两边
这也解释了两者的空间差异:归并需要额外的 O(n) 数组来「合」,快排的分区是原地完成的,只需要递归栈。
// 方法一export functionquick(array: Array<number>): Array<number> { console.time('快速排序耗时'); const rec = (arr: Array<number>): Array<number> => {if(arr.length <= 1) { return arr; }const left = [];const right = [];const pivot = arr[0];for (let i = 1; i < arr.length; i++) {const temp = arr[i]; temp < pivot ? left.push(temp) : right.push(temp); }return [...rec(left), pivot, ...rec(right)] } const result = rec(array); console.timeEnd('快速排序耗时'); return result;}方法一最好懂,但它是非原地的——每层递归都要新建 left 和 right 两个数组,它们加起来正好是「当前子数组的长度」,所以空间是 O(n) 起步(平均情况下递归树深度 log n,但同一时刻持有的一层就是 n,峰值取最大的一层)。同时它每次都固定取 arr[0] 当基准,遇到已排序数组会退化成最坏情况——**这时候递归深度变成 n,空间也跟着涨到 O(n²)**。
换句话说:「快排原地」这句话只对方法二成立,方法一(left/right 数组版)恰恰是典型的 out-place 实现。
方法二是原地、双指针、基准取中间:
// 方法二import { defaultCompare, swap, Compare } from'../../util';const quickSort = (array: number[], left: number, right: number, compareFn: Function) => { let index; if(array.length > 1) { index = partition(array, left, right, compareFn);if(left < index - 1) { quickSort(array, left, index - 1, compareFn); }if(index < right) { quickSort(array, index, right, compareFn) } } return array;}// 分区操作const partition = (array: number[], left: number, right: number, compareFn: Function) => { const pivot = array[Math.floor((right + left) / 2)]; let i = left; let j = right; while(i <= j) {while(compareFn(array[i], pivot) === Compare.LESS_THAN) { i++; }while(compareFn(array[j], pivot) === Compare.BIGGER_THAN) { j--; }if(i <= j) { swap(array, i, j); i++; j--; } } return i;}export functionquick(array: Array<number>, compareFn: Function = defaultCompare): Array<number> { return quickSort(array, 0, array.length - 1, compareFn);}方法二的分区逻辑是左右夹逼:左指针 i 一直右移,直到遇到一个 ≥ 基准的元素停下;右指针 j 一直左移,直到遇到一个 ≤ 基准的元素停下;两个都停了就交换,然后继续。两个指针相遇(i > j)时,i 就是分区点——基准左边的都 ≤ 基准,右边的都 ≥ 基准。
import { describe, it } from'mocha';import { expect } from'chai';import { quick } from'../quick';import { defaultCompare, reverseCompare } from'../../../util';describe('快速排序 测试', () => { it('快速排序-正序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [2, 3, 4, 5, 15, 19, 26, 27, 36, 38, 44, 46, 47, 48, 50]; expect(quick(arr)).to.be.deep.equal(res); }); it('快速排序-倒序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [50, 48, 47, 46, 44, 38, 36, 27, 26, 19, 15, 5, 4, 3, 2]; expect(quick(arr, reverseCompare(defaultCompare))).to.be.deep.equal(res); });})算法分析:
递归时间复杂度是: O(logn)分区时间复杂度是: O(n)最佳情况: O(nlogn)——每次都恰好平分最差情况: O(n²)——每次分区都极不均衡平均情况: O(nlogn)空间复杂度:**方法一平均 O(n)、最坏O(n²);方法二平均O(logn)、最坏O(n)**(均为递归栈 / 临时数组随递归深度的累加)
这里必须把「最坏情况」讲透,因为这是快排面试的第一追问。
最坏情况什么时候触发?当基准每次都是当前区间的最值时,分区会退化成「一个空区间 + 一个 n-1 长的区间」,递归深度变成 n,总代价退化到 O(n²)。最典型的两个触发场景:
场景 A:数组已经有序,基准固定取第一个元素 [1, 2, 3, 4, 5, 6, 7, 8] ↑ 基准取 1 → 分区后左边空、右边 [2..8] ← 完全没分 ↑ 基准取 2 → 左边空、右边 [3..8] ← 又没分 ... ✅ 递归深度 = 7,比较次数 ≈ 1+2+...+7 = O(n²)场景 B:数组全部元素相同 [5, 5, 5, 5, 5, 5, 5, 5] ↑ 每个元素都不严格小于也不严格大于基准,两个指针永远不移动 ↑ 经典双指针实现会在这里死循环或退化怎么解决?三种手段:
随机化基准: pivot = arr[Math.floor(Math.random() * (r - l + 1)) + l]——把「最坏情况」从「必然发生」变成「概率极低」,这是最常用的一招(912 题就靠它过)三数取中:取 arr[left]、arr[mid]、arr[right]的中位数当基准——对「已排序 / 已逆序」这类最常见的退化输入直接免疫三路分区:把数组分成 < pivot、== pivot、> pivot三段——对「大量重复元素」直接免疫,一次分区就把所有相等的元素全部归位(第七节的 75 题就是这个思想)
912 排序数组 这道题就是在考这三招:朴素实现的快排会直接 TLE,必须加随机化或三路分区。第八节会给出完整题解。
为什么快排不稳定? 因为分区时的交换是跨区间的:左边找到一个大元素、右边找到一个小元素,这两个位置隔着任意多的元素,一次交换就可能让相等元素的相对顺序翻转。而分区过程中还会出现「基准元素被交换到中间位置」这种额外扰动。
堆排序
简介:
堆排序(Heap Sort)是指利用堆这种数据结构所设计的一种排序算法 堆积是一个近似完全二叉树的结构,并同时满足堆积的性质:即子结点的键值或索引总是小于(或者大于)它的父节点
算法思路:
堆排序可以说是一种利用堆的概念来排序的选择排序。分为两种方法:
大顶堆:每个节点的值都大于或等于其子节点的值,在堆排序算法中用于升序排列 小顶堆:每个节点的值都小于或等于其子节点的值,在堆排序算法中用于降序排列
为什么「大顶堆 → 升序」?因为大顶堆的堆顶永远是当前最大值。把堆顶换到数组末尾,末尾就是最大值——反复「取最大值放到末尾」,自然得到升序。
算法步骤:
将初始待排序关键字序列 (R1, R2…. Rn) 构建成大顶堆,此堆为初始的无序区 将堆顶元素 R[1] 与最后一个元素 R[n] 交换,此时得到新的无序区 (R1, R2, ……Rn-1) 和新的有序区 (Rn), 且满足 R[1, 2…n-1] <= R[n] 由于交换后新的堆顶 R[1] 可能违反堆的性质,因此需要对当前无序区 (R1, R2, ……Rn-1) 调整为新堆,然后再次将 R[1] 与无序区最后一个元素交换,得到新的无序区 (R1, R2…. Rn-2) 和新的有序区 (Rn-1, Rn)。不断重复此过程直到有序区的元素个数为 n-1,则整个排序过程完成
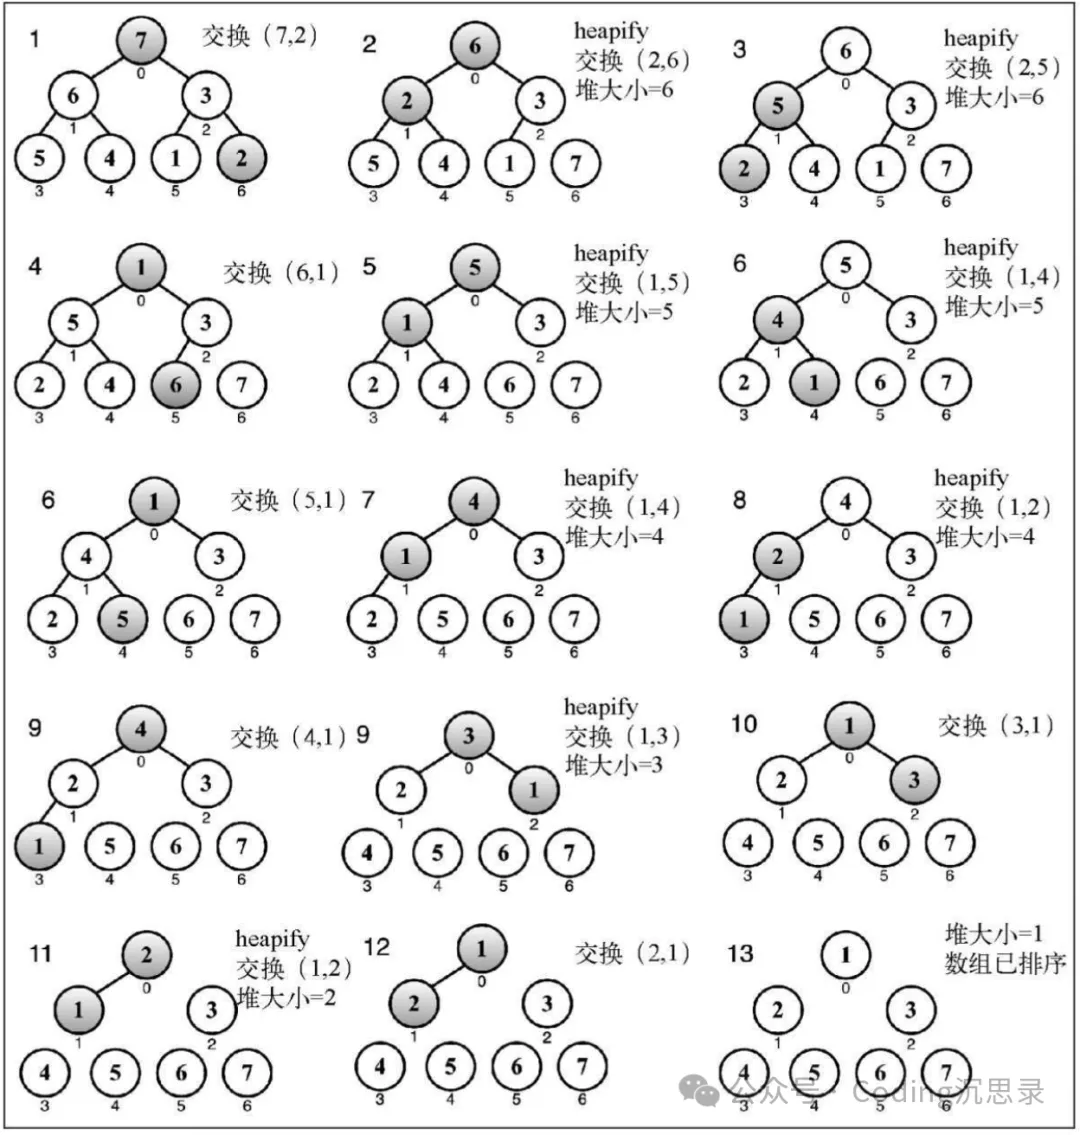
import { defaultCompare, swap, Compare } from'../../util';const buildMaxHeap = (array: any[], compareFn: Function) => { for (let i = Math.floor(array.length / 2); i >=0; i--) { heapify(array, i, array.length, compareFn); } return array;}const heapify = (array: any[], index: number, heapSize: number, compareFn: Function) => { let largest = index; const left = (2 * index) + 1; const right = (2 * index) + 2; if(left < heapSize && compareFn(array[left], array[index]) === Compare.BIGGER_THAN) { largest = left; } if(right < heapSize && compareFn(array[right], array[largest]) === Compare.BIGGER_THAN) { largest = right; } if(largest !== index) { swap(array, index, largest); heapify(array, largest, heapSize, compareFn); }}export functionheap(array: any[], compareFn: Function = defaultCompare) { let heapSize = array.length; buildMaxHeap(array, compareFn); while(heapSize > 1) { swap(array, 0, --heapSize); heapify(array, 0, heapSize, compareFn); } return array;}这段代码和第 8 篇堆:优先队列/Top-K/数据流中位数手写最小堆(面试收藏级)手写的堆是同一套东西,只是这里用的是**递归版 heapify**(第 8 篇用的是循环版 siftDown)。两者完全等价。
buildMaxHeap 的起始下标是 Math.floor(array.length / 2)——从最后一个非叶子节点倒着往前堆化。为什么从倒数第二层开始?因为叶子节点天然就是合法的堆(没有子节点可违反),不用处理。这个和第 8 篇讲的「O(n) 建堆」完全一致。
import { describe, it } from'mocha';import { expect } from'chai';import { heap } from'../heap';import { defaultCompare, reverseCompare } from'../../../util';describe('堆排序 测试', () => { it('堆排序-正序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [2, 3, 4, 5, 15, 19, 26, 27, 36, 38, 44, 46, 47, 48, 50]; expect(heap(arr)).to.be.deep.equal(res); }); it('堆排序-倒序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [50, 48, 47, 46, 44, 38, 36, 27, 26, 19, 15, 5, 4, 3, 2]; expect(heap(arr, reverseCompare(defaultCompare))).to.be.deep.equal(res); });});算法分析:
最佳情况: O(nlogn)最差情况: O(nlogn)平均情况: O(nlogn)空间复杂度: O(1)
堆排序为什么不稳定? 两个地方都在做「远距离搬运」:
建堆阶段, heapify会把父子节点交换——父节点在下标i,子节点在2i+1,中间隔着好几层排序阶段更明显: swap(array, 0, --heapSize)把堆顶和当前末尾元素交换——这两个位置在数组上相隔整个未排序区间
所以相等元素的相对顺序随时可能被破坏。
💬 面试官:快速排序的最坏情况是 O(n²),什么情况会触发?怎么避免?
✅ 标准答案:最坏情况发生在每次分区都极不均衡时——基准恰好是当前区间的最大或最小值,导致分区退化成「一边为空、一边 n-1 长」,递归深度变成 n,总代价退化到 O(n²)。最典型的触发场景是数组已经有序(或完全逆序),而基准固定取第一个或最后一个元素。避免手段有三种:① 随机化基准,让最坏情况从「必然」变成「概率可忽略」;② 三数取中(取首、中、尾三个数的中位数当基准),对已排序/逆序输入直接免疫;③ 三路分区,把数组分成小于、等于、大于基准三段,对大量重复元素的输入也免疫。
💬 面试官:快排和归并排序的稳定性怎样?各自适合什么场景?
✅ 标准答案:归并稳定、快排不稳定。归并在合并时「相等优先取左边那一段」,所以稳定;快排的分区交换是跨区间的,可能让相等元素翻转顺序。选型上:归并适合需要稳定、或者数据不能随机访问(链表)的场景,代价是 O(n) 额外空间;快排适合数据量大、内存敏感、且不需要稳定性的场景,原地、常数因子小、缓存友好,实际速度通常最快。
🎁 加分答案:能补四个判断维度——① 链表排序首选归并,因为链表没法 O(1) 随机访问,快排的分区需要频繁随机访问元素(第 148 题就是这个原因);② 数据量极大超出内存时用归并(外排序),因为归并可以「分片排序 + 多路归并」,而快排必须先全量载入;③ 要稳定且有大量重复键时,可以用三路分区的快排 + 额外带下标兜底,或者直接用归并 / 计数类排序;④ 工程里几乎没人只用纯快排——C++
std::sort是内省排序(快排 + 堆排 + 插入)、V8 用的是混合归并,因为「单一算法」在真实数据上总有一类输入会踩到它的短板。
五、线性排序(O(n),非比较)
前面六个算法都在「比较」,所以被 O(n log n) 的下界锁死(下一节会给出证明)。但排序不一定非要比较——如果你知道元素的取值范围,就可以直接「按值放位置」,完全跳过比较。这就是线性排序。
计数排序
简介:
计数排序不是基于比较的排序算法,其核心在于将输入的数据值转化为键存储在额外开辟的数组空间中 作为一种线性时间复杂度的排序,计数排序要求输入的数据必须是有确定范围的整数 计数排序是一种稳定的排序算法
算法思路:
计数排序使用一个额外的数组 C,其中第 i 个元素是待排序数组 A 中值等于 i 的元素的个数 然后根据数组 C 来将 A 中的元素排到正确的位置 它只能对整数进行排序
算法步骤:
找出待排序的数组中最大和最小的元素 统计数组中每个值为 i 的元素出现的次数,存入数组 C 的第 i 项 对所有的计数累加(从 C 中的第一个元素开始,每一项和前一项相加) 反向填充目标数组:将每个元素 i 放在新数组的第 C(i) 项,每放一个元素就将 C(i) 减去 1
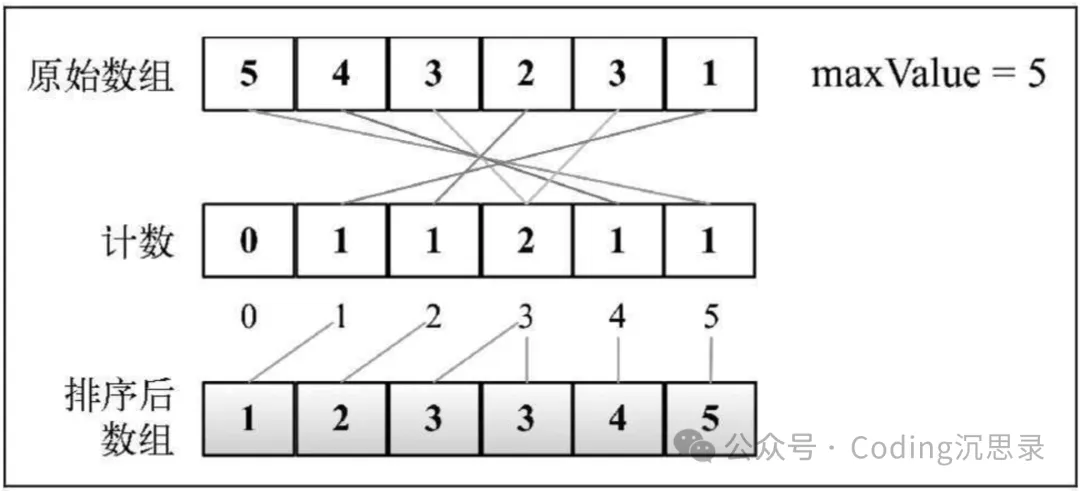
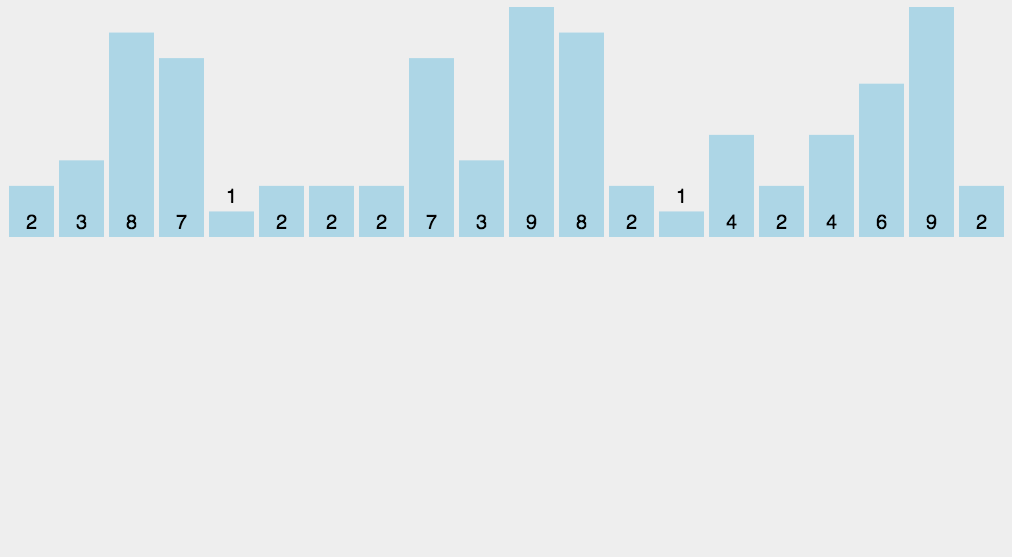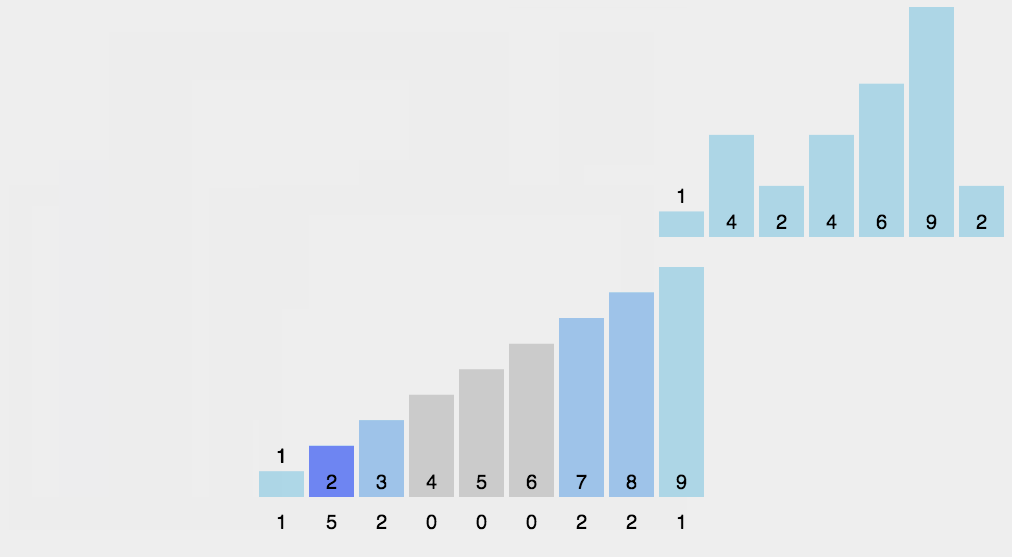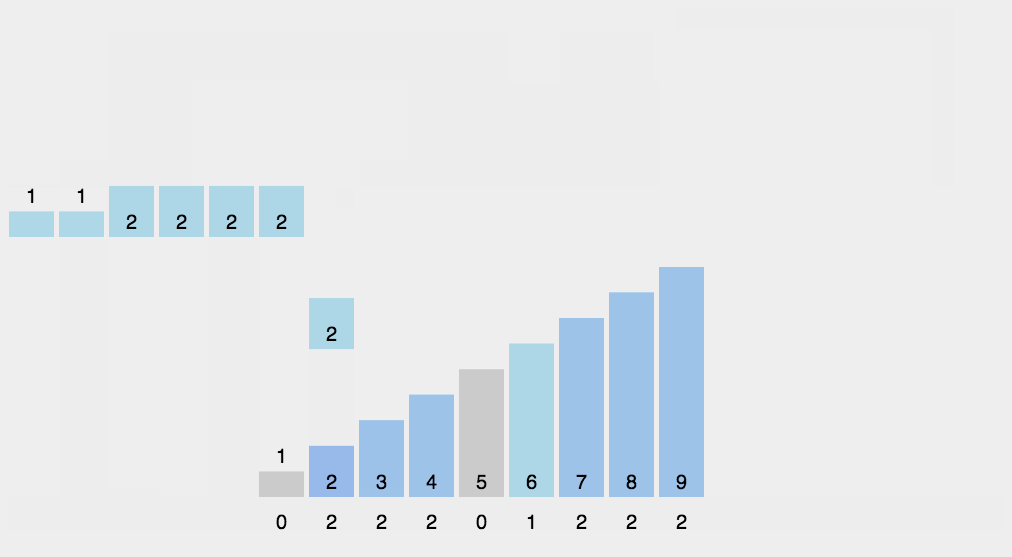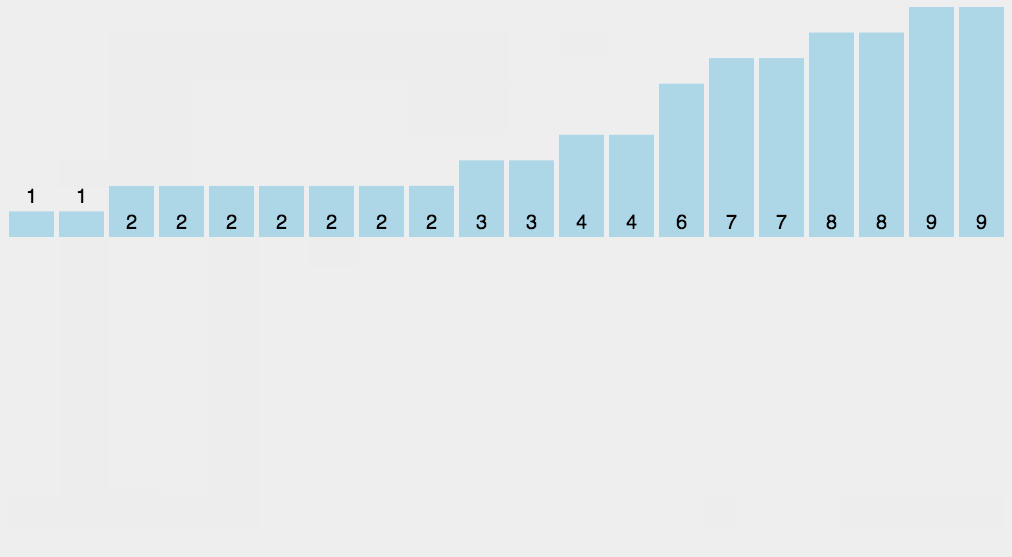
计数排序的思想极简:「我不告诉你谁大谁小,我只数每个值出现了几次,然后按值的顺序把它们摆出来」。比如 [4,2,2,8,3,3,1],值 1 出现 1 次、2 出现 2 次、3 出现 2 次、4 出现 1 次、8 出现 1 次——那我直接从 1 摆到 8 就行,全程没做一次「比较」。
import { findMaxValue } from'../../util';export functioncounting(array: any[]) { if(array.length < 2) return array; const maxValue = findMaxValue(array); // 最大值 let sortedIndex = 0; const counts = new Array(maxValue + 1); array.forEach(v => {if(!counts[v]) { counts[v] = 0; } counts[v]++; }); counts.forEach((v, i) => {while(v > 0) { array[sortedIndex++] = i; v--; } }); return array;}import { describe, it } from'mocha';import { expect } from'chai';import { counting } from'../counting';describe('计数排序 测试', () => { it('计数排序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [2, 3, 4, 5, 15, 19, 26, 27, 36, 38, 44, 46, 47, 48, 50]; expect(counting(arr)).to.be.deep.equal(res); });})这里要补一个非常关键的区分:上面这版是「简化版」,它只处理「纯数字数组」。仔细看回填那一段——它是直接 array[sortedIndex++] = i,把值 i 写回去,没有任何「原始元素」的概念。
对于纯数字数组,这没有任何问题(值和元素是同一个东西)。但如果要对对象数组做计数排序(比如按「药品库存量」排序一批药品对象),这版就彻底失效了——它会把所有对象都替换成数字。
标准稳定版是这样的(用前缀和 + 倒序回填),它是基数排序的子过程:
functioncountingSortStable(array: number[], maxValue: number): number[] { const counts = new Array(maxValue + 1).fill(0); for (const v of array) counts[v]++; // ① 计数 for (let i = 1; i <= maxValue; i++) counts[i] += counts[i - 1]; // ② 前缀和:变成「最后出现位置」 const result = new Array(array.length); for (let i = array.length - 1; i >= 0; i--) { // ③ 必须倒序回填 result[--counts[array[i]]] = array[i]; } return result;}三个步骤各有一个不可省略的理由:
② 前缀和把 counts[v]从「出现次数」变成「值 v 的最后一个元素应该放在哪个下标(开区间)」③ 倒序回填是稳定性的来源:同一个值有多个元素时,倒着遍历可以让原本在后面的元素先被放到靠后的位置,原本在前面的自然就留在前面了
而「必须倒序」这件事,在基数排序里是生死攸关的——下一节会解释。
算法分析:
最佳情况: O(n+k)最差情况: O(n+k)平均情况: O(n+k)空间复杂度: O(k)(上面那版原地回填的简化实现);换成前缀和 + 倒序回填的稳定版则要多开一个结果数组,变成O(n+k)
其中 k 是值的范围(maxValue - minValue + 1)。这里藏着一个非常实际的坑:计数排序的复杂度取决于「值域」而不是「元素个数」。如果排序 [1, 1000000] 这两个数,k = 1000000,要开一个百万长度的数组——比直接比较慢得多,还可能内存爆掉。所以计数排序只适合值域紧凑的数据。
桶排序
简介:
桶排序是计数排序的升级版。它利用了函数的映射关系,高效与否的关键就在于这个映射函数的确定
算法思路:
假设输入数据服从均匀分布,将数据分到有限数量的桶里 每个桶再分别排序(有可能再使用别的排序算法或是以递归方式继续使用桶排序进行排序)
算法步骤:
设置一个定量的数组当作空桶 遍历输入数据,并且把数据一个一个放到对应的桶里去 对每个不是空的桶进行排序 从不是空的桶里把排好序的数据拼接起来
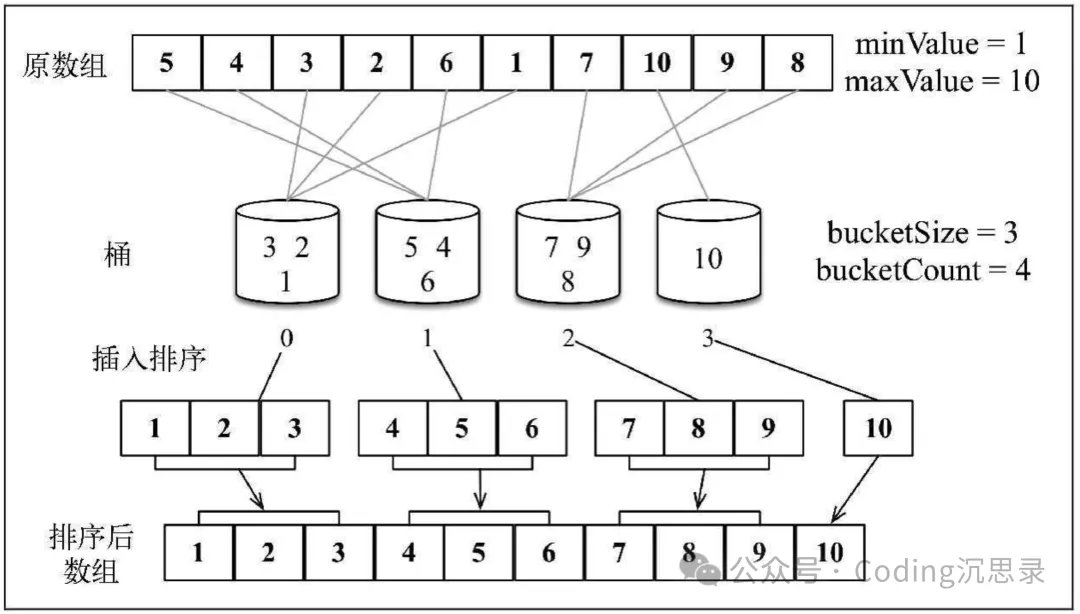
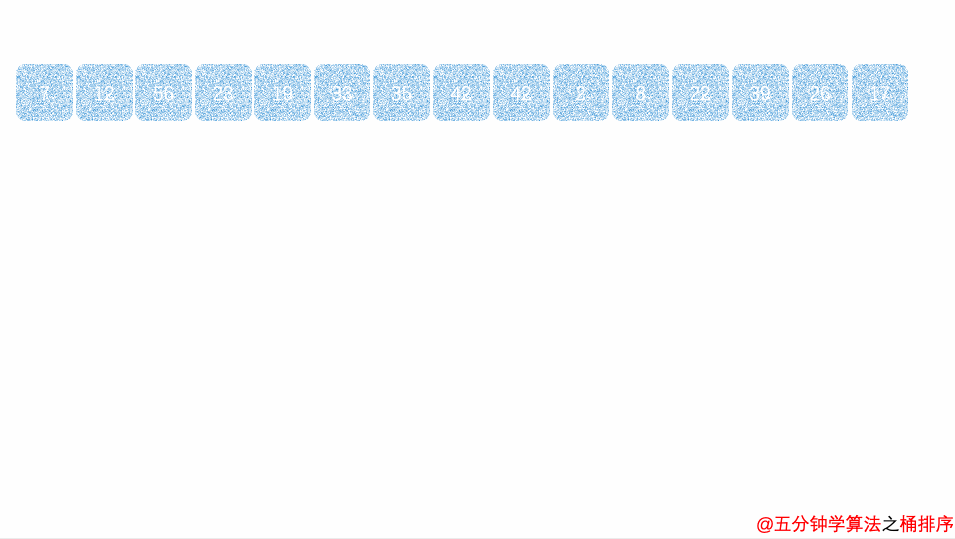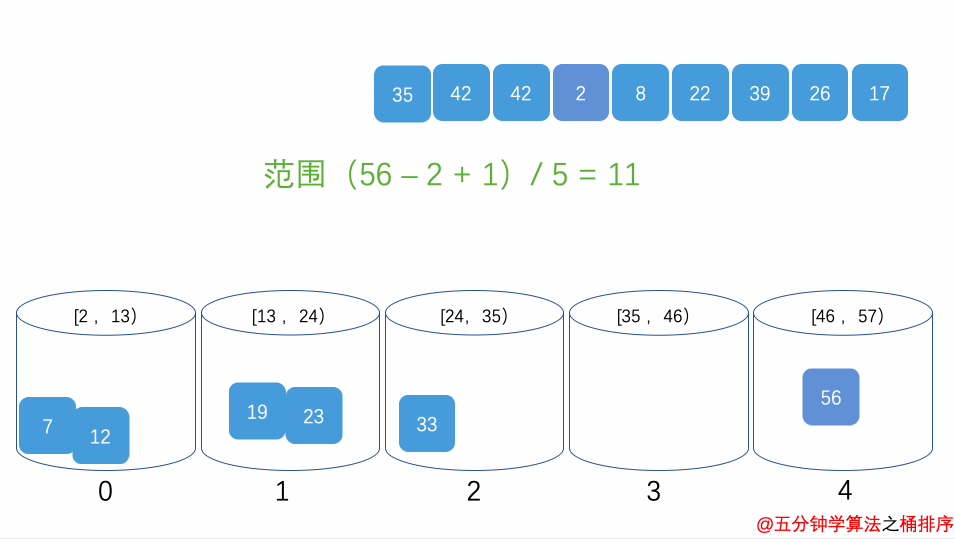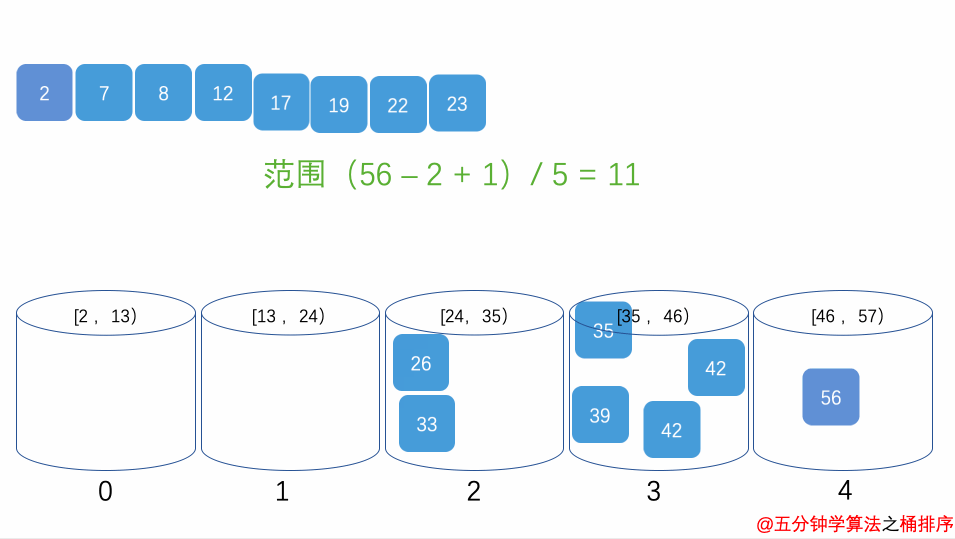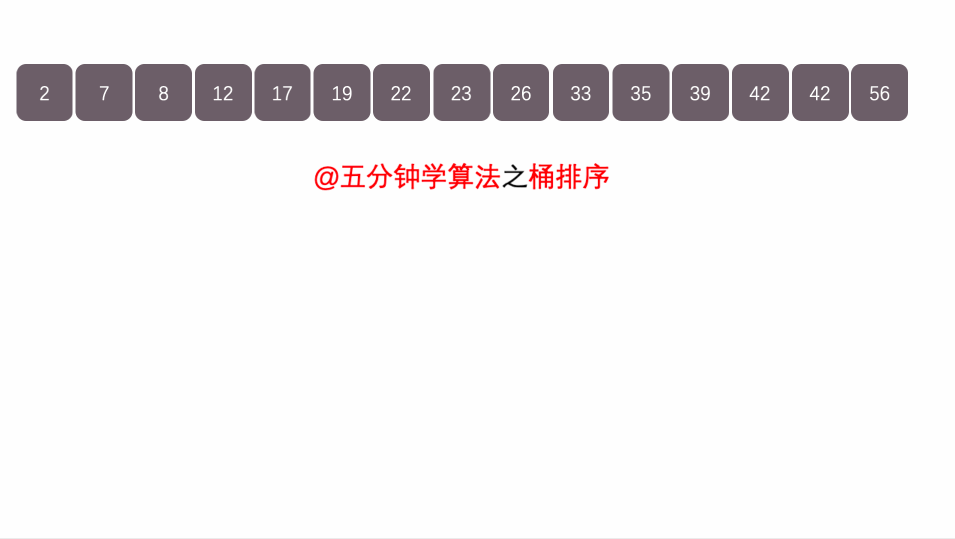
桶排序和计数排序的关系:
计数排序是「每个值一个桶」,所以桶的个数必须是 k(值域大小),且数据必须是整数桶排序是「每个区间一个桶」,桶的个数由你定,数据可以是小数—— bucketSize越大,桶越少、桶内元素越多
所以桶排序确实「兼容」了计数排序能做的事,还把适用范围扩展到了非整数。
import { insertion } from'./insertion';const createBuckets = (array: any[], bucketSize: number = 5) => { let minValue = array[0]; let maxValue = array[0]; for (let i = 1; i < array.length; i++) {const item = array[i];if(item < minValue) { minValue = item } els eif(item > maxValue) { maxValue = item; } } const bucketCount = Math.floor((maxValue - minValue) / bucketSize) + 1; const buckets: any[][] = []; for (let i = 0; i < bucketCount; i++) { buckets[i] = []; } for (let i = 0; i < array.length; i++) {const index = Math.floor((array[i] - minValue) / bucketSize);// console.log(index, buckets, array[i], minValue); buckets[index].push(array[i]); } return buckets;}const bucketSort = (buckets: any[][]) => { const sortedArray = []; for (let i = 0; i < buckets.length; i++) {if(buckets[i] != null) { insertion(buckets[i]); sortedArray.push(...buckets[i]); } } return sortedArray;}export functionbucket(array: any[], bucketSize: number = 5) { if(array.length < 2) return array; const buckets = createBuckets(array, bucketSize); // console.log(buckets) return bucketSort(buckets);}注意 bucketSort 里调用了 insertion——这是第三、四、五节内容的一次交汇:桶排序本身只是「分桶 + 拼接」,真正的排序交给桶内的插入排序完成。这也解释了为什么桶排序是稳定的:只要桶内用的算法稳定(插入排序稳定),并且拼接是按桶的下标顺序从左到右——整体就稳定。
import { describe, it } from'mocha';import { expect } from'chai';import { bucket } from'../bucket';describe('桶排序 测试', () => { it('桶排序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [2, 3, 4, 5, 15, 19, 26, 27, 36, 38, 44, 46, 47, 48, 50]; expect(bucket(arr)).to.be.deep.equal(res); });})算法分析:
桶排序最好情况下使用线性时间 O(n)桶排序的时间复杂度,取决于对各个桶之间数据进行排序的时间复杂度,因为其它部分的时间复杂度都为 O(n)很显然,桶划分的越小,各个桶之间的数据越少,排序所用的时间也会越少。但相应的空间消耗就会增大 最佳情况: O(n+k)最差情况: O(n²)——所有元素都落进同一个桶平均情况: O(n+k)空间复杂度: O(n+k)
「最差情况 O(n²)」很值得琢磨:如果数据分布极度不均匀(比如 99% 的数据挤在同一个区间),大部分元素会进同一个桶,桶内插入排序退化成 O(n²)。所以桶排序的前提是「假设输入数据服从均匀分布」——这个假设不成立,它就不成立。
基数排序
简介:
基数排序是对「多位数」的排序——把每个数看作由若干位组成,按位从低到高依次排序。
算法思路:
基数排序是按照低位先排序,然后收集 再按照高位排序,然后再收集 依次类推,直到最高位 有时候有些属性是有优先级顺序的,先按低优先级排序,再按高优先级排序 最后的次序就是高优先级高的在前,高优先级相同的低优先级高的在前
算法步骤:
取得数组中的最大数,并取得位数 arr为原始数组,从最低位开始取每个位组成radix数组对 radix进行计数排序(利用计数排序适用于小范围数的特点)
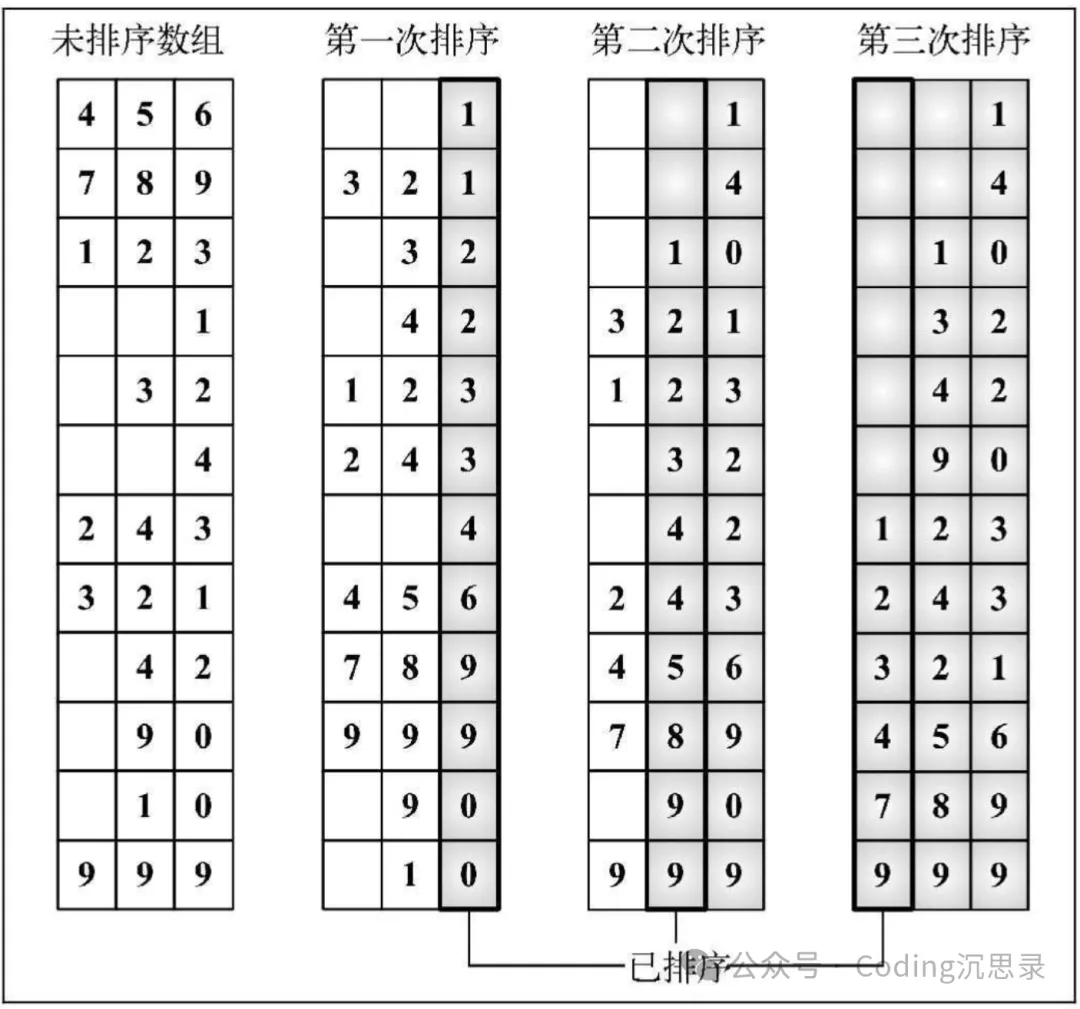
为什么基数排序要「从低位往高位」排? 这是整个算法的灵魂,也是和第一节「多键排序」完全同构的一件事:
把每个数的每一位看成一个「键」,个位是次要键、十位是主要键、百位是更主要的键。而第一节讲过:多键排序的正确做法就是从次要键排到主要键。所以:
第一轮按个位排 → 第二轮按十位排(稳定,保留个位顺序)→ 第三轮按百位排(稳定,保留十位顺序)每一轮必须稳定,否则前面所有轮次的成果全部白费。用一个只有两位数的例子看清这件事:
原始:[12, 13] —— 期望结果:[12, 13]第一轮按个位分桶:2 和 3 不同桶,收集后仍是 [12, 13](稳不稳定都一样)第二轮按十位分桶:十位都是 1,落进同一个桶 —— 这一轮的结果完全取决于稳定性 稳定 → 桶内保持第一轮的相对顺序 → [12, 13] ✅ 不稳定 → 桶内顺序可能被翻转 → [13, 12] ❌看明白了吗——当两位数字的「高位相同」时,它们在最后一轮里相对顺序的唯一依据,就是上一轮留下的顺序。而上一轮的顺序能不能带过来,全靠「计数排序是不是稳定的」。位数越多,这种「高位相同、靠低位定序」的分组越多,稳定性一旦丢失,错误就成片出现。
一句话概括:基数排序的正确性 = 每一轮计数排序的稳定性。这也是为什么上一节讲计数排序时,要专门强调「前缀和 + 倒序回填」那版——因为基数排序内部调用的就是那一版。
import { findMaxValue, findMinValue } from"../../util";const getBucketIndex = ( value: any, minValue: any, significantDigit: number, radixBase: number) => Math.floor(((value - minValue) / significantDigit) % radixBase);const countingSortForRadix = ( array: any[], radixBase: number, significantDigit: number, minValue: any) => { let bucketsIndex; const buckets = []; const aux = []; for (let i = 0; i < radixBase; i++) { buckets[i] = 0; } for (let i = 0; i < array.length; i++) { bucketsIndex = getBucketIndex( array[i], minValue, significantDigit, radixBase ); buckets[bucketsIndex]++; } for (let i = 1; i < radixBase; i++) { buckets[i] += buckets[i - 1]; } for (let i = array.length - 1; i >= 0; i--) { bucketsIndex = getBucketIndex( array[i], minValue, significantDigit, radixBase ); aux[--buckets[bucketsIndex]] = array[i]; } for (let i = 0; i < array.length; i++) { array[i] = aux[i]; } return array;};export functionradix(array: any[], radixBase: number = 10) { if (array.length < 2) {return array; } const minValue = findMinValue(array); const maxValue = findMaxValue(array); // Perform counting sort for each significant digit, starting at 1 let significantDigit = 1; while ((maxValue - minValue) / significantDigit >= 1) {// console.log('radix sort for digit ' + significantDigit); array = countingSortForRadix(array, radixBase, significantDigit, minValue);// console.log(array.join()); significantDigit *= radixBase; } return array;}对着看,countingSortForRadix 和上一节的稳定版计数排序步骤一模一样:计数 → 前缀和 → 倒序回填。唯一的差别是「桶的下标」不再是元素本身,而是「这一位上的数字」(getBucketIndex)。这就是「基数排序 = 多轮计数排序」的代码级证据。
import { describe, it } from'mocha';import { expect } from'chai';import { radix } from'../radix';describe('基数排序 测试', () => { it('基数排序', () => {const arr = [3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48];const res = [2, 3, 4, 5, 15, 19, 26, 27, 36, 38, 44, 46, 47, 48, 50]; expect(radix(arr)).to.be.deep.equal(res); });})算法分析:
基数排序基于分别排序、分别收集,所以是稳定的 但基数排序的性能比桶排序要略差,每一次关键字的桶分配都需要 O(n)的时间复杂度,而且分配之后得到新的关键字序列又需要O(n)的时间复杂度假如待排数据可以分为 d个关键字,则基数排序的时间复杂度将是O(d*2n),当然d要远远小于n,因此基本上还是线性级别的最佳情况: O(d·n)最差情况: O(d·n)平均情况: O(d·n)空间复杂度:** O(n + b)**——一个aux数组 O(n) +buckets计数数组 O(b)
⚠️ 注意这里有两个容易混的符号:d 是位数(要跑几轮),b 是基数(也就是桶的个数,默认为 10,因为按十进制取位)。上面笔记里把两者都写成 k,容易让人误以为「位数」和「桶数」是同一个量——实际计算时要分开看:d 决定跑几轮、b 决定每轮开多大的计数数组。
所以严格说,基数排序是 O(d·n) 时间、O(n + b) 空间,其中 d ≈ log_b(maxValue)。当 d 远小于 n 时(多数真实数据都满足),它才表现出线性级别的性能。
💬 面试官:计数排序、桶排序、基数排序凭什么能突破 O(n log n) 下界?
✅ 标准答案:因为它们不是比较排序。O(n log n) 是「比较排序」的下界——这个下界的前提是「算法只能通过 a < b / a > b 这类比较来获取元素之间的顺序信息」,每次比较只产生一个比特的信息。而计数、桶、基数排序直接利用元素的值本身(值域范围、桶的映射规则、每一位上的数字),相当于「绕过了比较」这条路,所以不受这个下界约束。代价是它们需要额外的假设——计数排序要求整数且值域紧凑、桶排序要求分布均匀、基数排序要求可按位分解,一旦假设不成立,性能就会退化。
🎁 加分答案:能补三点——① 用信息论讲清本质:比较排序每次比较最多区分 2 种情况(1 bit),而 n 个元素有 n! 种排列,需要 log₂(n!) ≈ n log n 比特,所以至少要做 n log n 次比较;计数排序的计数过程一次就拿到了「某个值的出现次数」这个更丰富的信息,信息效率更高;② 能指出「突破下界 ≠ 免费」——这三种排序本质是用 O(k) 的额外空间和「值域信息」换时间,
k超过 n 时就得不偿失了;③ 能举真实应用:JavaScript 引擎里的字符串排序、数据库的ORDER BY对低基数(比如性别、状态码)的列、以及第 75 题「颜色分类」(只有 0/1/2 三种值,本质就是值域为 3 的计数排序)。
六、比较排序的下界:为什么快不过 O(n log n)
到这里,你已经掌握了「比较排序最好能做到 n log n」这个事实。但为什么「最好」只能是 n log n?为什么不能更快?这个问题是算法课里最漂亮的证明之一,也是面试里区分「背结论」和「真懂」的分水岭。
决策树模型
考虑一个只依赖比较的排序算法。算法的执行过程,可以用一棵「决策树」来表示:
每个内部节点是一次比较: a[i] < a[j]?每个分支是比较结果(是 / 否) 每个叶子节点是一个「排序完成后的输出排列」
以三个元素 a, b, c 为例,决策树的形状大致是这样:
a < b ? ┌────── 是 ──────┐┌────── 否 ──────┐ b < c ? a < c ? ┌── 是 ──┐┌── 否 ──┐ ┌── 是 ──┐┌── 否 ──┐ abc a < c ? bac b < c ? ┌── 是 ──┐┌── 否 ──┐ ┌── 是 ──┐┌── 否 ──┐ acb cab bca cba这棵树一共 3 层、6 个叶子,正好对应 3! = 6 种排列——每一个叶子唯一确定一种输出顺序,最深的一条路径要走 3 次比较。注意「每层最多把叶子数翻倍」这个结构:n 越大,要覆盖的排列越多,树就必须越深,这就是下界的来源。
关键推理只有三步:
第一步:叶子数至少是 n!n 个元素一共有 n! 种排列(n 的阶乘)。排序算法必须能把「每一种输入排列」都排成唯一正确的结果,而不同的输入排列可能最终输出相同的值序列(当元素有重复时),但在最坏情况下(元素全部不同),每一种输入排列都对应决策树上一条独立的路径、一个不同的叶子。所以决策树至少要有 n! 个叶子。
第二步:高度为 h 的二叉树最多有 2^h 个叶子一棵二叉树每往下一层,叶子数量最多翻倍。所以高度为 h 的树,叶子数 ≤ 2^h。
第三步:两式联立
2^h ≥ n! → h ≥ log₂(n!)而根据 Stirling 近似,log₂(n!) = Θ(n log n)。于是:
任何比较排序算法,最坏情况下至少需要大约
log₂(n!)次比较,也就是Ω(n log n)。
直观理解:n log n 次比较是「信息的下限」
换个角度更好懂。每一次比较只回答一个「是/否」问题,最多给出 1 bit 的信息。而「确定这 n 个元素的排列」这件事一共需要多少信息?
可能的排列有 n! 种 要区分出是哪一种,需要 log₂(n!)bit每次比较只给 1 bit
所以要确定排列,至少要做 log₂(n!) 次比较。n = 1000 时,log₂(1000!) ≈ 8530——任何比较排序都要做这么多比较,一条都省不掉。
为什么归并和快排能「达到」这个下界
这里有个很漂亮的对称:
下界说「至少 n log n」 归并排序做到了「恰好 n log n」(任何输入) 快排做到了「期望 n log n」
所以 n log n 是「可达的紧界」,不是「过分乐观的下界」。归并能达到它的原因,是它的合并过程每一次比较都充分利用——两个有序段合并时,每次比较都能确定「某个元素的最终位置」,没有浪费任何一次比较的信息量。
而冒泡、选择、插入这些 O(n²) 的算法,问题就出在信息浪费:选择排序为了找出最小值,要比较 n 次,但只确定了 1 个元素的位置——平均每次比较产出不到 1 bit 的有效信息。这就是它们慢的根源。
线性排序「作弊」在哪
明白了决策树模型,就明白计数排序为什么能突破下界:它根本不在这个模型里。
决策树模型的前提是「算法只能做比较」。计数排序没有做任何比较——它直接读出了元素的值,然后用这个值当数组下标去累加计数。这一步索引操作获得的信息量,远大于一次「是/否」比较,所以它不受「每次比较 1 bit」的约束。
用大白话讲:
比较排序:我只能问「A 比 B 大吗?」,一个个问出来 计数排序:我直接看每个数是多少,我知道了「答案本身」
代价也很清楚:计数排序必须知道「值域范围」才能开那个计数数组——这是它用空间和信息换来的特权。如果值域是 10 亿,这套就不灵了。
💬 面试官:为什么比较排序无法突破 O(n log n) 的下界?
✅ 标准答案:把所有「只依赖比较」的排序算法的执行过程建模成一棵决策树:内部节点是比较、叶子是最终排列。n 个元素共有 n! 种排列,所以决策树至少要有 n! 个叶子;而高度为 h 的二叉树最多只有 2^h 个叶子,所以
2^h ≥ n!,即h ≥ log₂(n!)。由 Stirling 公式,log₂(n!) = Θ(n log n),所以最坏情况下比较排序至少需要Ω(n log n)次比较。从信息论角度看,每次比较只提供 1 bit 信息,而确定排列需要log₂(n!)bit,所以比较次数不可能低于这个值。
🎁 加分答案:能补三点——① 区分「下界」和「最优算法」:这个证明只说明「不可能更快」,但没说「一定有人能达到」;归并排序恰好达到了 n log n,所以这个下界是紧的(tight),不是保守估计;② **解释为什么简单排序是 O(n²)**:从决策树看,它们的比较次数远超
log₂(n!),浪费了大量比较——选择排序找出最小值用 n 次比较只确定了 1 个位置;③ 指出计数/桶/基数为什么不受约束:它们不比较,直接利用值的范围(值域大小k)——这是「用额外的值域信息和 O(k) 空间换时间」,所以它们能 O(n),但前提是值域可控。能主动对比「比较排序 vs 非比较排序的范式差异」,这题就是满分。
七、TimSort:V8 真实的 sort 实现
前面六节,我们把排序的理论体系走完了。但还有一个最实际的问题没回答:你每天敲的 arr.sort(),到底跑的是什么算法?
答案是:很长一段时间里是 TimSort。这一节把它彻底拆开,然后告诉你它 2026 年被换成了什么、为什么换。
从快排到 TimSort:2018 年那次切换
在 V8 v7.0(Chrome 70)之前,Array.prototype.sort 用的是 自举 JavaScript 写的快速排序 + 短数组插入排序。这套实现有三个问题:
不稳定——这正是第一节讲的「ES2019 之前浏览器行为不一致」的历史来源 **最坏 O(n²)**——存在性能悬崖,特定的输入可以让排序突然变得极慢 不能保证最坏情况——这对一个「标准库函数」来说是不可接受的,标准库的调用者无法预期什么时候踩雷
2018 年,V8 团队做了一个决定性的切换:
「Please welcome TimSort to V8.」
TimSort 从 V8 v7.0 / Chrome 70 开始可用。
切换的三个动机:
稳定性:V8 官方博客的原话是——「对稳定 Array#sort的需求,是 V8 issue tracker 里最古老的 ticket 之一」。TC39 在 ES2019 引入稳定排序的要求,V8 必须跟上算法保证:TimSort 最坏情况也是 O(n log n),没有性能悬崖;而对真实数据(部分有序),它能接近 O(n) 技术验证:TimSort 足够复杂,正好用来验证 Torque(V8 的内置函数 DSL)能否承载工业级算法
TimSort 是什么:识别 run,再归并
TimSort 的本质是归并排序 + 插入排序的混合体,外加一个关键洞察:
真实世界的数据几乎从来不是完全随机的——它通常包含大量「已经有序」的片段。
比如药品列表按 ID 加载,界面层做了几次局部插入删除——整体上它就是「大部分有序、局部乱」的。快排完全无视这个信息,一上来就暴力分区;而归并排序也只用「两两对半劈」这种几何划分,同样无视数据本身的有序性。
TimSort 的做法是:先把这些天然有序的片段(run)找出来,再对这些 run 做归并。找出来的 run 越多、越长,需要的归并就越少——对于完全有序的数组,整段就是一个 run,O(n) 一次扫描直接完成,一次归并都不需要。
第一道保障:自然 run 识别
V8 源码里的 CountAndMakeRun 干的就是这件事:从当前位置开始往后扫,看这一段是「升序」还是「降序」:
升序 run: a[i] <= a[i+1] <= a[i+2] <= …(注意是<=,相等元素也算升序)降序 run: a[i] > a[i+1] > a[i+2] > …(注意是严格的>),扫到之后原地反转,变成一个升序 run
输入:[1, 2, 3, 7, 6, 5, 4, 9, 10]第 1 段:1,2,3,7 是升序(每个都比前一个大或相等)→ run1 = [1,2,3,7]第 2 段:7,6,5,4 是严格降序 → 反转 → run2 = [4,5,6,7]第 3 段:9,10 是升序 → run3 = [9,10]得到 3 个有序段,只需要 2 次归并!而快排要把整段重新分区 n log n 次比较。为什么「相等」的处理规则如此关键? 看源码注释里的这句解释:
「For its intended use in stable mergesort, the strictness of the definition of "descending" is needed so that the range can safely be reversed without violating stability (strict ">" ensures there are no equal elements to get out of order).」
翻译过来就是:降序的定义必须是严格的 >,才能安全地反转区间而不破坏稳定性。因为严格降序里不可能有相等元素——反转之后,原本相等的一对元素不会被颠倒。而升序用 <= 则保证了「相等元素会被留在同一个 run 里,保持原有顺序」。
这两个不等号的选择,就是 TimSort 稳定性的第一道保障。 如果这里写错了(比如降序也用 >=),整段反转就会把相等元素翻个个儿,稳定性立刻崩塌。
第二道保障:minRun 与二分插入排序
自然 run 可能很短(极端情况下每个 run 长度都是 1),那样退化成「n 个长度 1 的 run 做归并」,还不如直接归并排序。所以 TimSort 引入了一个概念:minRun(最小 run 长度)。
规则很简单:
如果自然 run 的长度 ≥ minRun,就用它 如果不足 minRun,就用二分插入排序把它「补齐」到 minRun
minRun 怎么算?V8 的 ComputeMinRunLength 源码:
// If n < 64, return n (it's too small to bother with fancy stuff).// Else if n is an exact power of 2, return 32.// Else return an int k, 32 <= k <= 64, such that n/k is close to, but// strictly less than, an exact power of 2.macro ComputeMinRunLength(nArg: Smi): Smi { let n: Smi = nArg; let r: Smi = 0; // Becomes 1 if any 1 bits are shifted off. while (n >= 64) { r = r | (n & 1); n = n >> 1; } const minRunLength: Smi = n + r; return minRunLength;}这段代码在做的事情是:把 n 不断地右移(相当于除以 2),直到剩下不到 64;同时用 r 记录「中途有没有移出过 1 bit」,如果有就把结果 +1。最终得到的 minRun 落在 [32, 64] 这个区间里。
为什么是这个范围?源码注释给出了答案:n / minRun 要「接近但不正好是 2 的幂」。因为 TimSort 的归并是「相邻两段合并」,如果每个 run 的长度都是 2 的整数次幂,合并过程会非常均匀、非常高效。
⚠️ 这里必须纠正一个流传极广的错误说法:网上大量文章写的是「V8 TimSort 有个 INSERTION_SORT_THRESHOLD = 64 的常量,数组小于 64 就用插入排序」。源码里没有这个常量,这个说法是误传。 真实的数字有两个,含义完全不同:
64:是 ComputeMinRunLength里的循环边界,用来计算 minRun 的取值范围,不是「小于 64 就用插入排序」10:是 kMinTimSortLen,才是真正的「小数组直接走插入排序」的阈值
// 真正的小数组阈值const kMinTimSortLen: constexpr int31 = 10;// 入口处的判断if (numberOfNonUndefined < kMinTimSortLen) { // Faster for small arrays. BinaryInsertionSort(0, 0, numberOfNonUndefined);} else { ArrayTimSortImpl(context, sortState, numberOfNonUndefined);}元素少于 10 个,整个排序直接交给二分插入排序,连 TimSort 的流程都不进。 这个数字正好呼应第三节讲的「插入排序在小数组上常数因子最小」。
而 BinaryInsertionSort 里的稳定性处理,源码注释写得非常清楚:
「the invariants still hold, so: pivot >= all in [low, left) and pivot < all in [left, start), so pivot belongs at left. **Note that if there are elements equal to pivot, left points to the first slot after them -- that's why this sort is stable.**」
用二分查找找插入位置时,条件是 if (order < 0) 才往左收(right = mid),否则往右(left = mid + 1)。这个「只有严格小于才在左侧」的判断,让 left 最终停在「所有相等元素的右边第一个位置」——新元素插在相等元素后面,稳定性成立。
第三道保障:归并栈的双不变量
找出来的一堆 run 不能随便合并。如果每次都「攒到两个就合」,会退化成极端不均衡的合并(一个巨大的 run 和一堆小 run 反复合并),代价接近 O(n²)。
TimSort 用的是一个栈 + 两条不变量。假设栈顶的三段 run 从上到下是 A、B、C(A 最短、C 最长),那么任何时刻必须满足:
不变量 1: |C| > |B| + |A|不变量 2: |B| > |A|
V8 源码里的 MergeCollapse 就是不断检查、破坏就合并:
Examines the stack of runs waiting to be merged, merging adjacent runsuntil the stack invariants are re-established: 1. run_length(i - 3) > run_length(i - 2) + run_length(i - 1) 2. run_length(i - 2) > run_length(i - 1)下面的 ASCII 图演示了「不变量被破坏 → 合并相邻较短的两段」:
初始状态:栈里依次压入了 4 个 run ┌─────────┐ │ C: 60 │ ← 栈底 ├─────────┤ │ B: 30 │ ├─────────┤ │ A: 25 │ ← 栈顶(新压入的) └─────────┘检查不变量 2:|B| > |A| ? → 30 > 25 ✅检查不变量 1:|C| > |B| + |A| ? → 60 > 55 ✅→ 都不满足破坏条件,暂不合并,继续找下一个 run下一轮又压入 D = 8: ┌─────────┐ │ C: 60 │ ├─────────┤ │ B: 30 │ ├─────────┤ │ A: 25 │ ├─────────┤ │ D: 8 │ ← 新的栈顶 └─────────┘此时 A、D 成为「栈顶两段」,检查 |A| > |D| → 25 > 8 ✅但继续往上检查 C、B、A: |B| > |A| + |D| ? → 30 > 33 ❌ 破坏了!→ 合并「相邻较短的两段」:A(25) 和 D(8) 合并成 33 ┌─────────┐ │ C: 60 │ ├─────────┤ │ B: 30 │ ├─────────┤ │ AD: 33 │ └─────────┘再检查:|C| > |B| + |AD| ? → 60 > 63 ❌ 又破坏了→ 合并 B(30) 和 AD(33) 成 63 ┌─────────┐ │ C: 60 │ ├─────────┤ │ BAD: 63 │ └─────────┘再检查:|C| > |BAD| ? → 60 > 63 ❌ 继续合并 → 最终只剩一段 123这两条不变量的作用,**不只是追求效率,更是保证栈的深度是 O(log n)**——否则栈可能长得无限深,归并变成 O(n²)。数学上可以证明,满足这两条不变量的 run 长度序列至少按斐波那契增长,所以栈深度 ≤ log_φ(n),V8 直接把栈开成 85 项:
// The maximum number of entries in a SortState's pending-runs stack.// This is enough to sort arrays of size up to about// 32 * phi ** kMaxMergePending// where phi ~= 1.618. 85 is ridiculously large enough, good for an array with// 2 ** 64 elements.const kMaxMergePending: constexpr int31 = 85;85 项足够排 2 的 64 次方个元素——比 JS 数组的最大长度还多得多,所以这个栈永远不可能溢出。
第四道优化:Gallop(跳跃模式)
归并两个 run 时,如果其中一段的元素全都比另一段小(典型的「局部有序」情况),逐个比较会浪费大量时间——你要一个一个比过去,才确认「这一段确实全都小」。
Gallop 模式用指数搜索解决这个问题:从当前位置开始,按 1、2、4、8、16… 的步长跳跃着比较,一旦确定目标在某个区间内,再在区间内二分查找。这样「一路小下去」的长片段可以在 O(log k) 次比较内跳过。
Gallop 不是无条件开启的——它有开关:
// When we get into galloping mode, we stay there until both runs win less// often then kMinGallop consecutive times.const kMinGallopWins: constexpr int31 = 7;指标是「连续赢了 7 次」:如果一段连续 7 次都取到了自己的元素,说明它很可能整体更小,值得切到 Gallop 模式;一旦 Gallop 模式下对方开始获胜,就退出。这个动态开关让 TimSort 对「随机数据」和「高度结构化数据」都能自适应。
空间代价
TimSort 不是完全原地的,但它的额外空间是可控的:
run 栈:固定 85 项,常数 归并临时数组: MergeAt会先做两件事——用GallopRight找出「左边那段的开头有多少元素本来就在位置」(可以直接跳过),用GallopLeft找出「右边那段的结尾有多少元素本来就在位置」(也可以跳过),然后只对剩下的部分开临时数组,且只开min(lenA, lenB)大小
所以额外空间的上界是 n/2——V8 博客的原话是「the merge temporary never exceeds n/2 of the input length」。
现状补更:2026 年 V8 换成了 PowerSort
写到这里,必须补一条最新的现状——因为如果你在 2026 年之后去翻 V8 源码,会发现 array-sort.tq 里写的已经不是 TimSort 了。
2026 年 4 月,V8 提交了这样一个变更:
「[builtins] Sorting: TimSort --> PowerSort」
This CL replaces the TimSort implementation in V8's Torque builtins with PowerSort. The case for switching rests on algorithmic merits rather than raw speed, as macrobenchmarks are neutral.
换成 PowerSort 的三个理由:
合并代价更接近理论最优:TimSort 的合并代价相对于 run 长度的「熵」有时会超出最优值约 50%(在对抗性构造的输入上),PowerSort 可证明是「近乎最优」的 不变量更简单:TimSort 那套「两条不等式 + 栈」的不变量,提交信息里直接形容为「uncomfortably subtle」(令人不舒服地微妙)——历史上确实在其他语言的实现里出过 bug。PowerSort 的不变量是局部的、无状态的,更容易证明正确 跟随 CPython:Python 的 list.sort在更早就从 TimSort 换到了 PowerSort(CPython PR #28108),V8 这次是对齐这个方向
但请注意:对普通开发者来说,这几乎不影响任何东西。 下面这些全都没有变:
✅ 依然是稳定排序(这是规范要求,不是实现选择) ✅ 最坏情况依然是O(n log n) ✅ 依然识别自然 run,依然用插入排序做底座(小数组直接走二分插入排序) ✅ 对已排序 / 部分有序的数据,依然接近 O(n)
变的是合并策略——「什么时候合并、合并哪两段」的规则。这是实现内部的优化,不改变任何一个你可以依赖的性质。
另外还有一个和前端更贴近的变化:Maglev 和 TurboFan 会对长度 ≤ 16 的数组直接内联插入排序,完全不走 builtin。源码里对应的是 src/objects/js-array.h 中的 kMaxInlineSortLength = 16:
// 数组长度 ≤ 16 时,Maglev / TurboFan 直接把插入排序内联展开,// 而不是调用通用的 PowerSort builtin;PowerSort 自己在这个阈值以下// 也会走 BinaryInsertionSort。static constexpr int kMaxInlineSortLength = 16;也就是说,当你对小数组(≤16 个元素)调 sort 并传了比较函数时,V8 连 builtin 都不会进,直接在 JIT 编译器里展开成一段插入排序——省掉了「builtin ↔ JS 比较函数」来回切换的全部开销。这是为什么「小数组排序」在 JS 里几乎感觉不到成本。
为什么 TimSort 对真实数据几乎 O(n)
这一节最后,把「TimSort 为什么快」这件事用四类真实数据说透。
① 完全有序
[1, 2, 3, 4, 5, 6, ..., n]CountAndMakeRun 一次扫描就识别出「整个数组就是 1 个 run」,栈里只有 1 段,MergeForceCollapse 无事可做。总代价 = 一次 O(n) 扫描。 这是快排完全做不到的(快排面对有序数组,如果基准选得不好反而退化成 O(n²))。
② 部分有序(最常见的真实情况)
[1, 2, 3, 50, 51, 52, 4, 5, 6, 7, 100, 101, ...]识别出多个 run(比如 3 个),只需要 2 次归并。代价 ≈ O(n) 扫描 + O(n) 的归并,远快于 n log n。
药品列表、订单列表、日志列表,数据源通常就是按主键递增的,前端只是在中间做了筛选、插入、局部重排——这种「大部分有序、几处被打乱」的形态,正是 TimSort 的主场。
③ 完全逆序
[n, n-1, n-2, ..., 2, 1]识别出「整段严格降序」,ReverseRange 一次反转就完成。同样是 O(n)——这一点大多数人想不到:快排和归并面对逆序都要老老实实做 n log n,TimSort 一次反转就搞定。因为逆序本质上也是「高度结构化的有序」。
④ 大量重复键
[3, 3, 3, 5, 5, 5, 5, 1, 1, 1, ...]因为升序判断用的是 <=,相等元素会被收进同一个 run,所以重复键多反而让 run 更少、更短。这一点和快排形成鲜明对比:快排面对大量重复键时是最容易退化的(经典双指针分区会把相等元素分散到两边,导致分区失衡),这也是为什么三路分区对快排如此重要。
⑤ 真正的随机数据
[7, 2, 9, 1, 5, 8, 3, 6, 4]这是 TimSort 唯一「没有优势」的场景——随机数据天然没有长 run,minRun 补齐和普通归并的开销就体现出来了,性能略低于专门优化的快排。但 V8 依然选了 TimSort,因为:
差距很小,而且在宏基准测试里几乎是中性的 换来的是「稳定 + 最坏 O(n log n) 无悬崖」这两个标准库必需的保证 对真实数据(几乎都有序)的优势,远大于对随机数据的小劣势
💬 面试官:V8 为什么从快速排序切换到了 TimSort?TimSort 对真实数据有什么优势?
✅ 标准答案:三个动机——① 稳定性:ES2019 规范要求
Array.prototype.sort稳定,老的快排实现不稳定;② 消除性能悬崖:快排最坏 O(n²),标准库函数不能有这种不可预期的退化;TimSort 最坏也是 O(n log n);③ 对真实数据更快:TimSort 是「识别有序 run + 归并」的混合算法,真实业务数据(列表、日志、订单)大多「整体有序、局部乱」,能被它识别成长 run,代价接近 O(n),而快排完全无视了这部分已有信息。
🎁 加分答案:能补四个细节——① 版本要准:TimSort 从 V8 v7.0 / Chrome 70 开始;② 能说清「为什么小数组用插入排序」和真实阈值:真正的阈值是
kMinTimSortLen = 10(不是网上流传的 64),ComputeMinRunLength里的 64 是算 minRun 用的循环边界,两者含义完全不同;③ 能说出归并栈的两条不变量(|C| > |B| + |A|和|B| > |A|)以及它们保证栈深度 O(log n)、栈大小 85;④ 知道最新状态:V8 在 2026 年 4 月已经把 Torque 实现换成了 PowerSort(跟随 CPython),但「稳定、O(n log n) 上界、run 识别、插入排序底座」全部保持不变——能区分「实现细节变了」和「对外保证没变」,是真正读过源码的人和背八股的人的分界线。
🔧 真实场景:药品列表页的数据来源是「按 ID 增量拉取 + 前端本地筛选」。用户操作路径是:先全量加载 500 条 → 搜索框输入关键词做过滤 → 按销量重排。这三步里:
搜索过滤后剩下的数组,原顺序基本保持——TimSort 识别出大量 run,过滤后的排序几乎是线性的 如果换成传统快排,无论数据多有序,都要完整做一遍 n log n 的分区 更关键的是稳定性:过滤 + 按销量排序后,销量相同的药品会保持原本的 ID 顺序,列表不会「跳来跳去」——这是用户能直接感知到的体验差异
八、高频题精讲
理论讲完,落到刷题。这四道题覆盖了排序题的三种典型考法:手写高级排序、利用值域特性、在链表上排序。
912 排序数组
给你一个整数数组 nums,请你将该数组升序排列。要求不能使用内置函数。
解法一:三路分区 + 随机基准
functionsortArray(nums: number[]): number[] { const swap = (i: number, j: number) => { [nums[i], nums[j]] = [nums[j], nums[i]]; }; const sort = (l: number, r: number): void => {if (l >= r) return;// 👈 随机选基准:把「最坏情况」从必然发生变成概率极低const randomIdx = l + Math.floor(Math.random() * (r - l + 1)); swap(l, randomIdx);const pivot = nums[l];let lt = l; // [l, lt) < pivotlet i = l + 1; // [lt, i) == pivotlet gt = r; // (gt, r] > pivotwhile (i <= gt) {if (nums[i] < pivot) { swap(lt, i); lt++; i++; } elseif (nums[i] > pivot) { swap(i, gt); gt--; // 👈 注意 i 不前进:交换过来的元素还没检查 } else { i++; } } sort(l, lt - 1); sort(gt + 1, r); }; sort(0, nums.length - 1); return nums;}三路分区的精髓在于四个区间的定义:
[l, lt) → 严格小于 pivot[lt, i) → 严格等于 pivot[i, gt] → 还没处理(gt, r] → 严格大于 pivot两个最容易写错的地方:
nums[i] > pivot时swap(i, gt); gt--,**i不能前进**——因为换过来的那个元素是从「未处理区」来的,还没检查过nums[i] < pivot时swap(lt, i); lt++; i++——换过来的元素来自「等于区」,一定已经等于 pivot,所以i可以前进
三路分区解决了什么问题? 全相同元素的数组,普通两路分区会退化成「一边空、一边 n-1」,而三路分区会一次把所有相等元素全部归位,直接跳过递归。这就是「对大量重复元素免疫」。
解法二:归并排序
functionsortArrayMerge(nums: number[]): number[] { if (nums.length <= 1) return nums; const mid = Math.floor(nums.length / 2); const left = sortArrayMerge(nums.slice(0, mid)); const right = sortArrayMerge(nums.slice(mid)); const res: number[] = []; let i = 0, j = 0; while (i < left.length && j < right.length) {// 👈 相等时取左边,保持稳定 res.push(left[i] <= right[j] ? left[i++] : right[j++]); } while (i < left.length) res.push(left[i++]); while (j < right.length) res.push(right[j++]); return res;}归并版的好处是性能与输入完全无关——无论有序、逆序、全相同,都是稳定的 O(n log n),不存在被特殊用例卡住的风险。缺点是 O(n) 额外空间。
复杂度:快排版期望 O(n log n)、最坏 O(n²)(随机化后概率极低),空间 O(logn)(递归栈);归并版稳定 O(nlogn),空间 O(n)。
💬 面试官:912 你会用哪个解法?为什么?
✅ 标准答案:首选三路分区 + 随机基准的快排——原地、常数因子小、对重复元素免疫;如果追求「最坏情况也保证 O(n log n)」,可以用归并排序,代价是 O(n) 额外空间。
🎁 加分答案:能说出「为什么朴素快排过不了」——固定取首元素的实现在**已排序数组上会退化成 O(n²)**,而这道题的测试用例恰好包含这种情况;三路分区额外解决了「全相同元素」用例。还能补一句「这也是 Java 的
Arrays.sort用双轴快排的原因:单轴分区在重复元素多的场景损失较大」。
75 颜色分类
给定一个包含红色(0)、白色(1)、蓝色(2)的数组,原地排序,使相同颜色相邻,顺序为 0、1、2。不能使用 sort。
思路:这道题本质就是值域只有 3 个的计数排序,但由于要求原地,标准做法是三指针一趟扫描(荷兰国旗问题)。
functionsortColors(nums: number[]): void{ let p0 = 0; // 0 区的右边界(下一个 0 该放的位置) let i = 0; // 当前扫描指针 let p2 = nums.length - 1; // 2 区的左边界(下一个 2 该放的位置) while (i <= p2) {if (nums[i] === 0) { [nums[p0], nums[i]] = [nums[i], nums[p0]]; p0++; i++; } els eif (nums[i] === 2) { [nums[i], nums[p2]] = [nums[p2], nums[i]]; p2--;// 👈 i 不前进:换过来的元素还没检查 } else { i++; } }}三个指针划分出四个区间:
[0, p0) → 全是 0[p0, i) → 全是 1[i, p2] → 待处理(p2, n-1] → 全是 2**循环条件是 i <= p2**(不是 i < n)——因为 p2 右边已经处理好了,i 越过 p2 就说明全部处理完毕。
为什么 nums[i] === 2 时 i 不前进? 因为从 p2 位置换过来的元素属于未处理区,它的值可能是 0、1、2 中的任意一个,必须重新检查。而 nums[i] === 0 时换过来的元素来自「1 区」,必然是 1,所以可以安全前进。
这道题和快排三路分区的关系:其实就是三路分区的一个特例——pivot 固定为 1,而数组里的值只有 0/1/2 三种。所以「三路分区」这个技巧,一次学会,两处能用。
复杂度:时间 O(n)(每个元素最多被检查两次)、空间 O(1)(原地)。
💬 面试官:75 题你用了什么思路?为什么不能用计数排序?
✅ 标准答案:用三指针一趟扫描(荷兰国旗问题),
p0维护 0 区右边界、p2维护 2 区左边界,i从左往右扫。遇到 0 就交换到左边、遇到 2 就交换到右边、遇到 1 直接跳过。时间 O(n)、空间 O(1)。
🎁 加分答案:能指出「计数排序也能做,但要两趟而且需要额外空间」——计数排序要先统计再回填,是两趟遍历;三指针法一趟就完成且完全原地;还能说出「这道题本质是三路分区的一个特例,pivot 固定为 1」,把排序题和分区题打通。
148 排序链表
给你链表的头结点 head,请将其按升序排列并返回排序后的链表。
为什么链表排序首选归并? 因为快排的核心操作「分区」需要随机访问元素(左右指针从两端向中间夹逼),而链表只能顺序访问。归并排序的「分」只需要找中点(快慢指针),「合」只需要顺序遍历——完全适配链表的访问特性。
解法:快慢指针找中点 + 归并
class ListNode { val: number; next: ListNode | null; constructor(val?: number, next?: ListNode | null) {this.val = (val === undefined ? 0 : val);this.next = (next === undefined ? null : next); }}functionsortList(head: ListNode | null): ListNode | null{ // 递归出口:空链表或只有一个节点 if (!head || !head.next) return head; // 快慢指针找中点:slow 停在中间偏左的位置 let slow = head; let fast = head.next; // 👈 从 head.next 起步,保证偶数长度时 slow 偏左 while (fast && fast.next) { slow = slow.next; fast = fast.next.next; } // 断开成两段 const mid = slow.next; slow.next = null; // 递归排序两段,再合并 return mergeTwo(sortList(head), sortList(mid));}functionmergeTwo(a: ListNode | null, b: ListNode | null): ListNode | null{ const dummy = new ListNode(0); // 👈 哑节点统一头节点与非头节点的处理 let p = dummy; while (a && b) {if (a.val <= b.val) { // 👈 相等取左边,保持稳定 p.next = a; a = a.next; } else { p.next = b; b = b.next; } p = p.next; } p.next = a ? a : b; return dummy.next;}快慢指针的两个细节:
fast从head.next起步(而不是head),是为了让偶数长度时slow停在中间偏左。比如[1,2,3,4]:fast走 4→null 时slow停在 2,两段是[1,2]和[3,4],长度均衡如果 fast也从head起步,偶数长度时slow会停在偏右,导致两段长度不均([1,2,3]和[4]),递归深度变深
21 合并两个有序链表
题目:将两个升序链表合并为一个新的升序链表并返回。
解题思路:类似归并排序算法的「合」那一步。
解题步骤:
新建一个新链表,作为返回结果 用指针遍历两个有序链表,并比较两个链表的当前节点,较小者先接入新链表,并将指针后移一步 链表遍历结束,返回新链表
// todo 合并两个有序链表/** * Definition for singly-linked list. * class ListNode { * val: number * next: ListNode | null * constructor(val?: number, next?: ListNode | null) { * this.val = (val===undefined ? 0 : val) * this.next = (next===undefined ? null : next) * } * } */exportclass ListNode { val: number; next: ListNode | null; constructor(val?: number, next?: ListNode | null) {this.val = (val===undefined ? 0 : val);this.next = (next===undefined ? null : next) } }export functionmergeTwoLists(list1: ListNode | null, list2: ListNode | null): ListNode | null{ let list = new ListNode(0); let p = list; while(list1 && list2) {if(list1?.val <= list2?.val) { p.next = list1; list1 = list1.next; } else { p.next = list2; list2 = list2?.next; } p = p.next } p.next = list1 ? list1 : list2; return list.next;};import"mocha";import { expect, assert } from"chai";import { mergeTwoLists, ListNode } from"../leetcode";describe("合并两个有序链表 LeetCode 测试", function () { it("合并两个有序链表", function () {const list1 = new ListNode(1, new ListNode(2, new ListNode(4)));const list2 = new ListNode(1, new ListNode(3, new ListNode(4)));const list = new ListNode(1, new ListNode(1, new ListNode(2, new ListNode(3, new ListNode(4, new ListNode(4)))))); expect(mergeTwoLists(list1, list2)).to.be.deep.equal(list); }); it("合并两个有序链表", function () {const list1 = new ListNode(1);const list2 = new ListNode();const list = new ListNode(0, new ListNode(1)); assert.deepEqual(mergeTwoLists(list1, list2), list); }); it("合并两个有序链表", function () {const list1 = new ListNode();const list2 = new ListNode(0);const list = new ListNode(0, new ListNode(0)); assert.deepEqual(mergeTwoLists(list1, list2), list); }); it("合并两个有序链表", function () {const list1 = new ListNode();const list2 = new ListNode();const list = new ListNode(0, new ListNode(0)); assert.deepEqual(mergeTwoLists(list1, list2), list); });});复杂度:时间 O(n + m)(n、m 为两个链表长度),空间 O(1)(只用了常数个指针,直接复用原节点)。
三道题的复杂度对比:
O(nlogn) 期望 | O(logn) 栈 | ||
O(n) | O(1) | ||
O(nlogn) | O(logn) 栈 |
💬 面试官:148 为什么不用快排?能优化到 O(1) 空间吗?
✅ 标准答案:链表不适合快排——快排的分区需要「从两端向中间夹逼」,这要求 O(1) 随机访问,而链表只能从头顺序遍历,取「倒数第 k 个」都要 O(n)。归并排序的「分」只需要找中点(快慢指针 O(n))、「合」只需要顺序遍历,完全适配链表。空间上,递归版是 O(log n) 的递归栈。
🎁 加分答案:能给出自底向上的迭代版归并——先两两合并成长度 2 的有序段,再合并成长度 4、8…,全程只用几个指针、不递归,空间真正做到 O(1)。实现要点是「每轮用一个
step控制每段长度,逐步倍增」,是链表题里区分度很高的一问。
💡 一张图总结(面试速记表)
先看时间与空间。平均时间复杂度一栏(In-place 表示额外空间 O(1) 级别):
O(n²) | O(n²) | O(1) | |
O(n²) | O(n²) | O(1) | |
O(n²) | O(n²) | O(1) | |
O(n^1.3) | O(n²)O(n^1.5) | O(1) | |
O(nlogn) | O(nlogn) | O(n) | |
O(nlogn) | O(n²) | O(logn) | |
O(nlogn) | O(nlogn) | O(1) | |
O(n+k) | O(n+k) | O(n+k) | |
O(n+k) | O(n²) | O(n+k) | |
O(d·n) | O(d·n) | O(n+b) |
再看最好情况——这张表信息量很大,因为它区分了「这个算法会不会因为数据有序而变快」:
O(n) | O(n²) | |
O(n²) | ||
O(n) | while 首次比较即退出 | |
O(nlogn) | O(nlogn) | |
O(nlogn) | ||
O(nlogn) | ||
O(nlogn) | ||
O(n+k) | k | |
O(n+k) | ||
O(d·n) | d | |
O(n) |
再看稳定性与选型:
最后是这张「一句话内核」:
Array.prototype.sort 必须稳定 | ||
log₂(n!) = Θ(nlogn) | ||
O(n²);随机化/三数取中/三路分区解决 | ||
kMinTimSortLen = 10,不是 64 | ||
💡 记住这条主线:排序的所有考点,最终都归结为三个问题——「稳不稳定」「最坏多快」「额外占多少空间」。十个算法就是这三个维度的十种取舍:冒泡选择插入用「简单」换「速度」,归并快排堆排用「技巧」换「n log n」,计数桶基数用「额外假设」换「线性」。而 V8 的
sort之所以是 TimSort/PowerSort,是因为标准库必须同时满足「稳定 + 最坏 O(n log n) + 对真实数据快」这三个硬指标——这三个指标,恰恰是单一经典算法都给不全的。
📝 留个问题
Array.prototype.sort 还有一个很多人不知道的行为:它会把 undefined 和数组里的空洞,全都排到数组末尾,而且 undefined 后面的元素不会被传给比较函数。
给你两个方向思考:
规范层面:为什么 ECMA-262 要把这个行为写进规范?如果不这样规定,不同的比较函数会怎么影响结果? 实现层面: CompactReceiverElementsIntoWorkArray这个函数名叫「压缩」,它在压缩什么?为什么不直接排?
提示:想想「比较函数是用户传进来的」这件事——用户写的 compareFn 对 undefined 会返回什么?如果它返回了奇怪的值,排序还怎么保证正确?
欢迎在评论区写下你的答案 👇
参考资料
ECMA-262 规范 Array.prototype.sort章节:https://tc39.es/ecma262/ (稳定性的规范依据,ES2019 起明确要求)V8 官方博客「Getting things sorted in V8」:https://v8.dev/blog/array-sort (2018 年 TimSort 上线的官方说明) V8 源码 third_party/v8/builtins/array-sort.tq(TimSort 时期的实现,kMinTimSortLen、ComputeMinRunLength、MergeCollapse、GallopLeft/Right均在此文件)V8 源码 src/objects/js-array.h(kMaxInlineSortLength = 16的定义处)V8 提交记录: [array] Move Array.p.sort to Torque and use TimSort instead of QuickSort(2018)V8 提交记录: [builtins] Sorting: TimSort --> PowerSort(2026-04,跟随 CPython PR #28108)《算法导论》(CLRS)—— 比较排序下界与决策树模型(第 8 章) 《算法》(Sedgewick / Wayne,第 4 版)—— 归并、快排、优先队列的实现与优化 可视化演示 VisuAlgo(中文版):https://visualgo.net/zh (十大排序的逐步动画,适合对着文章第三节到第五节逐个看) 可视化演示 Toptal Sorting Animations:https://www.toptal.com/developers/sorting-algorithms (同一组数据跑不同算法,直观感受「谁快谁慢」) https://www.hello-algo.com/chapter_sorting/
🔖 这是「前端数据结构与算法」系列第 10 篇。上一篇:《图:从 Webpack 依赖图到拓扑排序与最短路径(面试收藏级)》;下一篇预告:《搜索算法完全指南:循环不变式、BFS/DFS 与滑动窗口(面试收藏级)》