ARTICLE · 1341813
这个翻译插件,把 45 家翻译服务塞进了一个下拉框
读一篇英文技术文档,大多数人会走三条路。
第一条,整段复制到翻译网站。格式全丢,代码块和表格混成一坨,还得来回切窗口。
第二条,装个整页翻译插件。翻完一看,中文盖住了原文,想知道哪句对哪句,只能凭感觉猜。
第三条,开个 AI 对话框,一段段粘进去问。准是真准,就是慢,而且上一段的上下文它记不住。
一个 10,134 星标的开源插件,把这三条路拧成了一条:原文留着,译文一段对一段插在下面。它叫流畅阅读,英文名 FluentRead,仓库在 github.com/FluentRead/FluentRead。
但让它跟其它翻译插件拉开距离的,不是这个双语排版。是设置页左上角那个数字:45。
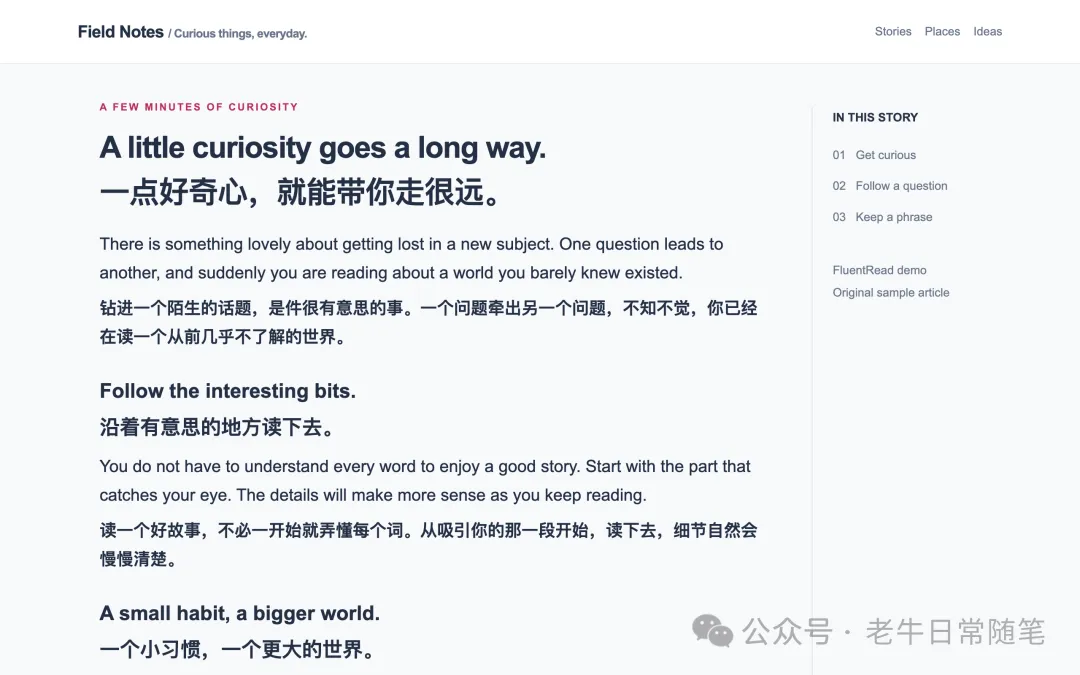
官方演示页的双语对照效果:英文原文保留,中文译文逐段插在下面(来源:github.com)
它把「用哪家翻译」变成了一个下拉框
打开设置里的翻译服务,顶部写着「服务 45」。这 45 项不是 45 个功能按钮,是 45 家能实际干活的翻译服务商。
上面分了四个标签:机器翻译、云服务厂商、模型服务商、聚合平台与接口。
机器翻译这一栏,既有微软、谷歌、DeepL、MyMemory,也有 B站翻译、腾讯交互翻译、火山翻译、豆包网页翻译、有道翻译、金山词霸、小牛翻译。
云服务厂商那一栏是各家云计算的官方接口:阿里云、腾讯云、百度、火山引擎,外加 Azure 和谷歌云。
模型服务商那一栏放的是大模型:DeepSeek、Claude、腾讯混元。
最后一个标签,留给「你自己填地址」的那一类,包括本地跑的 Ollama。
普通翻译插件只给你一根管子,接不上就只能干看着。它是把整排插座摆出来,你自己挑。
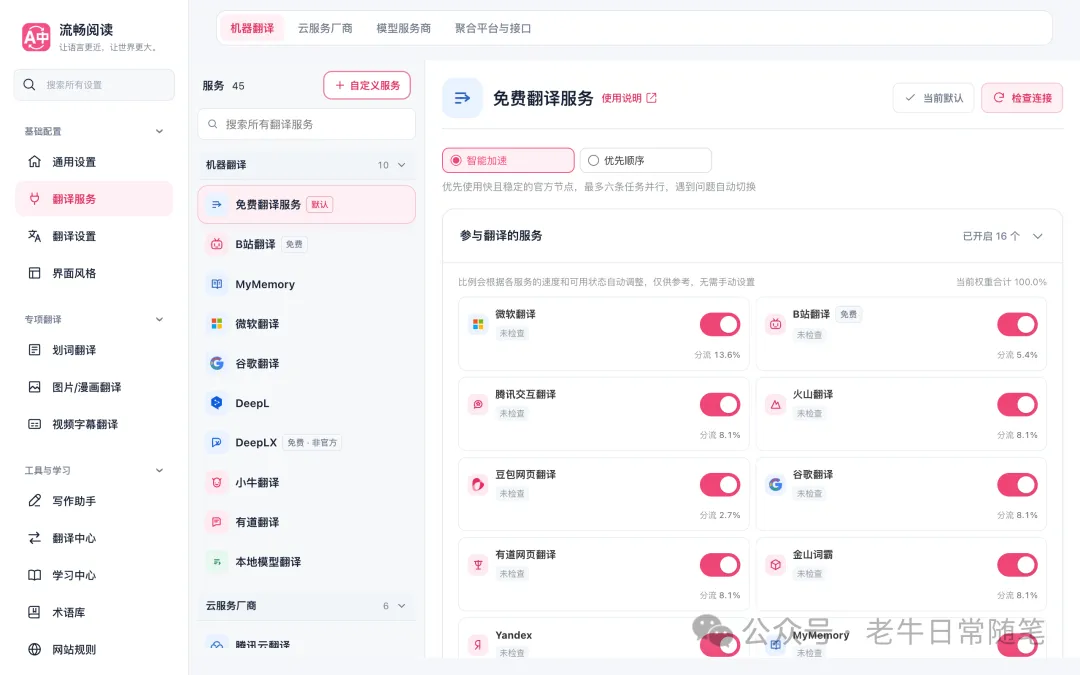
翻译服务设置页:左边是服务目录,右边能看到每个服务开没开、各占多少分流比例(来源:github.com)
免费那一档,国产接口比国外的还多
很多人以为免费的口子就谷歌和微软两个。
翻一下它的免费池,国产的反而更多。
B站翻译、腾讯交互翻译、火山翻译、豆包网页翻译、有道网页翻译、金山词霸、小牛翻译,全在免费档。国外的有微软、谷歌、Yandex、MyMemory。
这些口子不是随机抽一个用。默认策略叫「智能加速」:按各家当前的速度和可用状态自动分配,最多同时开六条任务,某一家出问题就换下一家。
设置页上每个服务底下都标着一个「分流比例」:微软 13.6%、腾讯交互 8.1%、火山 8.1%、谷歌 8.1%、B站 5.4%、豆包网页 2.7%。
这些百分比不是写死的,是跟着响应速度在动。
不想让它自己调度,也可以切成「优先顺序」,按你排的次序挨个试。
不过官方文档里有句提醒写得很实在:免费网页接口可能被限流、被改动、甚至停服,不保证一直能用。
豆包那个还标着「实验接口」,走匿名的网页参数,不读你浏览器里的 Cookie,也不读你在豆包那边配的 API Key。
想接自己的 DeepSeek,要填的框就那么几个
免费口子够日常用。但有两种情况你会想换:一天翻几十篇被限流,或者想让它顺手把句子讲明白。
从省事到折腾,三条路。
第一条,直接用国内云厂商的官方翻译接口。这四家是内置的,选完只填密钥,不用管接口长什么样。
1阿里云机器翻译:AccessKey ID、AccessKey Secret、地域
1腾讯云翻译:SecretId、SecretKey
1百度翻译:APP ID、密钥
1火山引擎翻译:Access Key ID、Secret Access Key、地域
地域那一项得跟你在控制台开的资源对上,填错了会鉴权失败,这一步最容易卡人。
另外,腾讯混元和腾讯混元翻译是两个东西:前者填 API Key,后者要 SecretId 加 SecretKey。别看名字像就填错。
第二条,接你自己的大模型。设置里有「自定义服务 → 兼容接口」,走的是 OpenAI 那套 Chat Completions 协议——现在国内大模型基本都支持这个通用格式。
地址栏有三种填法,它会自己补全:
1只填域名,比如 https://api.xxx.com,自动补成 /v1/chat/completions
1填到 /v1,自动补成 /chat/completions
1填完整路径,就按你写的发请求
模型那一栏要填服务商文档里的 API 模型 ID,不是网页上看到的展示名。
所以 DeepSeek、通义、智谱、Kimi 这些,只要服务商给你一个 OpenAI 兼容地址,都能接进来。地址和模型 ID 从控制台复制,别自己拼。
有一种模型接不了:只提供 /responses、/messages 或者 Gemini 原生协议的,用不了这个兼容接口。
第三条,干脆不出网。
设置里有「本地模型翻译」,下个语言包就能离线译:中英轻量包约 239 MB,腾讯混元开源的 Hy-MT2 1.8B 约 1.13 GB,日英轻量包约 214 MB。
这里有个坑得提前说。官方文档专门写了一句「下载大小不等于运行内存」。
1.13 GB 是硬盘上的文件大小,真跑起来内存会明显上去,电脑弱的会卡。
装了 Ollama 的,也可以直接连本机 http://127.0.0.1:11434,不用密钥。电脑慢的话,把那个服务的并发设成 1,别让它一次发好几段出去。
还有个细节挺实用:同一家的多个 Key 可以放一起轮换,哪个额度用完或者被限流,自动换下一个。
翻译插件最容易翻车的地方,其实是排版
翻得准不准,一眼能看出来。排版乱不乱,得装上去才发现。
这类插件有三个经典翻车现场。
一是翻完格式没了,段落变成一坨;二是一句话被链接和加粗切成好几块,分开翻之后语义断了;三是页面还在加载新内容,译文插错位置,原文也回不去。
它在这块做了几件具体的事,官方架构文档里都能查到。
第一,一段话中间夹着链接、加粗、斜体,它当一整段送出去翻,不拆成几段。译文回来之后,再按原来的骨架填回每个位置,格式不会散。
第二,页面内容一直在变,它靠一套「这块内容是谁写的」的标记来判断:这是我自己插的译文,还是网页自己刷出来的。分不清的时候宁可不覆盖。
第三,如果你之前已经用别的插件翻过这一页,它会退让,不让两套译文叠在一起。你把那个插件关了,它才重新接管。
还有一个看不太见但挺关键的:翻译结果存在浏览器本地,上限 1 万条、10 MB 出头,有效期 24 小时。翻过的页面再打开,基本秒出。
缓存写失败的时候它也照常翻译,不会因为存不下就罢工。
它还伸手管了 PDF 和字幕,但有一处明显短板
网页之外,它伸了三只手。
文档翻译:PDF、ePub、DOCX 打开就是双语对照,译文能改,也能导出来。
图片和圈选翻译:网页里的图片、你在屏幕上框的一块,都能认字再翻。
PDF 导出还做了个细节:缺中文字体会去镜像下载,简体中文优先国内镜像。
视频字幕:YouTube 和 X 上能出双语字幕,部分 X 视频还能用本地模型转写。
短板也在这儿——只支持 YouTube 和 X。
B站没有。对国内用户来说,这条基本等于用不上:我们要看的英文视频,大多不在那两个站。
另外,油猴脚本版只保留网页翻译的核心功能,本地模型、文档、字幕这些都没有。
还有个功能值得单独说:AI 阅读卡。
选中一句话,点开一个小面板,四个标签:读懂、拆句、用法、练习。
它给这句话的意思和语气,拆开讲语法,把关键表达拎出来配例句,还能顺着这句继续追问。
这个功能得自己配 AI 服务才有。光用免费翻译接口,是不带讲解的。
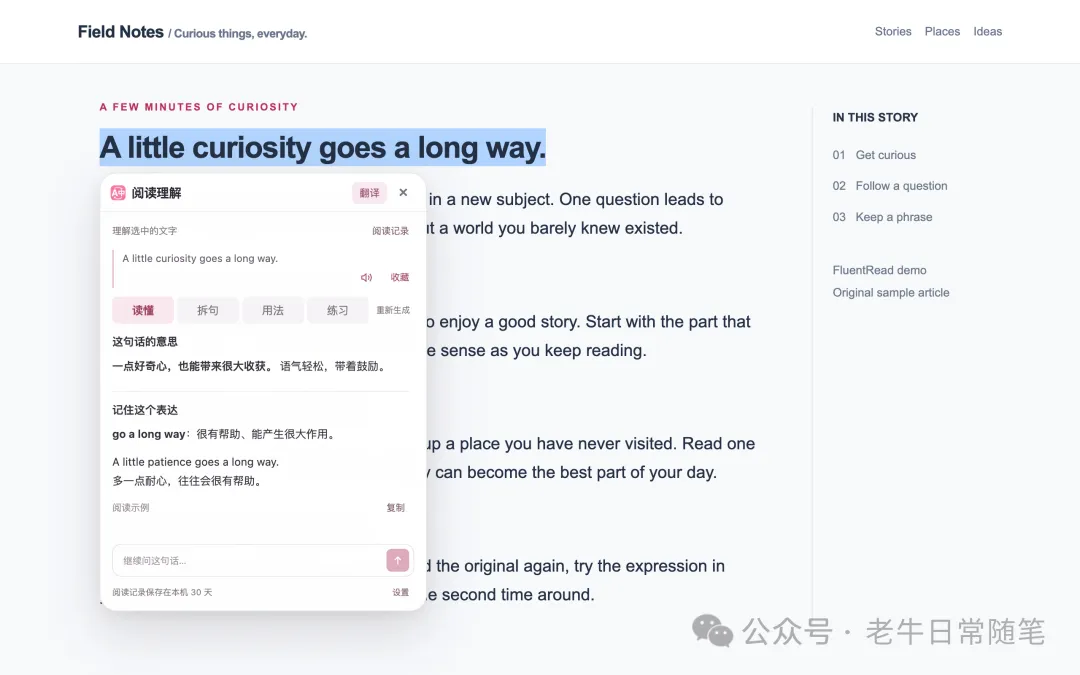
选中一句话后弹出的阅读卡:读懂、拆句、用法、练习四项可以切换,底部写着阅读记录存在本机 30 天(来源:github.com)
该装的装,该绕的绕
先看项目状态:10,134 星,566 个 fork(别人复制一份去改的次数),44 个还开着的问题,TypeScript 写的,GPL-3.0 协议(谁拿去改都得同样开源),最后一次提交是 2026 年 11 月 9 日,很活跃。
技术上它用 WXT 加 Vue 3 搭的浏览器扩展,翻译服务、站点规则、术语库分开存,测试要求语句、分支、函数、行数四个维度都做到 100% 覆盖——这在个人项目里算少见,说明作者是当正经产品在做。
README 里写得也挺直白:目前主要靠个人掏钱,每月几百美元的维护成本。第一个赞助方是 B站的 Index-Translate。
我的判断是这样。
经常读英文文档、论文、issue,需要原文对照着看的人,可以装。
不想为翻译开会员,又受不了单一免费接口限流的人,可以装——它的免费池确实够宽。
手里已经有 DeepSeek 这类 Key,想把翻译和讲解合到一块的人,值得装。
主要看 B站 视频字幕的,先别指望它。
只想装个能翻就行的,浏览器自带的整页翻译更省事,不用折腾。
对隐私敏感的,注意一点:配置能备份到自己的网盘(WebDAV 或 Google Drive),但备份里包含服务凭据。
选它的成本主要在前十分钟:挑引擎、填密钥、随便找篇英文页面试一遍。之后就只是打开网页,点一下。
这十分钟懒得花的话,它确实不如浏览器自带的整页翻译顺手。