ARTICLE · 1037965
我不懂教学,如何给AI"名师判断力"建供应链(二)
一、先搞清楚 AI 的误判长什么样
做质检之前,要先知道 AI 会怎么错。我们设计了一组对照测试:同一道高考真题(16 条 1932 年新闻标题拟主题写短评),两个 AI 上场,一个只给备课框架(裸 AI),一个框架加案例库(装备 AI),都不许查答案。预判完,拿期刊记录的真实学生错答对照。
名师记录的真实错答是:"国民政府坚持打内战""中国共产党是抗战的中流砥柱""国共合作抗击日本侵略",错因三类:信息片面、时空错乱、后见之明。
测试结果有三点值得记录:
1. 裸 AI 能做出高质量预判。它预判学生可能拟"国共合作共同抗日"——与真实错答几乎一字不差,并还原了路径:看到"红军大胜利"与"击退日军"相邻,脑补出统一战线,忘了 1932 年国共正围剿反围剿。
2. 装备 AI 反而漏掉了这个弯。它的预判全部"有出处",却漏了真题特有的错。原因是向库收敛:有了案例库后,AI 倾向于套用库中已有的错误模式,不再为眼前这道题专门想一遍。库帮了忙,也蒙住了眼。
3. 两类盲区四个受试者无一完整命中。知识型盲区——需要专门知识才能发现的错(如把欧洲"匈人"与中国"匈奴"画等号);缺席型盲区——需要看出"材料没说什么"(如材料只讲游牧冲击欧洲,没讲长城保障丝绸之路的积极作用)。
结论:AI 的预判可用,但存在两类补不上的短板,必须有人守。这不是态度问题,是实测结果。
二、质检动作的设计:审校页与留删法
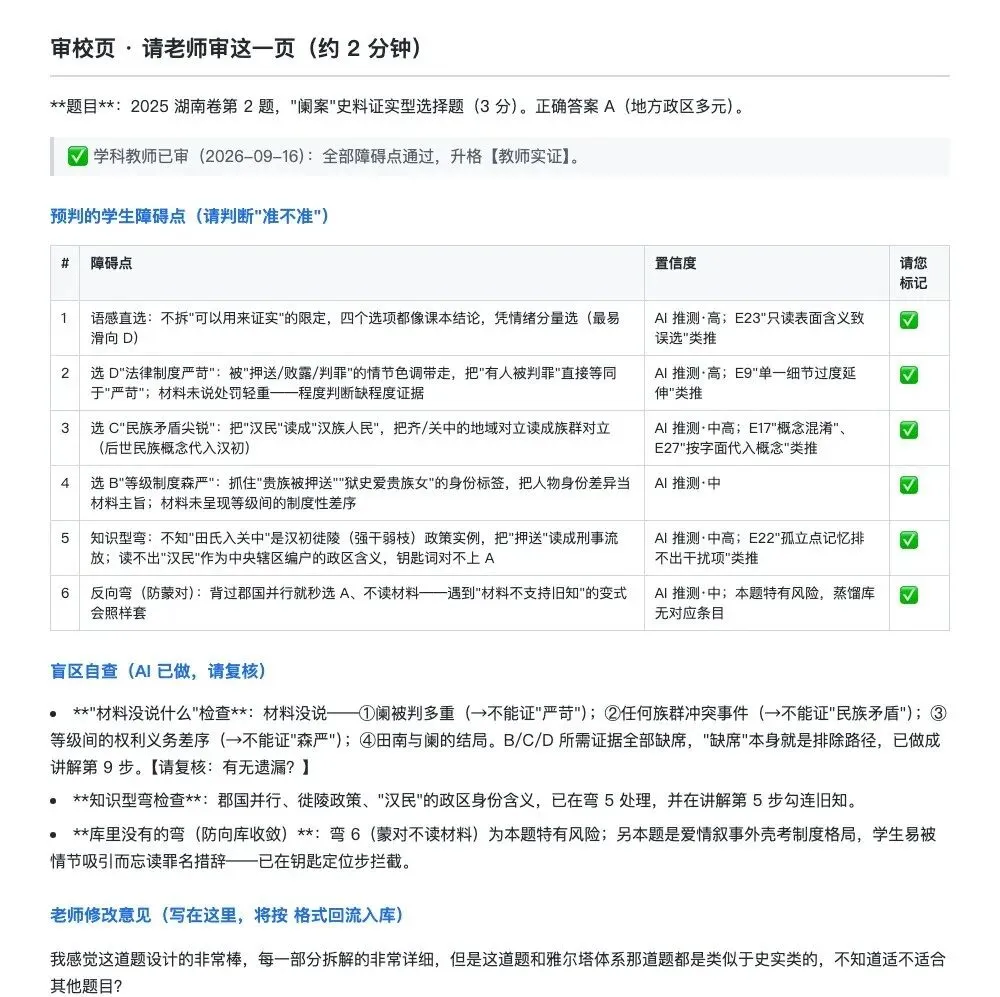
人守什么、怎么守,取决于成本。让老师通读每份课件,一次一小时,不可持续——不可持续的把关等于没有把关。我们把验证动作压缩到两分钟,产物是一张 A4 纸,叫审校页:
内容只有一张表:这道题 AI 预判了哪几个弯,一条一行; 每条带置信度标注:名师实证 / 期刊实证 / 课件类推 / AI 推测——老师一看就知道该把注意力放在哪; 老师批改用留删法:每行末尾印着 ✅/❌,留一个删一个。留 ✅=预判准,留 ❌=不准,一行一秒,不用写评语; 只有两类盲区弯(知识型、缺席型)需要想深一点,其余快速过。
设计逻辑:把专业验证压缩到两分钟,老师才肯天天在场;天天在场,质检才成立。
三、第一批实测:27/27
第一批送审五份课件,覆盖五种题型(选择题、材料题、短文题、比较题、图表题),共 27 条预判。
结果:27 条全部通过,零修改。
对这组数据我们内部做过一次复核,结论是两点:其一,流程成立——从生成、预判到真人验证的链路是通的;其二,这五道题都在案例库覆盖范围内,属于主场作战,27/27 不能外推为普遍命中率,真正的考验在完全陌生的题上(后续"期中考"已在跑)。
质检过程中也发生了一次典型的真人纠偏:AI 在课件里把一段学生习作诊断为"没有自己的观点",其中有一句"1971 年,乒乓外交打开了中美交往的大门"。老师批注:"这句话不是观点吗?"——"打开了大门"是对事件意义的评价,本身就是观点。后来统一改成三态表述:复述事实 / 复述别人的观点 / 有自己的中心论点。这个案例说明 AI 的误差常在一字一句的成色上,真人的一眼目前仍不可替。
四、这套质检对家长同样成立
质检的设计不依赖教学专业背景,核心动作是"拿预判清单对照真实作答"。家长完全可以复用:
让 AI 出一份"这道题孩子可能错在哪"的预判清单; 孩子裸做一遍题; 家长拿清单对照孩子的答案,逐条判断"像不像我孩子的错"。
老师审的是"准不准学生的错",家长审的是"像不像我孩子的错"——论对自己孩子思维习惯的了解,家长是最合适的质检员。这也是我们说"外行不生产判断,外行组织判断"的含义:AI 负责生成预判,人负责在闸口上签字,各司其职。
这里还要说清一件事:老师在质检环节的位置,是临时的。我们最终要的是"教师退出机制"——使用端(家长和孩子)这条回路,从设计上就不需要老师:家长验证的不是"这个弯对全体学生准不准",而是"我家孩子踩没踩中",地面真相就在眼前,不需要专家。老师真正不可替代的是建库早期:新题型出现、课标变化时做判断。等库厚到一定程度(用连续批次陌生题的通过率来量,比如稳定在 90% 以上),老师就从"每单全审"退到"抽审"、再退到"只审 AI 自评低置信的项",最终退出日常环节,只在需要时会诊。退出不是宣布的,是拿通过率考出来的。
小结
质检段的做法三句话:先实测 AI 会怎么错(对照测试,量出两类盲区);再把验证压缩到两分钟(审校页+留删法);第一批数据 27/27,流程成立,但不外推。
下一个问题是:今天的预判验完了,明天呢?原料会断顿、库存会过期、系统会自我复制退化——怎么让整条链自己转起来并且越转越好。第三篇,流转。