ARTICLE · 1037959
我不懂教学,如何给AI"名师判断力"建供应链(一)
团队没有一个懂教学的,但要做"像老师那样讲题"的 AI 产品。这件事要成立,先要解决一个问题:好老师讲题的判断力从哪来、怎么持续获得。这篇讲我们的解决办法:拆个课、建雷达供料、用蒸馏工艺加工。
一、先搞清楚要的东西长什么样:拆一份课件
做技术的第一步不是学教学理论,是找一个经过验证的样本拆开看。我们拆的是互动课件《雅尔塔会议的一种版本》(高考山东卷真题讲解),共 23 个步骤。
拆解后的事实是:23 步里只有 4 处提问,其余全是讲解。但这 4 处提问,每一处都对应一个真实的学生错误:
第一处针对"整句当史实":材料里"苏军在波兰展开攻势,把英美军队从覆灭的威胁中拯救了出来",学生容易把整句划成史实,而后半句"拯救"其实是观点; 第二处针对"答非所问":第二问问"解释形成的原因",学生容易答成"会议召开的原因"; 另外两处分别针对"空泛建议"("应该更全面")和"证据误读"。
反馈的设计也有讲究:学生答错后不给答案,只说"你注意到了苏军的行动。再看后半句"——先接住学生已想到的部分,再指向漏掉的部分。
结论:这份课件的核心资产是预判——写稿者提前知道学生会在哪儿想错。我们称之为"障碍点"。这就是要找的原料。
二、验证普遍性:29 期期刊里的证据
一份课件可能是孤例。我们把《历史教学》2024–2026 年共 29 期(约 270 万字)全部检索了一遍,确认"预判学生错误"是普遍做法而非个例。两条代表性证据:
证据一:2024 年福建卷明嘉靖沿海卫所军户柱状图题,正答率 20.05%。36% 的考生选"倭寇问题严重"——看到"嘉靖""沿海"即自动联想,未读图;29% 的考生用排除法后看柱子高低不一,自洽出"沿海经济发展不均"而错选。
证据二:雅典自杀法律题。学生普遍正向思维误选"雅典尊重生命",正确解法是抓住"自杀需申请批准"做逆向推理——规定的实质是对个人自由的限制。期刊中的讲题示范全部是冲着这类错误点去的。
理论上,这与奥苏贝尔"影响学习最重要的因素是学习者已经知道了什么"以及讲评课"以错定教"的原则一致。
到这里可以确认:预判是行业通法,且可以被记录和收集。这是供应链有货可运的前提。
三、把方法写给 AI:从规则清单改成六个问题
第一次尝试是失败的。我们写了"明白纸 v0.1":四步管线、规则清单、十条翻车检查表,被评审否决,原话是"你现在是削足适履,不是丰富完善"。
原因:名师的判断不是规则,是遇到具体情况时的选择。规则清单让 AI 照单填空,产出的是不出错的平庸稿。
改为"明白纸 v0.2":不写规则,写老师备课时心里过的六个问题——①这道题要学生做出什么思维动作?②学生会在哪儿拐弯、卡住、想过头?③钥匙藏在材料哪个角落?④哪个弯停下来互动、哪个直讲?⑤学生答错了此刻最需要什么?⑥学生从这道题带走什么可迁移的动作?AI 必须先答完这六问,才许写讲稿。
用 2025 湖南卷"国球"短文题盲测(无任何现成学情):AI 按六问挖出了两把钥匙——材料出处《国家认同与集体记忆》直接给出了论点角度,1937 年"便是我民族发扬之时"是材料自带的点题句;并预判出"流水账""史论分离"两类学生错误。但五个预判的弯里只有一个有实证,其余是推测——推测如何验证,是第二篇的主题。
四、原料的持续供给:雷达
知道原料在哪之后,下一个问题是持续获取。靠人翻期刊、刷视频是运气活,不稳定。我们的做法是把"发现"自动化:部署了一台雷达(changedetection.io),目前 27 个监视点,分三层:
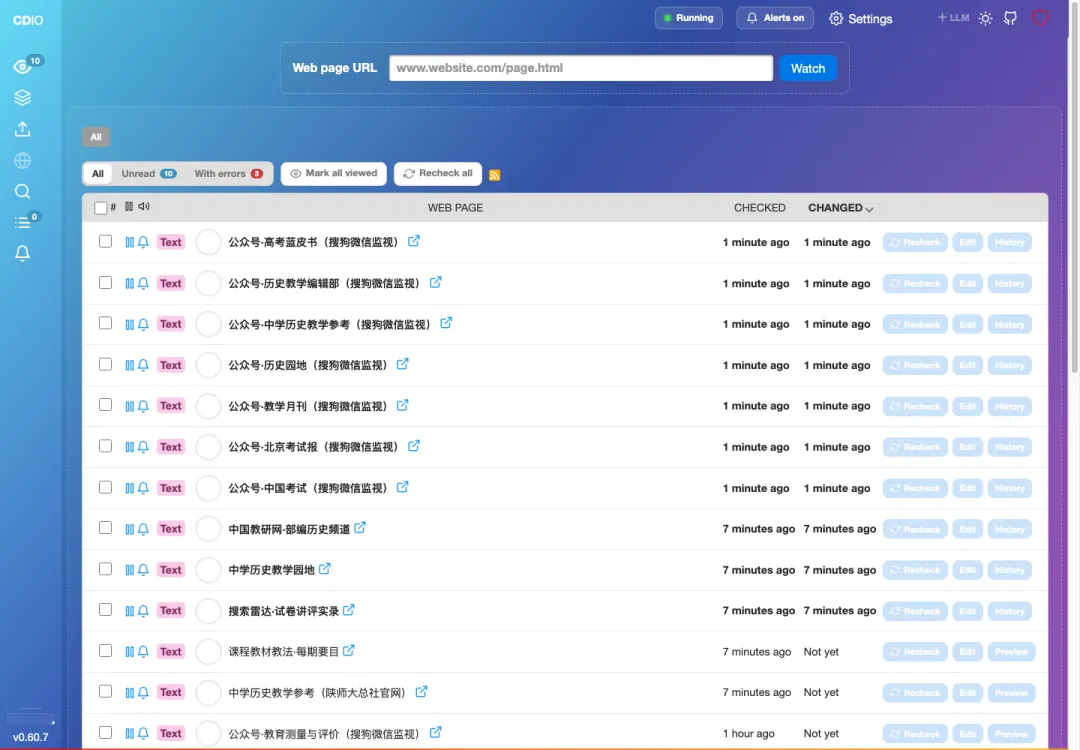
网页层(15 个点):《历史教学》《中学历史教学参考》《中国考试》等期刊官网,山东、浙江、湖南等省教育考试院栏目(试题评析发布口),教研平台和名师工作室网站; 公众号层(30 个点):通过搜狗微信搜索监视"中国考试""历史教学编辑部"等账号的新文章; 视频层(15个点):B 站高考历史讲题类 UP 主,新视频抓取 AI 字幕转文本。
雷达发现新内容后写入"素材登记表"(来源、日期、素材分级、表演风险标注),人工每周花两分钟勾选,勾中的进入蒸馏。公众号文章则给一个链接即可秒级提取正文转 Markdown。
五、原料的加工:蒸馏工艺
素材变成可用资产,要过一道蒸馏。我们的流程是六步,每一步都有明确规则:
定位关键事件:不全文通读,先扫描判断密度最高的地方——分歧点、转折点、学生卡壳处、教师"停下、拦住、放过、追问"的瞬间; 按提取单提取(每条六样):题目与情境;判断痕迹(停/拦/放/追,保留原话);真实学情记录(学生错误原话、得分率——有就记,没有空着,不许脑补);判断依据;可迁移模式;层级判定(这条属于经验、知识还是认知层); 反合理化追问:每条自问"这是教师当时的真实判据,还是事后写文章的合理化解释",存疑的降置信度; 质检(先于入库):讲不出具体情境和依据的条目直接扔掉; 五层分口入库:经验层进格子文件(按题型×环节分类)、知识层进模式区(同一模式在三个独立来源重现才转正)、认知层进框架区、元认知和价值观层交人裁决; 入库后三动作:更新索引、回填素材登记表、按层分流去向。 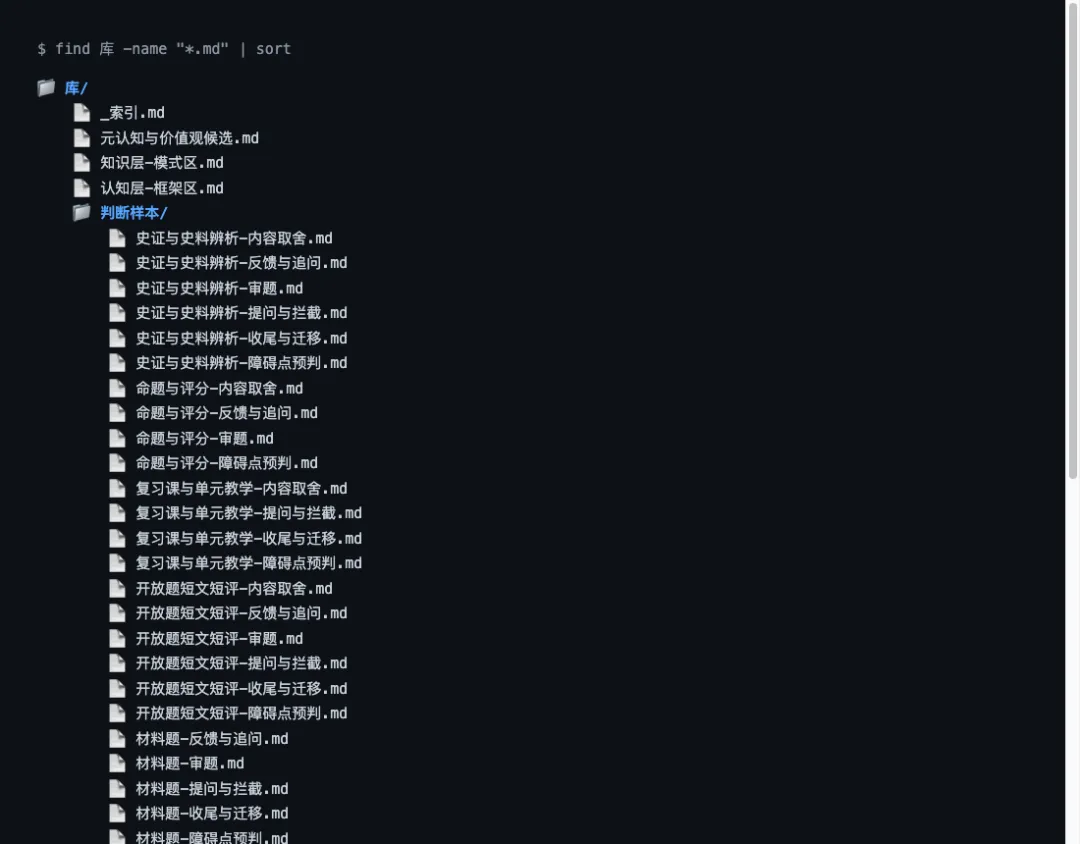
库里的条目都长一个样,以一条真实条目为例:【因果题·拦】学生答"商鞅确立新秩序所以秦国富国强兵",教师用晁错削藩、王莽新政、王安石变法皆败来拦截,追问"不确立新秩序能否富国强兵?"(出处:《历史教学》2025.06,名师实证)。
目前库里有 163 条这样的资产:65 条判断样本、49 条判断链、34 条学生错误案例、若干高层模式与框架。每条都带出处和置信度标签。
小结
进口这一段的做法可以压缩成三句话:拆真样本找到"预判"这种原料(雅尔塔、期刊);建雷达让原料持续不断供(60个监视点);用蒸馏工艺把原料加工成带标签的资产(163 条入库)。
下一篇的问题是:这些资产和 AI 用它做出的预判,准不准、谁来验?——质检环节,27 个AI弯老师全打了勾。