ARTICLE · 1069757
90分钟内,OpenAI和Anthropic同时降价:老美也开始打起了“价格战”
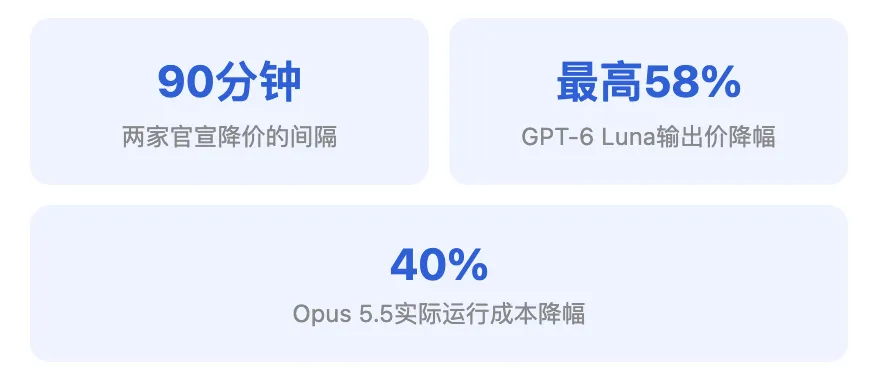
9月22日,AI圈发生了一件挺罕见的事:Anthropic先发布了降价版的Claude Opus 5.5,仅仅90分钟之后,OpenAI就跟着发布了大幅降价的GPT-6 Sol和Luna。两家全球估值最高的AI公司,在同一天、几乎同一时刻,不约而同选择用"降价"而不是"跑分"来打这一仗。这背后到底发生了什么,又会怎样影响整个市场——包括我们平时更熟悉的DeepSeek、豆包这些国产模型?我们来聊聊这个话题
一、发生了什么
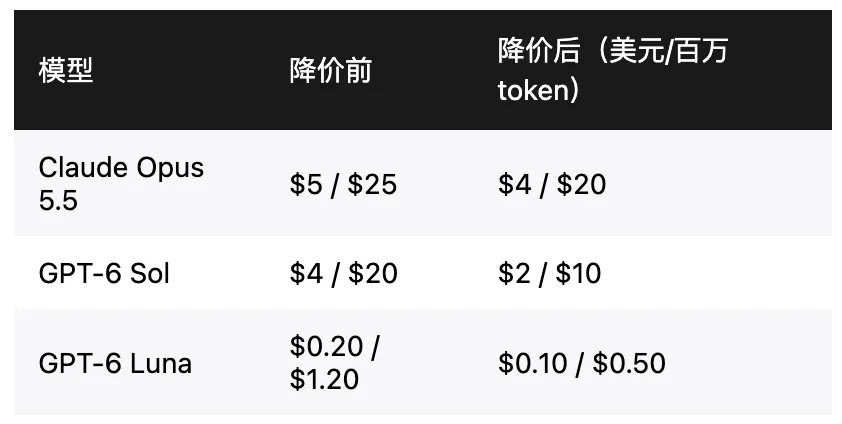
Anthropic先出手。9月22日,Anthropic发布Claude Opus 5.5,价格从上一代Opus 5的每百万token输入5美元/输出25美元,降到4美元/20美元,降幅20%;更关键的是缓存读取(cache read,编程和智能体任务里占大头的成本项)价格从0.50美元降到0.20美元,降了60%。Anthropic官方说法是,综合下来实际使用成本比上一代低了约40%,而且性能在大多数任务上能打平价格贵一倍多的旗舰版Fable 5.1。
OpenAI紧跟着回应。就在90分钟后,OpenAI发布GPT-6 Sol和GPT-6 Luna,价格直接砍半:Sol从4美元/20美元降到2美元/10美元;Luna从0.20美元/1.20美元降到0.10美元/0.50美元。OpenAI强调这是永久定价而非促销价,且Luna这一档已经便宜到比Claude Sonnet 5便宜约95%。
二、为什么两家几乎同时降价
1. 推理效率的真实提升,不只是"赔本赚吆喝"
两家都强调降价背后有真实的技术进步支撑——Anthropic说Opus 5.5完成同样任务所需的步骤更少;OpenAI也表示新一代模型在更好的缓存机制和推理效率下,服务成本本身就降低了。这意味着这不是纯粹靠"烧钱补贴"换市场份额,而是单位算力产出的智能确实在变多。
2. 企业客户的成本敏感度,正在成为核心竞争维度
有报道提到,OpenAI内部研究人员平均每天要消耗超过600美元的token,重度用户一天能花掉7000美元——这类数字侧面说明,大规模使用AI的企业和开发者,Token成本已经变成一笔实打实的预算压力,谁能把单位成本降下来,谁就更容易拿下企业市场和开发者生态。
3. 竞争烈度已经到了"你不降,用户就走"的地步
Anthropic和OpenAI几乎同时出手,本身就说明双方都在实时盯着对方的动作——这已经不是各自按自己节奏发新模型,而是进入了"你降我也必须跟"的价格战节奏,跟当年网约车、外卖补贴大战的逻辑有点像,只不过这次拼的是token单价。
值得一提的是,Anthropic此次降价还赶在了传闻中的IPO窗口之前——用更有竞争力的价格给招股书讲一个更好的市场份额故事,时间点耐人寻味。
三、这对整个大模型市场意味着什么
最直接的影响是中间价位的模型会被两头挤压——一边是Sol、Opus 5.5这类"高性能但更便宜"的主力型号,一边是Luna这类"极致低价走量"的轻量型号,夹在中间、性能和价格都不占优势的模型会很难卖。
第二个影响是竞争维度从"跑分"转向"每任务成本"——OpenAI这次公布的benchmark里,直接强调Luna完成单个任务的成本比Opus 5低93%,这种"按任务算账"的对比方式,本身就是在告诉开发者和企业:别只看模型强不强,要看办成一件事到底花多少钱。
第三,对下游的应用开发者和内容创作者(包括做AI相关内容、AI工具的独立开发者)是实打实的利好——同样的预算,能调用的token量变多了,用AI做产品、做内容的边际成本还在持续下降,这也是为什么"用AI做副业"这件事的门槛这两年一直在往下走。
四、放到中国模型里比一比:DeepSeek、豆包处在什么位置
这次降价让人很自然地想问一个问题:美国大厂降价之后,是不是把价格差距追上了中国模型?答案是——差距缩小了,但远没追平,尤其是在"走量"这个价位段,中国模型依然明显更便宜。
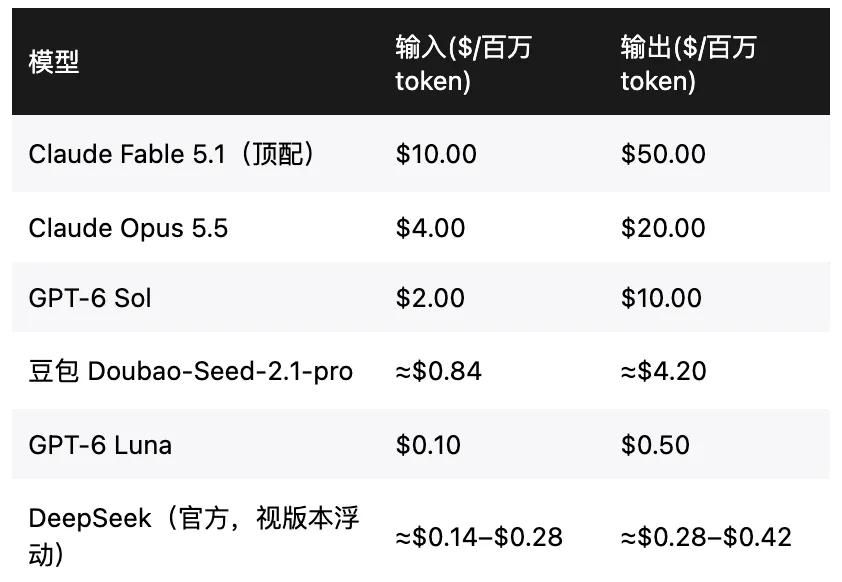
注:中国模型价格换算自人民币官方牌价,汇率按约7.15折算;不同版本、是否命中缓存价格浮动较大,仅供数量级参考。
几个明显的结论:
顶层旗舰模型,中美差距在缩小。豆包的旗舰型号Doubao-Seed-2.1-pro,价格已经落在GPT-6 Sol和Luna之间,跟美国二线主力模型基本是同一个数量级,不再是过去那种"便宜一个数量级"的关系。
走量层级,DeepSeek依然是"地板价"。即便GPT-6 Luna已经把价格砍到极致,DeepSeek在轻量型号上依然能做到更低,这也是为什么DeepSeek一直被称为"性价比之王"——它卷的不是跟旗舰模型拼性能,而是把"够用"的智能做到接近免费。
中国大模型市场本身也在分化。过去半年,国内出现了"一家收费(豆包试水订阅制)、一家降价(DeepSeek)、一群涨价(智谱等有能力提价的厂商开始对标海外顶级定价)"同时发生的局面——说明中国市场内部也不是铁板一块的"越来越便宜",而是不同厂商按自己的用户结构和技术底气,走出了不同的定价策略,这一点跟这次美国两大厂的分层降价逻辑其实是相通的。
写在最后
OpenAI和Anthropic这次几乎同步的降价,标志着大模型竞争进入了一个新阶段:单纯比拼"谁更聪明"的故事讲不动了,"谁能用更少的钱办成同一件事"正在成为新的战场。而把视野拉到全球来看,中美模型厂商其实正在殊途同归——都在往"分层定价、效率优先"这条路上走,只是起点和节奏不同。对普通开发者和内容创作者来说,这是个实打实的好消息:能用的AI越来越便宜,用AI做点什么的门槛也在持续走低。