ARTICLE · 1080398
译文:理解 AI 的 10 个核心概念
原文地址:https://habtesoft.medium.com/the-10-most-important-ai-concepts-explained-in-10-minutes-aea5f2336676
原文作者:habtesoft
编译:渡一教育 闫虹志
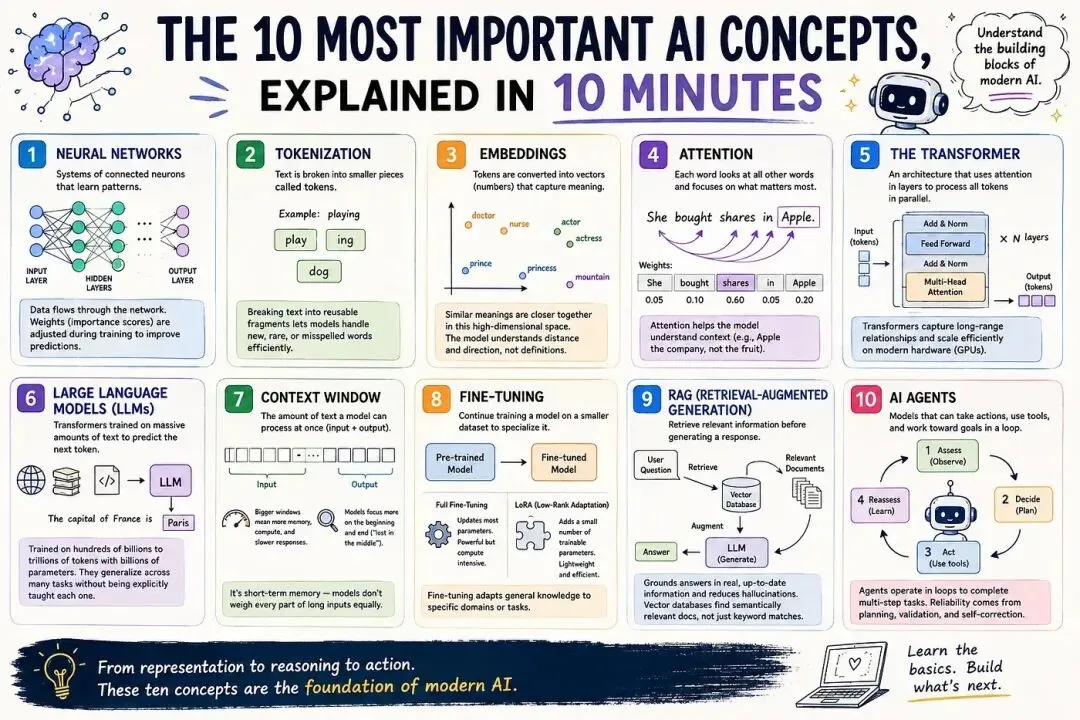
大多数尝试了解 AI 工作原理的人,都会在术语面前打退堂鼓。token、嵌入、注意力、微调、RAG:还没真正弄懂什么,术语就已经堆了一大摞。
好消息是:只要看清这些概念之间的联系,核心思想其实并不复杂。下面的每个概念都建立在前一个概念之上,从神经网络的基本构成单元开始,最后讲到能够自主行动的 AI 系统。按顺序读下去,整个图景就会逐渐清晰。
1. 神经网络
神经网络由多个相互连接的层组成,每一层都包含一些称为神经元的小单元。数据从输入层进入,经过一个或多个隐藏层,最后从另一端输出预测结果。
可以把这个过程想象成逐步提炼。同一份输入在网络中不断经过处理,每一层都会从中提取更多一点的含义。例如,在图像识别模型中,前面的层可能检测边缘和纹理,中间的层识别形状,更深的层则识别完整的物体——从像素到形状,再到含义,逐步深入。
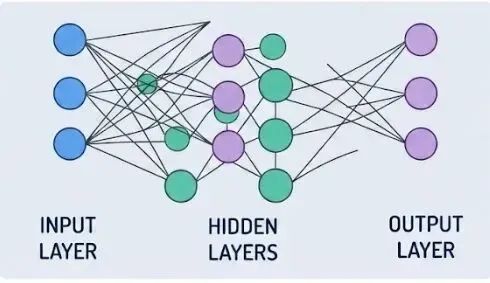
让这一切得以实现的,是附着在神经元之间每条连接上的一组数字,称为权重。权重本质上是一种“重要性评分”,决定一个神经元对下一个神经元的影响有多大。训练网络,就是反复调整这些权重,直到输出变得准确。现代模型的权重并非只有寥寥几个,而是数十亿个;它们被一起调整,将原始输入转化为连贯、有意义的结果。
2. token 化
模型处理文本之前,必须先把文本拆成更小的片段,称为 token。token 就像模型内部使用的字母表,是它实际读取和推理时使用的单位,而不是像人一样直接处理完整的句子。
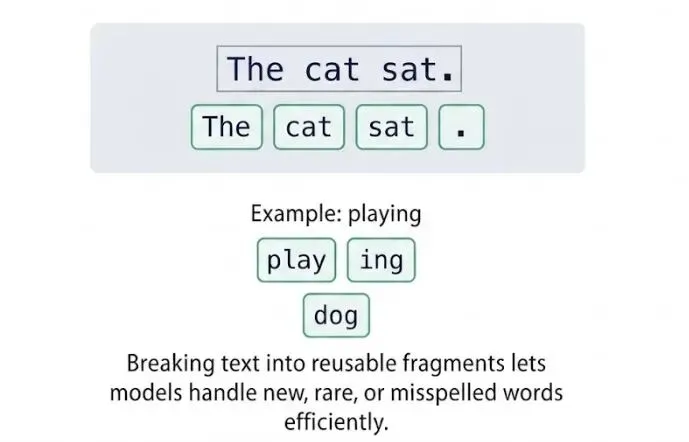
一个 token 并不总是一个完整的单词。像“dog”这样常见的短词通常会保持完整,但像“playing”这样较长或不那么常见的词,可能会被拆成“play”和“ing”等片段。这很重要,因为语言一直在变化——新词、拼写错误、俚语、多种语言混用——如果存储所有可能出现的完整单词,词表就会大到难以管理。把语言拆成一组固定、可重复使用的片段后,模型便能用熟悉的片段拼出从未见过的词,从而处理这些词。
3. 嵌入
文本经过 token 化之后,每个 token 都需要转换成模型真正能够用于计算的形式:一串称为向量的数字。这种数值表示称为嵌入(embedding),它捕捉的是 token 的含义,而不是拼写。
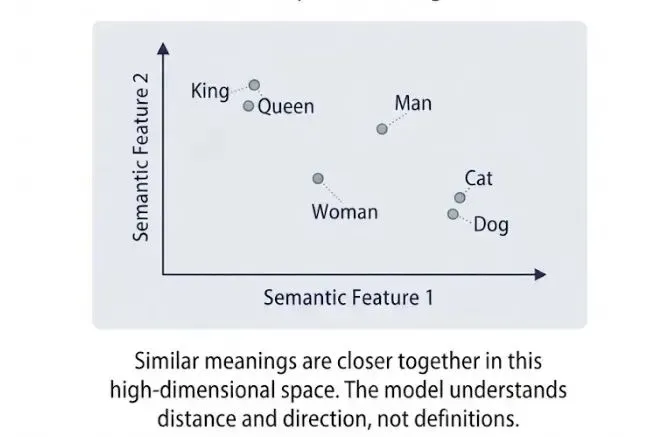
可以把嵌入想象成一张极高维地图上的坐标。含义相近的词会落在彼此附近,毫不相关的词则相距很远。“Doctor”(医生)和“nurse”(护士)彼此相近,而“doctor”(医生)和“mountain”(山)则相距很远。这个空间甚至能用一致的方向来表示关系:“actor”(男演员)与“actress”(女演员)之间的向量差,类似于“prince”(王子)与“princess”(公主)之间的向量差。模型并不是通过定义来理解语言,而是通过这个空间中的距离和方向来理解。
4. 注意力
词的含义取决于上下文。“Apple”可以指水果,也可以指一家公司,仅靠固定的嵌入,无法判断它在某个句子中具体指什么。
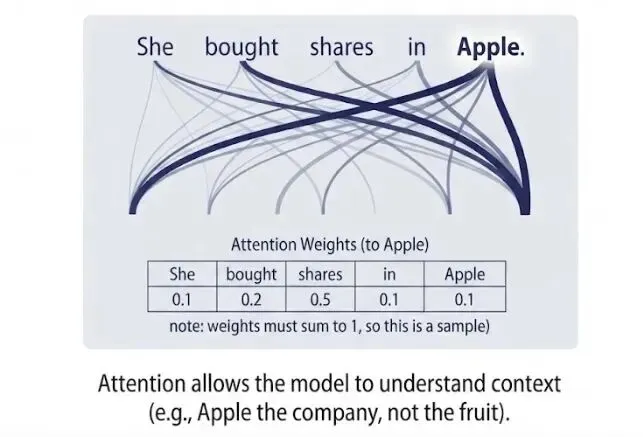
注意力机制解决了这个问题:它让每个词都能查看输入中的其他所有词,并判断哪些词对理解自己最重要。在“She bought shares in Apple”(她买了 Apple 的股票)这句话中,注意力机制让模型在理解“Apple”时,更加重视“shares”和“bought”,从而正确地将其理解为公司,而不是水果。
在注意力机制成为 AI 架构的核心之前,模型按顺序处理文本,一次处理一个词,因此很难捕捉句子中相距较远的词之间的关系。注意力机制让模型能够同时看到整个输入,并动态决定应该关注什么——这一转变被广泛认为是现代 AI 背后的关键突破。
5. Transformer
token、嵌入和注意力机制在一种称为 Transformer 的架构中结合起来。这种架构由 2017 年发表的论文《Attention Is All You Need》提出。它是如今几乎所有主流 AI 模型的基础,从 GPT、Claude 到 Gemini、Llama,都是如此。
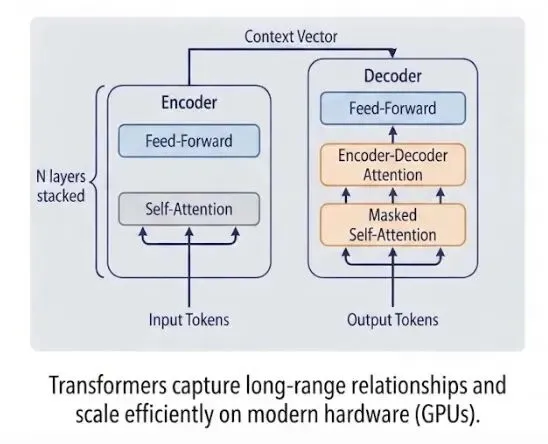
Transformer 将许多注意力层与一些更简单的处理步骤堆叠在一起。信息逐层得到提炼:前面的层识别语法等基本结构,中间的层捕捉词语和想法之间的关系,更深的层则处理更复杂的推理。
与较早的架构相比,Transformer 的关键优势在于,它能并行处理所有 token,而不是一次只处理一个。正是这种并行能力,让这些模型能够利用 GPU 等现代硬件扩展到极大的规模;这也是 2017 年之后 AI 进步迅速加快的重要原因。
6. 大语言模型(LLM)
从本质上说,LLM 就是在海量文本上训练的 Transformer——这些文本包括书籍、网站、代码等,总量往往达到数千亿甚至数万亿个 token。它的训练目标简单得令人意外:预测序列中的下一个 token。
在数万亿个样例上反复执行后,这个简单的目标会产生一种看起来很像理解的能力。模型学会句子如何组织、想法如何衔接,甚至掌握类似推理的模式——而这一切并不需要把语法或逻辑作为独立科目明确教给它。这就是为什么同一个模型可以编写代码、回答问题、解释陌生主题,而无需针对每项任务单独训练。
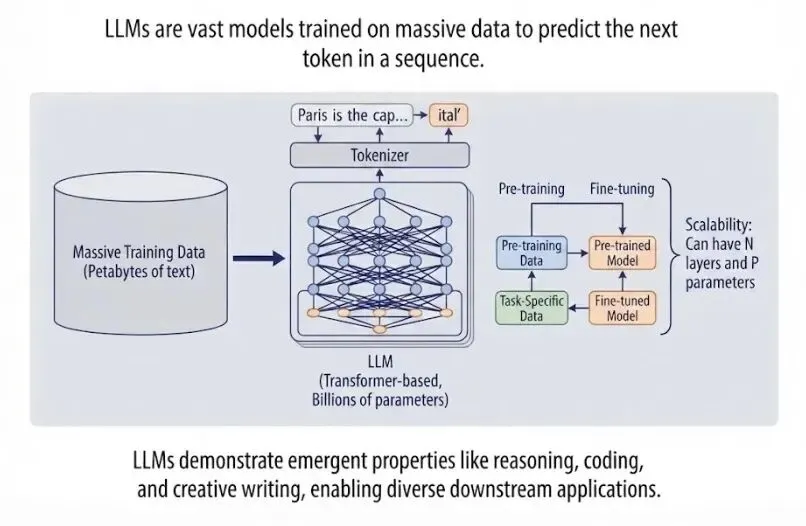
大语言模型中的“大”,指的是参数数量——也就是模型在训练过程中学到的内部数值,往往多达数千亿个。在这种规模下训练需要庞大的算力,成本常常高达数百万美元,但换来的是一个能够泛化到极其广泛问题的系统。
7. 上下文窗口
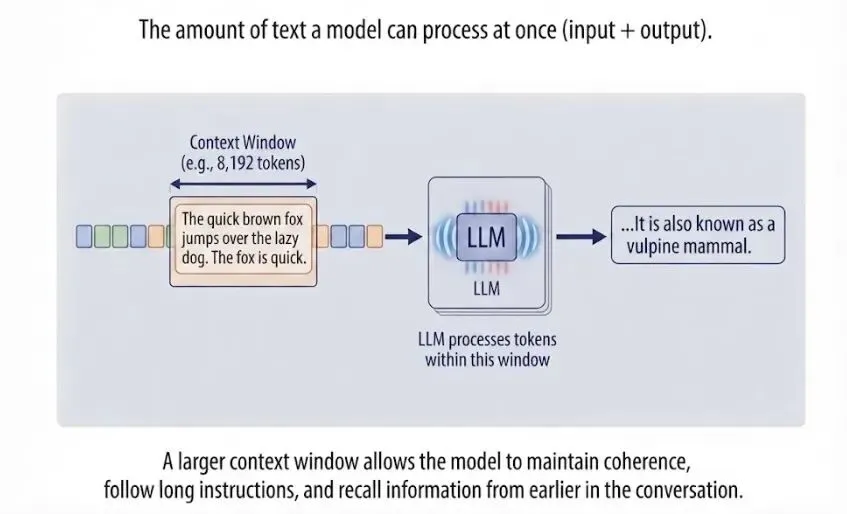
每个模型一次能够处理的文本量都有上限,这个上限称为上下文窗口。它同时涵盖你提供的输入和模型生成的输出,作用类似于短期工作记忆。
早期语言模型的上下文窗口很小,有时只有几千个 token,因此较长的对话或文档必须被裁剪。较新的模型能够处理多得多的内容——一次就能处理整本书、长篇对话或大型代码库。但更大的上下文窗口也有代价:需要更多内存、更多计算,而且响应通常更慢。
还有一个更隐蔽的限制。模型对长输入中各个部分的重视程度并不相同;它们往往更关注开头和结尾,有时会忽略藏在中间的细节——这通常被称为“中间信息丢失”(lost in the middle)问题。这也是为什么即使没有超出模型标明的上下文限制,它仍可能看起来忘记了你明确提过的内容。
8. 微调
微调是在一个已经理解通用语言的模型基础上,使用规模更小、范围更集中的数据集继续训练,让它专门适应某个领域或任务。模型并不是从零开始,而是被引导着向某个特定方向调整——例如,继续用法律合同和判例摘要训练,让它回答法律问题时更加自然。
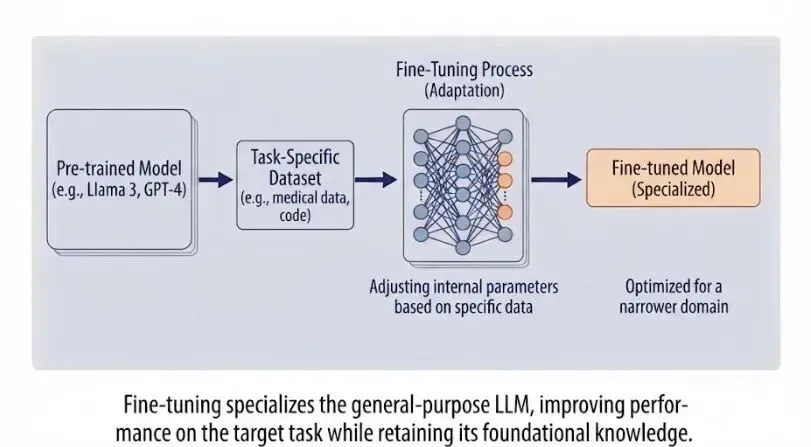
这种专门化并不是没有代价的。微调通常会更新模型中的大部分参数,这意味着需要将完整模型和额外的训练数据一起加载到内存中——对于非常大的模型,往往需要多块高端 GPU。它确实能带来控制能力和定制空间,但也伴随着显著的成本与复杂性。
一种更轻量的替代方案称为 LoRA(Low-Rank Adaptation,低秩适配),它保持原始模型冻结,并在其基础上添加少量可训练组件——其参数量往往只占总参数量的极小一部分。这使得在配置普通得多的硬件上实现专门化成为可能,也是微调模型和定制模型变得如此普遍的部分原因。
9. RAG(检索增强生成)
如果仅靠语言模型自身,它有时会生成语气自信、表达流畅,却完全错误的陈述——这种现象称为幻觉。之所以会出现幻觉,是因为模型的真正目标是生成看起来合理的后续文本,而不是验证事实;只要某个错误陈述符合模式,模型就会像生成正确陈述一样,自信地生成它。
检索增强生成是解决这个问题最实用的方法之一。RAG 不会只依赖模型在训练过程中学到的内容,而是让系统在生成回答之前,先从知识来源中搜索相关文档,再将这些文档作为上下文提供给模型。模型的任务便从“回忆并猜测”转变为“阅读材料并加以解释”。
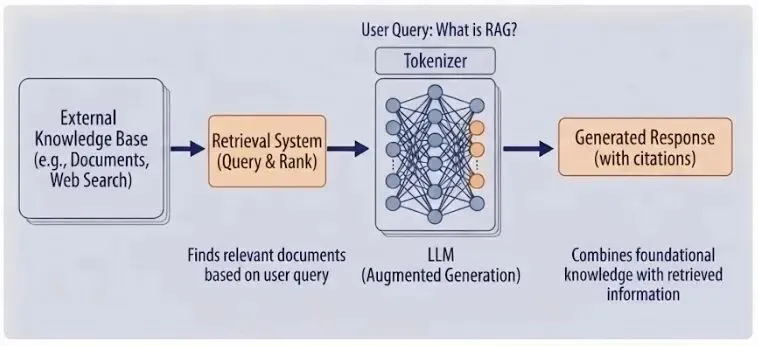
除了准确性,这还带来了一个实际好处:如果底层信息发生变化,无需重新训练模型,系统只需要更新后的文档。高效定位合适文档的工作通常由向量数据库完成。它存储文档片段的嵌入,并检索出与用户查询在语义上最接近的片段,即使两者的措辞并不完全一致。
10. AI 智能体
前面介绍的都是生成文本的模型。AI 智能体则更进一步:它是能够采取行动的语言模型——运行代码、调用 API、搜索信息或使用其他工具——而不是生成一个回答后就停下来。
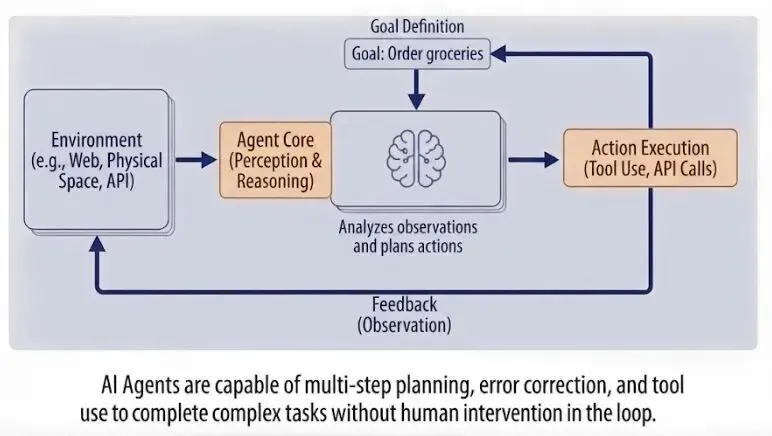
大多数智能体都在循环中运行:评估当前情况,决定下一步行动,执行该行动,然后根据结果重新评估。例如,一个修复 bug 的编程智能体可能会阅读问题描述、检查代码库、编写修复代码、运行测试,再根据失败的测试进行调整——如此反复,直到任务完成。
这种能力也伴随着取舍。多步骤任务中的每一步都有一定的出错风险,而这些小错误可能在较长的行动序列中不断累积。因此,构建可靠智能体的很大一部分工作,在于加入规划、验证和自我纠正机制,让多步骤工作流始终沿着正确方向推进,而不仅仅是赋予它们更多能力。
把这十个概念串起来,就形成了一条相当完整的脉络:模型如何表示语言(token、嵌入),如何理解语言(注意力、Transformer),如何成为可用的系统(LLM、上下文窗口),如何实现专门化并以可靠信息为依据(微调、RAG),以及如何开始采取行动,而不只是给出回答(智能体)。AI 中的其他一切——从用于图像生成的扩散模型,到基于人类反馈的强化学习——都是从这套共同的基础向外发展而来的。
RECOMMEND