ARTICLE · 1081673
【系统使能与高可用系列】Volcano源码深度解析(一):作业调度与队列管理机制
【系统使能与高可用系列】Volcano源码深度解析(一):作业调度与队列管理机制单个 Pod 调度解决的是“这个容器放在哪台机器”。大模型训练与分布式推理面对的却是另一类问题:多个进程需要同时获得足够资源,还要落在满足高速互联关系的一组 NPU 上。Volcano 把 Kubernetes 的逐 Pod 决策提升为 Job、Queue 和资源组决策;mindcluster 进一步把芯片健康状态、互联域、机架和超节点拓扑带入同一轮调度。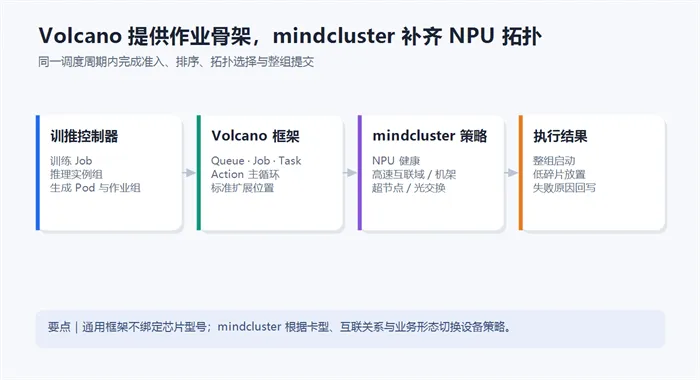
训推任务如何进入 Volcano Volcano 通过作业组把多个 Pod 识别为同一个 Job。作业组记录最小成员数、最小资源、所属 Queue 和优先级等信息,是业务控制器与调度器之间的契约。调度器持续汇总 Pod、作业组、Queue、节点和优先级变化,在每个调度周期形成一致的集群视图。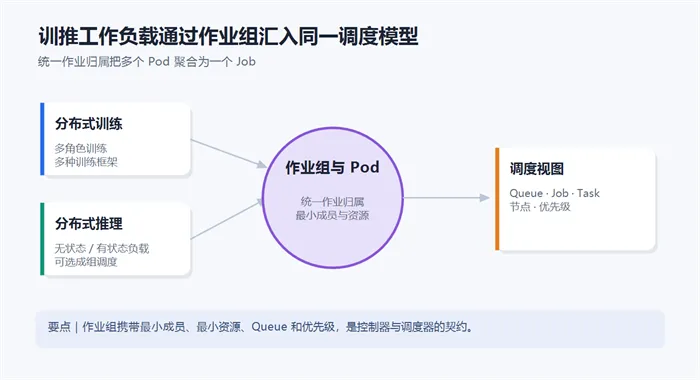
mindcluster 训练控制器会根据训练任务的副本和角色生成作业组。未单独指定时,最小成员数按总副本数计算,最小资源按各角色需求汇总。只有作业组通过入队检查后,控制器才继续创建训练 Pod,避免资源不足时少数进程先占住 NPU、其余进程长期无法启动。 训练 Pod 未指定调度器时,mindcluster 会将其交给 Volcano,并为不同训练角色补充统一的作业归属。这样,不同训练框架的分布式任务既能作为整体调度,又能保留各角色的最低副本要求。 推理侧由 mindcluster 推理控制器提供另一条入口。启用成组调度后,控制器根据无状态或有状态负载的副本数和资源请求创建作业组,再让相关 Pod 归入该组。在线推理无需改变原有工作负载形态,也能复用入队、整组放行和最小资源检查。 一个调度周期如何运行 每轮调度开始时,Volcano 先取得一致的集群快照,再装载排序、过滤、打分和公平策略,随后按配置执行各个动作,最后把决策交给 Kubernetes 落地。官方默认动作是enqueue、allocate、backfill。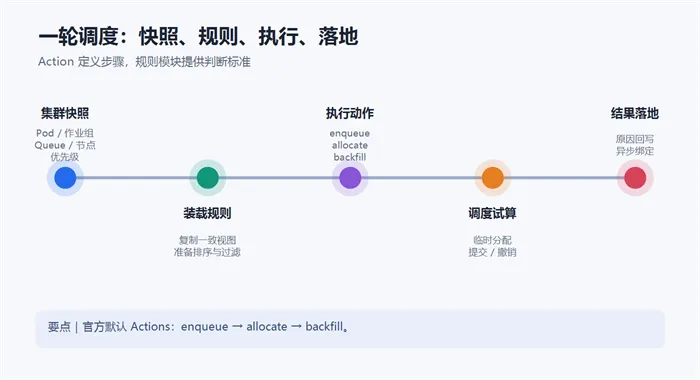
动作决定“这一轮做什么”,规则模块决定“按什么标准做”。例如 allocate 负责依次选择 Queue、Job、Task 和节点;成组调度规则判断资源是否足以让作业整体运行;优先级与公平策略决定先后和额度;mindcluster 的昇腾调度规则则校验 NPU 请求、过滤不符合拓扑的节点并进行成组打分。框架不需要理解每种芯片型号,芯片差异也不必改变主调度流程。 Enqueue:先决定谁有资格竞争 Queue 不只是一个分组名称。它还可以表达资源权重、使用上限、最低保障、队列优先级和资源是否允许被其他队列回收。企业可以据此划分训练、推理或不同租户的资源边界;若使用层级队列,还可以按照组织结构逐层计算公平份额。 enqueue 使用两层优先队列:外层选择 Queue,内层选择该 Queue 中的待调度 Job。每处理一个 Job,所属 Queue 都会重新参与排序,因此调度器不会把某个 Queue 一次性处理到底。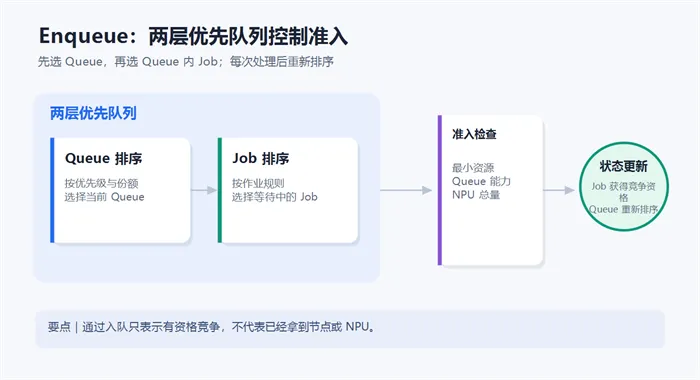
Job 只有在最小资源能够落入 Queue 的实际能力范围、相关准入规则都通过后,才会进入可调度状态。mindcluster 又增加了 NPU 维度的检查:如果全局可管理的 NPU 总量小于 Job 请求,就暂不允许入队;虚拟 NPU 和软共享设备则按实际可用份数折算。这可以减少“逻辑上已经入队、物理设备却永远凑不齐”的假进展。 入队并不等于已经获得节点或 NPU,它只代表 Job 获得了参与资源竞争的资格。排查等待中的任务时,应先确认作业组是否已经通过入队检查,再分析节点选择问题。 Allocate:从 Queue 到 NPU 的五层筛选 allocate 可以概括为五层选择:Queue、Job、Task、节点过滤和节点打分。已经超过应得份额的 Queue 会暂时让出机会;Job 和 Task 按已启用的规则排序;节点过滤负责排除硬约束不满足的位置;节点打分再从可用位置中选择更合适的节点。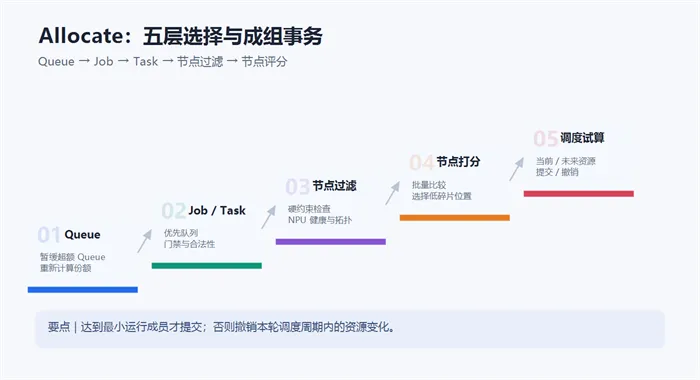
Volcano 不会为一个分布式 Job 找到一个可运行 Task 就立即完成绑定。每次选择先在当前调度周期内试算,持续更新剩余资源和作业状态。只有可运行成员达到作业要求,整组结果才提交;否则撤销本轮试分配。成组调度因此是一段可提交、可回滚的调度事务,而不是简单的资源数量检查。 资源当前空闲时,Task 可以直接进入分配流程;资源预计可通过回收释放时,调度器会先记录未来可用位置。真正的 Pod 绑定随后异步完成,避免主调度流程长时间等待。backfill 则利用剩余空隙放置不要求固定资源的 Task,但它主要提升利用率,不承担队列公平的核心职责。 mindcluster 如何补上 NPU 拓扑语义 Kubernetes 的资源计数能回答节点还剩几张 NPU,却无法回答这些卡是否属于同一高速互联域、同一机架或同一超节点,也无法完整表达网络故障卡是否适合分布式任务。mindcluster 在 Volcano 的标准扩展位置补充了六类能力: 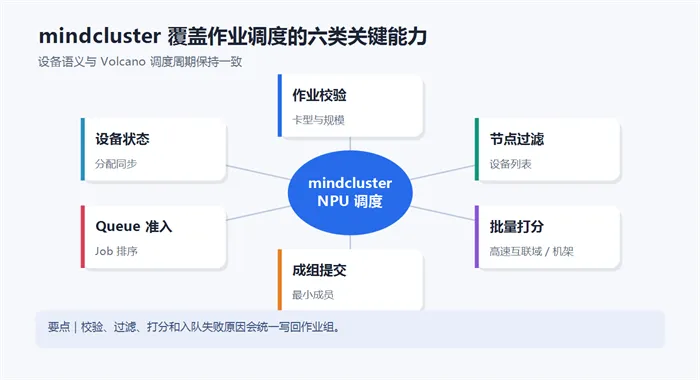
以 8 卡节点为例,普通资源调度可能把 4 卡 Task 放到任意四张空闲卡;mindcluster 会优先选择满足高速互联亲和的一组卡,并通过填充策略减少难以再次利用的碎片。在 A3 和大规模集群中,策略还会结合机架块、超节点大小和光交换拓扑选择节点。调度骨架保持不变,硬件差异由对应的设备策略吸收。 推理场景还需要服务级亲和。属于同一推理服务的实例,会依次优先选择同机架、同超节点和其他超节点;同一范围内再选择完整空闲机架更多、可用节点更多的位置。这是在“能够同时启动”之上,继续减少同一推理服务的通信距离。对于小规格推理实例,软共享策略还能把单张物理芯片划分为多个可调度份额,提高利用率。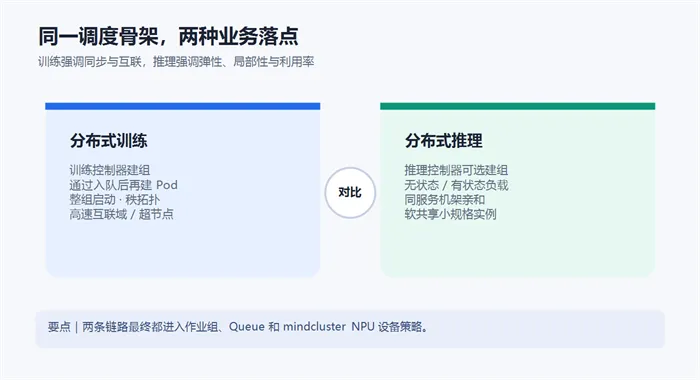
一条可执行的排障路径 第一步检查入口:训练任务是否启用了成组调度,推理任务是否正确生成作业组并指定 Volcano。第二步检查作业组:尚未入队通常指向 Queue、最小资源或 NPU 总量问题;已经入队但未运行,则继续查看参数校验、节点过滤和成组打分的失败原因。第三步核对节点的设备信息与 Kubernetes 资源视图是否一致,尤其关注网络故障设备、机架与超节点标识以及软共享份数。 这条路径对应真实调度阶段:控制器建组 → enqueue 准入 → allocate 过滤与打分 → 成组提交 → 异步绑定。按阶段定位,通常比只搜索 Pod 调度失败事件更接近根因。 结语 Volcano 用作业组建立 Job 边界,用 Queue 管理多租户入口,用一致的调度周期组织各项规则,再通过可回滚试算实现整组提交。mindcluster 复用了这套骨架,把华为 NPU 的卡级健康、互联域、机架和超节点约束嵌入标准调度阶段,让训练的同步启动与推理的弹性编排共享同一套作业调度语义。 Volcano 源码索引
在 Job 进入调度前校验卡型、任务规模和拓扑参数; 在节点过滤阶段检查设备列表、健康状态和单 Task 容量; 在节点打分阶段进行成组选择,兼顾互联亲和与资源碎片; 在成组提交阶段保持 NPU 最小成员语义一致; 在 Queue 准入和 Job 排序阶段考虑 NPU 总量及作业完整性; 在分配和撤销时同步设备级状态,并把失败原因写回作业组。
调度主流程:https://github.com/volcano-sh/volcano/blob/caf21f3d447c8f6d52fc0e48ab6db2b2f3773373/pkg/scheduler/scheduler.go#L95-L153 默认动作配置:https://github.com/volcano-sh/volcano/blob/caf21f3d447c8f6d52fc0e48ab6db2b2f3773373/pkg/scheduler/util.go#L38-L51 Queue 定义:https://github.com/volcano-sh/volcano/blob/caf21f3d447c8f6d52fc0e48ab6db2b2f3773373/staging/src/volcano.sh/apis/pkg/apis/scheduling/v1beta1/types.go#L461-L501 enqueue 动作:https://github.com/volcano-sh/volcano/blob/caf21f3d447c8f6d52fc0e48ab6db2b2f3773373/pkg/scheduler/actions/enqueue/enqueue.go#L44-L104 allocate 动作:https://github.com/volcano-sh/volcano/blob/caf21f3d447c8f6d52fc0e48ab6db2b2f3773373/pkg/scheduler/actions/allocate/allocate.go#L122-L205 分配结果的提交与撤销:https://github.com/volcano-sh/volcano/blob/caf21f3d447c8f6d52fc0e48ab6db2b2f3773373/pkg/scheduler/framework/statement.go#L374-L425