ARTICLE · 1150319
庚商数据前置仓 · 一个让AI“吃好饭”的秘密厨房
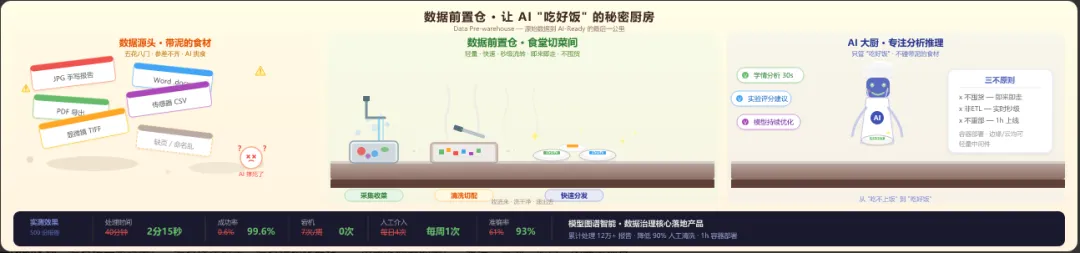
引子:一场被”饿死”的AI发布会去年秋天,某高校智慧教学平台上线了AI学情分析助手,承诺:上传实验报告,30秒生成个性化诊断。校长亲自站台。发布会当天,500份报告塞进AI的”嘴里”——40分钟只吐出3份结果,其余497份石沉大海。
排查真相:AI的”脑子”没问题,但”嘴”被堵死了。原始报告有手写的、扫描歪的、缺页的、命名混乱的。AI花了90%时间”猜”数据是什么意思,根本没精力做分析。
问题不在AI不够聪明,而是忘了——再厉害的大厨,也需要一个先把菜洗好、切好的厨房。这个厨房,就是数据前置仓。
什么是”数据前置仓”?
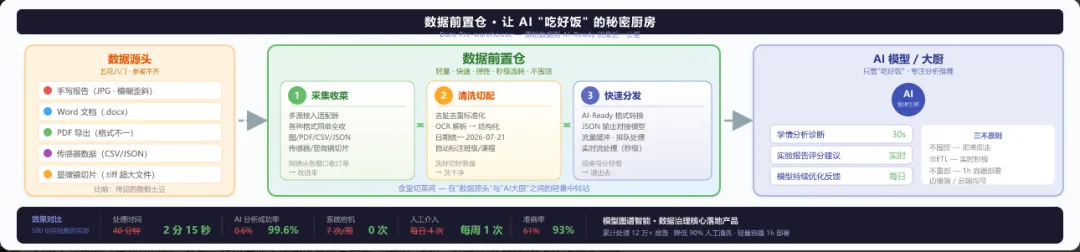
用食堂打比方:3000名学生冲到后厨喊”我要宫保鸡丁”——大厨一边接单一边炒菜,乱成一锅粥。前置仓模式:后厨门口设一个”打菜窗口区”——订单先归类汇总,批量传给后厨。大厨只管专注炒菜。数据前置仓就是数据源头与AI模型之间的轻量化中转站,核心职责三件事:
数据停留时间极短(秒级到分钟级),快速处理、快速流转,不像传统仓库”囤货”。
真实案例:植入前置仓后
原系统的三大堵点:数据格式五花八门、质量参差不齐、峰值冲击宕机。植入前置仓后,500份报告处理流程:
格式统一化 → 质量清洗 → 数据标注 → 流量缓冲 → AI-ready输出 → AI专注分析
效果对比:
| 2分15秒 | ||
| 99.6% | ||
| 0次 | ||
| 每周1次 |
在”模型图谱智能”中的位置
模型图谱智能三大支柱:模型管理、数据治理、知识图谱。数据前置仓是”数据治理”的核心落地产品,解决数据从原始到AI-ready之间的”最后一公里”。
三个典型场景:
- 多源异构→统一训练集
:显微镜切片、扫描件、传感器数据→清洗对齐标注→对接训练管道 - 实时数据流→模型推理
:边缘端轻量预处理(去噪裁剪转换),只发关键帧,保证实时性 - 历史沉淀→持续优化
:每天归集评分数据,清洗后进反馈管道,模型越用越准
澄清三个误解
一句话总结
🏢 给客户:前置仓是食堂切菜间——不让AI碰”带泥的土豆”,让AI专注分析和推理。处理速度提升20倍,稳定性99.9%。 👩💻 给技术同事:它是数据源与AI之间的轻量中间件——收进来(格式无所谓)、洗干净(去脏标准化)、递出去(按模型胃口装盘)。减少90%人工清洗量。 🎯 给销售:客户说”数据太乱AI跑不起来”——讲食堂切菜间故事。降低AI落地门槛。
尾声
植入前置仓三个月后,500份报告2分15秒全部出结果。一个学期累计处理超12万份报告,准确率从61%提升到93%。校长年终总结时说:
“以前我们说’让数据多跑路’,后来发现数据跑得太乱也不行。现在好了,前置仓帮我们把数据梳好头、洗好脸,再体面地见AI——这才是数字化该有的样子。”