ARTICLE · 1205554
【计算相似度工具】AI 是怎么“看懂“文字的?
计算相似度,把 AI 的底层逻辑装进脑子
配套工具:文脉 · 相似度雷达(双击
启动工具.bat即可打开) 学完你会有两个收获:① 真正搞懂 AI 是怎么"看懂"文字的;
路线图

这五个格子,就是所有 AI 语义应用的骨架。ChatGPT 的知识库问答、推荐系统、语义搜索,无非是把中间那步换成更聪明的模型,骨架一模一样。
第 1 课 AI 不认识字,它只认识数字
一句话结论:文字必须先变成数字,计算机才能"算"它。 你输入「我要一份三年经验的新媒体运营」,AI 内部看到的其实是:
[0.02, 0.00, 0.71, 0.13, 0.00, 0.00, 0.42, ...]这串数字叫向量(Vector)。为什么必须这样? 因为计算机只会加减乘除,不会算"像不像"。只有把文字变成坐标,才能比距离、比方向。一个好用的类比——把每个词都放到一张巨大的城市地图上:
「运营」「新媒体」「抖音」挤在同一个街区 「财务」「报税」「总账」挤在另一个街区 一段文字的位置,就是这串数字
💡 直觉检验:如果两段文字在地图上离得近,它们说的就是同一件事。这就是本工具在做的事。
第 2 课 怎么把字变成数字:TF-IDF
一句话结论:数词频,但稀有的词更值钱。
第一步:分词
中文没有空格,机器得先切开。这一步叫分词。
原文:我想做自媒体赚钱分词:我 / 想 / 做 / 自媒体 / 赚钱
工具用的是业界最常用的 jieba。
第二步:去停用词
「的、了、是、我、在」这些词出现最多,却完全没有信息量。必须扔掉。
去掉后:做 / 自媒体 / 赚钱第三步:算权重(这就是 TF-IDF)
最朴素的想法:数出现次数(TF)。 但立刻出问题——「的」出现次数最多,难道它最重要?显然不是。于是有了 IDF(逆文档频率):一个词在越多文章里出现,它越不值钱。
TF-IDF = 词频(TF) × 逆文档频率(IDF)IDF = log(总文档数 / 含该词的文档数)
第四步:编码成向量
把留下来词的权重,按词表顺序排成一条数字,向量就诞生了。
🎯 这一步是本工具的引擎核心,代码在
engine.py的_build_matrix()里,不到 20 行。
第 3 课 怎么判断像不像:余弦相似度
一句话结论:不比长度,比方向。
为什么不能比长度?
一篇 500 字的稿子和一篇 50 字的稿子,哪怕讲的是同一件事,向量长度也差 10 倍。比长度必然误判。
正确做法:算两个向量的夹角
A · Bcos θ = ──────────────────|A| × |B|
分子:对应位置相乘再求和 → 重合越多越大 分母:各自长度 → 做归一化,让长短文公平比较
分数怎么读
🎯 对应代码:
engine.py里的cosine_similarity()。
第 4 课 为什么光看余弦不够:三指标加权
这一课是本工具最值钱的工程经验,也是我们自测时真实踩到的坑。
踩坑现场
拿一段稿子和它的"逐句改写洗稿版"比对:
| 100% | ||
| 69.8 | ||
| 问题来了 |
原因
整篇余弦会被无关段落稀释。就像一杯浓咖啡兑了半杯水,浓度就下来了。短文本、结构松散的文本尤其明显。
解法:三指标加权
综合分 = 0.45 × 整篇余弦 ← 整体方向像不像+ 0.25 × 关键词重合率 ← 是不是在讲同一件事+ 0.30 × 单句最高相似 ← 有没有成段照搬(查重最关键)
调整后同一组数据变成 74.9 分 → 高度相似 ✅ 判断正确。
三个原始分全部显示在界面上
这不是锦上添花,而是商业必需:
客户看到"单句 100%",立刻明白问题出在哪一句 你不需要让客户"相信 AI",只需要让客户"看懂数字"
🎯 对应代码:
engine.py顶部的W_COSINE / W_KEYWORD / W_SENTENCE三个系数。改这三个数,就能调工具的敏感度。
第 5 课 从这一个小点,看懂整个 AI 大世界
一句话结论:你学的不是一个小技巧,而是一块通用积木。
一个必须记住的关键差别(面试常考)
| 不懂 | ||
| 每个分数都能追溯 | ||
| 完全离线 | ||
动手练习(做一遍胜过看十遍)
- 体会基础分
:打开「① 双文比对」,点「开始比对」,记下分数。 - 体会稀释效应
:把 A 框里第三段删掉,再比对一次。分数怎么变?为什么? - 体会关键词威力
:去「② 批量排行」,点「载入示例」,记下运营简历的分数;然后把基准里的「剪映」删掉再排行,分数掉了多少? - 体会单句定位
:看右下角的句子对照表,找那句 100% 的——它是不是只改了两个词? 做完这四步,你就真正理解了这个工具,也就理解了 AI 语义计算的底层。
附:工具能做的三件事
本手册与「文脉 · 相似度雷达」配套使用。全部计算在本机完成,原文不会上传任何服务器。
文脉 · 相似度雷达 v1.0
一个完全离线、不上传原文的中文文本相似度工具。 两个核心用途:发文前查重、简历对岗位 JD 打分。
一、怎么启动
方式一(推荐):双击启动
双击文件夹里的 启动工具.bat,等两三秒窗就出来了。
方式二:命令行
cd 本文件夹所在路径python app.py
如果报缺少依赖
打开命令行执行一次即可:
pip install customtkinter scikit-learn jieba python-docx本机环境已具备以上全部依赖,正常情况下无需安装。
二、四个页面怎么用
① 双文比对 —— 最常用
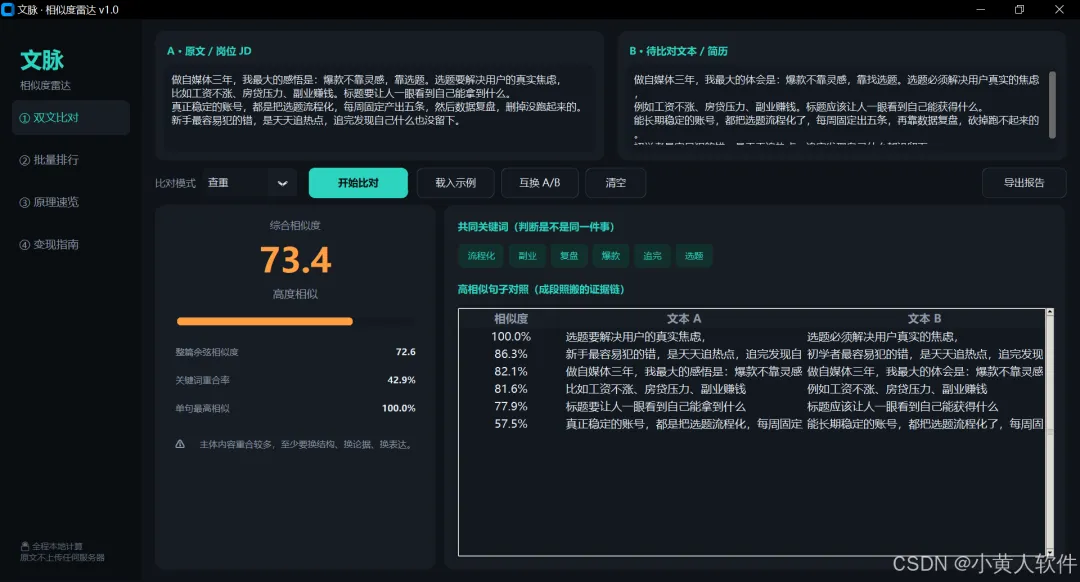
左边框贴「原文」(或岗位 JD),右边框贴「待测文本」(或简历) 选比对模式:查重 / 简历JD / 通用 点「开始比对」 看三个地方: - 左边大数字
:综合相似度(0~100) - 左边三行小指标
:整篇余弦 / 关键词重合 / 单句最高 - 右边表格
:哪几句高度雷同,逐句对照 点「导出报告」,得到一份可直接发给客户或领导的 Markdown 报告分数怎么读(查重模式): | 分数 | 判定 | 建议 | |—|—|—| | ≥ 85 | 极高相似 | 有被判搬运的风险,重写 | | 70~85 | 高度相似 | 换结构、换论据、换表达 | | 50~70 | 中度相似 | 同题不同稿,把自家案例写足 | | < 50 | 差异明显 | 可放心发布 |
注意:单句最高相似 ≥ 90% 时,即使总分不高也要警惕——那说明有整句照搬。
② 批量排行 —— 效率神器
左边贴基准文本(如岗位 JD) 右边攒候选:点「添加候选」手输,或「导入文件」批量导入(支持 txt / md / docx,可多选) 点「开始排行」,自动按匹配度排序,第一名高亮 点「导出排行榜」得到表格典型用法:把一份 JD 放左边,50 份简历导入右边 → 30 秒排出优先级。
③ 原理速览
工具内复习五节课内容,不用翻手册。
④ 变现指南
四条已梳理好的赚钱路子 + 定价话术 + 启动节奏。这一页建议认真看一遍。
三、分数背后的算法(一句话版)
文字 → 分词去停用词 → TF-IDF 加权 → 向量 → 算夹角余弦 → 三指标加权汇总 详细讲解见同目录的 学习手册_五节课学AI.md,五节课从零讲到能看懂 ChatGPT 的原理。 三个原始指标我们全部保留显示,不做黑箱判断——这是本工具和在线 AI 工具最大的区别之一。
四、常见问题
Q:我的文稿会被上传吗? 不会。全程本机计算,没有一行联网代码。断网也能用。Q:能处理多长的文本? 单篇几千字没问题。批量排行建议单批不超过 200 个候选。Q:为什么同义词它认不出来? 这是 TF-IDF 的固有局限(它只看字面词)。需要懂语义时,业界做法是换成 Embedding 模型,但对 90% 的查重场景来说,TF-IDF 更快、更便宜、更可解释。Q:分数和别的平台不一样,以哪个为准? 不同算法的分数本来就不能直接比。在同一套算法下比较才有意义——比如同一份 JD 筛多份简历,排序是可靠的。Q:窗口显示不全 / 太大? 程序已自动适配屏幕缩放。若仍有问题,手动拖动窗口边缘调整即可。
五、文件清单
启动工具.bat | |
app.py | |
engine.py | 算法引擎 |
page_compare.py | |
page_batch.py | |
page_info.py | |
ui_kit.py | |
examples.py | |
selftest.py | |
smoke_test.py | |
学习手册_五节课学AI.md | |
使用说明.md | |
样例报告_洗稿检测.md |
想改算法敏感度?打开
engine.py,改顶部三个系数W_COSINE / W_KEYWORD / W_SENTENCE即可。
六、二次开发提示
engine.py 是纯算法模块,不含任何界面代码,可以直接:
from engine import similarity, batch_rankres = similarity("文本A", "文本B")print(res.score, res.level) # 73.4 高度相似print(res.cosine, res.kw_overlap, res.sent_max) # 三个原始分print(res.as_dict()) # 转成字典,方便存库/传接口
所以它既能做桌面工具,也能挂到 Flask/FastAPI 后端做成网页版或小程序后端。