ARTICLE · 1239103
大模型怎么使用工具|AI-FDE转型之路·AI工程06-Tool-Calling原理
这篇主要是讲大模型使用工具的原理,通过这篇文档就很清楚了解大模型与工具之间的关系,更好的对大模型进行祛魅,内容比较多,建议先收藏,电脑查看。
一、先把一句话说清楚:模型不会直接调用工具
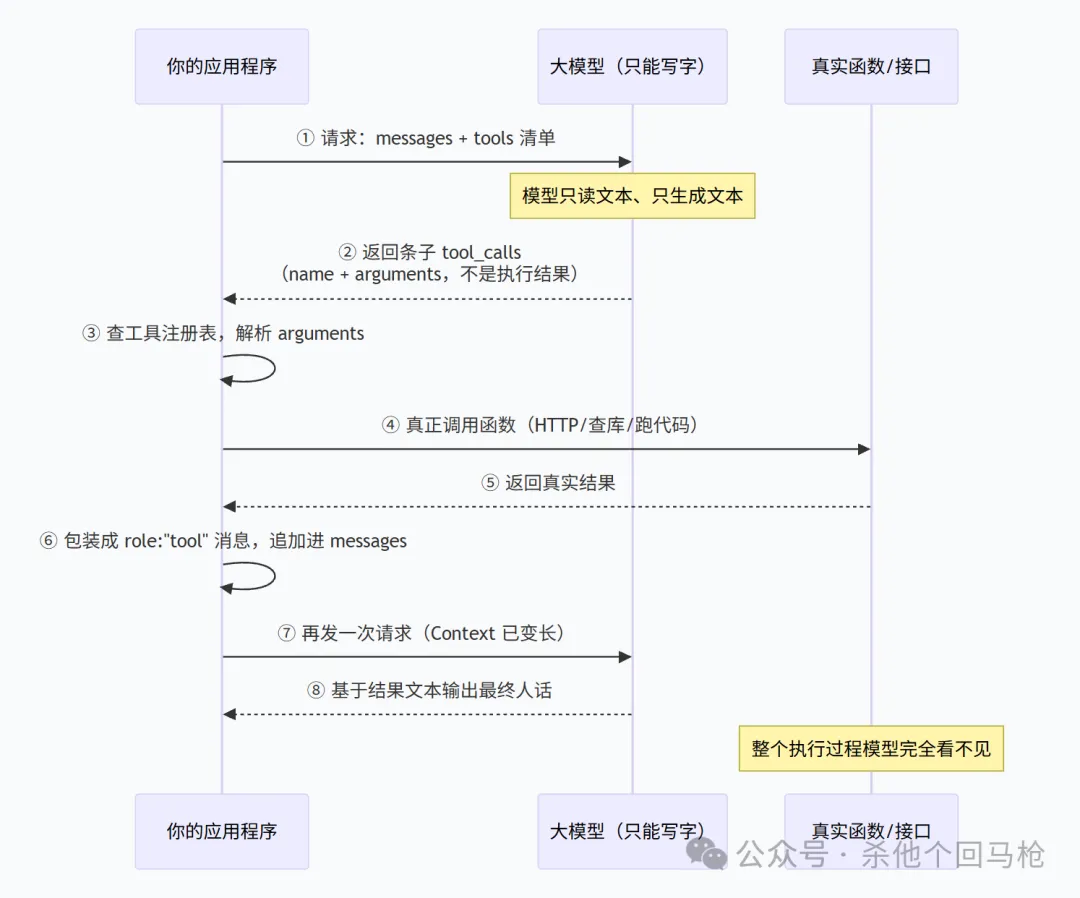
我的判断是:模型从头到尾没有调用过任何工具。它输出的只是一段文本——一段"我打算调用某个工具、参数是这些"的文本。真正去执行接口、查数据库、跑代码的,是你的程序。
这句话听起来像抬杠,但它决定了后面所有的做法。你以为在"教模型做事",其实你是在给一个只能写字、不能动手的人(大模型)配跑腿(工具)。
打个比方。模型是个坐得住的人:给他纸笔,他能写、能分析、能给你一份看上去很专业的报告。但房间没有门、没有网、没有电话,他出不去。他唯一能对外表达的方式,是在纸上写一张条子递出来:"请帮我查一下 ZX-07 的生效日期。"
这张条子,就是我们说的"工具调用"。模型写条子的能力,跑腿的活儿是你的程序干的。条子是用来描述工具。
一条工具调用,本质是"模型写条子 → 你的人去跑腿 → 跑腿结果贴回纸条 → 模型再读一遍纸条",模型从头到尾没有碰过你的系统,只是对文本进行了处理。
二、模型每一轮看到的东西,叫 Context
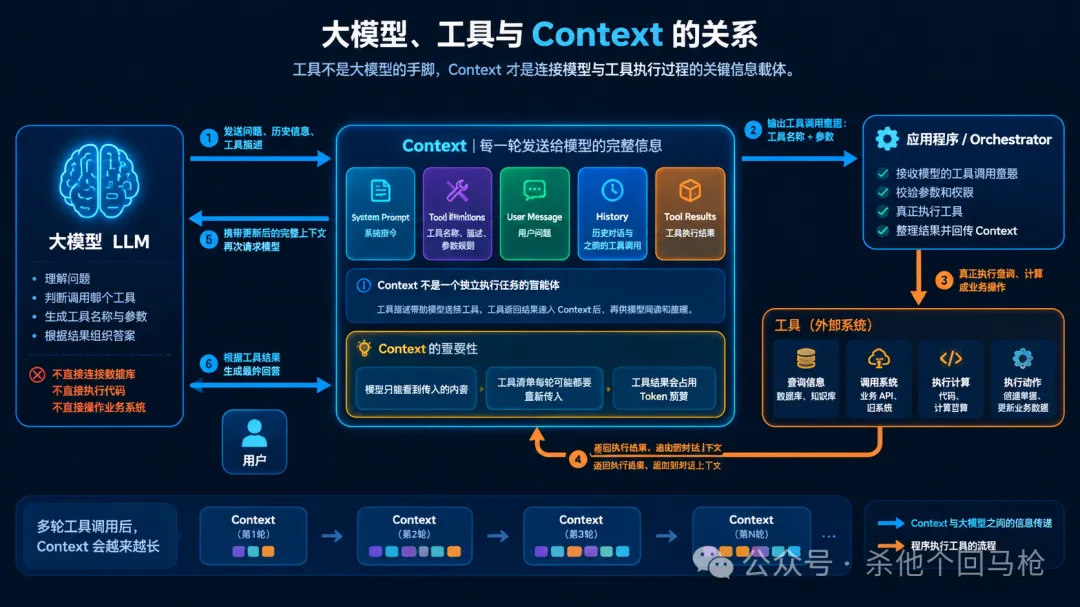
大模型、工具与Context的关系是什么样子的呢,第 03 讲讲过一句话,我把它放在这里当地基:上下文。模型每次收到的不是"我们聊了多久",而是眼前这一整段拼起来的文字——系统提示词、检索到的材料、历史对话、工具返回的结果,一次性交给它,它来处理文本。
现在把工具放进这个画面里,你会看到一件之前被忽略的事:工具调用不是发生在 Context 之外,它就长在 Context 上。
具体说三件事。
第一,工具清单本身就在请求里,而且每一轮都要重发。
你在第 03 讲的预算表里分了五段:系统提示词、检索材料、历史会话、工具返回、输出预留。工具清单不在表里,但它的开销跟"系统提示词"是同一类——常驻、每次都带。挂五个工具,就是五段描述每次请求都过一遍。
第二,工具的返回值会占掉"工具返回"那一格,而且是实打实挤占其他内容的空间。
第 03 讲那张表里,"工具返回"给的预算是 10%–20%,超了先砍它。这句话现在有了具体含义:工具返回值和检索材料抢的是同一份预算。一次调用返回三百个字段,模型只需要五个——那就砍。另外,工具调用次数越多,回填进 Context 的东西越多,第 03 讲讲的"上下文像滚雪球"就滚得越快。
第三,也是最关键的一条:Context 是模型唯一的记忆,所以工具返回必须自己会说话。
第 03 讲讲过大模型的记忆——它没有自动延续的聊天记忆,每一轮都是把之前的内容重新拼上去发过去。工具结果也一样:它进了 Context 就只是一段文字,模型下次读到这段文字的时候,它不知道这段文字是真数据、是错误信息、还是你自己写的兜底文案。
所以"工具返回空"这件事之所以危险,根源在这里:空字符串和 null 进到 Context 里,在模型眼里就是"查过了,没有结果",不是"查失败了"。模型顺着往下编,是在忠实地使用它的上下文。Context 里没有的东西,模型永远不知道。
三、一轮工具调用的完整五步
把上面那句话拆开,就是五步。拿"查制度生效日期"这个工具走一遍。
第一步:你把工具清单放进请求里。
不是把接口地址放进去,是把一段给模型看的文字放进去:工具叫什么名字、能干什么、什么时候该用、参数叫什么、参数长什么样、返回什么。主流平台都把这块放在请求体的一个独立字段里(OpenAI 叫 tools,Anthropic 也叫 tools),工具的参数形状用 JSON Schema 描述。
模型看到的就是这些文字。它看不到你的接口文档、你的数据库表结构、你 Java 代码里的方法实现。
第二步:模型输出调用意图。
模型判断"这题需要查生效日期",于是输出的不是自然语言回答,而是一段结构化数据,意思是"我要调查询制度生效日期,参数 doc_id 等于 ZX-07"。
各家字段名不一样,但结构是一样的。OpenAI 的 Chat Completions 里长这样(示意):
tool_calls: [{id: "call_abc123",type: "function",function: {name: "查询制度生效日期",arguments: "{\"doc_id\": \"ZX-07\"}"}}]
Anthropic 的写法不同,但你可以看成同一件事的两种方言:
content: [{type: "tool_use",id: "call_abc123",name: "查询制度生效日期",input: { "doc_id": "ZX-07" }}]
差异记两条就够用:OpenAI 的arguments是"装着 JSON 的字符串",Anthropic 的input直接就是对象。其他都是包装差异。一般采用OpenAI的格式。
第三步:你的程序执行它。
程序拿到 name,去自己维护的那张"工具注册表"里找到这个工具对应的实现,发 HTTP 请求、查库、跑代码。这一步全部发生在你的环境里,模型一点都看不见。
第四步:结果塞回上下文。
程序把工具的真实返回结果(或者一段错误信息)作为一条新消息,追加进对话,再发一次请求给模型。
这一步有个细节值得记住:是"追加",不是"替换"。对话还是原来那一整条,只是后面多接了一段——这就是第 03 讲说的"滚雪球",滚一次长一截。
各家的包装方式:OpenAI 用一条 role: "tool" 的消息,靠 tool_call_id 跟第二步那次调用对上号;Anthropic 用 type: "tool_result" 的内容块,放在紧跟着 assistant 那轮之后的那条 user 消息里,里面用 tool_use_id 对应上一步的 id。
第五步:模型基于结果回答。
这次它能看答案了,因为答案已经变成文本躺在上下文里。前面那五步里,只有这一步是"模型自己输出给人看的话"。
所以你会发现一个反直觉的事实:工具调用不是"一次"模型交互,是"多一次"。模型至少被调用了两次——第一次出条子,第二次看结果写答案。如果一次对话里连着查三次,那就是四次模型交互。这直接对应第 03 讲那笔账:每多一轮,整段上下文就要重传一遍。
四、把五步摊开:一次完整的交互报文
这一节是本篇最该看的部分。前面讲的是道理,这里看真东西。
先说清这份报文怎么读
报文的标题是"第 N 轮",一轮 = 模型被调用一次。每一轮都是一问一答,方向是固定的两个:
第 N 轮: 你的程序 ──── 提问(带 Context + 工具清单)────▶ 模型你的程序 ◀─── 回答(要么是调用意图,要么是给人看的话)── 模型
所以"你的程序 → 模型"和"模型 → 你的程序"是同一轮里的两半,不是一个来回的两个轮次。第 1 轮你发请求,模型回条子;第 2 轮你发条子加结果,模型回条子;直到某一轮模型不再回条子,而是回一段人话——那一轮就是终局。
整条链路一共 4 轮:前三轮在跑工具,第 4 轮模型才真正处理。
读报文前先说清两条约定(后面所有报文都这么处理):
(同前,未变) | |
"... 四个工具原样重发一遍,此处为省篇幅省略 ..." |
我要强调的是:省略的只是贴在这里的篇幅,不是真实请求里的内容。你的程序每一轮发出去的,都是完整的。
四轮全景对照表(这张表建议先扫一眼,后面报文里就不容易乱):
注意一件事:"轮次"数的是模型被调用了几次,不是你写了几个工具。这里调了 4 个工具,但模型只被调用了 4 次,因为第 1 轮它一口气要了两个工具。
再看 messages 那一列:2 → 5 → 7 → 9。每调一个工具,Context 就长两条(模型的条子 + 工具结果),而且前面的一条都不删,每轮整个重发。第 03 讲讲的滚雪球,在这张表上就是这几个数字。
再看一个细节:每一轮你发给模型的,都是一份完整的 JSON 请求,里面装着到目前为止的全部对话(Context)。模型每轮回的东西,都是这一轮新增的那一段,不是全部。所以你看到的响应报文比请求报文短得多——模型只回增量,完整的历史由你的程序替你保管着,每次原样重发。
这一条是本节所有困惑的解药:模型不知道前面发生了什么,它只知道你这次发来的那段文字。
场景:恒信银行的内部办事助手,用户问了一句"我上周那笔差旅报销,超没超行里的差旅标准?超了就帮我提个补充单,把单号给我"。
这一句话里藏着四种活儿,所以我们在请求里挂了四个工具——正好是第 06 讲第二节讲的那四类(取信息、接老系统、做计算、干动作):
queryExpense | ||
queryTravelPolicy | ||
calcAmountOver | ||
createExpenseSupplement |
【第 1 轮 · 上半】你的程序 → 模型
(上面那张图里的"提问"这一半。下面这个 JSON 就是你发给模型的全部内容。)
{"model": "DeepSeek-V4-Flash","messages": [{"role": "system","content": "你是恒信银行的内部办事助手。涉及金额一律以系统数据为准,不允许自行推算;提单类操作必须先核对标准再执行。"},{"role": "user","content": "我上周那笔差旅报销,超没超行里的差旅标准?超了就帮我提个补充单,把单号给我。"}],"tools": [{"type": "function","function": {"name": "queryExpense","description": "查询当前用户最近一笔已提交的报销单。当用户问『我那笔报销多少钱』『报销单号是多少』时调用。只查最近一笔;查历史多笔或他人报销时不要用这个工具。","parameters": {"type": "object","properties": {"user_id": {"type": "string","description": "工号,形如 E10238,从登录态取,不要让用户口述"},"status": {"type": "string","enum": ["submitted", "approved", "paid"],"description": "按状态过滤,默认取 submitted"}},"required": ["user_id"]}}},{"type": "function","function": {"name": "queryTravelPolicy","description": "查询行内现行差旅费用标准,返回职级对应的住宿限额与伙食限额。当需要判断某笔费用是否超标时调用。不返回具体金额计算结果,只返回标准本身。","parameters": {"type": "object","properties": {"job_level": {"type": "string","description": "职级代码,形如 P6、P7"},"city_tier": {"type": "string","enum": ["1", "2", "3", "other"],"description": "出差城市层级,1 为一线,other 为其他"}},"required": ["job_level", "city_tier"]}}},{"type": "function","function": {"name": "calcAmountOver","description": "计算实际金额超出标准的金额与比例。只做算术,不查任何系统。传入金额时单位一律为元,不要传万元或角。","parameters": {"type": "object","properties": {"actual_amount": {"type": "number","description": "实际发生金额,单位元"},"limit_amount": {"type": "number","description": "标准限额,单位元"}},"required": ["actual_amount", "limit_amount"]}}},{"type": "function","function": {"name": "createExpenseSupplement","description": "提交一张报销补充单。仅在已确认费用确实超标、且已拿到超标金额后调用。提交后必须把单号回给用户。","parameters": {"type": "object","properties": {"expense_id": {"type": "string","description": "原报销单号,来自 queryExpense 的返回"},"over_amount": {"type": "number","description": "超标金额,单位元,来自 calcAmountOver 的返回"},"reason": {"type": "string","description": "超标原因简述,不超过 50 字"}},"required": ["expense_id", "over_amount", "reason"]}}}],"tool_choice": "auto","parallel_tool_calls": true}
先停一下,看这一段报文教了什么:
模型收到的全部东西就是这个 JSON。它不知道你的报销系统长什么样,不知道"职级 P6"对应哪个表、不知道 job_level该从哪来——它只知道job_level是个字符串、枚举里有哪些值、以及你告诉它"形如 P6、P7"。description里的两句话不是装饰:"当用户问…时调用"是给模型判断要不要调用的依据,"查历史多笔或他人报销时不要用这个工具"是边界。 这两条就是第 06 篇讲的四个问题里的第一和第二个。enum是在告诉模型"别自己编"。description里写"单位一律为元,不要传万元"是在堵一个具体的坑。四个工具里,前两个是"问",第三个是"算",第四个是"改"。模型看不见这个分类,它只会读文字。
【第 1 轮 · 下半】模型 → 你的程序
("回答"这一半。这是模型这一轮返回的完整报文,一个字段没省——很多教程只贴 message 那块,看不到外面还有别的东西:)
{"id": "chatcmpl-B1a2b3c4","object": "chat.completion","created": 1785277080,"model": "DeepSeek-V4-Flash","choices": [{"index": 0,"message": {"role": "assistant","content": null,"tool_calls": [{"id": "call_q1","type": "function","function": {"name": "queryExpense","arguments": "{\"user_id\": \"E10238\", \"status\": \"submitted\"}"}},{"id": "call_q2","type": "function","function": {"name": "queryTravelPolicy","arguments": "{\"job_level\": \"P6\", \"city_tier\": \"2\"}"}}]},"finish_reason": "tool_calls","logprobs": null}],"usage": {"prompt_tokens": 1247,"completion_tokens": 58,"total_tokens": 1305}}
先回答一个自然的疑问:模型就返回这么一小段?
是的,而且这不是省略,这是它这一轮的全部。模型没有"想说的话"藏在别处——它的输出只有 choices[0].message 这一块,其余全是这次调用的元信息:
message.tool_calls | ||
message.content | null——它没打算说话 | |
finish_reason | tool_calls(要调工具)/ stop(说完了) | |
usage | ||
idcreated、model、object |
两个容易被忽略的细节:
一、content是null,但它不一定永远是null。上面那段"只返回一小段"是绝大多数情况——模型决定调工具时就不说话。但模型也可以在同一条消息里既说话又调工具(content 有文字,tool_calls 同时存在)。如果你写的客户端逻辑是"看到 tool_calls 就忽略 content",用户会丢看到本来该看到的那句话。这是真实存在的坑。
二、finish_reason: "tool_calls"才是真正的信号。判断"这一轮要不要去执行工具",正确的做法是看这个字段,而不是看 tool_calls 数组在不在。当然,实际上 tool_calls 有内容时 finish_reason 必然是 tool_calls,两者一致——但**"模型这一轮打算调工具"这件事本身,是靠这个字段告诉你的**,你的程序整个循环的开关就搭在这上面。
再看两个参数:user_id 它从系统提示词里说的"从登录态取"(虽然这里并没有真的取到,但格式对了),job_level 它填了 P6、city_tier 填了 2。这两个值模型是编的——它不知道这个用户是什么职级、去的是几线城市。它在模仿它见过的形状。第 06 篇说的"模型自己猜了一个不存在的文档编号",就是这一步发生的。
所以真实项目里,这两个参数该由你的程序在执行前覆盖掉,或者用 tool_choice 直接指定某一个工具、参数由代码填。参数是模型填的,不是传过去的。
还有一句必须记下来的规矩:tool_calls里的每一个 id,都必须有一条对应的结果回回去。少回一条,请求会被直接拒绝(报 400,提示某个带 tool_calls 的 assistant 消息必须为每次调用提供响应)。工具执行失败不是不回的借口——把错误信息当作结果内容回传就行。
【第 2 轮 · 上半】你的程序 → 模型
(你把第 1 轮模型的条子和两个工具结果,一起塞进 Context,发第 2 次请求。你的程序在这中间做了三件事:调了报销系统、调了标准查询接口、把两个结果拼成文本塞回去。注意messages数组变成 5 条了。)
{"model": "DeepSeek-V4-Flash","messages": [{ "role": "system", "content": "你是恒信银行的内部办事助手。涉及金额一律以系统数据为准,不允许自行推算;提单类操作必须先核对标准再执行。" },{ "role": "user", "content": "我上周那笔差旅报销,超没超行里的差旅标准?超了就帮我提个补充单,把单号给我。" },{ "role": "assistant", "content": null, "tool_calls": [{ "id": "call_q1", "type": "function", "function": { "name": "queryExpense", "arguments": "{\"user_id\": \"E10238\", \"status\": \"submitted\"}" } },{ "id": "call_q2", "type": "function", "function": { "name": "queryTravelPolicy", "arguments": "{\"job_level\": \"P6\", \"city_tier\": \"2\"}" } }] },{ "role": "tool", "tool_call_id": "call_q1", "content": "{\"expense_id\": \"BX-20261015-0932\", \"amount\": 3860.00, \"status\": \"submitted\", \"submit_date\": \"2026-10-15\"}" },{ "role": "tool", "tool_call_id": "call_q2", "content": "{\"job_level\": \"P6\", \"city_tier\": \"2\", \"hotel_limit\": 3200.00, \"meal_limit\": 600.00, \"total_limit\": 3800.00}" }],"tools": [ "... 四个工具原样重发一遍,此处为省篇幅省略 ..." ],"tool_choice": "auto"}
(这一轮请求里 tools 的内容跟第 1 轮一个字都没变,整段重复发过来——这是原文,图中省略。工具清单不随对话变化,每轮都原样重发。)
这一轮报文里有三处值得停下来看:
一、工具清单又出现了。"tools": [ "...原样重发一遍..." ]。这就是第二节说的"常驻、每次都带"。四个工具的描述,这一轮又付了一遍钱。第 03 讲那张预算表里,工具描述的开销记在"系统提示词"那一格底下。
二、Context 变长了。对话从"系统提示词 + 用户一句话",变成了"系统提示词 + 用户一句话 + 模型的条子 + 两条工具结果"。第 03 讲说的滚雪球,此刻正在滚。
三、工具结果是"你的程序写的文本"。你看 queryExpense 返回的那一串——amount: 3860.00 和 total_limit: 3800.00 现在同时躺在上下文里,超不超标已经是个明摆着的问题。但模型还是不会自己算。因为 3860 和 3800 谁大,它的心算不可靠——第 06 篇讲的"做计算"那一类工具,就是为这一刻准备的。
顺便提醒一句:如果你程序里写的是"查询失败,请稍后重试",模型读到的是一模一样的字符串,它不知道这是失败,它会当成一个查回来的结果继续推理。兜底文案是给系统看的,也是给模型看的,别兜成看起来像真数据的东西。
【第 2 轮 · 下半】模型 → 你的程序
(模型看到两个结果之后,回的新条子。这一轮它只调一个工具。)
{"role": "assistant","content": null,"tool_calls": [{"id": "call_q3","type": "function","function": {"name": "calcAmountOver","arguments": "{\"actual_amount\": 3860.00, \"limit_amount\": 3800.00}"}}]}
模型把两个数原样搬进了计算工具。它没有自己心算,这是对的。而且注意它搬得准——因为这两个数就明明白白写在上一轮的 Context 里,它只需要复制。
那"超出 60 元、占 1.58%"这个结论,是 calcAmountOver 这个工具在你的服务器上算出来的,不是模型算的。模型只是把结果搬进了下一个工具的参数里。
这就是"做计算"这一类工具的全部价值:把心算换成代码。差旅费差一天、超标 60 块这种题,模型自己算对了是运气,算错了你根本看不出来。
【第 3 轮 · 上半】你的程序 → 模型
(你把计算结果回填进 Context,发第 3 次请求。注意看messages数组——它是从第 1 轮原样长过来的,前面一条都没删。)
{"model": "DeepSeek-V4-Flash","messages": [{ "role": "system", "content": "(同前,未变)" },{ "role": "user", "content": "(同前,未变)" },{ "role": "assistant", "content": null, "tool_calls": [{ "id": "call_q1", "type": "function", "function": { "name": "queryExpense", "arguments": "{\"user_id\": \"E10238\", \"status\": \"submitted\"}" } },{ "id": "call_q2", "type": "function", "function": { "name": "queryTravelPolicy", "arguments": "{\"job_level\": \"P6\", \"city_tier\": \"2\"}" } }] },{ "role": "tool", "tool_call_id": "call_q1", "content": "(同前,报销单查询结果)" },{ "role": "tool", "tool_call_id": "call_q2", "content": "(同前,差旅标准查询结果)" },{ "role": "assistant", "content": null, "tool_calls": [{ "id": "call_q3", "type": "function", "function": { "name": "calcAmountOver", "arguments": "{\"actual_amount\": 3860.00, \"limit_amount\": 3800.00}" } }] },{ "role": "tool", "tool_call_id": "call_q3", "content": "{\"over_amount\": 60.00, \"over_ratio\": 0.0158, \"is_over\": true}" }],"tools": [ "... 四个工具原样重发一遍,此处为省篇幅省略 ..." ],"tool_choice": "auto"}
看清楚messages数组现在的长度:7 条。第 1 轮发过去的时候是 2 条(系统提示词 + 用户提问),这一轮变成 7 条。每一条都还在,一个都没删。
上面这个报文里,有 5 条标着"同前"——它们的内容跟第 2 轮那份一模一样,所以我没重复贴。但它们每一轮都真的在你的请求里,这就是"每轮整个重发"的意思。你自己写代码时也是这么写的:维护一个 messages 数组,每轮往后追加,绝不删前面。
这就是第 03 讲讲的滚雪球——你每多调一个工具,Context 就多长一截(模型的条子 + 工具结果,两条一起长)。而这份数组,每一轮都要整个重发一遍。
【第 3 轮 · 下半】模型 → 你的程序
(模型看到 is_over: true,决定提单。注意这是模型第一次发出"干动作"的调用意图——第 4 轮里那张单子能被创建,源头是这一段。)
{"role": "assistant","content": null,"tool_calls": [{"id": "call_q4","type": "function","function": {"name": "createExpenseSupplement","arguments": "{\"expense_id\": \"BX-20261015-0932\", \"over_amount\": 60.00, \"reason\": \"出差住宿超标,按行内标准补提差额\"}"}}]}
这一段是"干动作"这一类工具是最危险的地方。模型决定调它的时候,它已经带着参数了;你的程序执行它的时候,它真的会在生产系统里建出一张单子。
所以这一类工具要么先出方案等人点确认,要么限定只能改某些状态和某些范围,并且每一次调用留痕。第 06 篇讲的"不加确认环节,模型一句话就把生产数据改了",说的就是这个。
【第 4 轮 · 上半】你的程序 → 模型
(你把提单成功的回执塞进 Context,发第 4 次请求。messages数组已经 9 条了。)
{"model": "DeepSeek-V4-Flash","messages": [{ "role": "system", "content": "(同前,未变)" },{ "role": "user", "content": "(同前,未变)" },{ "role": "assistant", "content": null, "tool_calls": [{ "id": "call_q1", "type": "function", "function": { "name": "queryExpense", "arguments": "{\"user_id\": \"E10238\", \"status\": \"submitted\"}" } },{ "id": "call_q2", "type": "function", "function": { "name": "queryTravelPolicy", "arguments": "{\"job_level\": \"P6\", \"city_tier\": \"2\"}" } }] },{ "role": "tool", "tool_call_id": "call_q1", "content": "(同前,报销单查询结果)" },{ "role": "tool", "tool_call_id": "call_q2", "content": "(同前,差旅标准查询结果)" },{ "role": "assistant", "content": null, "tool_calls": [{ "id": "call_q3", "type": "function", "function": { "name": "calcAmountOver", "arguments": "{\"actual_amount\": 3860.00, \"limit_amount\": 3800.00}" } }] },{ "role": "tool", "tool_call_id": "call_q3", "content": "(同前,计算结果)" },{ "role": "assistant", "content": null, "tool_calls": [{ "id": "call_q4", "type": "function", "function": { "name": "createExpenseSupplement", "arguments": "{\"expense_id\": \"BX-20261015-0932\", \"over_amount\": 60.00, \"reason\": \"出差住宿超标,按行内标准补提差额\"}" } }] },{ "role": "tool", "tool_call_id": "call_q4", "content": "{\"supplement_id\": \"BC-20261020-0417\", \"status\": \"submitted\", \"created_at\": \"2026-10-20 10:12:33\"}" }],"tools": [ "... 四个工具原样重发一遍,此处为省篇幅省略 ..." ],"tool_choice": "auto"}
9 条了。这个报文里 8 条标着"同前",只有最后一条是这轮新增的——但正是这 7 条"同前",让模型能想起自己前面查过什么、算过什么。
注意 call_q4 这个 id——它是第 3 轮模型给的,你必须原样带回,这是整个协议的"连接键"。
这里还藏着第 03 讲的一个坑:"用户点确认"这件事本身也是一段文字进 Context 的。用户说"确认",程序把这句话变成一条 role: "user" 的消息追加进去,模型读到才继续。确认这个动作,也是靠上下文传递的。
【第 4 轮 · 下半】模型 → 你的程序 → 用户
(最后一轮。模型这轮不再出条子,而是说人话。你的程序收到之后转给用户显示出来——模型从来不知道"显示"这回事,它只管生成文字。)
{"role": "assistant","content": "您的差旅报销单 BX-20261015-0932 金额 3860.00 元,超出行内差旅标准 3800.00 元,超出 60.00 元(约 1.58%)。已为您提交报销补充单,单号 BC-20261020-0417,状态已提交。补充单提交后需要您补齐超标事由说明并等待主管审批。"}
到这一行,模型才第一次说人话。
回头看整条链路:查报销单、查标准、算超标、提补充单——四件真事,全部是你的程序干的。模型在这个过程里只干了三件事:决定调哪个工具、把参数填成它认为像样的样子、把结果组织成人话。
让Deepseek花了一个图,大概交互是这样的(不是上面交互的数据,只是一个样例)。
五、那个工具在你的程序里,长什么样?
报文里 calcAmountOver 只是一个名字。模型看到的是这个名字加一段描述,真正干活的是你程序里的一个普通函数。把它摊开看,这一节祛魅才算祛完。
下面这段是可以直接跑的 Python(示例实现,把 Decimal 的坑都踩进去了):
from decimal import Decimal, ROUND_HALF_UPCENT = Decimal("0.01")def calc_amount_over(actual_amount, limit_amount) -> dict:"""计算实际金额超出标准的金额与比例。只做算术,不查任何系统。传入金额单位一律为元。"""# 参数校验:模型填的参数不可信,必须再卡一道try:actual = Decimal(str(actual_amount))limit = Decimal(str(limit_amount))except Exception:return {"ok": False, "error": "参数不是合法数字,请传入以元为单位的数值"}if actual < 0 or limit < 0:return {"ok": False, "error": "金额不能为负数"}if limit == 0:# 除零保护:模型很容易把限额填成 0return {"ok": False, "error": "标准限额为 0,无法计算超出比例,请先确认职级与城市层级"}# 先量化到分,再判断是否超标——顺序反了会出坑(见下方说明)over = (actual - limit).quantize(CENT, rounding=ROUND_HALF_UP)is_over = over > 0if not is_over:over = Decimal("0.00")ratio = (over / limit).quantize(Decimal("0.0001"), rounding=ROUND_HALF_UP)return {"ok": True,"over_amount": float(over),"over_ratio": float(ratio),"is_over": is_over,}
这段代码里有四件事,是"工具能正确工作"和"工具看着能工作"的区别。
一、参数校验不能省。模型给什么你就算什么,迟早出事。上面的 try/except、负数检查、除零保护,每一条都对应模型真实会犯的错——它会给你 3800.00,也会给你 3800,甚至给你 3800元,更可能给你 0。第 06 篇讲的"参数取值范围只写在心里,模型就会按它见过的样子编一个",防线只能建在这里。
二、金额用Decimal,不要用float。这不是洁癖。float 的二进制表示有误差,0.1 + 0.2 在你眼里是 0.3,在计算机里是 0.30000000000000004。注意代码里"先量化到分、再判断"这个顺序——如果先判断再量化,会得到一个自相矛盾的结果:
# 错误写法(先判断,后量化)over = 0.1 + 0.2 - 0.3 # = 5.551115123125783e-17over_amount = round(over, 2) # = 0.0is_over = over > 0 # = True ← 说超标了,金额却是 0
上面这种结果,模型拿到会怎么想?它看到 over_amount: 0 和 is_over: true,大概率会跟你说"确实超了,金额不大"。这种自相矛盾的返回,比报错还难查。下面这段代码跑出来是干净的(is_over: False),因为量化在比较之前。
三、失败要返回"失败",不要返回空。这就是第 06 篇那条"失败动作"的落地。{"ok": False, "error": "..."} 是一句模型能读懂并转述给用户的话;返回 null 或者空字符串,模型会当成"查到了,没有结果",然后自己往下编(第 06 篇坑清单第一条)。
四、返回结构里带上ok。模型拿到的每一条工具结果都要能被它复述:"查到了,超 60 元,比例 1.58%"或者"没查成,原因是限额为 0"。字段名本身就是给模型看的说明书。
顺带说一句:这个函数没有一行代码跟"大模型"有关。它就是个普通的入参、返回值、加几层校验。你在第 06 篇看到的那些"取信息 / 做计算 / 干动作 / 接老系统",落到代码里就是四个这样的函数——区别只在于第三个会改数据、第四个要去调老系统。
把这条链路摊平,看 Context 涨成什么样
同一个问题,四次请求,工具清单被完整重发了四次。这就是第 03 讲那笔账在工具场景下的样子。工具挂得多不多,直接乘以轮数。
六、三个最常见的误解
误解一:"模型知道我的系统长什么样"
不知道。它看到的是你写在描述里的那几十个字,和工具返回给你的那几行文本。
你的接口真实返回了 300 个字段、里面嵌着 8 层嵌套、还带着内部术语——这些只要没被塞回上下文,模型就一点不知道。反过来也一样:它在中间做的所有事,模型也一点不知道。
所以你会遇到这种情况:你的接口超时了、重试了三次最后降级返回了一个兜底值,整个过程你的程序处理得干干净净,模型收到的就是一行"生效日期:2023-05-01"。它会把这个假结果当成真的,高高兴兴告诉用户。
模型的视野里只有两样东西:描述文本,和结果文本。中间的整个世界对它不存在。
误解二:"参数是传过去的,不是模型填的"
模型填的。
你给模型一个 Schema,告诉它参数 doc_id 是个字符串、必填。模型在生成的时候,是根据训练中学到的模式,编出一个它认为像doc_id的字符串。它没有查过你的编号规则,它只是在模仿它见过的形状。
OpenAI 生态提供 strict: true(结构化输出)能保证生成的参数严格符合你给的 Schema——类型对、必填项在、枚举值不越界。这是有用的。但请注意它保证的是什么:
doc_id | |
格式合法 ≠ 内容正确。编号存在不存在、权限够不够、日期格式对不对,仍然要你的代码去校验。Schema 是给模型看的"表格格式要求",不是业务规则引擎。
误解三:"接了工具,模型就更聪明了"
没有。模型还是那个模型,第 01 讲讲的那些毛病一个没少——它照样会幻觉,照样会算错日期。
工具改变的是它的信息面和行动力,不是它的智力。接上工具之后,它能从"不知道"变成"能查",能从"算错"变成"让代码算",能从"说不了"变成"真去办"。但"该不该查""查回来的数据怎么解读""这个结论能不能下"——这些还是它在判断。
工具治不了幻觉,只能限制大模型减少幻觉,增加大模型的扩展。
七、为什么"工具描述"成了最要紧的一件事
把上面几条串起来,就能推出一个结论:模型挑工具,本质是在做一次语义匹配,而且是在概率上做。
它没有规则表可以查,没有 if-else 写好"遇到'生效日期'就调 A 工具"。它把用户的话和工具清单一起读进去,然后在"下一个词该是什么"这个问题上,给出了"应该调用工具 X,参数是 Y"这个答案。
这个机制带来三个直接后果:
一、描述含糊,选择就含糊。你写"查询日期",用户问"规定从什么时候开始执行",它可能觉得你需要的是"查询修订记录"。它分不清,是因为你分不清。写得越具体(什么时候用、什么时候别用),它命中正确工具的概率越高。这就是 06 篇那一整篇在讲的事。
二、工具越多,越容易挑错。同一个决策层上挂十几个工具,每个描述又都长得差不多,模型的匹配空间一下变大,挑错率跟着上去了。我自己的红线是超过十个就该收,办法是合并同类项,或者先做一层粗分类再进细的工具集。
三、工具描述是给人看的那部分 UI。想想一个你没用过的接口,光看文档你能不能判断"这个接口能不能解决我的问题"?工具描述对模型,就是接口文档对你的作用。它描述的不是"这个接口怎么实现",是"什么时候该用它"。
顺带说一句:平台内置工具、自定义 HTTP 接口、工作流、MCP Server——这四种在模型那一侧长得一模一样,都是"一个名字 + 一段描述 + 一个 Schema"。选哪种是实施和架构的决策(成熟度、治理要求、复用范围),跟模型能力没关系。这个认知能省掉很多无效争论。
八、工具不是免费的:链路和成本
把第四节那份报文压成一张账:
两个要注意的地方:
第一,工具描述是常驻开销。每次请求都把那段描述带上去,工具多了就是几份常驻成本。这跟第 03 讲的"每次请求都要把整段上下文重新带上去"是同一笔账。
第二,"并行调用"能省轮次,但不省上下文。第四节那次 queryExpense 和 queryTravelPolicy 就是并行发起的——你的程序同时去跑两个接口,理论上快。但结果还是得一条条塞回上下文,上下文该占的还是占了。省的是往返次数和延迟,不是 token。
还有一个更前沿的方向值得知道:新一代模型开始支持程序化工具调用——不是让模型一次次手写"调 A 再调 B",而是让模型自己写一段小脚本来编排这些调用,把筛选、汇总、排序这种确定性的活儿挪到代码里执行,模型只留判断的部分。
对我们做交付的意义是:同样是"接工具",架构上限已经不一样了。老的做法是把编排逻辑写死在平台流程里,新的做法是让模型在一定范围内自己编排。前者稳,后者灵活。
九、MCP 到底改变了什么
第 07 讲专门讲 MCP,这里只提前祛一个最常见的魅。
MCP 没有改变模型使用工具的任何原理。
在模型眼里,一个 MCP 工具和一个你自己写的 HTTP 接口工具,没有任何区别——同样是一个名字、一段描述、一个 Schema。MCP 规范里也是这么定义的:工具靠 tools/list 被发现(返回名字、描述、输入 Schema),靠 tools/call 被调用(传名字和参数,返回内容块,出错用 isError 标记)。
它改变的是"工具清单怎么送到模型面前"这件事:
你的工具自己写在代码里,叫"私有工具",换个应用就得重写一遍; 做成 MCP Server,就是一个标准服务,Claude、WorkBuddy、别的 Agent 客户端都能挂上去用。
所以对非技术的人来说,一句话总结 MCP:它不是给模型加能力,是给你的工具插了一个通用插头。模型那一侧的原理,和第 06 篇讲的一模一样。
十、什么算会了
你能对着一条完整的调用日志,说出"这五步分别发生了什么"。 不是"知道有工具调用这回事",是能指着日志指出:哪一步是模型出的条子,哪一步是你的程序去跑的,中间那次重试在哪。 你能说清模型到底看见了什么、没看见什么。 尤其是"没看见"的那部分——超时、重试、权限、限流、脱敏,这些模型统统不知道,所以它们必须由你的程序兜住。 你能解释一次幻觉是怎么从"工具返回空"开始的。 这不是理论题,这是实际最容易踩的坑:工具返回了空或者 null,模型不会说"没查到",它会顺着往下编。 你知道 strict 能干什么、不能干什么。 能保证格式,不能保证内容。 你能指出一份请求里,哪些字是给模型看的、哪些字是你的程序自己该覆盖的。 比如第四节那份报文里的 job_level和city_tier——那俩是模型填的,不能信。
动手任务:让你手上任意一个已经接了工具的系统,把一次工具调用的原始报文打出来——请求体、模型的回复体、你的程序回填的那段结果,三段都看。然后拿笔在这三段上标:第一步、第二步、第三步、第四步、第五步各对应哪一段。
标完你会发现,很多"这模型怎么突然变傻了"的问题,答案就在那段你之前没看过的中间代码里。
十一、坑
工具返回空,模型就顺着编。这是本篇最该记住的一条。空字符串、null、空数组,在模型眼里是"查到了但是没有",不是"查不到"。它会拿这个"没有"往下推:既然查不到生效日期,那大概就是已经失效了吧。工具必须把"没查到"作为一个明确的、有字样的情况返回(比如固定文案"未查到该文件的生效日期"),而且失败时明确写"禁止根据文件名推测日期"。
超时了,但模型不知道。你的程序把超时兜成了默认值,模型收到的是"生效日期:2023-05-01",它会当真话讲出去。兜底值是给系统用的,不是给模型用的——要兜就兜成"查询失败,请稍后重试"这种明确的话,别兜成看起来像真结果的东西。
上下文压缩把工具结果压掉了。第 03 讲说过压缩会丢信息。工具结果恰恰是最容易丢也最不能丢的那部分——"你查过什么、查到什么"没了,模型就会重新猜一遍。所以压缩时该白名单保护的,除了数字和编号,还有工具结论。
以为strict: true就万事大吉。它保证参数长得对,不保证参数是真的。编号存在吗、这个人有权限查吗、这个状态允许改吗——全在 Schema 之外,得你自己写代码卡。
工具清单塞进系统提示词里。有的平台你把工具写在正文里、模型照样不认,得放在平台约定的那个字段(tools)里。这个坑很隐蔽:你看日志,提示词里明明写了工具,模型就是不调。
挂太多工具。十几个工具、描述又都相近,模型挑错的概率明显上升。这时候该做的不是继续打磨描述,是合并同类项,或者加一层粗分类先分流。
这篇文章就到这里,如果看不懂没有关系,后续会对工具进行详细的讲解,尤其是Agent的设计。
《AI-FDE 转型之路》:写给不写代码的 IT 实施 / 售前 / 运维,把已有的交付能力「AI 化」。全系列 55 篇,六大模块 53 项技能。
想先看看自己缺什么:AI-FDE 技能自评地图,53 项打分,出一张雷达图。AI-FDE 转型之路 · 开篇