ARTICLE · 1301409
"集结"端侧AI朋友圈:从大模型芯片到真实场景,聆思进入生态竞速 | 前沿在线
2026年的端侧AI,热闹得有点像智能手机生态刚起来那几年。
AI PC想让Agent替人操作电脑,机器人接上视觉语言动作模型,智能家居和汽车座舱也忙着把大模型搬进设备。
模型一代比一代聪明,芯片参数越来越漂亮,演示视频一个比一个能打。
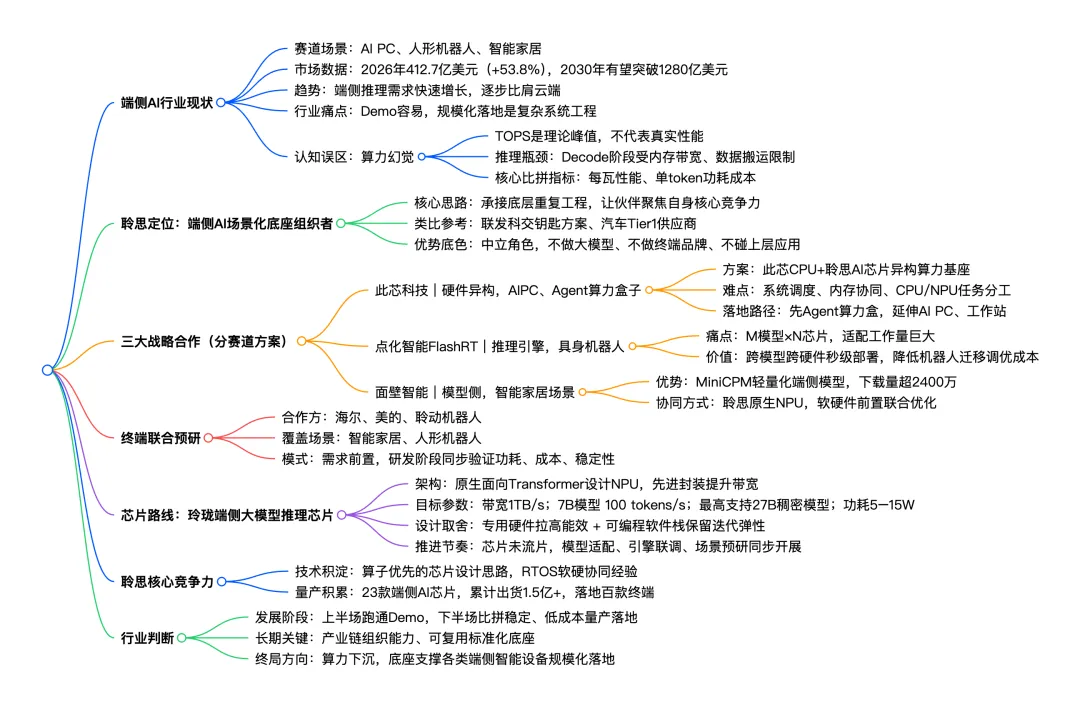
这不是概念在炒作。按IIM信息预测,2026年全球端侧大模型相关软硬件及服务市场规模将达412.7亿美元,同比增长53.8%,到2030年有望突破1280亿美元。
更直接一点说,端侧推理的需求,正在以肉眼可见的速度,逼近甚至超过对云端的依赖。
资本和厂商不是冲着PPT来的,是真有蛋糕要分。
就在这个当口,聆思的动作,把这场竞速又往前推了一步。
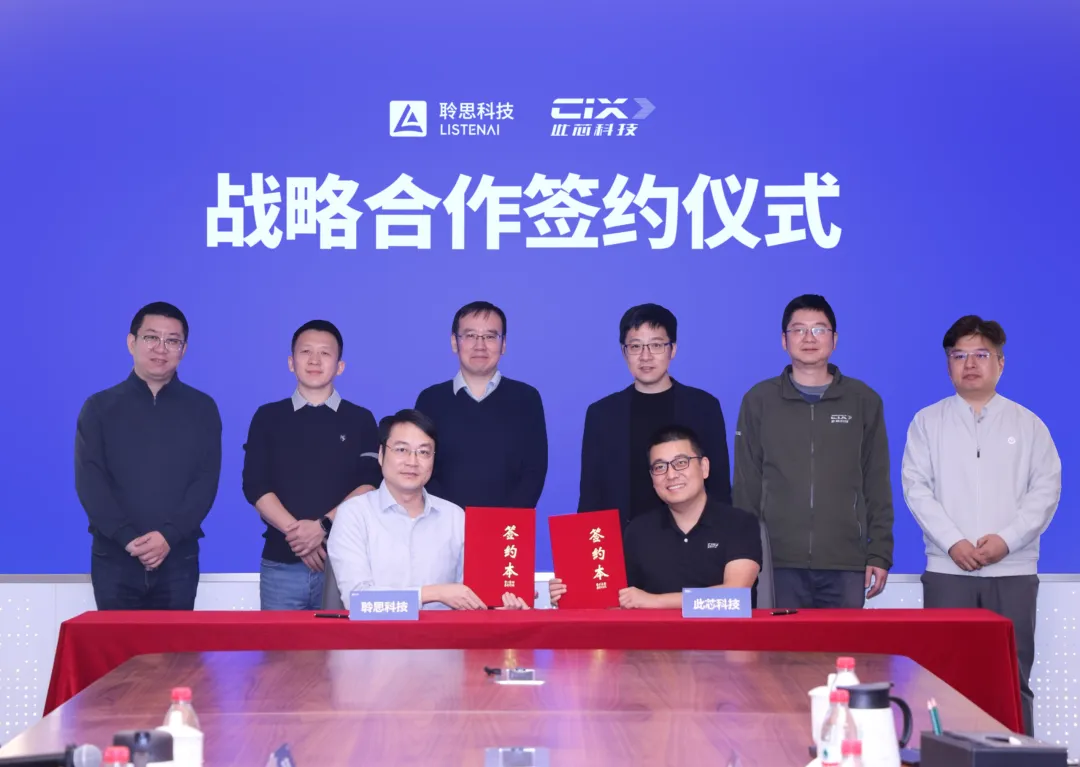
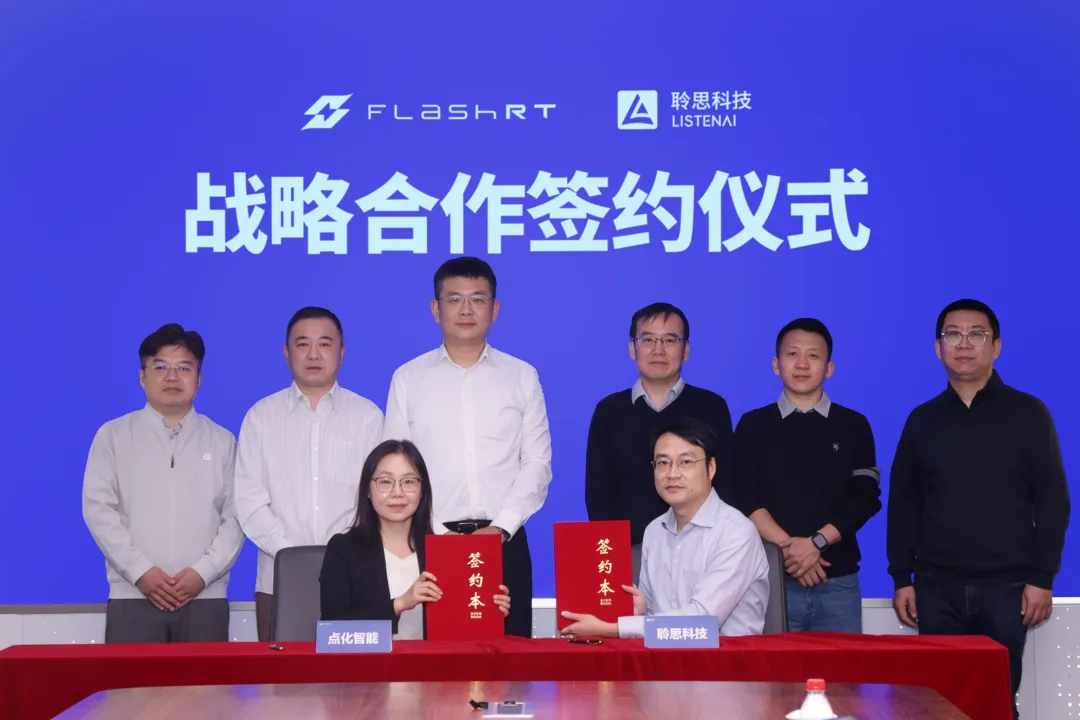
10月23日,聆思科技与此芯科技、点化智能科技达成战略合作。
此前,聆思已与面壁智能建立战略合作关系,并与海尔、美的、聆动机器人、奇瑞等终端企业展开战略级联合预研。
一家端侧AI芯片企业,正把不同环节的伙伴,集结到同一条产业链上。
可真正做过产品的人都知道,演示跑通,和把东西卖出去、长期用起来,中间隔着一大摊工程活儿。
Demo像相亲,挑的都是最好的状态。真过日子,全是细节。
拿Computer Use来说,模型能看懂屏幕、规划下一步,还得靠操作系统分配权限、调用应用、读写文件。
换成机器人,感知、决策、推理结果还要接上运动控制。模型会思考,不代表设备就能自己把活儿干完。
过去大家习惯比模型参数、芯片TOPS、功耗,现在的难题越来越像一道系统工程题:CPU和NPU怎么分工?模型更新后,旧的适配还能复用多少?推理引擎怎么跟不同硬件打通?最终又怎么满足终端的成本、功耗和开发周期?
单个技术模块拿出来,都有不错的选择。难的是让它们真正配合起来。
TOPS越来越高,产品为什么还是难做
端侧AI的第一个认知陷阱,是把标称算力当成了真实能力。
TOPS衡量的是理论峰值,是芯片在最理想状态下每秒能完成的运算量。真正跑大模型时能兑现多少,是另一回事。
大模型推理和过去的轻量AI任务,不是一个路数。
以常见的自回归Transformer为例,推理分两个阶段。Prefill处理输入的整段上下文,并行度高,算力容易喂饱。
Decode阶段一个字一个字往外吐,尤其在小批量推理时,每生成一个token,都要反复读取模型权重、访问KV缓存。这时候卡住速度的,往往不是算力,而是内存带宽和数据搬运。
计算单元备好了,数据没及时送到,再高的峰值也使不上。两块标称TOPS相近的芯片,跑同一个模型,吐字速度和功耗能差出一大截。
再加上架构匹配。通用架构的芯片,天生不是为Transformer设计的,注意力机制、长序列依赖这些大模型的核心特征,没有对应的硬件优化,大量算力空转。
纸面参数一路狂奔,真实体验原地踏步,这就是行业里说的算力幻觉。
这里有个更值得琢磨的现象。行业不是不知道TOPS虚,可宣传口径还是清一色堆TOPS。
原因不复杂:真实能效最难测、最难横向比,TOPS这个数字却好堆、好讲故事。 客户问起来,报个好看的算力数字,比解释"每瓦能跑多少token"省事得多。
端侧AI真正该比的是每瓦性能、每个token的功耗成本,不是标称TOPS。
行业慢慢看清,决定一款产品能不能打的,不再是单一指标,而是算力、内存、算子、软件能不能在一个系统里协同。
单一性能指标,已经判断不了产品竞争力。
单颗芯片再强,也只是一张牌,牌局怎么打,还得看谁来组织。
单点突破之后,总得有人铺底层
把眼光拉长,端侧AI今天的处境,几乎每个成熟硬件产业都经历过。
一个产业从起步到爆发,路径大致相似。先是单点技术突破,证明这事能做;接着一堆玩家涌入,Demo满天飞;再往后,瓶颈浮现,底层的公共能力没人做,产品迟迟上不了量。
功能机时代,联发科的交钥匙方案把处理器、基带和软件系统打包,大幅降低了终端厂商的系统开发门槛,一批国产手机厂商由此起来。
端侧AI如今同样需要降低集成和适配成本,只是它要面对更多模型变化、硬件差异和场景约束。
汽车里的Tier 1是类似角色。
博世、大陆、电装这些供应商,把零部件、软件、系统集成做成模块,交给整车厂,让整车厂在成熟底座上专心定义自己的车。
这跟城市铺水电路是一个道理。地下管网先铺好,后来的人不必自己打井、自己发电,城市才转得起来。底层门槛拉下来,终端才可能规模化上量。
端侧AI现在就站在这个节点上。
它不缺会做Demo的公司,真正缺的,是有人把产业链集结起来、肯替整个行业打底。
三场合作,三个行业的解法
看清了这一层,再看聆思这一连串动作,味道就不一样了。
做端侧这件事,本来就没人能独自干完。它不把自己框成一家只卖芯片的技术公司,而是把身位摆在了场景解决方案上,一个行业一个行业地,把各自需要的产业链环节组织起来。
每场合作都有明确的针对性,各取所需,合作共赢。
串起来看,三场合作其实是同一个逻辑:把厂商和开发者不擅长、也不愿意干的底层脏活接走,让他们把精力留给真正决定自己竞争力的那一件事。
它不是在一家家挑合作伙伴,是在补齐自己生态版图上的每一块拼图。
硬件侧:与此芯科技异构协同,探索AIPC与Agent盒子
做AI办公和各类应用的开发者,真正的价值在Agent和应用层。
要是没有一个现成的硬件算力底座,他们得先去琢磨CPU、NPU怎么分工、系统怎么调度、外设怎么接,这些既不在核心价值里,也不是他们擅长的。
聆思和此芯科技的合作,先把这套底座搭出来。
此芯CPU加上聆思AI专用芯片的异构组合,兼顾通用计算和大模型认知推理,解决当前端侧大模型推理算力的痛点,打造Agent端侧大模型算力基座。
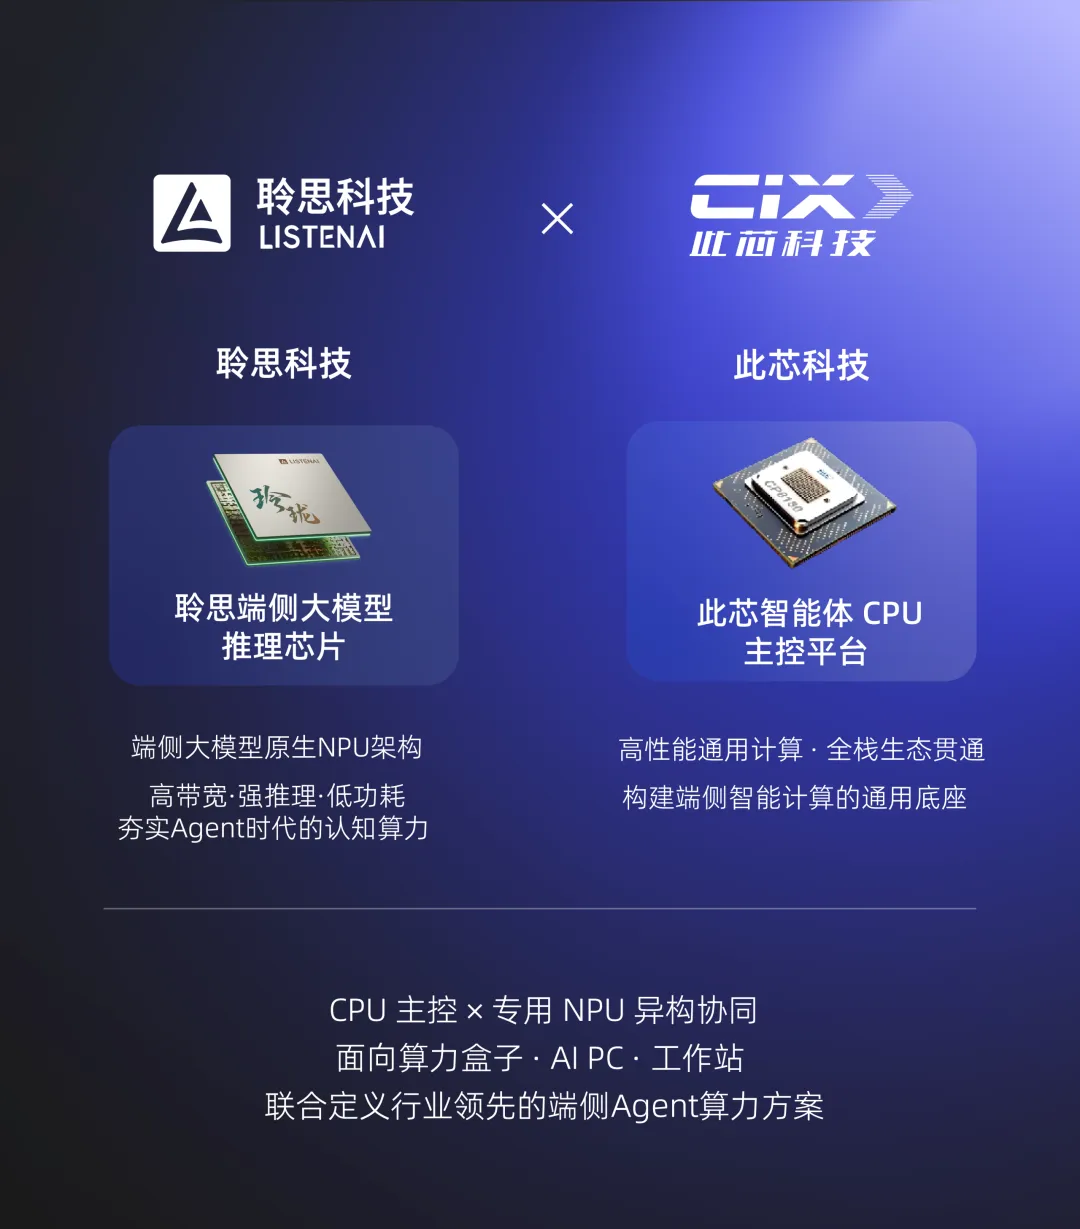
具体到产品,此芯科技旗舰芯片P1采用Armv9.2架构,集成12核CPU、GPU和30 TOPS NPU。
它最值钱的不是参数,是2026年5月联想全球首发搭载P1的AI主机,这颗国产CPU头一回进了全球PC巨头的核心产品线。
聆思想要的不只是一颗能用的CPU,是一个能真正把芯片带进量产的整机通道。
异构协同真正的难点也不在把两颗芯片放一块,而在系统软件和调度。CPU和NPU怎么分工、内存怎么协同、任务怎么调度,这些要在架构层面先理顺,否则就是两颗芯片各跑各的。
双方在系统层面深度适配,通用任务和认知推理各归其位。
底座搭好,开发者拿到的是一套成熟的参考方案,省下的时间精力全投回Agent和应用本身。
双方先落在Agent算力盒子,再延伸到AI PC、工作站,探索AIPC与Agent盒子的新形态。
引擎侧:与点化智能科技(FlashRT)联手,破解具身智能的适配难题
具身机器人是端侧AI最受关注的方向,也有它特有的难题。
机器人厂商的竞争力是个系统工程,模型只是其中一环,本体设计、运动控制、数据采集、系统集成、可靠性和场景交付,哪一样都不能掉链子。模型路线也分两类,有自研VLA的,也有基于开源VLA做微调的。
但不管自研还是用开源,模型迭代得都很快,而且现在大多跑在英伟达的GPU上,性能够用,成本和功耗却高。
真要走向消费级量产,行业得把模型迁移到更高效的NPU上,迁移和优化最耗神。机器人厂商数量多、单家出货小,很难每家都养一支底层团队。
这正是业内常说的"M家模型或机器人企业,对应N款端侧芯片",M乘N种组合,适配工作量巨大。
过去一个机器人厂商想换颗芯片,模型要重编译、算子要重写、性能要重新调,动辄以月计,一支团队大半年就耗在这一件事上。
这笔账摆在那,劝退了一大批原本想做量产的机器人厂商。
点化智能科技的FlashRT不是一颗芯片,是面向具身智能的实时推训引擎,定位在场景和硬件之间,往上是各家VLA模型,往下是不同算力芯片,把重复的适配活沉淀成一套可复用的能力。
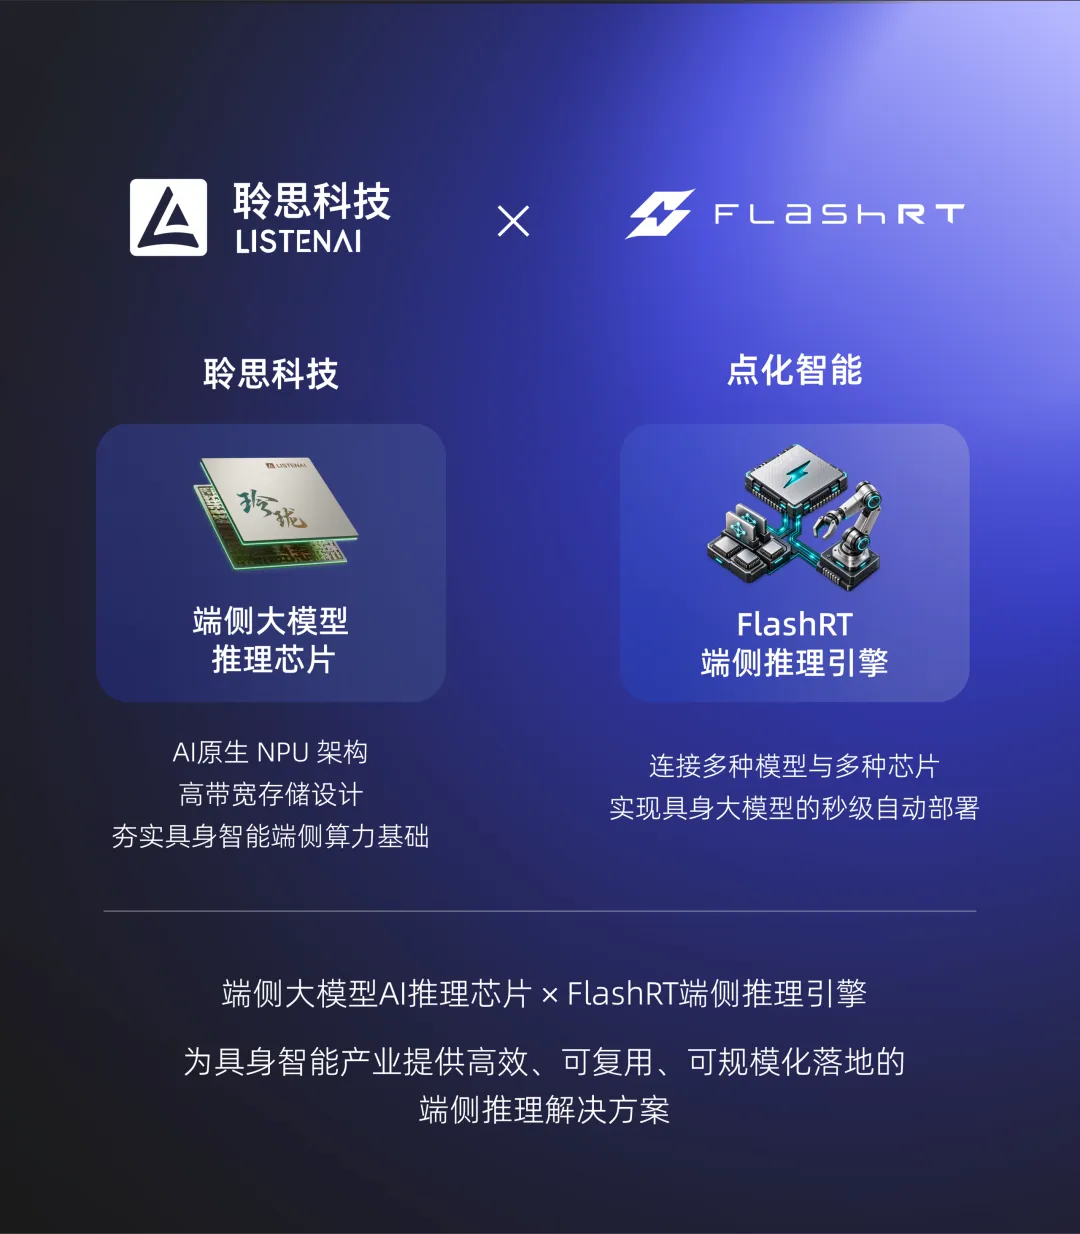
输入模型参数和芯片算力、算子参数,就能在目标芯片上秒级完成部署,方案已在英伟达平台验证,模型运行效率优于英伟达原生部署。
机器人厂商换模型、换硬件,不必每次把编译、算子、运行时这些底层工程重做一遍,还能把精力继续放在本体、模型和场景交付这些真正决定竞争力的事上。
模型侧:与面壁智能软硬结合,面向智能家居等多场景
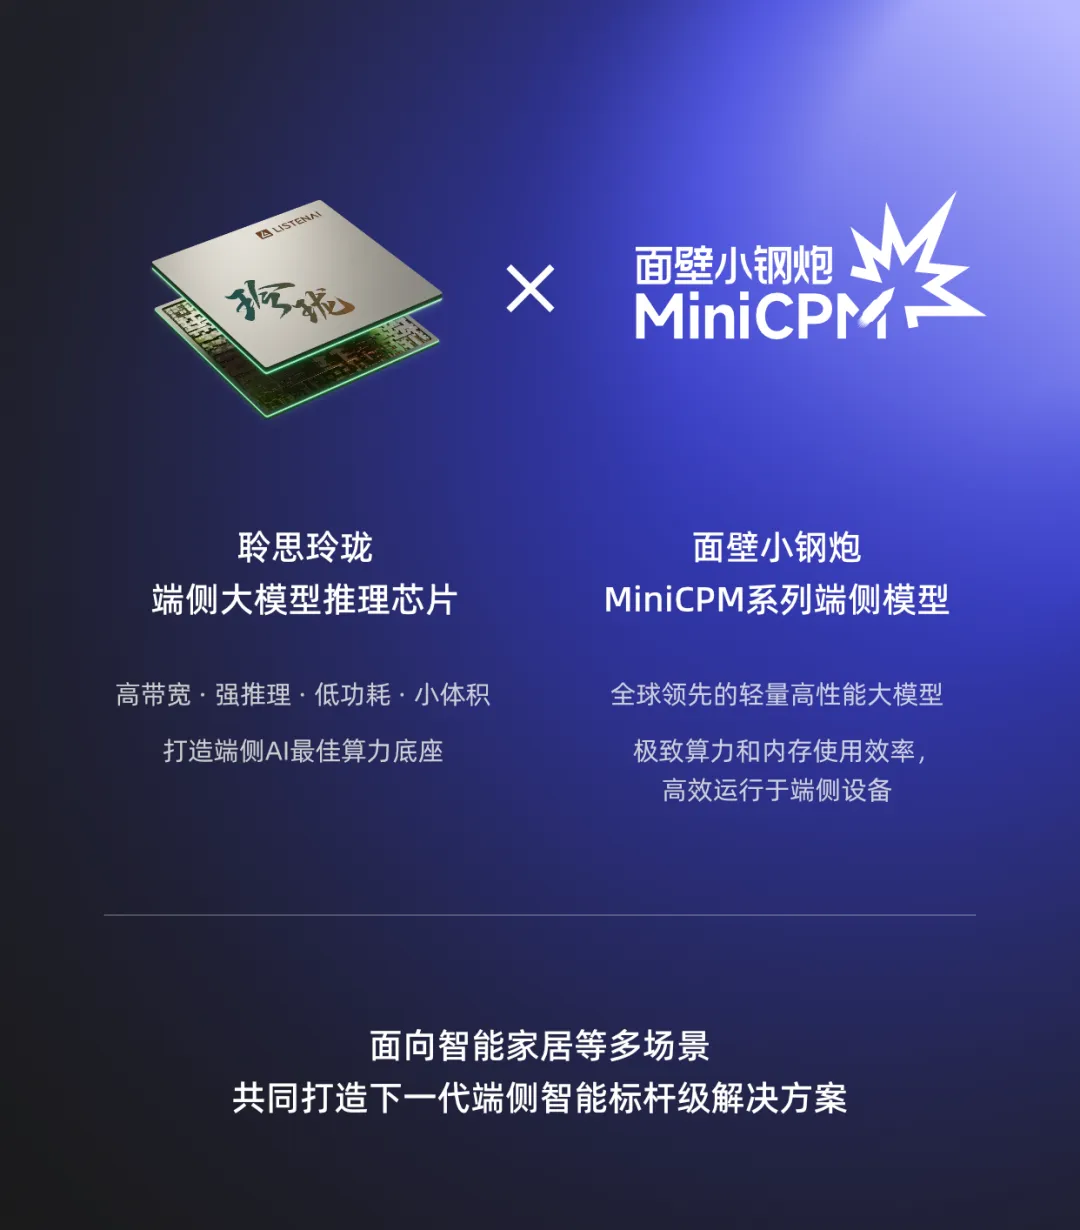
聆思与面壁智能的战略合作,瞄准的是智能家居等多场景。
这些场景有个共同的尴尬:现成的开源模型,对它们的具体应用并不友好。智能家居要长时间低功耗运行,通用模型直接拿来用,效果差一截。
它们需要面壁智能这样的垂类模型厂商,针对具体场景专门训练、优化模型。
这是笔双向的账。面壁智能需要一个硬件性能领先的算力平台,让自己的模型跑出更好的效果;聆思也需要面壁智能这样的垂类模型,把场景真正做透。
面壁智能孵化自清华NLP实验室,MiniCPM系列端侧模型轻量化、高性能,全球下载量已突破2400万次,在智能家居等多场景规模化落地。
聆思围绕Transformer算法特征研发AI原生NPU,双方从模型部署、算子优化到软硬件协同前置合作,把模型特性和芯片架构在设计阶段就对上,打造端侧软硬一体化的高效方案。
三场合作,拆开看是三个行业的三个解法,放到一起,才是完整的画面。
此芯科技把专用推理接进完整计算系统,点化智能科技推动模型在不同硬件上更方便地部署和更新,面壁智能让模型与芯片更早协同。
对一家想做Agent算力盒子或机器人的企业来说,理想的技术底座是什么?
模型有适配基础,计算资源有明确分工,部署工具能持续更新,还有参考设计可以接着开发。企业专注自己的产品,不用每次都从底层搭起。
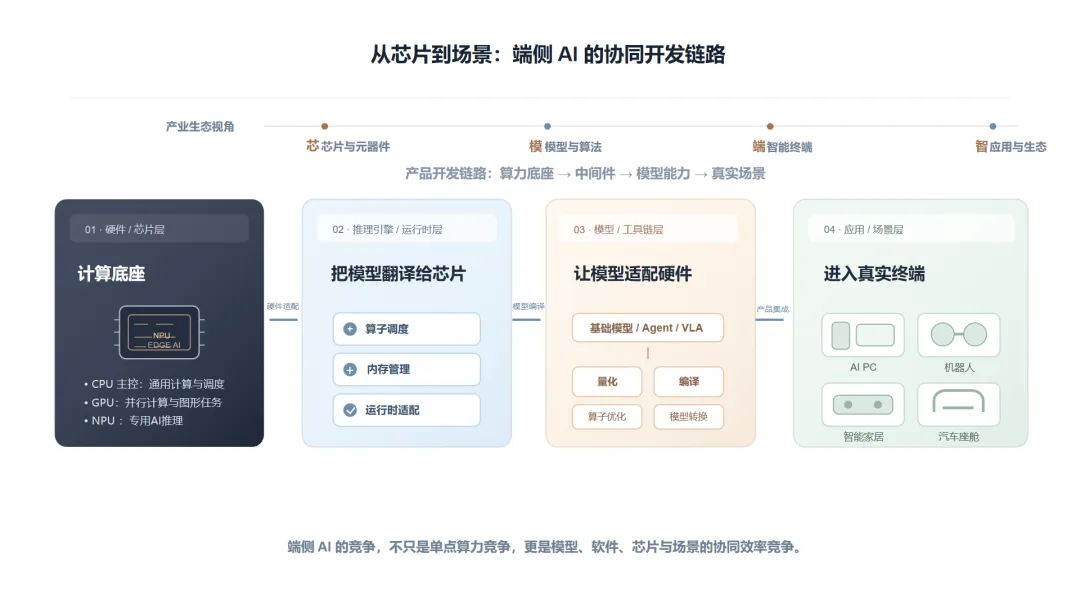
这也是"开放的端侧AI场景化底座"该有的样子:各家拿出擅长的能力,通过模型适配、系统工具和参考方案,让一次工程投入尽可能被更多应用复用。
聆思在其中发挥的,是连接技术伙伴、推动方案协同的产业组织能力。
终端联合预研,把场景提前请进来
除了集结产业链,聆思还在做一件关键的事:把真实场景的需求,提前请进研发流程。
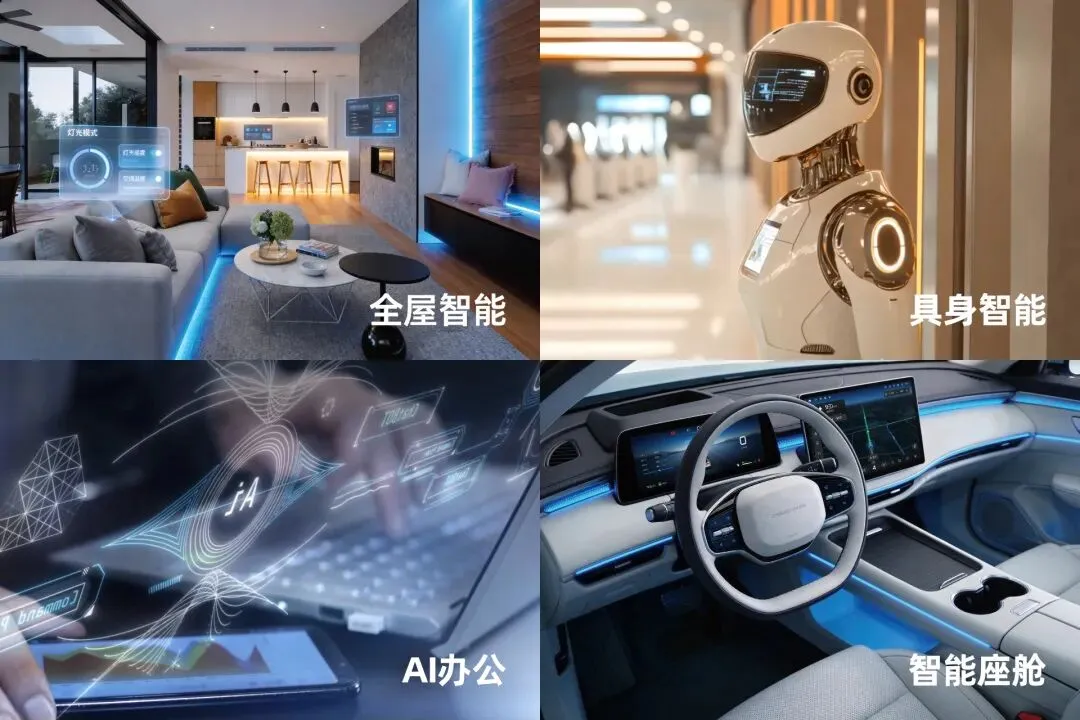
聆思与海尔、美的、聆动机器人、奇瑞等终端企业展开战略级联合预研,覆盖智能家居、机器人、智能座舱等方向。
这些场景的工程约束各不相同。
智能家居看重长时间运行、多设备协同与成本,机器人需要感知、决策和运动控制衔接,座舱还要处理多应用并行和多模态交互。
产品怎么用、算力怎么配、成本怎么控,不能等到最后一道工序才想起来。
通过联合预研,终端厂商把目标应用、功耗预算、硬件形态、系统软件等需求带进方案设计,芯片和方案也在真实产品原型中验证功耗、性能与稳定性。
场景前置到研发,产品的坑少踩一半。这也是这一整套底座,真正接得住真实需求的地方。
专用与通用,芯片怎么才不被下一代模型甩开
聊到这儿,得碰一个真正考验芯片设计功力的问题。
专用化是把双刃剑。越是针对某一代模型做深度优化,能效越是好看;可模型一旦换代,风险也跟着来。
大模型这两年的演进没停过。
注意力机制在变,量化方式在变,稀疏化结构、KV Cache管理、多模态输入处理,都在快速迭代。今天为某个算子量身定做的电路,下一代模型可能就用不上了。
把芯片做成完全固定的专用电路,效率是高,但容易被模型迭代甩开。反过来,做成完全通用的芯片,又回到了老路,能效上不去,专用的意义就没了。
这是整个芯片行业都要面对的取舍:怎么在"当下跑得快"和"未来用得上"之间找平衡。
行业里比较成熟的解法,是把高价值的计算路径做专,同时把算子集合、数据通路和任务调度做成可编程的,再用编译器和运行时去承接模型的变化。硬件把效率天花板拉高,软件留出适配未来的弹性。
聆思的安排,是配套自研编译器、算子库和运行时,再加上和面壁智能、点化智能科技这些模型与引擎团队的前置协同。
模型一有新变化,能通过软件栈快速吸收,而不是逼着硬件推倒重来。
专用的能效,加上可编程的弹性,这是它面对模型迭代给出的答案。
这个答案不是被模型迭代逼出来的,是设计之初就算过账的主动选择。跑得快的当下,和用得上的未来,它都要。
用他们的说法,芯片不能拿固化的理念去做,模型每换一代,架构都得接得住。
这场局,为什么偏偏是它来攒
能集结产业链、替不同行业打底的,为什么是聆思?
先看技术路线。
聆思从做语音芯片开始,就把这件事反过来做:比算法更前置。
先把算法拆到最细的算子,算清楚每个算子要多少算力、多少内存、多少带宽,再照着这些需求去画芯片。
做人形追踪,就把特征提取、目标检测那几个算子的电路做到极致,把用不上的通用模块整个砍掉;做OCR,就专门加一块图像预处理加速器。这才是外人复刻不来的那层功夫。
后来做AI视觉,行业都在Linux方案上堆算力,它用RTOS软硬协同,把算力利用率做到80%以上,成本降到原来的三分之一。
这套螺蛳壳里做道场的功夫,到了大模型时代照样成立。
它不是在通用架构上叠AI模块,是从大模型的计算和访存特点出发做原生NPU,天然适合和上下游深度协同。
当年做语音时攒下的这套工程能力,才是它今天敢下这盘棋的本钱。
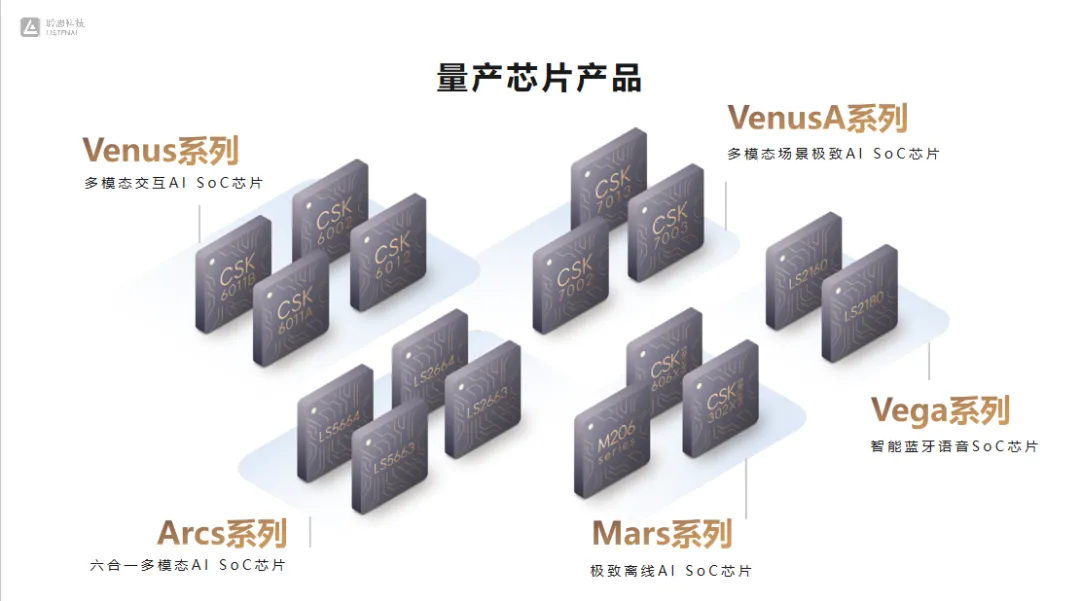
再看落地经验。自2020年成立,聆思已推出23款系统级端侧AI芯片,累计出货超1.5亿片,进入100余款终端。
消费级终端的BOM、可靠性、软件维护、量产节奏,都得从研发早期就算账,这些坑踩得够多,才知道工程能力该往哪儿攒。
还有定位。聆思没把自己局限在技术提供商,而是走向场景解决方案,为具体行业做解决方案。它不做大模型,不做终端品牌,不碰上层应用,和产业链上的伙伴都没有直接竞争。
做端侧AI底座,最要克制的是自己下场抢终端的冲动。既当平台又当运动员,生态往往很难做起来。
聆思能攒起这个朋友圈,恰恰因为它站得够中、手伸得够短。位置中立,大家才愿意把核心需求拿出来,一起把底座做深。
别人在卷参数,它在做一件更慢但更重的事:把行业的底打好。
这条路当然不好走。集结产业链、把底座做扎实,都是慢功夫,一年两年看不出什么,得熬得住。
芯片还没流片,整条链已经动起来
再看聆思正在研发的端侧大模型推理芯片玲珑。
玲珑围绕Transformer的计算和访存特点原生设计NPU,对计算架构和算子做针对性优化,并借助先进封装提高内存带宽。
按公司披露的研发目标,玲珑内存带宽可达1TB/s,7B模型Decode速度为100 tokens/s,双芯片级联可运行27B稠密模型,典型功耗控制在5至15W。
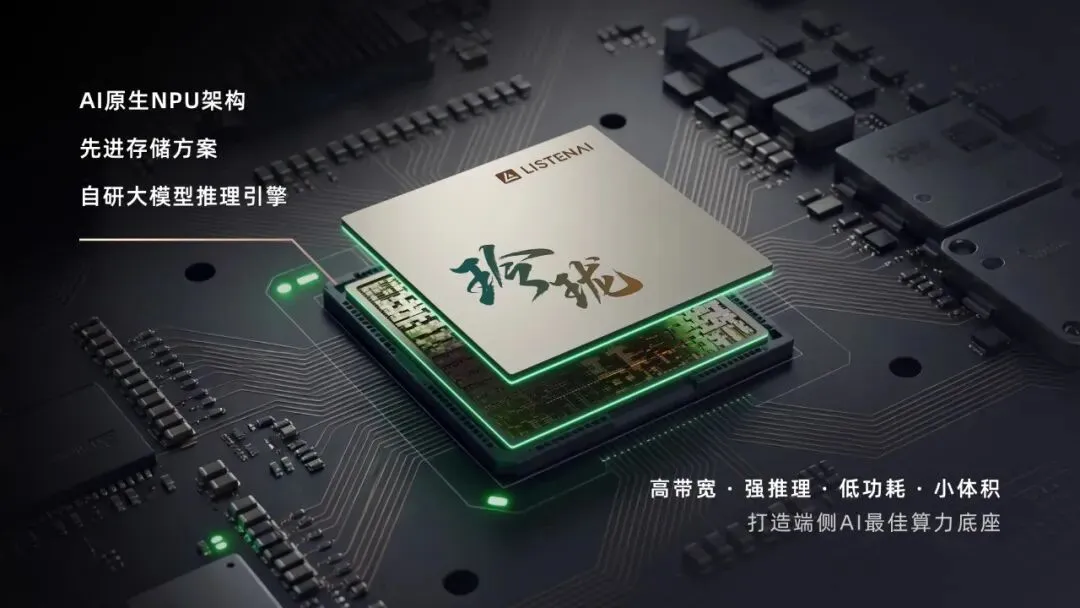
这颗芯片的价值很具体:在有限的功耗和面积下,带来高效的端侧推理效率,让大模型不必只待在云端,能走进机器人、家居、座舱这些对体积和功耗都很敏感的设备。
更值得琢磨的是它的推进方式。
玲珑2025年年初启动研发,预计2026年年底推出。与此同时,模型侧的前置适配、异构计算的协同、推理引擎的联调、终端场景的预研,已经同步展开。
芯片行业惯常的节奏,是先流片、再拉生态。玲珑走的是另一条路:先把整条链拉起来,再等芯片落地。
一块还在研发的芯片,能同时牵动这么多行业、这么多环节一起动,这本身就是最有力的注脚。
等芯片流片,模型适配、整机方案、部署工具、场景验证都已经在前面等着。这不是实验室里的概念,是按量产的节奏在排兵布阵。
端侧AI的上半场,大家都在证明自己能跑起来。下半场,要证明的是能不能稳定、高效、低成本地跑在真实行业里。
这几笔合作放到一起,才看清聆思真正在攒的是什么。
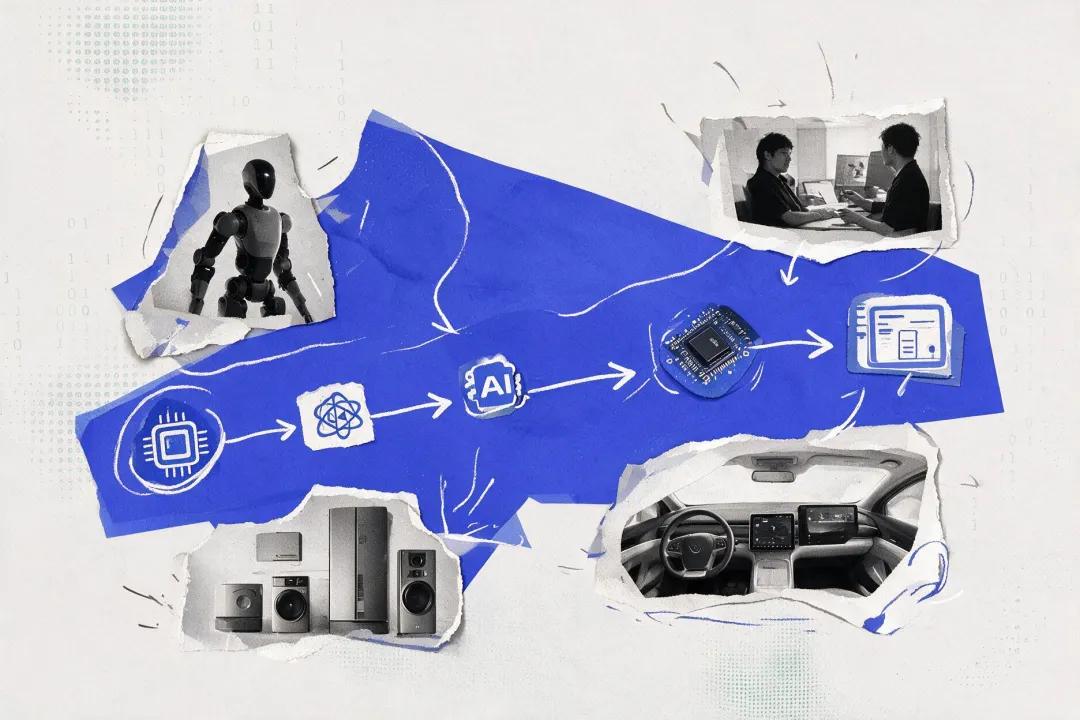
往深里看,是把芯片、模型、引擎、主控到系统这一整条技术栈,借这些伙伴的手串成了一条能直接用的线。终端厂商不用再自己去拼。
往宽里看,是每一笔合作都精准落在一个行业:Agent 办公、具身智能、智能家居等多场景。
这两个方向一旦对上,聆思手里就不只是几个合作项目,而是一个可以反复套用的底座。将来面对一个新行业,把它搬过去,比从零开始快得多。
真到牌桌上见真章,得看谁先让整条链都赚到钱,光自己赚是撑不起来的。
端侧AI的标准,不会等芯片量产之后才形成,而会在量产前的协同里被一点点定下来。
窗口期像末班车,你以为还有,等关门才发现上不去。
这场竞速的终点,落在每个人手里。
冰箱能听懂人话,机器人能在客厅把活干完,车里的助手不联网也能搭上话,这些从前只出现在演示里的功能,真要成为日常,靠的就是这一层底座在底下托着。
谁能组织场景、组织产业链,谁就更有机会把端侧AI真正做成产品。
聆思干的,是把底层那些谁都绕不开、又没人愿意单独干的活儿做扎实,让行业里的每一家,都能把精力留给自己真正擅长的事。
当算力下沉到每一个设备,真正的智能时代才刚开始。
这场生态竞速,现在才刚刚开始。