ARTICLE · 1339038
不只是网页搜索:AI本地搜索插件正在改变办公方式AIFindTool
过去十几年,我们找信息的习惯是被浏览器塑造的:输入几个词,翻几条结果,点开来看。这套动作很熟练,但它有一个前提——你要找的东西在网上。办公场景里,这个前提经常不成立。项目方案、客户往来、历史报表、去年那份报价单,都躺在自己的硬盘、共享盘和几个笔记软件里。网页搜索帮不上忙,系统自带的搜索框又只认文件名和少量正文关键词,一旦记不清名字,事情就卡住了。
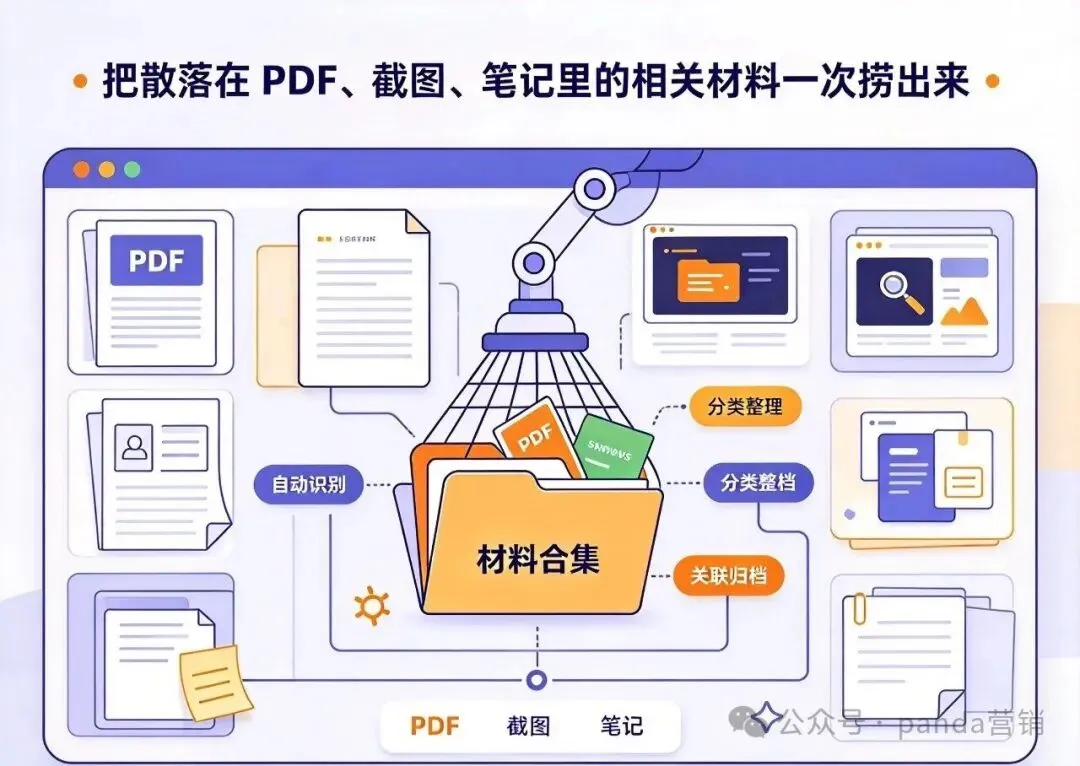
AI本地搜索插件补的是这一段。它的工作方式并不玄:先在你指定的目录里建立索引,把文档正文、图片里的文字、音视频的转写内容读进去,之后允许你用一句描述去找,而不是逼你猜对关键词。像 AIFindTool 这类工具,核心变化是把"检索"从文件名匹配挪到了内容理解上,并且尽量把处理留在本机完成。
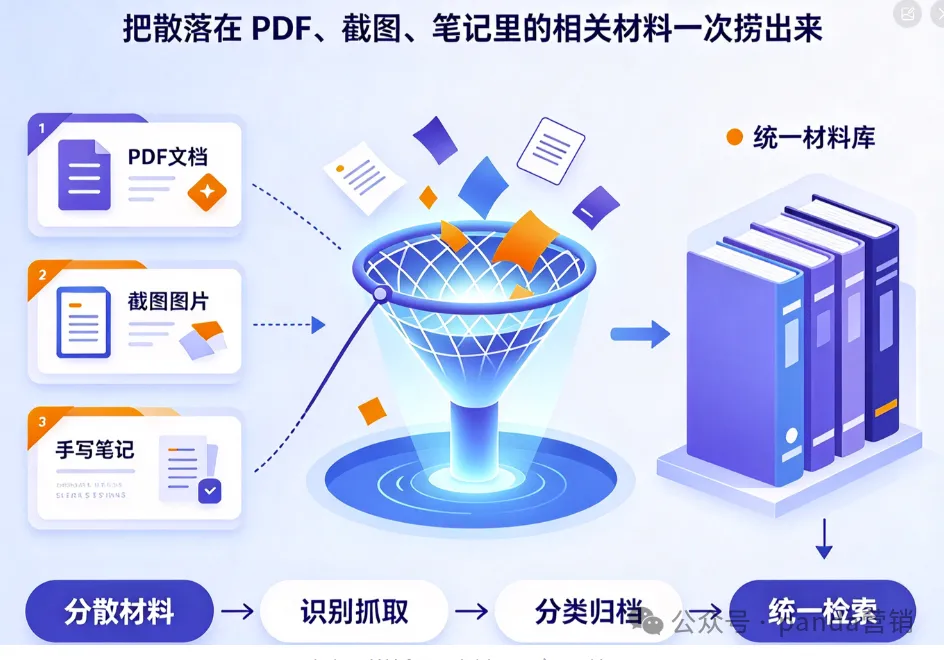
它带来的变化,最先体现在一些很具体的时刻。接手一个搁置两年的旧项目,不用挨个翻文件夹,直接描述"关于渠道分成比例的那次讨论";做年度复盘时,把散落在 PDF、截图、笔记里的相关材料一次捞出来;同事离职后留下一堆目录,靠内容而不是靠命名去判断里面有什么。这些场景的共同点是:线索在脑子里,不在文件名上。传统工具处理不了这种落差,所以人们通常的选择是放弃寻找、重新做一遍。
再往深一层,它松动的是办公的依赖条件。过去我们靠目录结构和命名规范来保证"以后找得到",这套办法成本高、执行差,时间一长就腐化——下载目录里堆满"微信图片_20240315"就是证据。当内容本身可被检索,归档的心理负担会轻一些,人们也更愿意复用旧资料。有些团队因此调整了内部规则:不再执着于完美的文件夹层级,转而要求文档开头写清结论、时间、项目代号和数据来源,因为这些信息现在真的能被搜到。命名从"给人看的标签"变成了"给检索留的线索",这是个不大但真实的转变。
但别把它想得太省事。首次建索引要花时间、占磁盘,范围选大了还会把缓存、备份、临时文件一并捞进结果,反而更吵。语义搜索对"型号、编号、条款号"这类精确字符串并不比关键词更强,两者得混着用。扫描版 PDF 的识别结果需要回到原页核对,尤其是数字、金额和条款表述。更麻烦的是权限与合规:客户资料、未发布内容、合同原件是否允许被索引,数据会不会离开本机,要看具体版本的官方说明,不能凭印象判断。也建议关掉自动重命名、自动移动、自动删除——工具能判断"内容相似",判断不了"这份能不能删"。