ARTICLE · 1370204
处理office文档,为什么特别费积分?
写给每天被 Word、PPT、Excel 、PDF包围的你,把Office办公文件夹变成知识库,可能是你今天花得最值的 10 分钟。
01
引言
我们已经习惯使用各种AI Agent来处理日常办公需求,市面上也有很多好用的办公类Agent产品,如:WorkBuddy,千问办公,豆包办公,Codex,灵犀等等,在处理Office文档的时候,你有没有发现:
积分(TOKEN)消耗特别快 处理需求的时速度很慢 结果答非所问,无法准确地获取信息 ……
02
为什么你的积分消耗得特别快
我们先了解一下AI处理的文件夹中Office文档的流程:
① 猜关键词 → 根据你问的话,猜可能相关的文件名和词
② 盲搜 → 在目录里多轮翻找,试一个又一个关键词
③ 看目录快照 → 逐个文件夹扫,靠文件名筛出“可能相关”的
④ 逐个打开 → 文件名看不出内容,只能打开看
⑤ 现场转换 → 遇到 PPT / Excel / PDF 读不了,先转成文字
⑥ 通读比对 → 把内容读进上下文,判断是不是你要找的那份
⑦ 找漏 / 找重 → 可能漏掉真正在的那份,也可能把原件和副本算成两份
⑧ 作答 → 答完你也不知道它到底找全没有
⑨ 下次再找 → 换个问题→从①重新开始
几个关键问题:
- 定位靠猜
文件名提供不了“内容讲什么”的信息; - 循环靠运气
每次重试都要重放整段上下文,代价线性上涨; - 回答不带证据边界
读到的原文是否完整、是否过期,无从判断。 - 每次提问
每一次提问都在从零开始认识你的文件。
所以你的积分:在这些频繁的“翻找、转换、通读”,全都发生在你提问的现场,而且每问一次,就重来一次。
03
为什么要创建知识库
如何解决上述问题,答案是:把Office文档文件夹创建为知识库,创建知识库本质上是做了一次前置整理:
提前把文件转成好读的纯文字版本,转换在发布时一次做完; 给整库做一份目录(index),一进来就知道有什么、在哪; 给每份内容标好来源和状态,用的时候心里有数。
做完这一步,再提问时流程就变成了:
查一下目录 → 直接读对应的内容 → 回答。
现场不用再转换,不用再翻找,不用再把大段中间文字塞进上下文。
用个生活化的比方:
没有知识库,就像每次做饭都从洗菜、切菜、生火开始;有知识库,就像提前把菜洗好切好、配料摆齐,下锅就能炒。 菜还是那些菜,但你是从“备菜”开始,还是从“开炒”开始,效率差了不止一点。
而且这份“提前备好”的收益是可累积的:整理一次,之后每一次提问都在省。高频使用的资料,用得越多,省得越多。
04
有无知识库逐环节对比
最终的结论,有知识库:
省时间:少了盲搜、逐个打开、现场转换,从“翻半小时”变成“问一句”。
省积分:读得少、绕得少,消耗就少。积分花在真正的提问上,而不是花在“翻文件”上。
更踏实:答案能挂回原始文件,随时可以点回去核对;遇到只提取了文字、图片没进库的情况,AI 会老实告诉你,而不是给你一个看似完整、其实缺东西的答案。
05
如何创建能够与AI无缝协作的知识库
市面上的知识库产品有很多,但真正提供能够与AI Agent协作的知识库很少,推荐工具:
知晓知识库
下载地址:https://md.shuyu.com
一键创建知识库
下载安装完成后,进入首页,在知识库页面中,选择“+新建”,选择文件夹即可一键创建知识库:
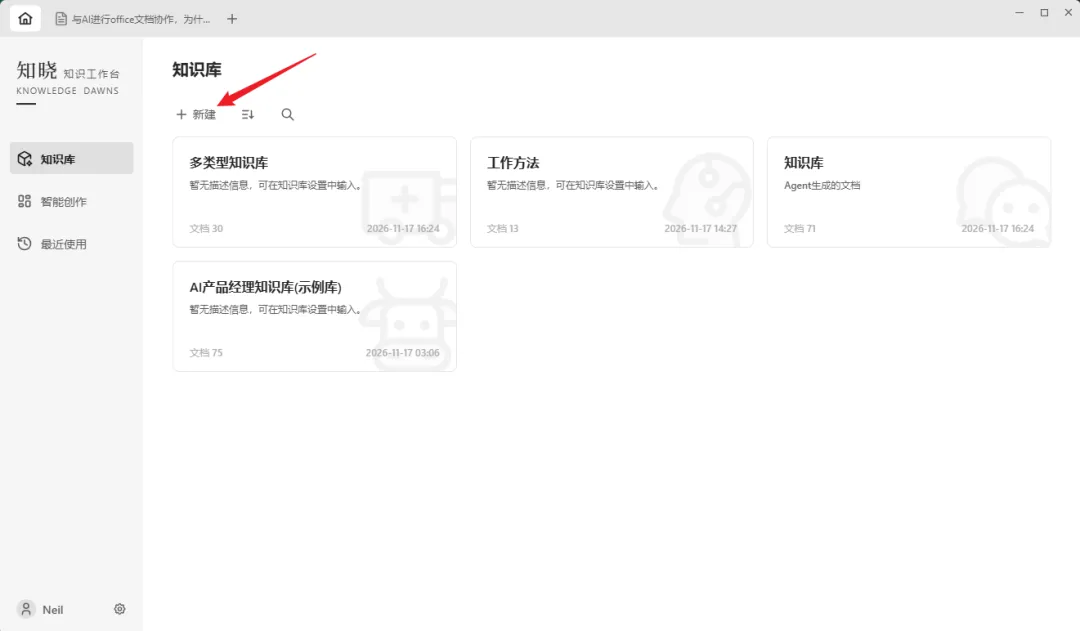
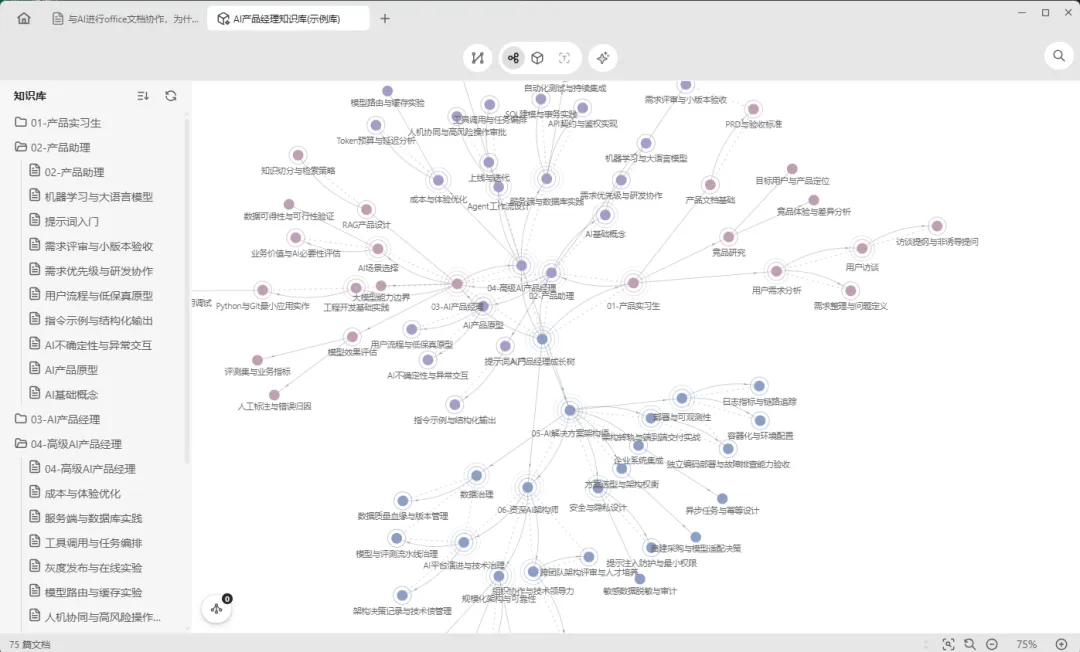
选择文件夹后,会自动处理完成,并构建可视化知识图谱:
创建知识库后还能:
全文搜索 知识库问答 一键生成可编辑的PPT,网页,小红书图文卡片、思维导图、微信公众文章等
创建你的第一个知识库:
知晓知识库
下载地址:https://md.shuyu.com