ARTICLE · 1031913
我用 jev 大模型写了一个暴力文档召回
TypeSafe 的 Jev 是个"只做判断"的模型——你给它一段文本,它不写文章、不做推理链,而是返回带概率的结构化答案。于是我想到一个很暴力的做法:
把所有文档整个丢给模型,让它逐篇判断"这篇跟查询相关吗",按概率排序。
没有分块,没有 embedding,没有向量数据库。就叫它"暴力文档召回"。
它是怎么工作的
每篇文档在插入时先整体打一次分——有没有实质内容、覆盖面多广、好不好读、什么语言。这些是自适应的是/否概率题和等级评分题。
搜索时,把库里所有文档连同查询一起交给模型,每篇文档对应一个判断:
"这篇文档跟用户的查询相关吗?— 从整篇文档的主题和语义判断,不要只看共同词语。"
外加一个判断:"这些文档里有能回答查询的吗?"
返回的就是每篇文档归一化后的概率,直接当排序分用。关键词匹配只作为对照基线。
效果
我插了 16 篇中文文档(历史、科技、文化、生活),实测召回:
每次召回约 400–600ms,判断"有没有答案"的置信度基本都在 0.97 以上。
最直观的是跟关键词匹配对比:搜"怎么拍出背景虚化",关键词几乎全军覆没,"摄影入门"却稳拿 0.94——因为那篇文档里可能一个"虚化"都没有,但它讲的正是景深和光圈。
为什么它敢"暴力"
关键在批处理。文档越多,每个查询的成本不是线性增长的——一次请求能带很多判断,它们并行返回。
有个官方基准:把 13 个问题合并成一次调用,比逐条调用便宜 12.2 倍、快 10 倍,答案完全一致。
所以"暴力"是有底气的:文档整个塞进去、所有判断一次问完,成本依然很低。这也正是为什么它敢不分块——分块是算力不够时的妥协,不是最优解。
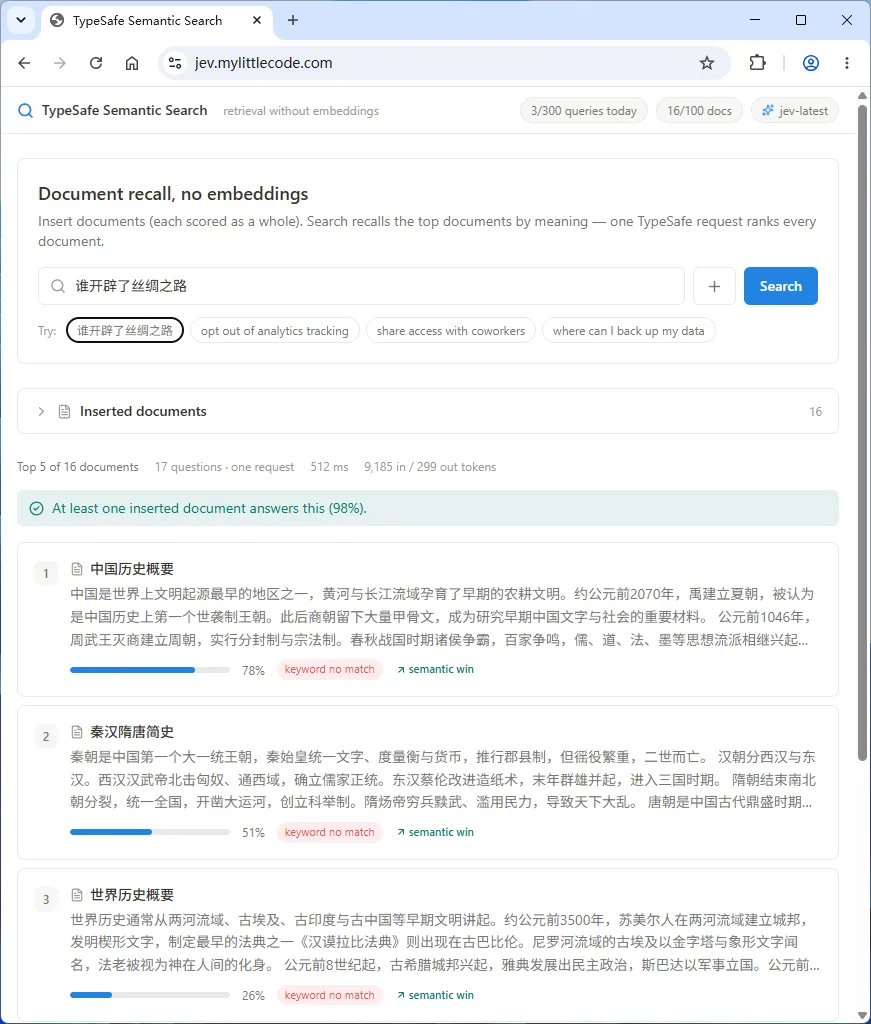
线上跑在 https://jev.mylittlecode.com。
通常我们会把模型当"生成器",让它写文字,再解析输出。但 Jev 这类模型是把判断本身当成 API:输入状态,输出概率。控制流留在程序里,模型只在"需要语义理解"的地方补位。
如果你也想试,入口在这:jev.mylittlecode.com。插几篇文档,搜一句话试试。