ARTICLE · 1044707
官方译介|用 AI Functions 在数仓中直接调用大模型:Top Use Cases
原文标题:Using AI_Functions in Your Data Warehouse: Top Use Cases
原文地址:
https://www.databricks.com/blog/using-aifunctions-your-data-warehouse-top-use-cases
原文发布日期:2026 年 8 月 14 日
原文作者:Srikant Das 、 Ismail Makhlouf
翻译:洞见Databricks(上北智信运营)
导读
在大多数企业里,数据仓库存放结构化数据,非结构化数据则留在数据湖中。这种架构对分析型工作负载来说运转良好——它们大规模消费结构化数据,日复一日地为固定的报表集服务。
然而,AI 工作负载需要不同的输入。AI 模型经常需要解析非结构化数据(如评价、支持工单、PDF),并将其与结构化数据结合,用于训练、构建和服务模型。于是,一个想要对支持工单做情感分析的分析师,不得不把数据行导出到某个外部服务,等待预测结果,再手动将数据行拼回表中。这个过程缓慢、脆弱(schema 一变就崩),还引入了不必要的安全和治理风险。
AI Functions 解决了这个问题:它把 AI 直接带到你的数据身边,而不是把数据搬到独立的 AI 环境中。你只需在标准 SQL 查询中调用模型,整个推理过程都保留在现有 pipeline 和 Unity Catalog 治理范围内。这种架构从根本上改变了你在数据仓库中使用 AI 的方式。
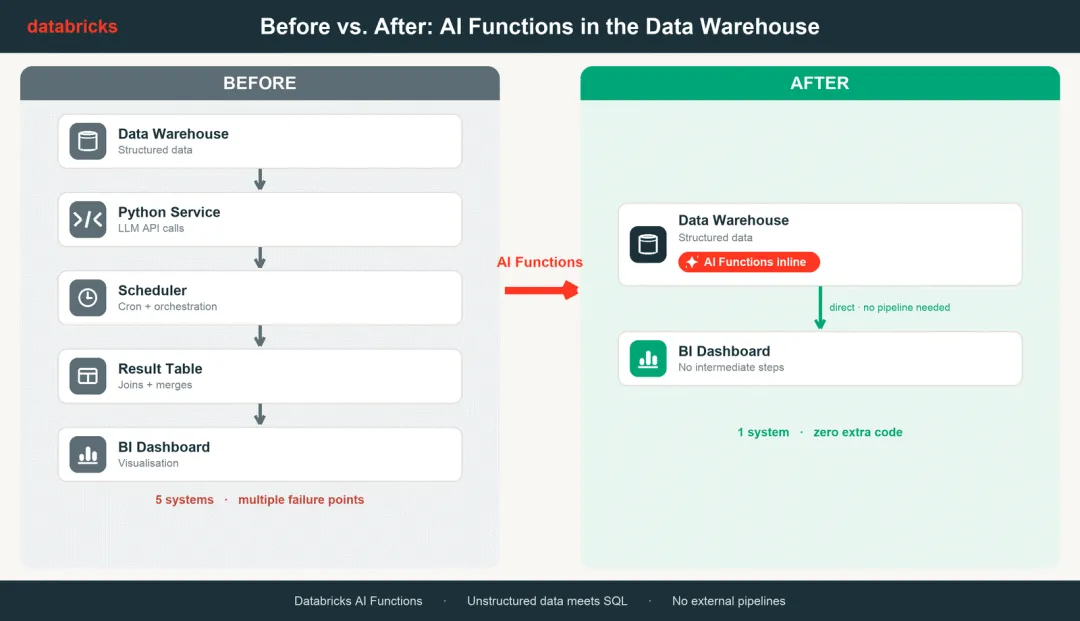
📝 图1|AI Functions 在 Databricks Lakehouse 中直接调用模型,数据无需离开治理边界。
AI Functions 遵循 Unity Catalog 权限体系,数据保持安全和私密。模型只能访问你明确授权的数据。
只要你会写 SELECT,就能用 AI。Databricks 替你管理复杂性——查询规划、并行化和重试——你无需操心集群管理或外部编排。对百万行运行推理和对单行一样简单,同一查询无需重写即可扩展。
消除对账多个仪表盘的复杂性。AI 使用量直接出现在 system.billing.usage 中,与标准 Databricks SQL 仓库费用并列。
以更低的成本获得更好的结果。通过使用任务专用函数——如 ai_classify、ai_extract、ai_translate 和 ai_parse_document——你调用的是为特定任务量身定制的模型,而不是为通用推理过度付费。
你可以在 Databricks 的任何地方使用这些 AI 函数,包括notebooks、Lakeflow Spark Declarative Pipelines 和 Workflow。
本文重点展示如何在 Databricks Lakehouse 中从 SQL 调用这些函数,将数仓中的结构化数据与数仓外的非结构化数据(或通过 GenAI 函数自行生成的产物)结合。
使用场景 1:
文档智能——从原始文件到结构化行
ai_parse_document 充当摄取桥梁,将 PDF 或图像等原始二进制文件内容转换为可读文本。解析完成后,ai_extract 负责细粒度地提取特定键和值。这种组合方法消除了脆弱的自定义 OCR pipeline 或第三方解析服务——后者常常在 schema 变更时崩溃。
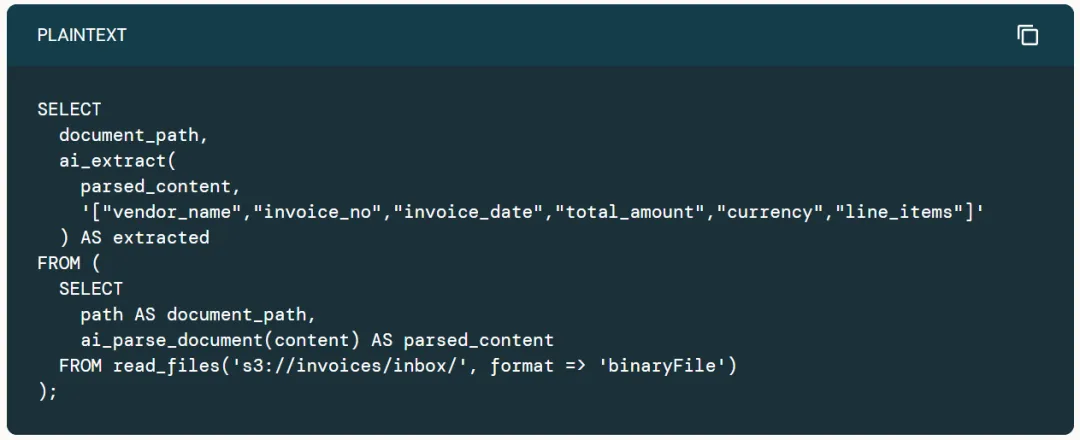
在这个用例中,我们将 ai_parse_document 指向一个包含发票的 Databricks volume。发票被解析后,AI parse document 以 JSON 格式产出结果,然后传递给 ai_extract 函数,在其中定义我们想要从发票中提取的实体。最终结果是一个结构化表,包含我们从发票中提取的字段。
血缘关系现在从原始 PDF 一直延伸到提取出的行,全部在单个查询计划内完成。人们过去手工搭建的桥梁——Python OCR 服务、LLM 调用、JSON 扁平化步骤——全部坍缩进了这一条查询。
SELECT
document_path,
ai_extract(
parsed_content,
'["vendor_name","invoice_no","invoice_date","total_amount","currency","line_items"]'
) AS extracted
FROM (
SELECT
path AS document_path,
ai_parse_document(content) AS parsed_content
FROM read_files('s3://invoices/inbox/', format => 'binaryFile')
);
📓Demo notebook:Document intelligence
使用场景 2:
客户反馈情感分析
ai_classify 函数执行零样本分类(zero-shot classification),将自由文本反馈映射到一组用户自定义标签中,无需模型训练。这个过程将混乱的非结构化文本转化为受治理、可查询的列,使情感和主题数据立即可用于 BI 仪表盘和高管报表。
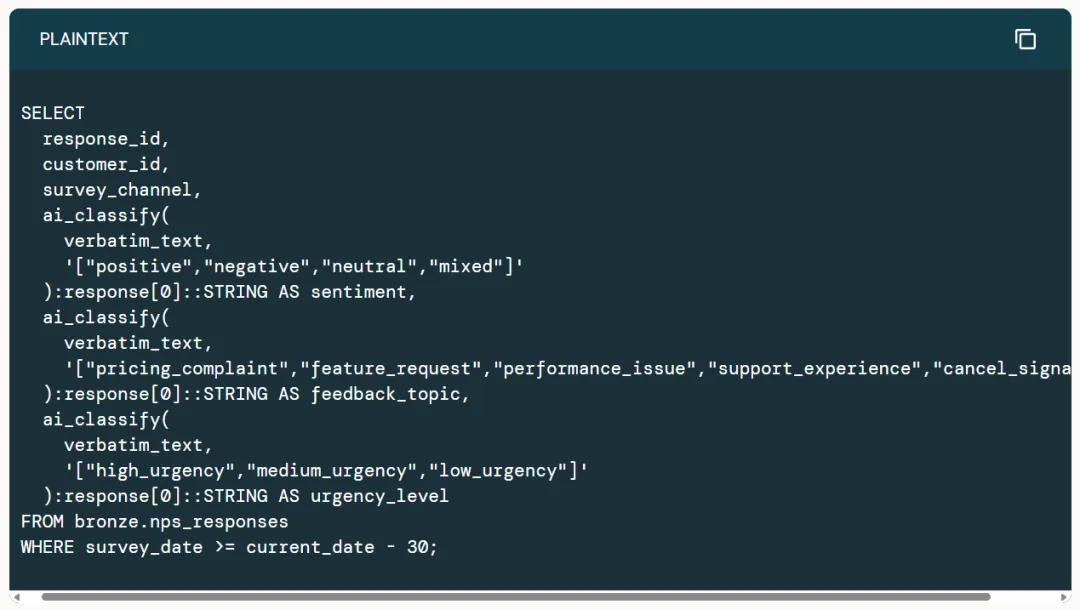
在这个示例中,我们想将 bronze.nps_responses 表中的客户评价分类为 positive、negative、neutral 和 mixed。
SELECT
response_id,
customer_id,
survey_channel,
ai_classify(
verbatim_text,
'["positive","negative","neutral","mixed"]'
):response[0]::STRING AS sentiment,
ai_classify(
verbatim_text,
'["pricing_complaint","feature_request","performance_issue","support_experience","cancel_signal"]'
):response[0]::STRING AS feedback_topic,
ai_classify(
verbatim_text,
'["high_urgency","medium_urgency","low_urgency"]'
):response[0]::STRING AS urgency_level
FROM bronze.nps_responses
WHERE survey_date >= current_date - 30;
📓Demo notebook:Sentiment analysis
使用场景 3:
多语言数据内联翻译
借助 ai_translate,你可以在查询层直接将多语言数据规范化为单一目标语言。这避免了数据孤岛和碎片化,让所有下游分析(包括分类和提取)能够同时在整个全球数据集上运行,而不是只处理英文切片。
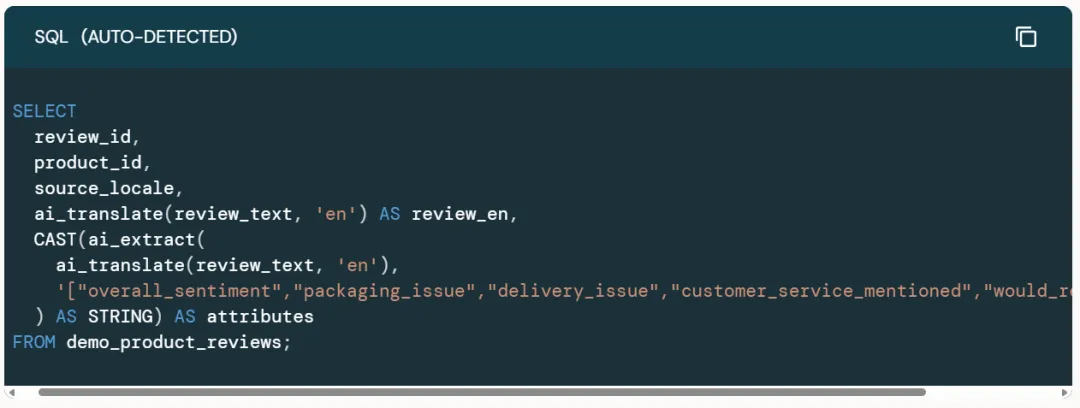
在这个示例中,我们从不同的客户评价中提取情感,然后将它们翻译成英文。
SELECT
review_id,
product_id,
source_locale,
ai_translate(review_text, 'en') AS review_en,
CAST(ai_extract(
ai_translate(review_text, 'en'),
'["overall_sentiment","packaging_issue","delivery_issue","customer_service_mentioned","would_repurchase"]'
) AS STRING) AS attributes
FROM demo_product_reviews;
📓Demo notebook:
Translation and normalization
使用场景 4:
大规模分类与智能路由
聚焦运营效率,ai_classify 将支持工单或通话记录等自由格式输入转换为可操作的类别。通过在摄取点识别传入反馈的意图和紧急程度,它实现了向适当团队或自动响应系统的自动化智能路由。
在这个用例中,我们从表中摄取不同的支持工单,然后使用 ai_classify 确定工单的用户意图和紧急程度。
SELECT
ticket_id,
customer_segment,
ai_classify(
ticket_body,
'["billing","outage","product_question","cancel_request","praise"]'
):response[0]::STRING AS intent,
ai_classify(
ticket_body,
'["high","medium","low"]'
):response[0]::STRING AS urgency
FROM bronze.support_tickets;
📓Demo notebook:Classification and routing
使用场景 5:
销售通话结构化提取
ai_extract 函数专为从长内容(如销售通话记录)中挖掘半结构化信息而设计,将叙述性文本转换为离散的结构化字段。它将定性信息直接送入 BI 工具,有效地将口头对话转化为可查询的指标(如交易阶段和风险标记),提供了巨大价值。
在这个用例中,我们挖掘一段长记录,识别下一步行动、交易阶段、风险标记和风险原因,以便销售人员对产生该记录会议的成果采取行动。
SELECT
call_id,
account_id,
call_date,
ai_extract(
transcript,
'["next_step","owner","deal_stage","risk_flag","risk_reason"]'
) AS facts
FROM gold.call_transcripts
WHERE call_date >= current_date - 7;
📓Demo notebook:Sales-call extraction
使用场景 6:
用 ai_query 进行生成式起草
ai_query 是最通用的函数,也是其他函数的基础:它允许你向任何你有权访问的 Databricks 托管基础模型(Foundation Model)服务端点发送 prompt,并为每一行返回模型的回答。
在这个用例中,我们可以使用 ai_query 为虚构表 gold.renewal_signals 中的每个客户账户起草续约外联邮件,该表显示了哪些账户已准备好续约。
SELECT
account_id,
account_name,
account_owner_email,
ai_query(
'databricks-gpt-oss-120b',
CONCAT(
'You are drafting a renewal-outreach email. Return a JSON object with exactly three fields: subject, body, suggested_send_date. ',
'subject: one short subject line under 70 characters, no greeting. ',
'body: the email body, 4 to 8 sentences, addressed to the account owner by first name, referencing the open risks and the recent engagement. ',
'suggested_send_date: a date string in YYYY-MM-DD format within the next 14 days; pick sooner dates when days_to_renewal is short or open_risk_flags are active. ',
'Tone: professional, concise, no marketing fluff. ',
'Account context: name=', account_name,
', mrr_usd=', mrr_usd,
', days_to_renewal=', days_to_renewal,
', open_risk_flags=', open_risk_flags,
', last_engagement_summary=', last_engagement_summary
),
responseFormat => '{"type":"json_schema","json_schema":{"name":"renewal_outreach_draft","schema":{"type":"object","properties":{"subject":{"type":"string"},"body":{"type":"string"},"suggested_send_date":{"type":"string"}},"required":["subject","body","suggested_send_date"]},"strict":true}}'
) AS outreach_json
FROM gold.renewal_signals
WHERE days_to_renewal <= 60;
因为你编写 prompt,它可以做任何模型能做的事——这就是为什么它能处理那些更专用的函数覆盖不到的场景。
📓Demo notebook:Generative drafting
建议 | 说明 |
第一天就标记作业 (Tag jobs on day one) | 这将允许你将 AI Functions 的成本归因到正确的作业 |
优先尝试任务专用函数 | 只有当 ai_classify、ai_extract、ai_parse_document 或 ai_translate 都不适用时,才使用 ai_query |
请求结构化输出 | 对于 ai_query,使用 responseFormat 获取结构化输出。如果传入 DDL STRUCT schema,你会得到类型化字段而非原始字符串;json-schema/json_object 格式仍返回 JSON 字符串 |
慎重选择模型 | 每个基础模型都有权衡(包括成本、性能和支持的输入格式)。确保你针对每个用例有意选择模型 |
先采样再扩展 | 至少先运行 10,000 行,阅读输出,然后再运行其余部分。成本与准确性的权衡因每个用例而异 |
将 prompt 视为代码 | 对它们进行版本控制,在 pull request 中审查,添加注释。在这个工作流中,prompt 是一种包含业务逻辑的转换 |
贯穿所有六个场景的主线是相同的:AI 运行在数仓的同一位置——一个平台、一套治理模型、一张账单、一组 pipeline。
现有 SQL ETL 中的任何一行都可以接上 AI 步骤,而无需你搭建托管它的系统;过去在旁支翻译、评分或分类数据的每个 Python 脚本,都成为一行替换的候选。
所以,从一个列开始。选取当前服务最脆弱的工作负载,把它改写为 SELECT,在 10,000 行上运行,然后看看返回了什么。一次快速的 sprint 之后,你就会知道它是否合适——而且你将不再为把数据运出去使用而支付额外的开销。
每个笔记本都附带内联示例数据、逐步 SQL 和预期输出。
⚠️编者注:原文末尾列出的用例与笔记本对应关系存在顺序笔误(将 Generative drafting 列为 Use case 1),以下按正确顺序整理:
# | 用例 | Demo Notebook |
1 | 文档智能 | Document intelligence |
2 | 情感分析 | Sentiment analysis |
3 | 翻译与规范化 | Translation and normalization |
4 | 分类与路由 | Classification and routing |
5 | 销售通话提取 | Sales-call extraction |
6 | 生成式起草 | Generative drafting |
🔗All notebooks:访问 Databricks 官网获取全部笔记本
洞见编者注
这篇文章传递了一个非常明确的信号:AI 正在从"外围服务"变成"数仓内的一等公民"。
SQL 即 AI 接口:对于广大数据分析师和工程师来说,SQL 是他们最熟悉的语言。AI Functions 把大模型的推理能力封装成 SQL 函数,意味着不需要学习 Python、不需要搭建 API 服务、不需要管理模型部署,一行 SELECT 就能让 AI 处理数据。
治理不妥协:所有 AI 推理都在 Unity Catalog 的权限体系下运行,数据不出湖仓。这解决了企业采用 AI 时最大的顾虑——数据安全与合规。
成本透明:AI 使用量直接计入 system.billing.usage,与 SQL 仓库费用统一,避免了多套账单、多套系统的对账噩梦。
专用函数 vs 通用函数:Databricks 的设计思路很清晰——能用专用函数(ai_classify 等)就别用通用 ai_query,因为专用函数在成本和质量上更优。这与 Unity Gateway 中 Smart Routing 的思路一脉相承:用对的模型做对的事。
与 Unity Gateway 的协同:AI Functions 解决了"在数仓内调用 AI"的问题,而 Unity Gateway 解决了"跨 agents、models、tools 统一治理 AI 流量"的问题。两者结合,企业可以在数仓内用 SQL 原生调用 AI,同时在全局层面通过 Unity Gateway 管控成本、安全和访问策略——数据面与控制面各司其职。
落地建议:如果你正在评估是否引入这套方案,建议先找一个"当前最痛"的 ETL 步骤(比如手工 OCR + 人工校验发票),用 ai_parse_document + ai_extract 改写,跑 1 万行看看效果和成本。Databricks 官方文档中提供了每个函数的详细参数和计费说明,生产前请务必查阅。
版权声明:本文译自 Databricks 官方博客,原文版权归 Databricks 所有。翻译权归洞见Databricks(上北智信运营)所有,转载请注明出处并保留此声明。
END
【本文由洞见Databricks 编辑呈现】
洞见Databricks 由上北智信运营,聚焦 Databricks / Lakehouse / Spark 在国内的落地实践与中文技术生态。
🤝 商务合作 / 技术交流
扫码添加企微客服,或见公众号菜单栏「联系我们」