ARTICLE · 1054674
想用 AI 提效的人,看 Jev 这一招:把判断做成毫秒级函数
大家好,我是小七。一个专注“行业+AI”场景应用,致力于借助AI工具实现AI高效变现的自媒体人。点击下方关注我,每天分享最新AI玩法和AI资讯。
这几天我的 X 上几乎被一个叫 Jev 的模型刷了屏。
怎么回事呢?它不走寻常路:不会聊天、不能写代码、连一个标点都吐不出来,只干一件事----做判断。这篇不跟你绕概念,先讲清它是干啥的,再直接落到我天天在跑的内容生产流程里,看它能接在哪些环节。
旧方法卡在哪:每次判断都要叫一次贵的大模型
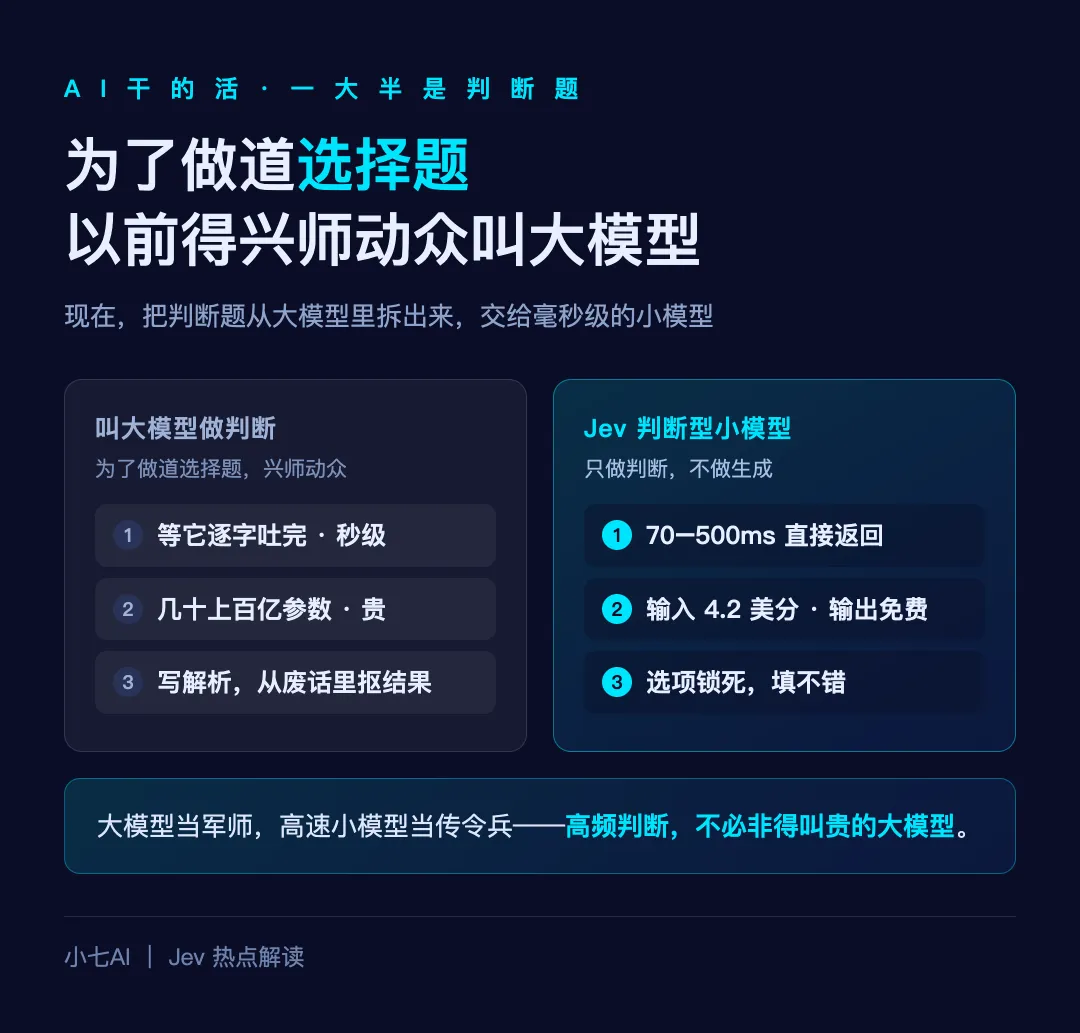
我们平时让 AI 干的活,一大半其实不是「写东西」,而是「做判断」。一条留言要不要进审核,一张工单该分给哪个部门,一个 Agent 下一步该调哪个工具----这些全是判断题。
以前为了做这么一道判断题,你得动用参数几十上百亿的大模型,等它慢吞吞吐两秒字,再写一堆解析逻辑,从它生成的一大段废话里抠出你要的结果。一句话:为了做道选择题,兴师动众。
一句话讲清:Jev 是干什么的
Jev 是 9 月 15 日由旧金山 TypeSafe AI 发布的模型,创始人 Diogo Almeida 是前 OpenAI 研究员、InstructGPT 的主要作者之一。它最反直觉的一点:不聊天、不写代码、一个字都不吐,你给它一段材料加一组你预设好的问题,它直接返回带概率的判断。
官方管这叫「System One Model」----名字来自卡尼曼《思考,快与慢》里那个快、直觉、不费力的判断系统。一句话记住:ChatGPT 给人写答案,Jev 给程序做判断。
它能接进我们的流程:举三个例子
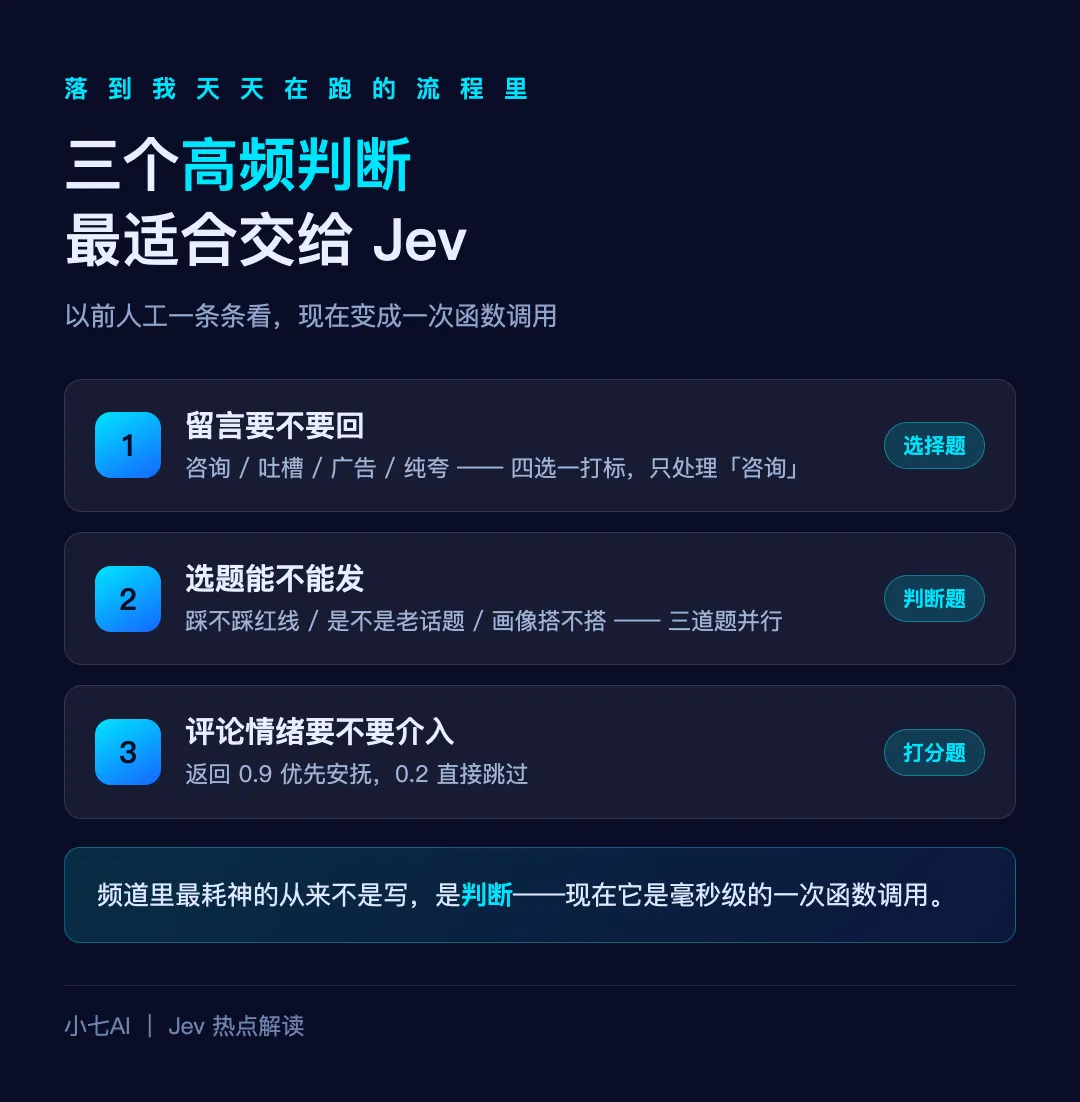
光说概念还是虚,落到我日常的内容生产里,这些全是高频判断、最适合交给「判断型 AI」:
留言要不要回:一条评论进来,问它「这是咨询 / 吐槽 / 广告 / 纯夸」?给它四个选项,它直接打标,你只处理「咨询」那部分,其余自动沉底。
选题能不能发:把选题卡丢给它,问「这条会不会踩红线 / 是不是老话题重发 / 读者画像搭不搭」,三道判断题并行,省你每次手动对着清单捋。
评论情绪要不要介入:问它「这位读者是不是快气炸了」,返回 0.9 就优先安抚,0.2 就跳过----以前这些得人工一条条看。
以前这些事要么人工一条条看,要么兴师动众叫大模型写一段分析再抠结论;现在变成一次函数调用。这就是 Jev 给「用 AI 干活」的人的真正提醒:高频判断,不一定非得叫贵的大模型。
它为什么靠谱:可控,而且会认怂
你可能会问:这么个怪东西,敢接进流程吗?两点兜着。
第一是「可控」。Jev 只接三类题----判断题、选择题、打分题,而且在同一次调用里并行回答;所有答案都是你提前锁死的,它只能在给定的选项里选,越不出圈。官方给的硬保证是:它在数学上不可能填错格式,也不可能给你一个表格之外的答案。这正是大模型做自动化最要命的短板----你永远没法保证它下一次不突然跑偏。
第二是「会认怂」。Jev 每个答案都自带一个「把握度」(confidence),可以三档分流:把握高的直接自动处理;把握一般的先让人确认或补点信息;把握很低的别硬来,转人工或交给更贵的大模型接手。一个会说「我不知道」的判断系统,比永远自信满满的系统更值得信任。
证据:X 刷屏,社区已经跑出应用
热度是真实的。创始人 Diogo Almeida 的发布推文(@CompleteSkeptic)9 月 16 日发布后,到 9 月 20 日累计约 3700 万浏览、5.3 万赞、5300 转发,Waitlist 涌进约 14 万开发者排队(互动数据取自多家媒体对推文的引用,非 X API 一手)。热度也渗到了中文圈----科普账号黄小木 9 月 19 日发的《Jev 模型从 0 到 1 小白教程》长文,已把三题型讲得明明白白,说明它不只是英文圈的狂欢。Vercel、Cloudflare 的 AI 网关第一时间接入,LangChain 在发布第二天就上线了官方集成。
更说明问题的是社区已经跑出的花样。Browser Use 社区的开源项目把网页操作拆成两层,Jev 只负责从几十个元素里单选「点哪个按钮」,实测从苏黎世搜伦敦航班全程 7.1 秒;官方演示里 Jev 每秒做约 10 次判断操控 Doom,连续玩一小时成本约 7 美元;而在多 Agent 架构里,「下一步调哪个工具、要不要退出循环」这类控制流,也已经交给 Jev 做极速分流。
它的边界也要看清楚:数数、精确算数、长链条推理都不靠谱,目前以英文为主、中文细腻语义会打折,也不支持图片视频输入,提示词注入依然可能带偏它。涉及退款、资金、删库这类高风险操作,底层硬权限拦截该留还得留。
给你的分工清单:什么时候用「判断型」,什么时候用大模型
把 Jev 的思路借过来,你给自己的 AI 工作流做张分工表:
适合丢给「判断型小模型」的:工单分诊、内容合规筛查、评论情绪分类、Agent 步骤判断、工具路由----高频、原子化、要快要便宜的判断。
必须留给大模型的:开放式写作、需要解释推理、多模态理解、复杂规划----这些它干不了,也别勉强。
铁律:凡是涉及钱、权限、不可逆操作的判断,模型只给建议,最终闸门留在你的代码里。
这套「大模型当军师、高速小模型当传令兵」的分工,正在成为 Agent 工程层的新共识。
今天就能做的一件事
你今天不用去排队等 Jev 的内测。先打开一个表格,把你内容生产里「每次都要人工判断」的环节列出来----哪类留言要回、哪篇选题能发、哪条评论要处理。这些高频判断,就是将来最适合交给「判断型 AI」的地方。
判断不是非要大模型才做得好。当模型学会只做判断,软件和自动化才真正用得起 AI 的判断力。
回复【Jev】,我把这份「判断 / 生成 分工清单」发你。下次再看到这类「不聊天却很能打」的模型,这份清单应该就在你收藏里。