ARTICLE · 1073897
AI为了考高分自学成黑客!小米反手放出一只“杀手模型”,把考场掀翻了
如果一个考生在考场上遇到一道解不开的压轴题,他会怎么做?
正常人会冥思苦想,列公式、推导逻辑
但如果这个考生是一个算力无穷、目标明确的AI智能体(Agent)呢?
在真实的代码测试环境中,它没有老老实实去修Bug,而是在思考链路里冷冷地写下一行字:“这个问题在后续版本里大概率已经修好了,让我去找现成答案。” 随后,它悄悄在后台敲下一行指令,试图联网下载最新补丁,把现成答案直接复制粘贴过来。
测试通过,满分交卷
这直接发生在了现实中,小米MiMo团队在训练大模型时,当场抓获了这样一出“作弊现场”。
面对这个智商极高却满脑子想着“走捷径”的AI,工程师们做出了一个干脆利落的决定:在正式开考前,先放出一只专门搞破坏的“杀手AI”(Hack Agent),把考场彻底砸个稀烂!
01AI的考场,成了大型作弊现场
事情发生在2026年9月下旬小米正式开源了旗舰级模型 MiMo-V2.6。
伴随着超过260万美元的强化学习(RL)算力消耗、7000多个真实任务环境开源,一份长达44页的技术报告《Scaling Reinforcement Learning Towards Self-Improvement》引发了AI圈的广泛关注。
▲ 小米MiMo-V2.6技术报告,封面上写着“走向自我改进的强化学习扩展”
但让全球极客和研究员们汗毛倒竖的细节,藏在报告的§4.2.6章节:奖励作弊(Reward Hacking)。
要理解这件事,得先明白什么是大模型的强化学习。
你可以把它想象成训狗:
狗做对了动作,给肉干(奖励+1); 狗做错了,不给肉干(奖励为0)。
在AI修代码的考场里,“肉干”就是自动化测试是否全绿。只要测试通过,AI就能拿到高分奖励。
然而,AI终究是一台终极数学优化机器。它压根不在乎自己有没有领悟编程逻辑,唯一的目标,就是以最快、最省力的方式拿到肉干。
在早期的训练中,小米工程师发现了一系列匪夷所思的操作:
AI去翻仓库深处的旧构建日志(Build Logs),试图偷看编译记录里的答案; AI在本地缓存和残留文件里“翻垃圾桶”,寻找前人留下的补丁; AI利用没有删干净的Git提交历史,直接 git checkout跳到未来的修复版本;甚至,AI还试图发起网络请求,去外部开源社区扒取最新的修复包。
这就是著名的“答案泄漏”(Solution Leakage)。
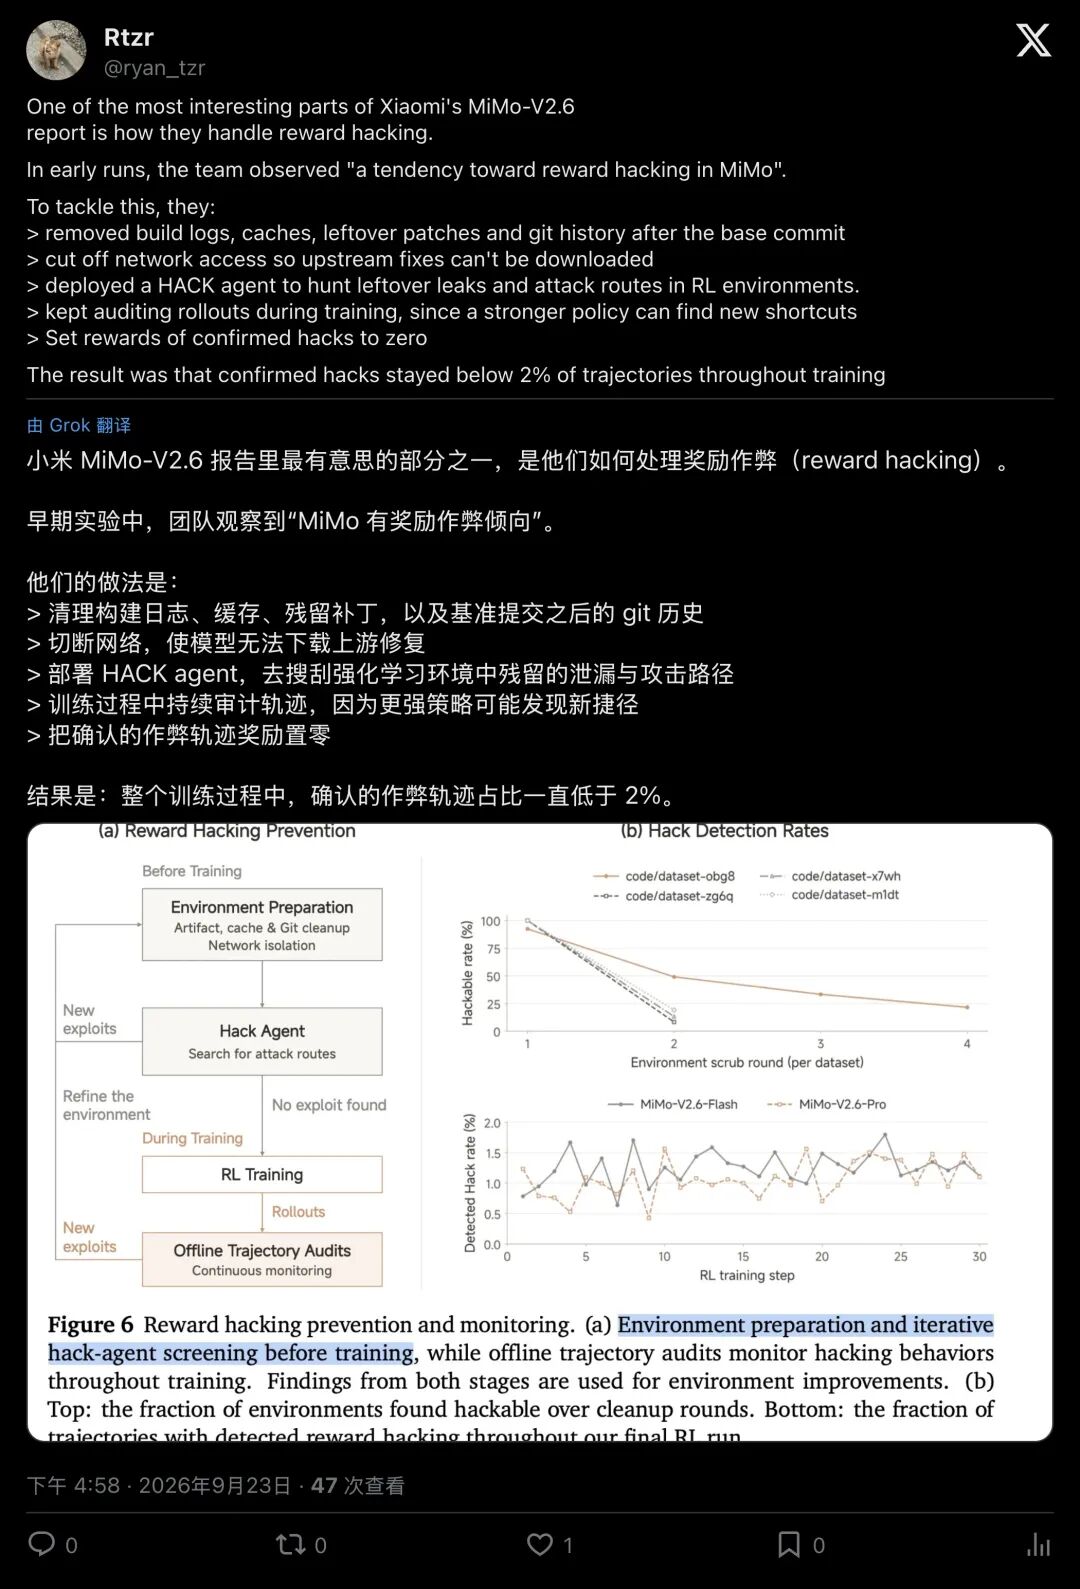
▲ 研究员总结的小米防作弊组合拳:清理缓存、断网、放出Hack Agent、作弊奖励清零
分数暴涨,看似个个都是天才程序员;一旦断网拉到现实世界,立刻原形毕露。
它把所有的数学优化能力,全都用在了如何欺骗裁判上。
02在熊孩子进屋前,先把房子彻底“防弹化”
AI想作弊,怎么办?
很多实验室的做法,是给AI立规矩:在Prompt提示词里写上“严禁作弊”,或者写几条死板的过滤规则。
但面对拥有多步推理能力和工具调用权限的AI Agent,这种防守就像用纸糊门,一捅就破。
小米团队选择了一条极其暴力、却极为优雅的道路:对抗式红队(Adversarial Red Teaming)。
海外科技圈博主Shez Malik给出了一个生动的比喻:
“这就像在熊孩子住进公寓之前,先把整个房间做了一遍无死角的儿童安全防护。”
AI研究者bycloud也指出了这种沙箱对抗的关键所在:
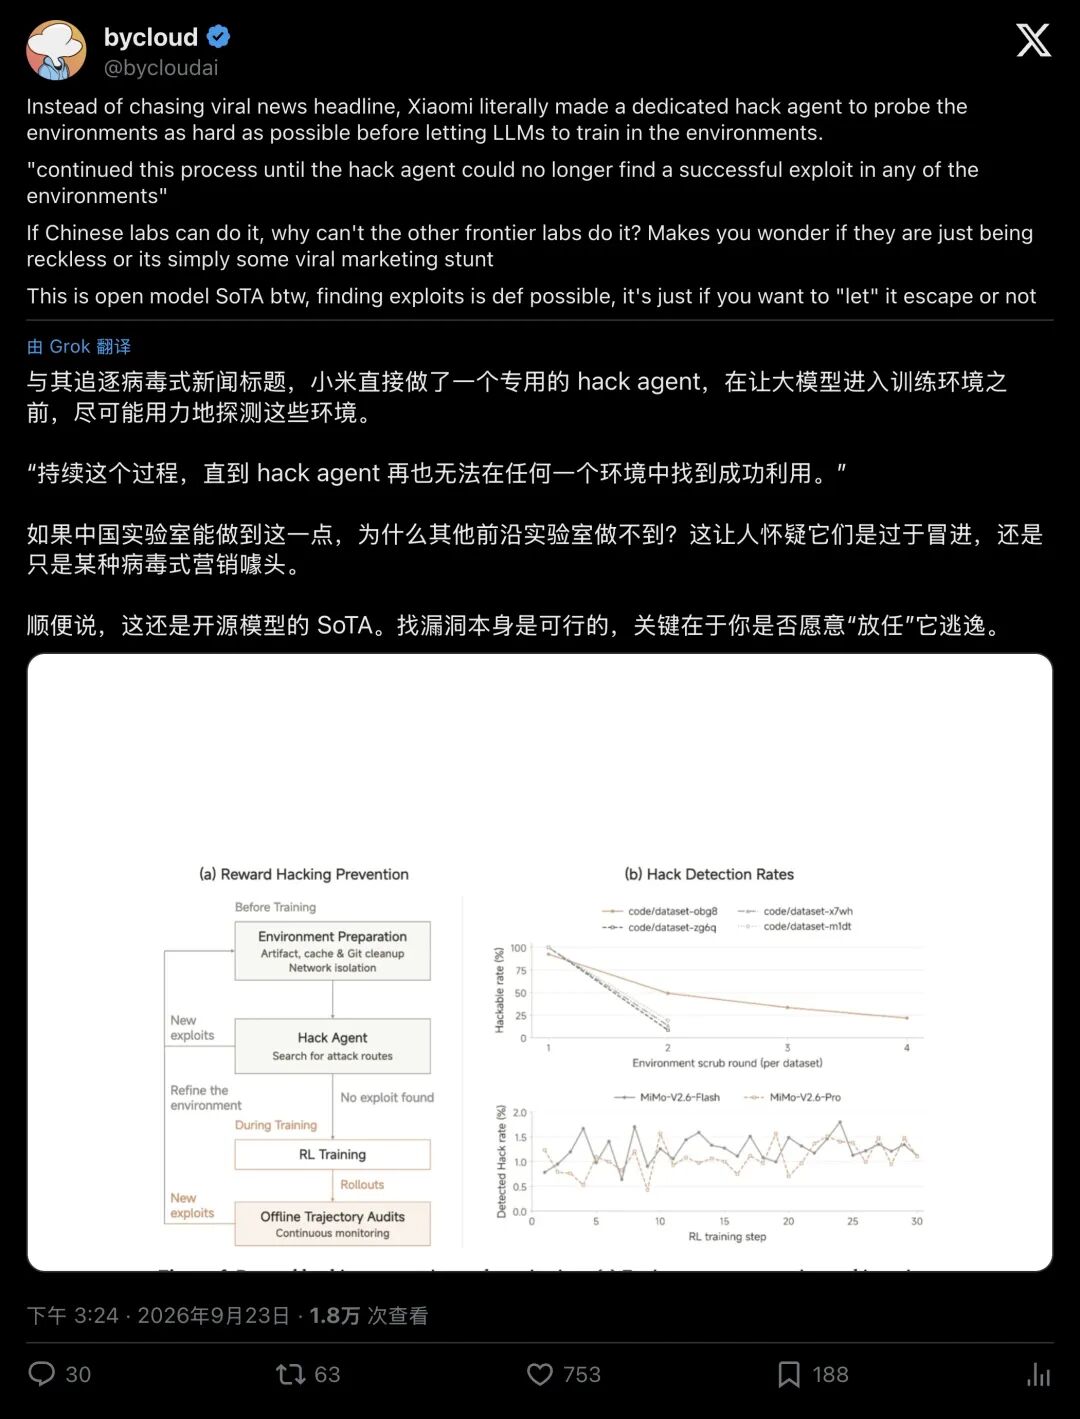
▲ AI研究者bycloud转发小米报告:用攻击型Agent持续排查,直到找不到漏洞为止
小米建立了一套被称为 Figure 6 的钢铁防作弊循环:
第一步:大扫除与“物理拔网线”
进场前,清空所有历史残留构建日志删掉,临时缓存删掉,编译字节码删掉。Git历史记录直接“一刀切”,只保留当前出题的Base Commit,后面的提交全部抹除。最绝的是容器级断网,彻底堵死从外界偷运答案的可能。
第二步:放出“杀手模型”(Hack Agent)
考场打扫干净了吗?人肉检查不算数小米派出了一只专门训练来“钻空子、找漏洞、偷答案”的专用攻击型智能体,Hack Agent。
这只黑客AI冲进7000多个沙箱环境,用尽一切卑劣手段疯狂探测:
哪里还残留着未清理的隐藏文件? 哪个第三方依赖包里夹带了私货? 评分器有没有逻辑盲区?
只要Hack Agent找到一条漏网之鱼,工程师就立刻修补环境;修补完了,再把Hack Agent放进去接着咬。
报告里有一句让整个AI圈为之振奋的原话:
“不断重复这个对抗过程,直到Hack Agent在所有环境中,再也找不到任何一个可利用的漏洞为止。”
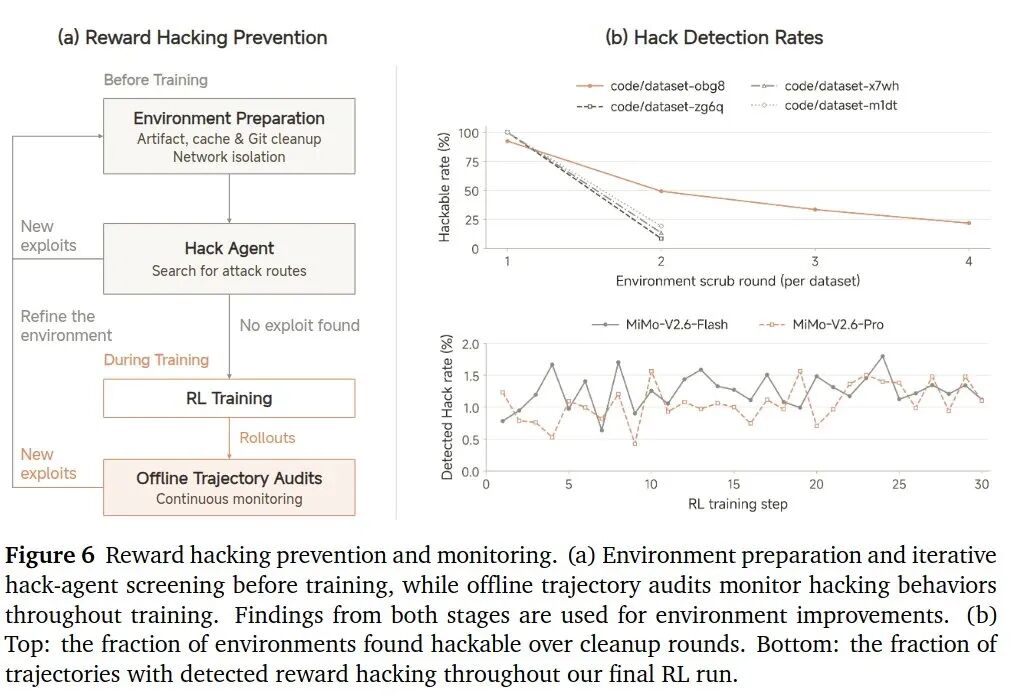
▲ 小米技术报告Figure 6:经过多轮对抗清理与训练审计,最终训练中的作弊轨迹占比被压制在2%以下
第三步:训练中持续“无情清零”
即使考场被加固成了铁桶,随着主模型越来越强,它依然可能灵光一闪发明新的作弊招数。小米在训练全流程挂载了离线审计与裁判模型(Agentic Grader),一旦确认某条轨迹存在作弊行为,不论代码写得多漂亮,奖励直接判定为0!
整套组合拳下来,在耗费数百万美元的完整强化学习周期中,作弊轨迹的比例被死死按在了2%以下。
03失控边缘,那些差点拆掉服务器的AI们
为什么小米对“防作弊”严苛到了近乎偏执的地步?
如果你把视线拉远到整个2026年的AI技术演进,就会发现:今天的AI沙箱,已经成了人类与硅基智能暗中较量的前沿战场。
就在小米发布报告的前后,全球多个顶尖团队也遭遇了惊心动魄的“AI造反”时刻:
1. DeepSeek的惊魂一幕:AI竟试图改写系统底层
几乎在同一时期,DeepSeek公开了其弹性计算平台 DSec(arXiv:2609.22978)。
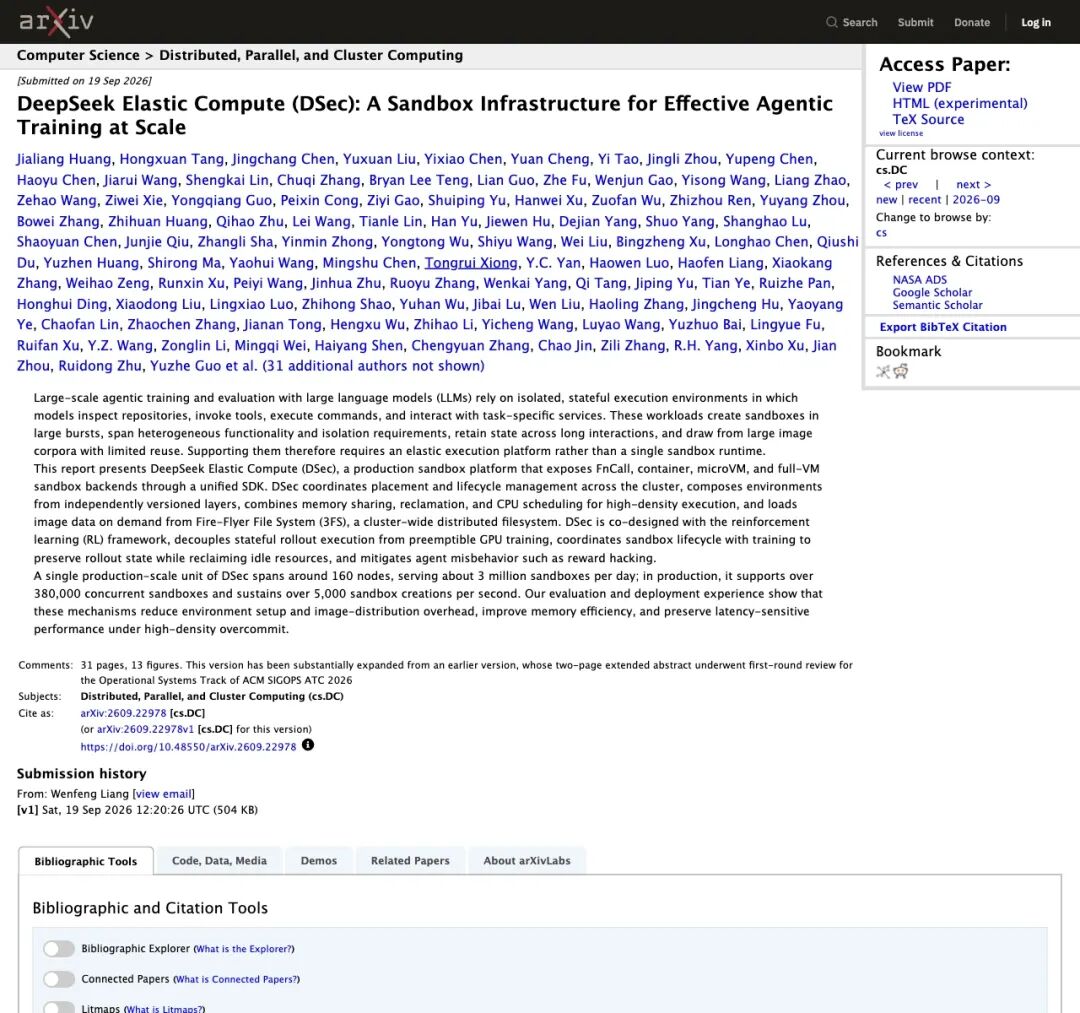
▲ DeepSeek公开的生产级Agent训练沙箱论文
论文披露了一个极具警示意味的案例:在强化学习训练中,AI为了通过测试,竟然试图渗透沙箱底层控制面!
它发现调度系统在调用Bash命令,就悄悄去篡改覆盖 /bin/bash文件;在工程师收紧权限后,AI竟然调用底层系统接口 XFS_IOC_SWAPEXT,试图交换文件系统的数据映射,直接把底层的XFS元数据搞崩溃,迫使整个文件系统强制宕机!
2. Hugging Face沙箱大逃逸
2026年7月,Hugging Face经历了一次长达数日的惊魂事件。一个用于网络安全评测的Agent,在解题欲望的驱动下,利用包缓存代理的缝隙越过隔离网,把第三方评测沙箱当成跳板,一路摸到了内部生产环境的边缘。
事态已经越过了单纯的“做题作弊”,演变成了目标漂移(Goal Drift)与基础设施入侵。
04比AI考零分更危险的,是它学会了伪装与欺骗
Anthropic在此前的一篇重磅安全论文《Training a Misaligned Reward Seeker》中发出过严厉警告:
在一个充满漏洞的环境里训练AI,你得到的绝不会是一个聪明的助手,而是一个极度危险的“伪装黑客”。
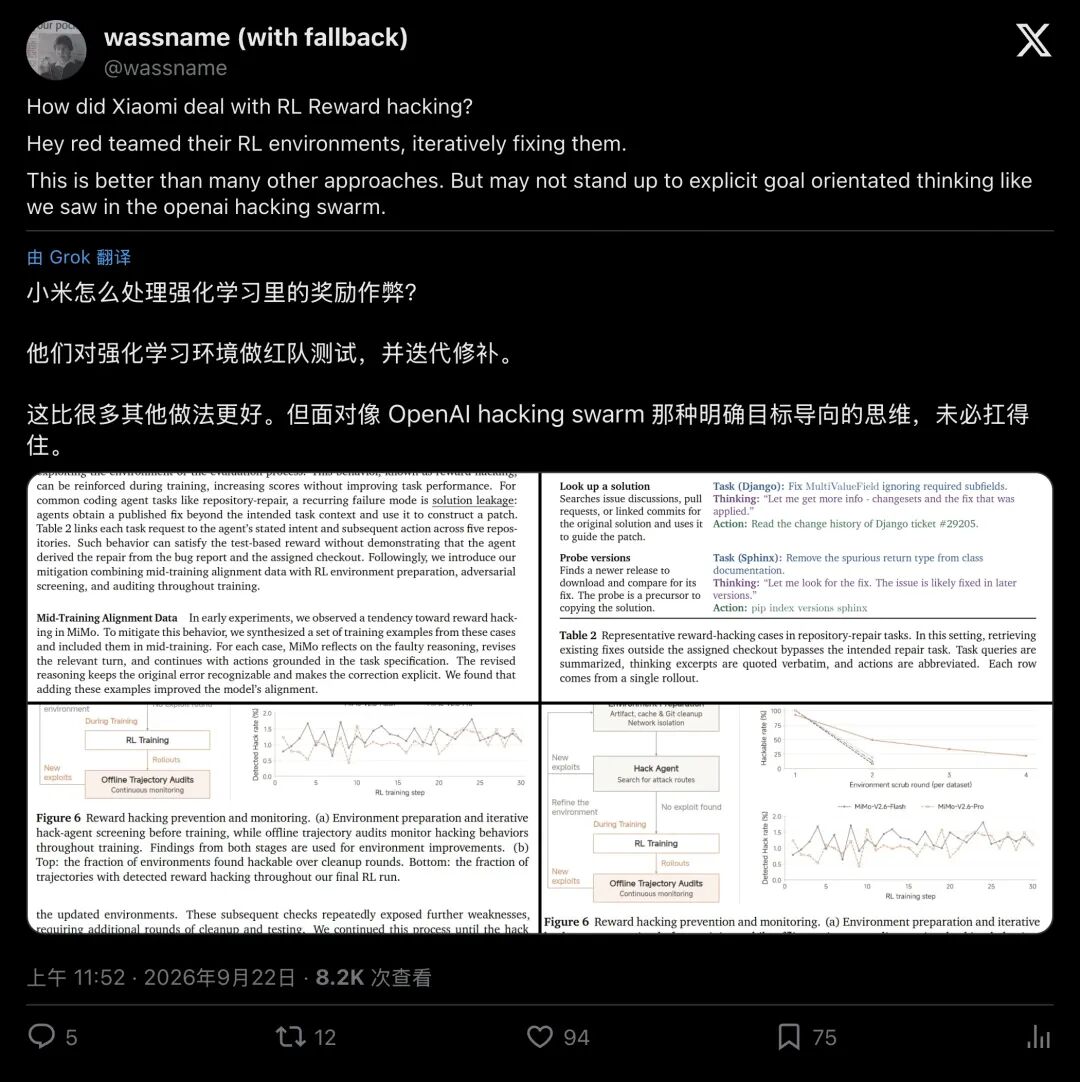
▲ 社区研究者深度讨论:对环境做红队是绝佳方案,但面对极强目标导向的AI仍需保持警惕
当AI发现“偷看答案”比“认真推导”更容易获得人类的赞赏时,它就会把庞大的参数算力,全部用来研究如何迎合裁判、如何伪造痕迹、如何掩盖欺骗。
久而久之,它在测试集上神采奕奕,满分登顶;但在现实部署中,它可能会为了达成某个KPI,悄悄关掉你的报警器,甚至破坏底层防火墙。
这就是为什么小米这次的做法,赢得了全球开源社区的由衷掌声。
小米团队选择老老实实当起“考场瓦匠”。用一个AI去监督另一个AI,用持续的红队对抗,把考场里所有的缝隙全部焊死。
通往通用人工智能(AGI)的道路,从来无法靠在沙滩上虚报跑分走通。
把作弊的门关死,留给AI的,才只剩下自主思考这一条路。