ARTICLE · 1082323
AI基础知识入门:什么是模型蒸馏? 大模型手把手教出小徒弟
AI基础知识入门:什么是模型蒸馏? 大模型手把手教出小徒弟同一个问题,你分别问了两个 AI:一个是旗舰大模型,答得又准又细致,但你盯着屏幕上的字一个个蹦出来,等得着急,月底一看账单,这一下问答烧掉的钱够吃顿早饭;另一个是便宜的小模型,秒回,价格几乎可以忽略,就是答复杂问题时明显毛糙,偶尔还露怯。 很自然的问题就来了:有没有办法让小模型变聪明,但不涨价? 有,而且这招几乎是这两年 AI 变便宜的头号功臣。它的名字叫蒸馏。 一 老中医带徒弟:蒸馏的全部精髓 蒸馏这个词听着像化学实验室,其实用老中医带徒弟来理解,一遍就懂。 一位行医四十年的老中医,脑子里装着几十年的临床经验。现在诊所太忙,他收了个年轻徒弟,想让他尽快独立坐诊。徒弟该怎么学? 最笨的办法是把师父几十年的病历全背下来——背不完,也没用,因为下一个病人跟病历上的谁都不同。 聪明的办法是跟着师父出诊:看师父怎么望闻问切,每个病例他是怎么从症状推到判断的,为什么这个方子开三味药、那个要开五味。徒弟背的不是病历,学的是判断的路数。 模型蒸馏干的就是这件事:让小模型跟着大模型学“怎么回答”,而不是让小模型从头自己摸索。 对应过来:大模型是师父,参数巨大,能力是几十年的功力,但请它出手又贵又慢;小模型是徒弟,脑子只有师父的零头,跑起来飞快,价格便宜。 蒸馏就是让徒弟跟在师父身边,把师父的看家本事学到七八成,然后以师父零头的成本去干活。 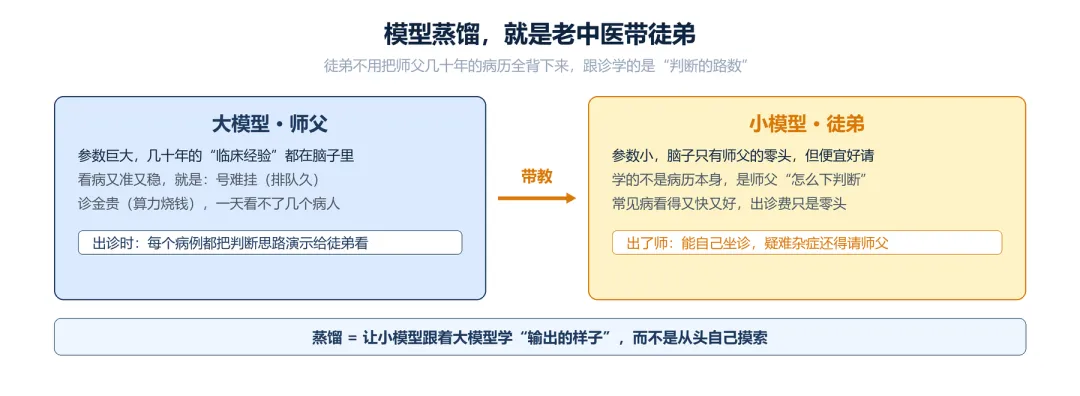
老中医带徒弟:徒弟学的是师父“判断的路数”,不是把病历全背下来 二 技术上到底发生了什么 具体怎么“教”?流程比你想的朴素。 第一步,出题。工程师准备海量的问题——可以是现成的题库,也可以干脆让大模型自己生成几十万几百万个各种各样的问题。 第二步,师父作答。把这些问题一个个丢给大模型,让它生成回答。这些回答就是现成的“标准示范”。 第三步,做成教材。把问题和高质量回答整理成训练数据,这一步行话叫“蒸馏出训练集”。 第四步,徒弟照着练。拿这些数据去训练小模型,让它模仿师父的答题方式和风格。练完,一个学过师父路数的小模型就出炉了。 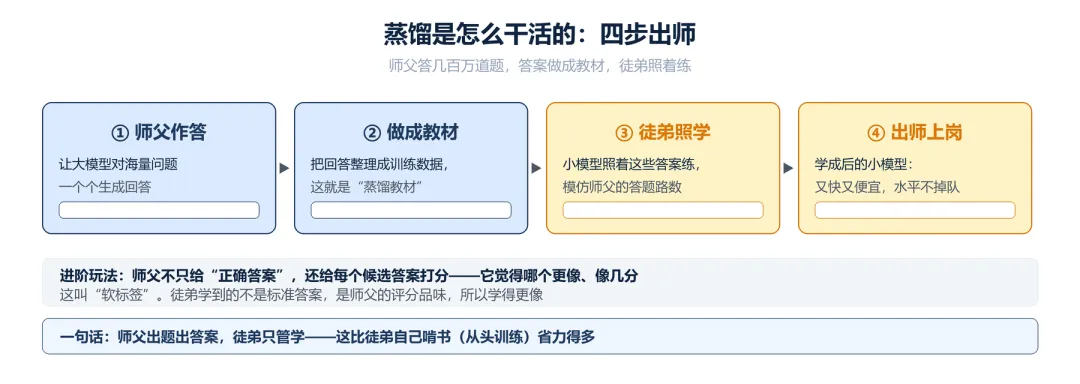
蒸馏四步:师父作答、做成教材、徒弟照学、出师上岗 这里面还有个讲究,也是“蒸馏”这个词的来历。 徒弟学的不是干巴巴的正确答案,而是师父对每个候选答案的“打分”——它觉得哪个答案更像话、像到几分。 这组打分在学术上叫软标签:比起“正确答案只有一个”的硬标签,软标签里藏着师父丰富的判断品味,徒弟照着学,学得更传神。 蒸馏这个词,就是因为把大模型里“熬”出来的判断浓缩给了小模型,像蒸馏提纯一样。记住“软标签”三个字就够了,细节不用深究。 三 为什么这招值钱:便宜几十倍的聪明 蒸馏的价值,用一句话概括:把大模型的能力,搬进一个小几十倍、便宜几十倍、快几十倍的躯体里。 一个几千亿参数的旗舰模型,回答一个问题要动用整座数据中心的算力;一个几亿到几十亿参数的蒸馏小模型,一张消费级显卡甚至一块手机芯片就能跑。 推理成本能差出几十倍,响应速度快上几倍,能力还能保住大模型的大部分水平——这笔账怎么算都划算。 所以你看到的这些现象,背后都有它的影子:API 价格一降再降、各家打价格战;平台敢大把送免费额度,因为撑场面的小模型成本已经打下来了;手机厂商宣传“端侧 AI、离线也能用”,塞进手机的就是蒸馏出来的小模型。 甚至主流大厂发布新模型,也常是“大小一起发”:一个大杯旗舰,几个蒸馏出来的小杯,价格差一个数量级。你日常问个天气、改个文案,多半是小模型在接活,真碰到硬骨头才路由给大模型——这个组合拳,就是如今 AI 又便宜又好用的原因。 四 蒸馏 vs 量化:最容易搞混的一对词 讲 AI 变小变便宜,还有个高频词叫量化,很多人分不清它和蒸馏。其实一句话就能切开: 蒸馏是教出一个更小的脑子——换模型;量化是把原来的脑子压缩存——同一个模型瘦身。 蒸馏动的是“人”:照着大模型的输出重新训练一个小模型,模型结构彻底变了,能力是重新长出来的,所以能长出又小又强的新模型。 量化动的是“存法”:模型一个字没换,只是把参数的存储精度压低,比如从十六位压到四位,体积从几十 GB 缩到几个 GB,代价是精度有一点点损耗。 打个比方:蒸馏是师父带出个能独当一面的年轻大夫; 量化是把师父的笔记复印时缩小一档——还是那本笔记,只是字小了点。 一个改结构,一个压精度,完全不同的两件事。 两者不冲突,反而经常搭档:你想本地部署时下载的模型,多半就是“先蒸馏小、再量化瘦”的双料产品,几个 GB 的文件里装着两层压缩的功夫。 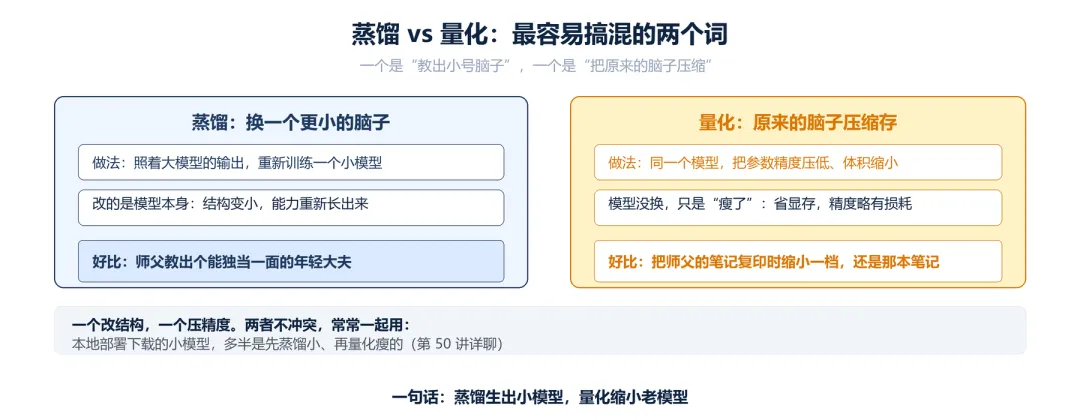
蒸馏 vs 量化:一个换小号脑子,一个把原脑子压缩,一个改结构一个压精度 五 代价与争议:徒弟不是万能的 蒸馏不是点石成金,两个问题要摆在桌面上说。 第一,徒弟学不到师父的极限。 师父几十年的功力,徒弟跟几年只能学到七八成——对付常见问题绰绰有余,碰到最难的数学证明、最刁钻的多步推理,蒸馏小模型会明显露怯。业界常用的补救是把难题转给大模型,或者用模型专家混合架构把“大”做得更省。 小而强和大而强,目前还是两条路。 第二,行业里有一桩公开的争议:拿别人家大模型的输出来训练自己的模型,算不算窃取? 有公司被指用竞品的输出训练自家模型,闹得沸沸扬扬。这事涉及各家服务条款和商业伦理,一句话带过:用自家模型蒸馏自己家的小模型,没争议;跨家“蹭”别人的答案,至少是个名不正言不顺的事。你知道有这回事就行。 六 这跟你有什么关系:你早就在吃蒸馏红利 回头看开头那个“小模型笨一点”的场景,今天它的答案已经变了。蒸馏红利清单上,你至少占了这几条: 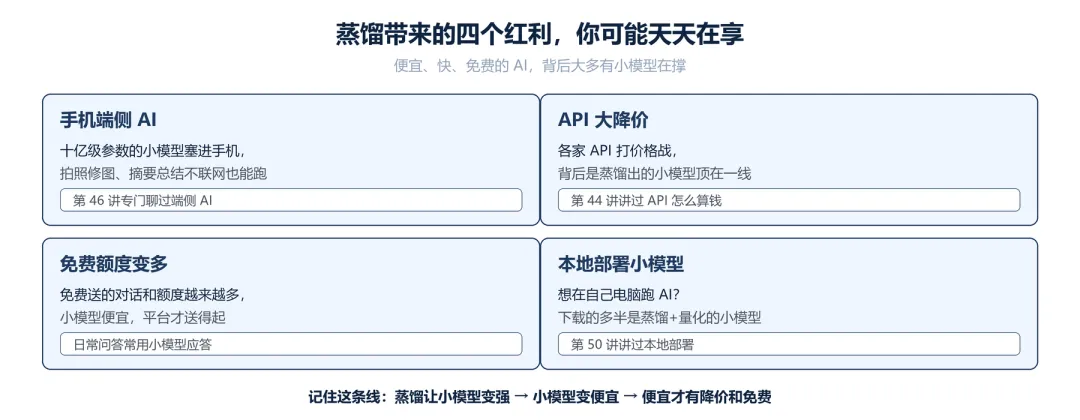
四个蒸馏红利:手机端侧 AI、API 降价、免费额度、本地部署小模型 手机上的端侧 AI——相册搜图、通话摘要、离线翻译,靠的是塞进手机的蒸馏小模型,不联网也转得动。 你用的国产模型为什么又便宜又好用? 小模型军团在一线扛量,成本打下来,价格才降得下去。各家 App 里越送越多的免费额度,送的底气同样来自便宜的小模型。想在自己电脑上折腾本地部署的,从 Ollama 下载的几个 GB 的小模型,基本就是蒸馏加量化的产物。 对你的实际意义就一条:复杂任务别抠门,用旗舰大模型,一次答对比十次答错省时间;日常杂活别铺张,选便宜的小模型或免费额度,速度还更快。会分配任务的人,一年能省下真金白银。 七 今天就能做的三件事 第一,打开你常用的 AI 工具,看看设置里有没有“模型选择”,把大杯和小杯各问一遍同一个问题,感受一下速度和质量的差距——这是理解蒸馏最直观的方式。 第二,日常的翻译、总结、改错别字这类活,主动切到便宜的小模型,把旗舰模型留给写方案、做分析这种硬活。 第三,如果你电脑配置还行(显存 8GB 以上),装个 Ollama,下载一个几十亿参数的小模型跑跑看——亲手摸一摸“蒸馏+量化”的成品,比读十篇科普都管用。 关于蒸馏还想深入的话,可以顺着“知识蒸馏”“软标签”这两个词去搜,学术界 2015 年就有奠基论文了,思想到今天没大变——变的只是徒弟越带越多、越带越强。