ARTICLE · 1094225
“大空头”迈克尔・伯里拆解AI风险(长文) | 词元极致消耗、账面虚增繁荣与久期错配风险...
女王带你一分钟速读
AI 算力泡沫:最关键 4 个要点
1. 需求是假的
市场把 AI 起步期的词元冲榜、基准测试误当常态化需求;compression(自研替代)已让外部可变现需求开始收缩。
Bezzle 账面虚增:价格脱离实际,账面上涨制造“心理财富” Tokenmaxxing 词元极致消耗:个体理性、整体制造算力无上限的假象 牛鞭效应:虚假需求信号向上传至芯片制造、向下传至数据中心投融资,被逐级放大
2. 供给已透支
英伟达 20% 营收押在微软一家,却对台积电锁定 1820 亿美元远期采购(超年度经营现金流),GPU 集群 10 年就可能淘汰。
微软 capex 减 20% → 英伟达营收约 -4%(简化测算) 微软在英伟达账上应收账款约 122 亿美元 ≈ 英伟达 2024 全部客户应收 思科对照:单一客户占比从未 >10%,英伟达集中度超历史标杆
3. 融资最危险
约 2750 亿美元在建数据中心等着长期置换;资产约 10 年、债务 15–19 年,期限错配。
资金正从科技巨头现金流,迁向寿险 / 私募信贷 / 百慕大自保的分层证券化 百慕大新增 200+ 家自保机构、36 家 PE 背景,结构神似引爆 08 年的 MBS 云厂商残值担保条款宽松,若同一批数据中心价值同步下跌,兜底形同虚设
4. 结论:撑不久
像航空业早期的空载航班——起步期不计成本合理,但“烧钱攒数据”的局面撑不了太久。
不是 AI 本身虚假,而是把起步期阶段需求误当常态化
正文
迈克尔・伯里(Michael Burry)因2008年金融危机前精准做空次贷而一举成名,这段经历被写进《大空头》,后又搬上银幕。伯里早在30年前便活跃于互联网社区,任职斯坦福神经内科住院医师期间,他就在techstocks等早期论坛分享观点,之后创办valuestocks.net,公开自己的选股逻辑与交易记录。1999年,知名价值投资人乔尔·格林布拉特(Joel Greenblatt)创立了Value Investors Club网站(VIC,一个需审核准入的价值投资论坛),伯里在此发表多篇深度分析,获得格林布拉特的赏识。2000年,伯里创立Scion Capital,格林布拉特成为其主要出资人…2025年11月,伯里注销了旗下资管公司,专注自有资金投资,同时在Substack开设付费专栏「Cassandra Unchained」,分享自己的投资思考与交易记录。
这篇文章发表于今年5月22日,是其AI系列的第三篇《The Heretic's Guide to AI's Stars Part III Tracepalooza & the Bezzle》。文章以英伟达切入,讨论了伴随AI热潮而来的牛鞭效应、账面虚增繁荣与期限错配风险。
事实上,伯里的多头仓位属于深度价值一派,但与多数“只做多”的价值投资者不同,他热衷做空,认为那是契合自身秉性的做法。眼下,AI多空之争愈演愈烈,双方似乎都能拿出像样的理据。自2025年三季度起,伯里陆续做空了英伟达、Palantir;2026年,其空头标的扩展至甲骨文、Nebius、美光、卡特彼勒,以及费城半导体指数ETF(SOXX)。诚然,择时是一件难上加难之事,伯里也坦言自己成了“喊狼来了的孩子”。但这篇文章的价值,不在于认同他的结论,而在于借鉴他的分析框架,思考他所提到的风险信号。
全文篇幅较长,通读一遍大约需要1小时。我将几个核心结论总结如下:
英伟达营收高度依赖少数客户。其最大客户(微软)占其营收约20%,若微软资本开支削减20%,英伟达营收将受到4%的冲击。作为对照,思科从未有过单一客户营收占比超过10%的情况。同时,微软在英伟达账上的应收账款约122亿美元,几乎等于英伟达2024年全部客户应收账款总和。在其余大客户减少赊销拿货期间,唯微软加大采购,显示其囤积芯片、加大算力基建投入的“野心”。
企业推行“词元极致消耗”(Tokenmaxxing)扭曲了需求信号。词元极致消耗指企业在内部配额、排行榜和管理层要求的驱动下,把AI词元用到极致的现象。从个体角度看,这一行为大多是理性的,但整体却营造出算力需求无上限的假象。这一信号向上传导至芯片制造领域,向下传导至数据中心投融资领域,形成“牛鞭效应”。英伟达在台积电锁定的定制化产线,其远期采购承诺达1820亿美元,已超出其年度经营性现金流。
本轮行情催生“账面虚增繁荣”(The Bezzle)。Bezzle一词由加尔布雷思在《1929 年大崩盘》中提出,查理芒格作了衍生阐述,本质是说资产价格上涨带来社会收入和心理财富的增长,即便侵占已经发生、价格已脱离实际。就本轮泡沫而言,并非AI本身是虚假的,而是市场把AI发展初期的阶段性需求——基准测试、轨迹采集、员工冲榜式的词元消耗——当成了常态化需求,并据此定价。然而,基准测试不代表真实生产力,模型训练不等于性能表现,词元极致消耗不是可靠的基建需求信号。
需求收缩(compression)已经启动,并将持续深化。词元极致消耗并不局限于超大规模云厂商和基础模型公司,而是存在一个由云厂商、垂类模型厂商、部署专有AI封装层的非科技企业以及纯粹的第三方模型使用者所构成的“金字塔”结构。处于下层的企业都有向上跃迁的动力,这一过程被称为“compression”:以自研替代外购,沉淀自有轨迹数据,摆脱对单一底层模型的绑定。行业整合后,外部可变现需求将会回落(与AI渗透率无关)。以微软为例:2025年12月,公司向内部工程师开放Claude Code,但仅仅半年后便将其关停,并要求全员在6月30日前切换至自家GitHub Copilot。
杰文斯悖论不足以支撑当前资本开支周期。该理论指出,成本下降将带来大量此前未参与消费的新增用户。就AI而言,算力成本的确在下降,但问题在于,市场需要杰文斯悖论短期内就强力兑现,眼下尚不具备条件:AI渗透率难以再现革命性扩张,个人用户的普及也基本完成。从超长期维度看,算力成本下降可能催生机器间推理需求的大爆发,但那还不是现在。
本轮资本开支面临期限错配的问题。在外部算力需求收缩的背景下,芯片在快速迭代,数据中心、配套电厂在加速建设。GPU集群/算力基础设施10年内可能就会面临淘汰,但支撑数据中心的债务期限通常15-19年。相关缺口须由再融资资金填补,并且新增资金的风险属性已和过去不同。
数据中心建设的融资链条正在向传统寿险资金延伸。AI基建资金来自多个渠道:
1)科技巨头经营现金流。但自由现金流投入目前已接近上限,后续需转向表外融资或债务/股权融资。
2)产业循环融资。这一链条极为复杂,所有参与方均采用同一套叙事、同一套假设,增加了融资体系的脆弱性。
3)以数据中心作为抵押资产的结构性融资。此为当前主要增量,也是风险最集中的一环。数据中心建设期,银团通常提供2-3年只付息建设贷款;建成后,这笔贷款需由长期置换融资替换,眼下约2750亿美元在建项目等待被置换。接盘资金主要是数据中心ABS、私募配售债券和来自保险公司/私募信贷基金的直接贷款。而这些资金的源头,是大型PE背书的私募信贷基金,以及设在百慕大的自保再保险公司。寿险资金依循这条路径,间接成了数据中心的最终出资人。
AI热潮以来,百慕大新增200余家自保机构,其中36家有私募机构背景,专门承接自身发行的数据中心ABS。这套分层证券化结构,与20年前伯里做空的住房抵押贷款ABS如出一辙。此外,云厂商巨头虽为数据中心提供残值担保,但底层条款十分宽松;若同一批数据中心价值同步下跌,这一兜底机制将变得形同虚设。
因此,就像空载航班在航空业发展初期是合理的(飞行员累积飞行时长、工程师采集数据、监管机构磨合规则...)AI这种轰轰烈烈、不计成本的基准测试,是任何有价值的新兴产业,在起步初期必然经历的阶段。但这种局面无法维持太久。
“他们不过是在到处飞空载航班罢了(They are just flying empty airplanes around)”
——桑恩
英伟达(NVIDIA)既是行业北极星、猎户座,更是整条资本市场银河的核心锚点。
英伟达当前受益于市场旺盛需求,但它的客户高度集中;而这些客户的自身需求,正被一轮难以持续的“模型训练与基准测试阶段”(training and benchmarking phase)所扭曲。这种扭曲的需求,通过“定制化保供协议”(custom supply commitments)传导至英伟达上游供应链,又顺着下游蔓延至数据中心投融资(data-center financing)领域,形成“牛鞭效应”(注:bullwhip,即上游微小的需求波动,会顺着产业链逐级放大。具体到AI领域,即AI大厂预判后续算力紧缺,提前和英伟达签订锁定产能的定制化保供协议——>英伟达看到海量锁单,于是大幅扩产、向上游晶圆厂、零部件厂商加码下单——>下游资本看到算力订单火爆,不断给数据中心项目放贷、融资扩建机房)。
而笼罩在这一切之上的,是“账面虚增繁荣”(The Bezzle):它一旦被看破,便无法无视;一旦被揭穿,便不复存在。
所幸,本周英伟达Luminous系列、Grace系列交出了亮眼的营收业绩,英伟达随即披露了最新一份季报。
我知道不少投资者都紧盯库存数据,但目前库存风险并未出现异常。从库存细分结构来看,数据逻辑合理:27财年第一季度原材料库存大幅攀升,一方面源于Blackwell Ultra新一代芯片产能正在爬坡,另一方面也与25财年第四季度Blackwell系列上市前的备货策略一致,是提前锁定上游产能、前置备货的常规操作。
更值得关注的是英伟达的客户结构:客户集中度已经高得爆表(Customer concentration is off the charts)。
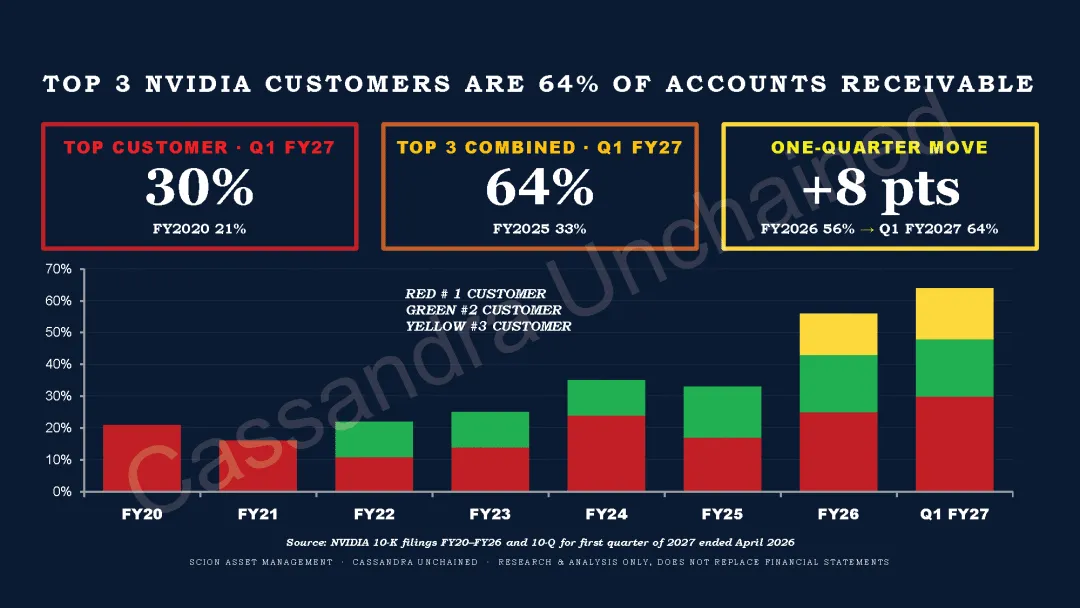
英伟达的最大客户很可能是微软。微软CFO今年1月曾表示,微软云(Azure)算力紧缺的状况至少会延续到今年6月。倘若微软把英伟达芯片的资本开支削减20%,英伟达营收就会受到4.2%的冲击。
思科(Cisco)过去从未有过单一客户营收占比超过10%的情况,只有当多个客户同步缩减采购时才会受到明显冲击。但对英伟达而言,只要单一大客户削减采购,或是该客户的订单增速达不到英伟达的预期,公司业绩就会遭遇重创。
一边是手握绝对话语权的寡头级核心大客户,另一边是高度定制化的专属供应链。风险隐患着实令人担忧。
当年思科和升阳微系统(Sun Microsystems)未曾陷入英伟达今日这般严峻的处境,升阳最后却仍破产了。如今在英伟达身上,我看到了两家企业曾经的影子,我也看到了过往存储芯片大周期(DRAM cycles)的影子。下文将对这些复杂逻辑做详细拆解。
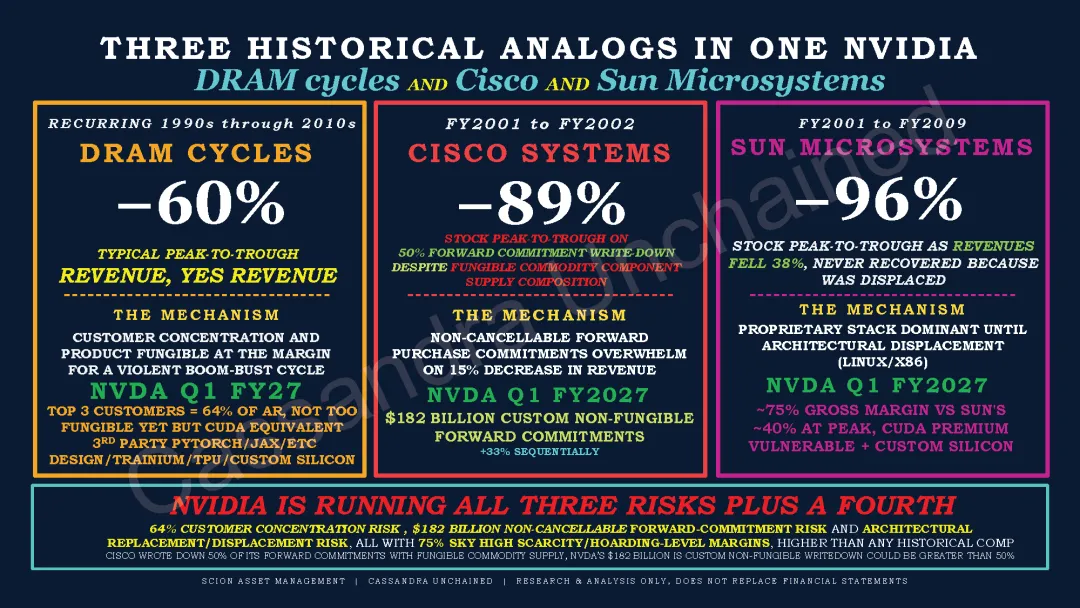
客户集中度,是驱动存储芯片行业过往周期性暴涨暴跌的核心诱因。过去一二十年里,DRAM行业的客户集中度有所下降,行情也不再高度绑定单一题材。但如今,少数几家巨头客户扎堆采购、行情高度依赖单一主线的局面再度上演,俨然重现上世纪90年代的情况。正因如此,我做空了费城半导体指数(SOX,Philadelphia Semiconductor Index)。
思科(Cisco)当年曾对其半数“采购承诺”(purchase commitments,思科提前与上游晶圆厂签订锁定产能的长期采购协议,无论后续需求如何,都必须履约拿货,违约将面临高额赔偿与资产减值)计提减值。它的供应商拥有大量其他客户,采购的零部件通常也是通用、可替代的(fungible)。
英伟达的做法则截然不同:它在台积电(TSMC)锁定了多条专属定制产线并为其提供资金。台积电无法利用常规产线生产英伟达芯片,这是一套定制化、不可替代的供应链(non-fungible supply chain)。该供应链不仅存在地缘风险;倘若英伟达业务增速放缓,乃至不幸出现下滑,还可能带来大额亏损。
英伟达当前市值突破5万亿美元,1820亿美元的远期采购承诺乍看之下并不刺眼(其中单一大客户占到1190亿)。可事实上,这1820亿的锁定采购规模,已经超过了英伟达每年极为可观的经营性现金流。
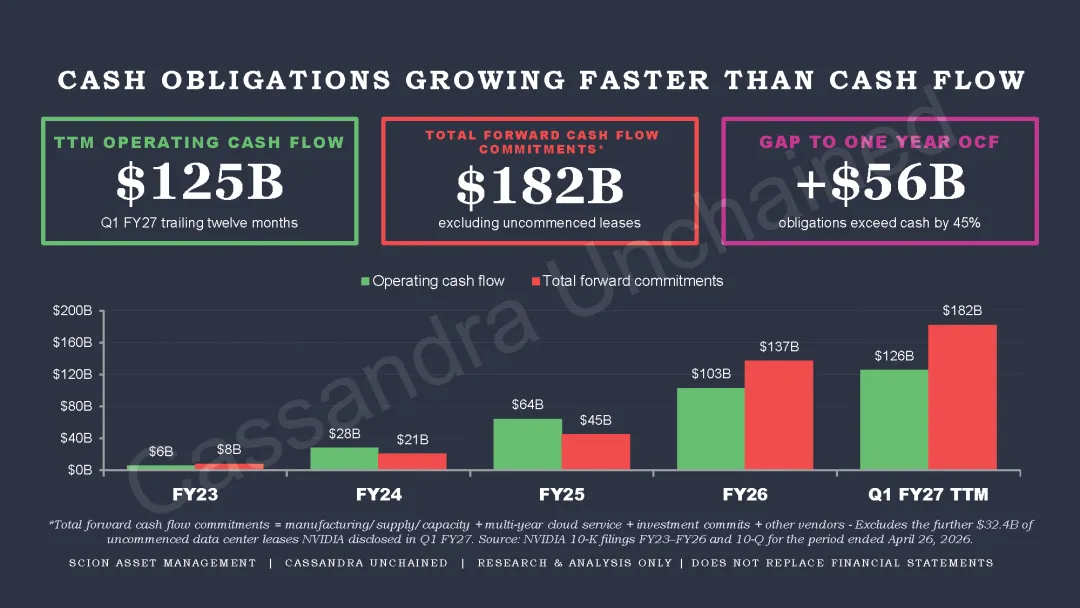
截至目前,这些都还不是问题。微软采购芯片的速度,远快于自身机房部署上架的速度。关键是,这批囤积的GPU被微软计入了在建工程(construction-in-progress,CIP),在正式投入使用前,既无需在资产负债表中计提折旧,也不会给微软带来当期成本压力。
然而,只要微软买了那些芯片,英伟达就可以确认收入、核销对应存货。这也印证了前文所说,英伟达当前的库存数据看起来十分健康。
对英伟达而言,这笔交易直接确认营收,形成应收账款。后续随着货款回笼,公司经营性现金流也随之改善。
不过,从应收账款变动模式中,我注意到一处反常疑点。
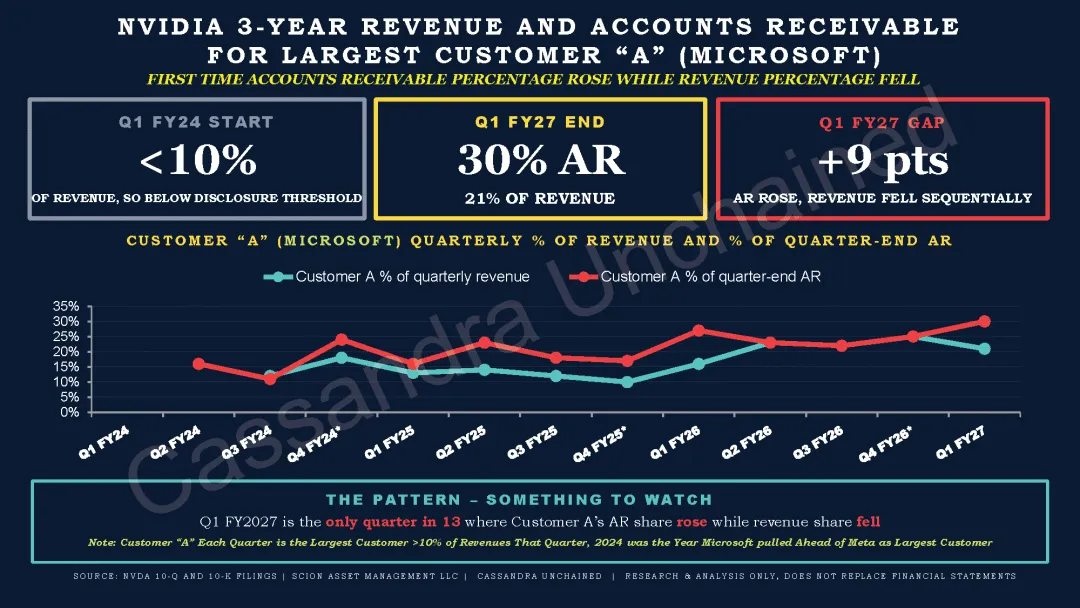
一季度,客户A(微软)在英伟达应收账款中的占比大幅攀升,可它在英伟达总营收中的占比却明显下滑。目前微软对英伟达的应收账款余额约122亿美元,几乎等于英伟达2024年所有客户的应收账款总额。
诚然,英伟达整体业务规模大幅扩张,过去几年其营收增长4.9倍,应收账款同样增长4.9倍,但该大客户应收账款余额暴涨至原先的13.4倍,背后正是微软大规模集中采购所致。
这并非质疑英伟达的成长性,而是指出财务数据里的反常走势:其余大客户(B客户、C客户)均减少了赊销拿货,唯有微软加大采购。过去两年,微软频频对外释放信号,称他们无意做数据中心这类“裸金属”生意。
微软把爆米花扔的到处都是,根本没想要喂动物(注:指微软对外释放迷惑性言论,刻意掩盖自己真实的布局意图)。
早在2024年,微软CEO萨提亚・纳德拉就说:“我们可能囤积了大量暂时无处装机的芯片库存(you may actually have a bunch of chips in inventory that I can't plug in)。”
2025年4月,微软叫停了总供电量1.5吉瓦的数据中心项目,并终止了多份场地租赁协议,相关内容在《Blessed Fraud》一文中已有分析。
微软本财年将于2026年6月结束。今年1月,微软曾对外表示,算力供给紧张的局面至少会持续到6月;同时还称,未来数年将持续迭代自研Maia系列芯片。
而在今年5月14日,微软宣布禁用Claude Code,要求全体工程师最晚在6月30日前切换至内部GitHub Copilot平台(注:国内阿里的做法也如出一辙)。收缩来得异常迅猛,要知道Claude Code在2025年12月才刚向微软内部工程师开放。
基于以上信息,可推演出两种潜在情景:
情景1:微软提前锁定了自己现阶段并不需要的库存(pull forward inventory)。尽管机房建设放缓、电力紧缺问题日益凸显,微软依旧选择大批量提货,只为保住自己在英伟达下一代芯片中的优先供货席位。这批芯片被归入在建工程暂时存放于仓库,财务层面无需计提任何折旧、不会侵蚀当期利润,但硬件本身却在持续发生物理损耗。此外,微软与英伟达约定的赊销账期约60至65天,意味着微软在收货后的数月内无需实际支付货款,现金流压力被延后。
情景2:英伟达主动向微软压货(channel stuffing,渠道压货),以此美化季度财报,打败市场一致预期。英伟达清楚微软具备大规模仓储囤货的条件,愿意承接多余芯片,且双方此前可能就有过这种配合。对微软而言,这批入库芯片计入在建工程,不对当期利润、财报业绩产生任何负面影响。
与此同时,标普全球(S&P Global)预测,全球多地电网承载力不足以匹配数据中心扩张节奏。预计到2028年,数据中心行业电力缺口将达到19吉瓦,占算力用电需求的40%。
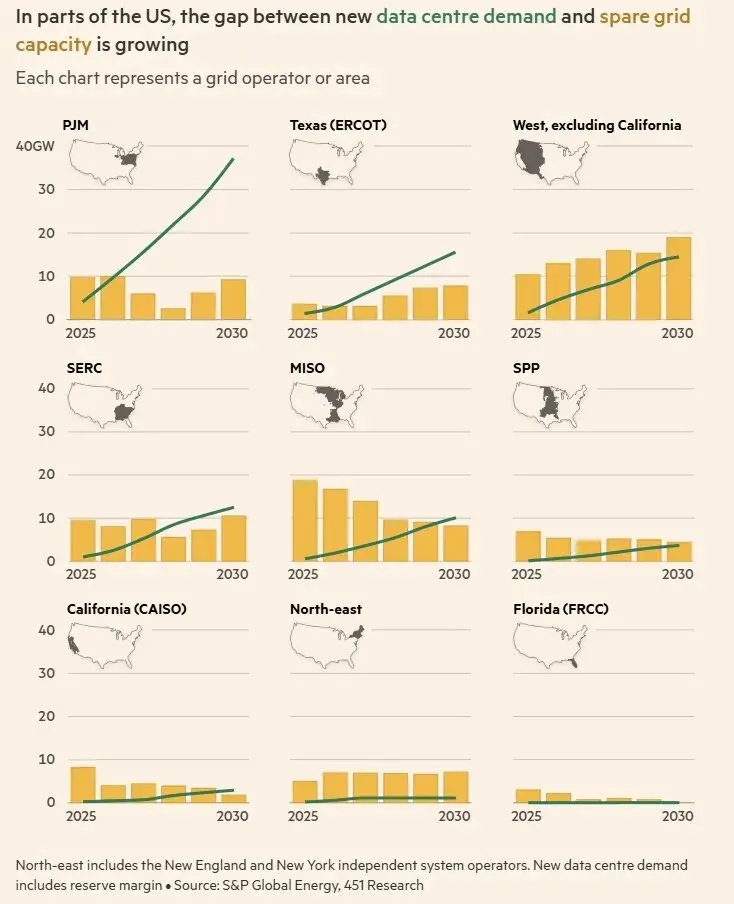
所有人都发现,数据中心已成为算力扩张的瓶颈环节。那些被计入在建工程的英伟达芯片,全就放在那儿等待部署。
无论上述两种情形哪一种属实,一场剧烈的“牛鞭效应”都已在暗中酝酿。我在之前文章中曾详细阐述过牛鞭效应:疫情封控期间,这一效应在全球供应链中体现得淋漓尽致。当年思科之所以对半数远期采购承诺计提大额减值,同样是因为牛鞭效应。
我还没有确凿证据,这更像是发现有人正把手搭在扳机上。接下来几个季度值得密切跟踪,尤其是数据中心融资叙事的演变。
与此同时,多头阵营不断鼓吹AI需求有多旺盛,形容其永无止境、异常火爆。
我认同当下的需求热度确实异乎寻常,但这本质只是“账面虚增繁荣”(The Bezzle)。当前的算力需求并非源于稳定可持续的真实业务场景,也不是长期向上的增长曲线带来的刚需,只是阶段性、群体性、组织层面的竞争行为:各行各业争相搭建自研AI技术栈,试图抢占竞争优势。
为达成这一目标,各家企业都在拼命做模型基准测试、采集运行轨迹数据、封装训练工具、收集模型故障样本,竭尽全力拉高AI调用规模。
这种狂热、仓促、阶段性的行业热潮,还有一个专属名词:
词元极致消耗(Tokenmaxxing)
空头们一直在问:眼下这场 AI 热潮最终该如何实现商业化落地?市场给出的答案是:各类企业已经在通过采购算力、疯狂消耗词元(Token,大模型处理文字、代码、图像的最小计费单位,企业调用AI、使用算力均按照消耗的Token数量收费)、把算力额度用到极致、不断拉高词元使用量来完成商业化变现。
但这一现象背后有其特殊成因,并不能代表长期可持续的真实需求。
无论你看多还是看空AI领域,都必须弄懂“Tokenmaxxing”这个概念。
《纽约时报》记者凯文・鲁兹在今年 3 月 20 日刊发题为《再多一点!再多一点!再多一点!科技从业者疯狂拉满AI使用量》(More! More! More! Tech Workers Max Out Their A.I. Use)的报道,详细解读了Tokenmaxxing这一现象。就在他发文后没几天,4月1日,风投机构Theory Ventures的托马斯・通古兹发文分析微软依托词元消耗模式招聘工程师一事,并详细讲解了如何实现 Tokenmaxxing。
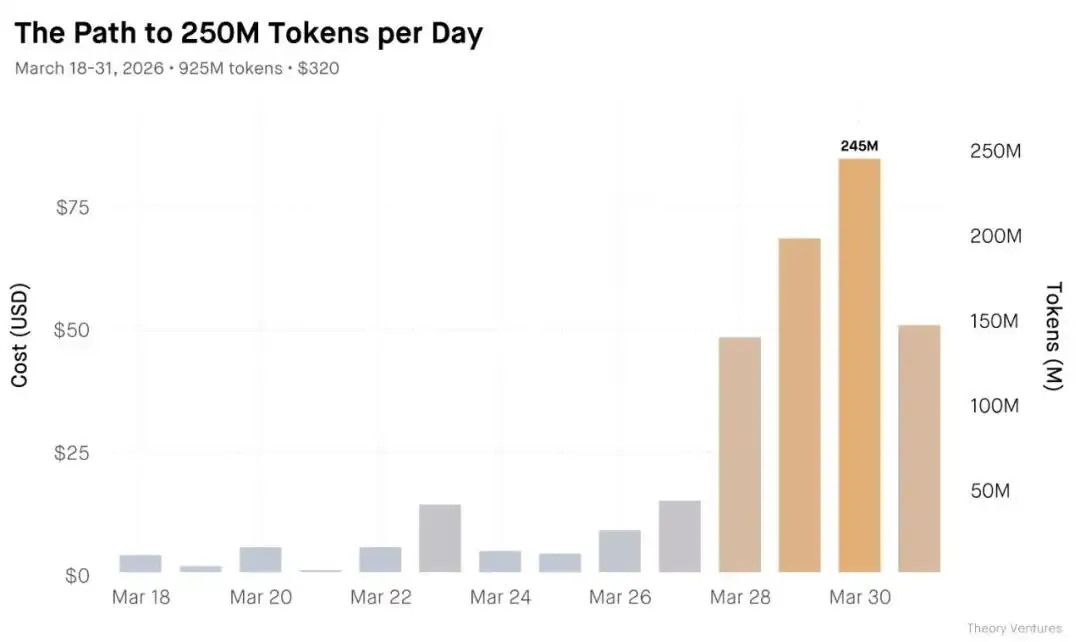
正如托马斯在博文中写道:
“秘诀就在于并行化部署。每天开工前做好规划,让多个智能体同步开展工作。METR机构的研究数据显示,当前最新大模型已可自主连续运行12小时,而一年前这一时长仅为1小时……但目前,生产力的提升空间依旧没有触顶。”
"The secret is parallelization. Structure a plan at the start of the day that allows multiple agents to work simultaneously. METR research shows the latest models can now work autonomously for 12 hours, up from 1 hour a year ago… The productivity ceiling? Still unmaxxed."
4月6日,科技媒体《The Information》刊发 《Meta员工争相角逐AI“词元传奇”称号》的报道。文章说,硅谷技术从业者刻意疯狂消耗词元,公司内部还设有个人消耗纪录榜单、全员排行榜。这篇报道发布没多久,Meta就紧急下架了这份词元消耗排行榜。
随后《财富》杂志跟进报道,文中援引Meta首席技术官安德鲁・博斯沃思对公司一名顶尖工程师的评价:
“这名优秀工程师每年消耗的AI词元成本,几乎等同于自己的年薪,而他的工作效率提升了5至10倍…说白了,这笔投入稳赚不赔,尽管放开使用,上不封顶。”
"His best engineer is spending the equivalent of his salary in tokens, but he's 5x to 10x more productive...It's like, this is easy money. Keep doing it. No limit."
英伟达GTC大会上,黄仁勋这样表态:
“我完全可以预见,未来公司里每一位工程师都会配有年度AI词元预算。工程师基础年薪大概几十万美元,我会额外再发放相当于其年薪一半的词元配额,借助AI把工作效率放大10倍。如今在硅谷,这已经成了企业招揽人才的一大筹码——求职者都会问,入职后我能拿到多少词元额度?出现这种现象的原因很明确:只要工程师可以调用足够的词元,工作生产力就能大幅提升。”
Y Combinator(注:硅谷知名创业孵化器)创始人加里・谭向来擅长用夸张笔触渲染各类行业风口,本月早些时候,他谈到词元极致消耗时,同样极尽渲染、大肆吹捧。
如加里所说:
“倘若你不计代价把所有可能性穷尽、做到极致完美——换作人工,完成这项研究大概需要耗时1个月,而借助AI,你只需不断拉高算力调用强度即可。多付出算力成本,或许就走上了极致消耗词元的路子,但你本就应该把词元额度用满……一旦实现词元消耗最大化,你相当于买入了数百万年的机器意识算力。此刻的你,俨然成为坐拥时间财富的亿万富翁。”
词元极致消耗绝不只是高频使用AI这么简单,更绝非可持续的AI应用需求。它是由配额驱动(quota-driven)、内部排行榜驱动(leaderboard-driven)、管理层硬性要求之下催生的算力过度消耗行为。这类使用或许能提高生产力,但绝非10倍、15倍的提升幅度。一部分算力消耗来自尽心尽责的模型基准测试,还有一些、甚至很多,其实是是职场身份比拼、员工内卷晋升的手段。可所有这些算力消耗最终都被统计为需求,被误认为是可变现的刚需。
那究竟什么是词元(Token)?
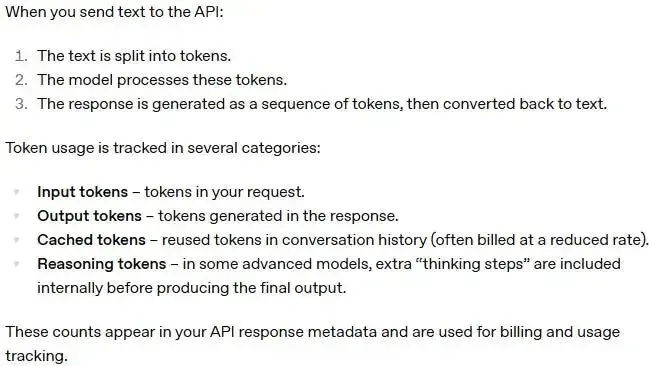
词元是大语言模型处理文本的最小计费单位,每调用一个词元都会产生相应费用。
OpenAI专门在其官网开设页面,详细解释词元相关规则。以下是OpenAI官方说明:
接下来谈词元极致消耗(Tokenmaxxing)。
企业将词元极致消耗包装成一套先进的发展理念,借此机制,让内部员工无偿编写提示词、反复调试对话来训练公司自研大模型。再加上各路对效率提升的夸张宣传,以及加里・谭这类行业意见领袖大力鼓吹,这套理念形成了极强的舆论号召力。
词元极致消耗通过轨迹数据(traces)实现:每一条轨迹,都是一次人类与AI模型交互的完整记录。
在词元极致消耗的场景下,不同轨迹作为模型训练样本具备不同价值,其中对于模型训练最有帮助的轨迹是纠偏类交互记录(redirection):也就是人类明确认可模型给出的输出方向,或是直接否定、纠正模型的错误输出。
当一名员工为冲击词元消耗排行榜而烧掉3000万词元时,他在多次人机交互中做出的每一次判断、留存下的轨迹数据都具备对冲成本的价值,因为这些数据可直接用于迭代训练下一代模型。
但不难预见其中潜藏的失控风险(slippery slope,指行为从合理边界逐步滑向失控、畸形的极端状态)。AI尚且属于新兴事物,人们面对全新工具时,往往会走向极端,催生大量低效甚至毫无生产力的使用行为。我对一众AI信徒反复宣扬的提升生产力的数据深表怀疑。当有人宣称生产力能提升15倍时,其他人必须质疑其统计的基准口径是否合理。
账面虚增繁荣(The Bezzle)
回到开篇我提到的账面虚增繁荣。这个词源自“挪用公款”(embezzlement)。一旦看破,便不能再无视;若要揭示,就必将其彻底毁灭(Cannot be unseen once seen. Cannot be revealed without destroying it altogether)。
查理・芒格曾多次谈及这一概念,但这个术语最早由约翰・肯尼思・加尔布雷思(John Kenneth Galbraith,1908–2006)提出。他在《1929年大崩盘》一书中写道:
“在各类侵占财产的犯罪行为中,唯有挪用公款存在时间差属性。从实施犯罪到罪行败露,中间可能间隔数周、数月甚至数年。在此期间,挪用者占有非法所得,而资金被侵占的一方竟不会感受到任何实际损失,全社会心理层面的财富反而出现了账面净增长。任何时刻,一个国家的企业与银行体系中,都沉淀着大量尚未被曝光的资金挪用,我们可以将这类未暴露的虚增资产统称为“Bezzle”。
这类虚增资产的规模动辄高达数百万美元,并且会随经济周期不断起伏。经济繁荣期,人们心态松弛、彼此信任,市场资金充裕。即便资金充足,依然有许多人想要获取更多。此时,挪用行为愈发频繁,违规事件的曝光率大幅下降,账面虚增资产迅速膨胀。而经济萧条时期则截然相反:人们对资金管控严苛、处处设防,资金经手人需要自证清白才会被信任;审计全面且细致,商业信用与行业道德标准大幅提升,账面虚增繁荣随之缩水。”
"Alone among the various forms of larceny [embezzlement] has a time parameter. Weeks, months or years may elapse between the commission of the crime and its discovery. This is a period, incidentally, when the embezzler has his gain and the man who has been embezzled, oddly enough, feels no loss. There is a net increase in psychic wealth. At any given time there exists an inventory of undiscovered embezzlement in—or more precisely not in—the country's business and banks.
This inventory—it should perhaps be called the bezzle—amounts at any moment to many millions of dollars. It also varies in size with the business cycle. In good times, people are relaxed, trusting, and money is plentiful. But even though money is plentiful, there are always many people who need more. Under these circumstances, the rate of embezzlement grows, the rate of discovery falls off, and the bezzle increases rapidly. In depression, all this is reversed. Money is watched with a narrow, suspicious eye. The man who handles it is assumed to be dishonest until he proves himself otherwise. Audits are penetrating and meticulous. Commercial morality is enormously improved. The bezzle shrinks."
庞氏骗局(Ponzi scheme)就是典型的账面虚增繁荣案例。伯尼・麦道夫制造了一场规模空前的Bezzle骗局。只要罪行没有败露,所有参与者都会误以为自己的财富在持续增长。
企业同样会催生这类虚假繁荣。全球金融危机爆发前的房利美(Fannie Mae)和房地美(Freddie Mac)、安然(Enron)、世通(WorldCom)以及诸多财务舞弊企业,都曾制造出巨大的账面虚增繁荣。
这一概念也适用于并未财务造假、却依托管理层造势或阶段性市场狂热获益的企业。这类市场狂热终究只是短暂现象。
正如卡内基国际和平基金会所述:
“不幸的是,加尔布雷思指出,账面虚增繁荣注定难以长久。某一时刻投资者终将醒悟,意识到自己被误导,自己真实财富远低于预期。届时市场感知到的财富开始缩水,直至回归真实财富水平。账面虚增繁荣会先推高全社会账面财富、刺激居民与企业超额消费,可一旦回归现实,财富大幅缩水,消费行为也会陷入断崖式萎缩。”
"Unfortunately, the bezzle is temporary, Galbraith goes on to observe, and at some point, investors realize that they have been conned and thus are less wealthy than they had assumed. When this happens, perceived wealth decreases until it once again approximates real wealth. The effect of the bezzle, then, is to push total recorded wealth up temporarily before knocking it down to or below its original level. The bezzle collectively feels great at first and can set off higher-than-usual spending until reality sets in, after which it feels terrible and can cause spending to crash."
2000年,查理・芒格对账面虚增繁荣作了如下阐述:
“加尔布雷思创造Bezzle一词,是因为他发现每一分未被曝光的资金挪用都会极大地刺激全社会消费。毕竟挪用者的可支配收入增加、消费随之扩张,而资金受损方尚未察觉资产流失,消费习惯维持不变。但加尔布雷思并未进一步延伸这一洞察,仅停留在警示者的角色。接下来,我尝试把这一概念推向更深的逻辑维度。”
"Galbraith coined the 'bezzle' word because he saw that undisclosed embezzlement, per dollar, had a very powerful stimulating effect on spending. After all, the embezzler spends more because he has more income, and his employer spends as before because he doesn't know any of his assets are gone. But Galbraith did not push his insight on. He was content to stop with being a stimulating gadfly. So I will now try to push Galbraith's 'bezzle' concept on to the next logical level."
芒格基本上是说,股票及其他资产价格上涨本身就会产生社会收入和财富效应,即便价格与其价值已严重不匹配(rising prices of stocks and other assets can generate income and wealth effects themselves, even though the prices do not match underlying value)。
因此,追求长期收益的投资者,通常有3种选择:
1.找出罕见的“负向账面虚增”(negative bezzle,即被市场错杀、价格远低于真实价值的标的),找到其中最大的negative bezzle,然后大笔投入;或者,若能找到多个这样的标的,可适度分散投资。
2.主动参与其中,助推、甚至亲手制造这场虚增繁荣浪潮。
3.努力揭露这个虚增繁荣,在泡沫破裂的过程中获取收益。
讽刺的是,第三种选择往往会被虚增繁荣的受益者所唾弃。从定义上讲,许多从账面虚增繁荣中获益的人——或仅仅一个人——可能只是看到某些蠢货(注:指做空者和试图戳穿泡沫的人)正试图毁掉看似有价值的东西。而另一些——也许也只有一人——却非常清楚并不存在什么蠢货,但他们仍须不惜一切代价阻止此人,只为了不让虚增繁荣的价值受损。
或许我本该开篇就先阐释账面虚增繁荣,但我选择先从英伟达切入。
需要说明的是,虚增繁荣并不是说AI本身是虚假的(尽管我认为它尚未被清晰界定)。相反,本轮的账面虚增繁荣,源于各类阶段性需求:模型性能基准测试、采集人机交互训练数据、员工内卷冲击算力排行榜……这些需求被市场当成常态化永续需求,甚至被解读为未来需求将进一步爆发的先行信号。
词元极致消耗的金字塔结构
事实上,词元极致消耗并非局限于超大规模云厂商(Tier 1 hyperscalers,指微软、谷歌、亚马逊、英伟达这类坐拥海量算力、自研基础大模型的头部科技企业)和基础大模型企业——这些公司利用员工人机交互行为来训练自家模型。
这一模式之所以快速扩散,根源来自商用授权协议的约束:主流基础大模型的合作协议通常约定,厂商不得使用企业客户数据进行模型训练,仅能基于个人轨迹数据(individual data traces)进行训练。这就意味着,每家企业只能依靠内部海量员工生成尽可能多的交互轨迹,过程中消耗海量词元,以此提升企业专有数据价值、改进自研模型封装层(wrapper,部署在第三方大模型与企业业务系统之间的中间程序,负责数据采集、指令转发、日志留存、接口适配),并降低对第三方模型的依赖。头部大厂早已深知这点,其余公司也在迅速跟进。
即便你的公司尚未开始,词元极致消耗很快就会蔓延到你所在的公司。
所有自己研发大语言模型(LLM)、小语言模型(SLM)的软件公司或集团——例如财捷集团(Intuit)推出的金融大模型——都有充足的动机使其员工通过词元极致消耗完成模型训练。赛富时(Salesforce)、ServiceNow、Workday等公司均属于这一范畴。这类面向垂直行业、特定信息领域的专用AI模型,同样需要大量训练,也就是词元极致消耗。我们不妨称其为第二层级(Tier 2)。
还有大量非科技类企业部署了专有AI。这类企业一般采用轻量化自研封装层调用第三方大模型,例如帕兰提尔(Palantir)提供的技术方案、企业内部IT团队或咨询公司搭建的定制化中间层。这类企业暂时还没有构建自己的基础大模型。不过,轨迹数据会被封装层而非底层模型记录。会被封装层完整留存。这让公司可依托精密复杂的中间层抓取训练轨迹数据,逐步让这套封装架构摆脱对单一底层大模型的绑定,实现多模型兼容(model agnostic)。这是第三层级(Tier 3),一个非常活跃、不断迭代的层级。
大一点的银行、保险等金融机构,会搭建专属AI封装层,匹配资管、托管、受托理财等多元化金融业务场景。以摩根大通为例,其推出的大模型工具套件,本质就是一套封装系统,可依托中间层采集员工交互轨迹,同时隐藏底层调用的大模型来源。不妨称其为3a层级(Tier 3a)。
其余大型非金融实体企业同样会搭建AI封装工具,服务自身主营业务,例如CVS Health、沃尔玛、联合健康集团均在积极布局,可被视为3b层级(Tier 3b)。这类企业的技术成熟度参差不齐,但都在持续优化、向上迭代升级。
第四层级(Tier 4)企业是纯粹的第三方大模型使用者,没有任何独立的AI技术布局。长期来看,这类企业会持续缩减。
实际上,每个层级内的企业都会逐步升级跃迁,往更高层级迈进,这也是Palantir长期市场空间被持续挤压的部分原因。
前三大层级的企业,均具备极强的动机去推行词元极致消耗模式。
这座金字塔并非一成不变的经济结构,企业向上跃迁的动力极强。所有追求利润最大化的企业,都会向金字塔更高层级攀爬。这个动作就叫做行业需求压缩(compression,指企业从单纯外购算力,逐步走向自研模型、沉淀自有数据,行业从粗放式算力军备竞赛,转向精细化自研降本,整体算力需求增速放缓。对应前文微软关停Claude Code的现象)。
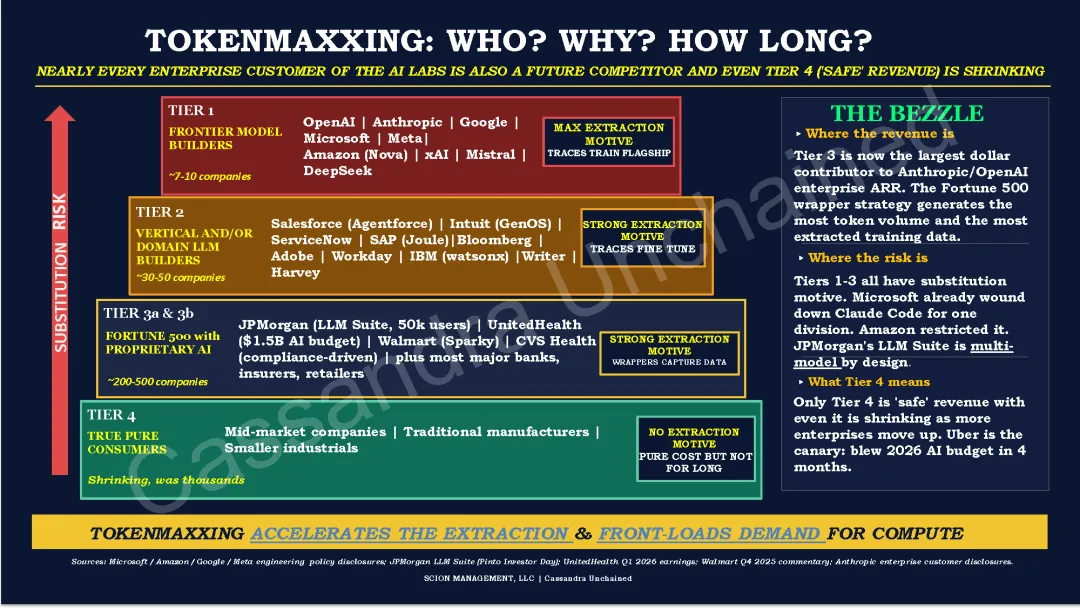
上面的示意图展示了前文提到的词元极致消耗金字塔词元极致消耗金字塔(The Tokenmaxxing Pyramid)。图中左侧向上的红色箭头代表产业演进趋势:随着企业自身训练出更先进的模型,(第三方)底层模型将被逐步取代。还是那句话,行业的内生动力,是向着金字塔更高层级攀登。
所以,本轮“账面虚增繁荣”究竟是什么?目前我们所处的阶段,财富200强里大量非科技企业都在落地封装层策略(wrapper strategy),它们正在消耗海量词元、生成最多的交互轨迹,以此获取模型训练数据。
随着这些企业完成模型训练、向更高层级跃升,大规模算力训练需求就会枯竭,随之而来的便是需求收缩。
所谓需求收缩,就是指模型性能基准测试阶段结束后,企业开始约束、削减对第三方词元的过度消耗。
前文提到,微软旗下负责研发Windows、Microsoft 365、Outlook、Teams、Surface硬件的体验与设备事业部,已经把Claude Code封了,不能再用了。据科技媒体The Verge报道,Claude Code在2025年12月刚向微软内部工程师开放,一度广受欢迎。但在2026年5月14日,微软关停相关授权,并要求全员在6月30日前切换至自家GitHub Copilot。这一从训练(自家AI产品)到压缩(第三方AI应用)的过程十分迅速。
The Verge披露,即便不少工程师更青睐Claude Code并提出反对意见,微软依然强制执行内部管控。这种做法看似意外实则非常合理:公司清楚,把核心技术主动权拱手交给第三方长期而言没有任何好处,自研专有方案才是未来的竞争优势(Companies know long-term that there is no benefit in giving it all up to 3rd parties. Long-term, proprietary in-house solutions will be the competitive advantage)。
微软执行副总裁拉杰什・贾哈在内部邮件中(引自Awesome Agents博客)写道:
“我们当初同时上线Copilot CLI和Claude Code,初衷是为了快速学习、在真实的工程工作流中对工具做基准测试,搞清楚什么事最适配团队的方案。Claude Code是这一学习过程的重要组成部分……而Copilot CLI为我们带来了特别重要的东西:一个我们可以通过GitHub,围绕微软的代码仓库、工作流程、安全要求与工程需求共同塑造的产品。”
"When we began offering both Copilot CLI and Claude Code, our goal was to learn quickly, benchmark the tools in real engineering workflows, and understand what best supported our teams. Claude Code was an important part of that learning... Copilot CLI has given us something especially important: a product we can help shape directly with GitHub for Microsoft's repos, workflows, security expectations, and engineering needs."
就在内部大规模使用 Claude Code 期间,投资博主Tunguz发文证实,微软工程师和 Meta 等大厂同行一样,开启了极致刷词元、疯狂沉淀交互轨迹(tracepalooza)的模式。短短数月基准测试就做完了,现在微软将利用这些结果来改进其内部产品。这也对应示意图里向上的红色箭头:长期来看,所有企业都会沿着金字塔向上攀登。
第三层级企业的技术从业人员,都将微软的所作所为看在眼里。
需求收缩,本质是面向外部可商业化变现的AI需求回落,与AI渗透率并没有关系。(Compression is lower external monetizable AI demand. It has nothing to do with adoption)。那些IT专家和工程师们长期想做的,就是降低外部AI服务商从自身业务中攫取的利益。这是他们紧密紧盯行业动向的原因。
再以亚马逊为例:亚马逊此前一直在其Bedrock封装平台上运行Claude Code。2025年末,亚马逊在内部部署智能体编程工具Kiro,搭建用量排行榜/数据看板,并对员工使用情况进行监控。方法就是词元极致消耗,用量落后的员工会被管理层重点关注。通过对AI的使用,亚马逊旨在节省20亿美元成本,还部署了21000个AI智能体。
后来工程师们提出反对,他们想要更多词元额度、想继续用Claude Code拉满词元消耗,他们觉得这种工作方式下的效率远高于Kiro。这是一种被强烈的社会认同所强化的意识形态(注:指科技行业从业人员把Claude Code+tokenmaxing奉为主流工作理念)。
但这也引发了代价惨重的系统宕机事故。据技术博客dev.to记录:
“在其自研AI编程工具接连引发重大系统故障后,亚马逊被迫对335套核心业务系统启动为期90天的安全重置。仅3月5日这起事故,就造成630万笔订单流失,峰值时段收到21716条用户故障上报。”
上面提到的AI编程工具正是Kiro:该工具此前就多次引发服务中断,还生成大量缺陷代码,而经工程师们却批准了这些代码并将其投入生产,后果可想而知。
不过,所有AI调用行为都运行在亚马逊Bedrock平台之上,所以它掌握了全部交互轨迹与运行数据,并从各种错误中获得了大量经验。这有助于改进Bedrock平台,进而也提升了基于该平台的Claude Code。这对亚马逊也有利,因为它向Anthropic投资了80亿美元。
这似乎是顶尖公司的明确策略:它们真正想要的是海量训练数据,因此刻意激励员工极致消耗词元来采集数据。只要能不断丰富、沉淀交互轨迹,短期高昂成本、系统故障失误都是可以接受的。
当前行业技术学习门槛依旧很高,“疯狂采集交互轨迹数据”(tracepalooza)已是行业通行做法。金字塔前三个层级的企业都在大规模推行词元极致消耗,也催生了当下规模空前的账面虚增繁荣。
但这终究只是阶段性的(行业热潮)。是的,AI尚处发展初期,可发展初期往往伴随最无节制的滥用。
杰文斯悖论(Jevons Paradox)
杰文斯悖论(注:指商品使用效率提升、单位使用成本下降后,总消耗量非但不会减少,反会大幅增加。AI场景下,指算力降价将拉动需求增加)无法拯救本轮资本开支周期,词元极致消耗就是证据。杰文斯悖论成立的前提,是商品供给成本下降,使此前从未参与消费的新用户入场。但当前对词元极致消耗的各种激励机制,意味着企业端AI调用量已趋近饱和。
工程师们几乎都在竭尽全力消耗词元,而不顾企业成本。
而对于非企业级用户(个人及第四层级公司),第三方大语言模型已经大范围普及,只要拥有智能设备,全球绝大多数人都可以便捷使用。
倘若仅依靠人类使用者,那杰文斯悖论所说的新增用户空间其实十分有限。杰文斯并不能成为当下AI投资逻辑的充分理据。AI渗透率很难再出现革命性的扩张,因为它真的不能。人们基本都已经在用了,而且很多人只是借着行业大规模训练的窗口期,疯狂地、不计成本地调用AI。
长远来看,未来广泛的机器间推理场景(machine-to-machine inference)或许能让杰文斯悖论生效。当然这需要算力成本持续下降,目前成本也确实在下降。
但争议的核心并非未来更低的推理成本能否催生出更多使用需求。从非常长期的维度来看,这或许是成立的。
问题在于,市场需要杰文斯悖论在短期内就强力兑现,而当下并不具备这样的条件。没错,不会是当下,尤其是在需求收缩的大背景下。微软Excel问世40余年,如今几乎预装在全球每一台个人电脑上,但绝大多数用户即便常年使用,实际用到的功能甚至不足其全部能力的百分之一。AI也会迎来相同宿命:海量的算力产能摆在眼前,人类却只能挖掘其中一小部分应用潜能(Vast capacity, with humans only caressing the possibilities)。
这一轮算力热潮终会落幕(This too shall pass)。模型训练将从颠覆性创新阶段转入常态化迭代阶段,推理将占据主导,但海量算力很快就会超出我们创造信息的能力。目前各大实验室已经开始面临人类原生数据不足的瓶颈——人工编写的代码、文稿、分析报告、音乐创作…虽然总量庞大,但过度建设的算力供给,对我们这些小人物来说注定是绰绰有余的。
需求收缩终将成为主旋律,金字塔上多个层级将不断整合,收敛归一。
从这之后的核心矛盾,都与期限错配(duration mismatch)有关:软件快速迭代、需求快速收缩,但金融资本投放、硬件产能建设却极为缓慢。而账面虚增繁荣,目前就暂存于这两者之间。
资金究竟从何而来?
英伟达每年都在推出新一代芯片,数据中心在全速加紧建设,配套电站也在加急开工,但外部算力需求已经开始收缩。经营性现金流被资本开支尽数消耗,债务规模正快速扩张。
词元可以在数百万次消耗后快速被遗忘,但数据中心并非如此。GPU算力集群通常几年后就面临技术淘汰。支撑数据中心建设的债务期限长达15-19年,但许多算力基础设施可能不到10年就会落伍淘汰。
正因如此,芯片采购与算力数据中心的资金来源,一直是市场大量猜测的焦点。
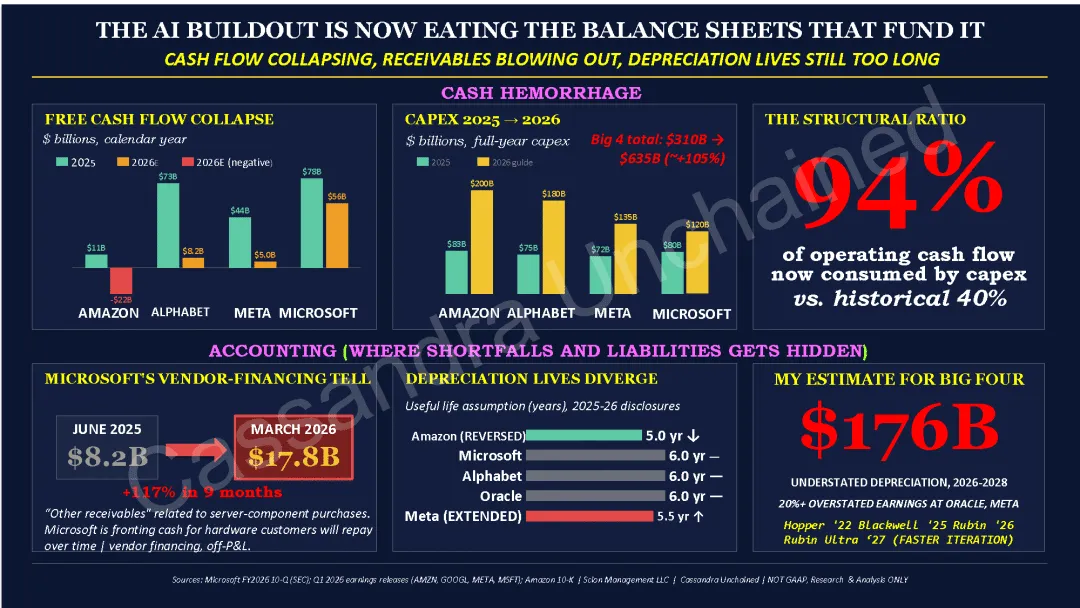
冰冷的现实是:现阶段,微软、Meta、谷歌、亚马逊4大科技巨头的自有现金,加上甲骨文靠债务融资获得的资金,以及各类外部投资资金,共同撑起了本轮算力基建热潮。用不了多久,OpenAI和Anthropic也将获得大量IPO资金。
现金尚未枯竭,至少4大巨头还没有。资金规模或许还会继续扩容,但目前各家依靠经营性现金流进行资本投入的空间已接近上限。企业接下来只剩下两条路:要么采用表外融资(off balance sheet),要么直接增加债务。边际新增的每一块钱资金,(其风险属性)已和过去截然不同。
另一个重要的资金来源,就是我们早有耳闻的“循环现金流”(circular cash flows,指多家企业之间相互投资、采购、融资形成的资金闭环流转)。下图展示了2个以英伟达为起点和终点的循环,但各公司之间还存在大量其他循环路径。我认为没有任何一张图表能完整把这些循环现金流呈现出来。
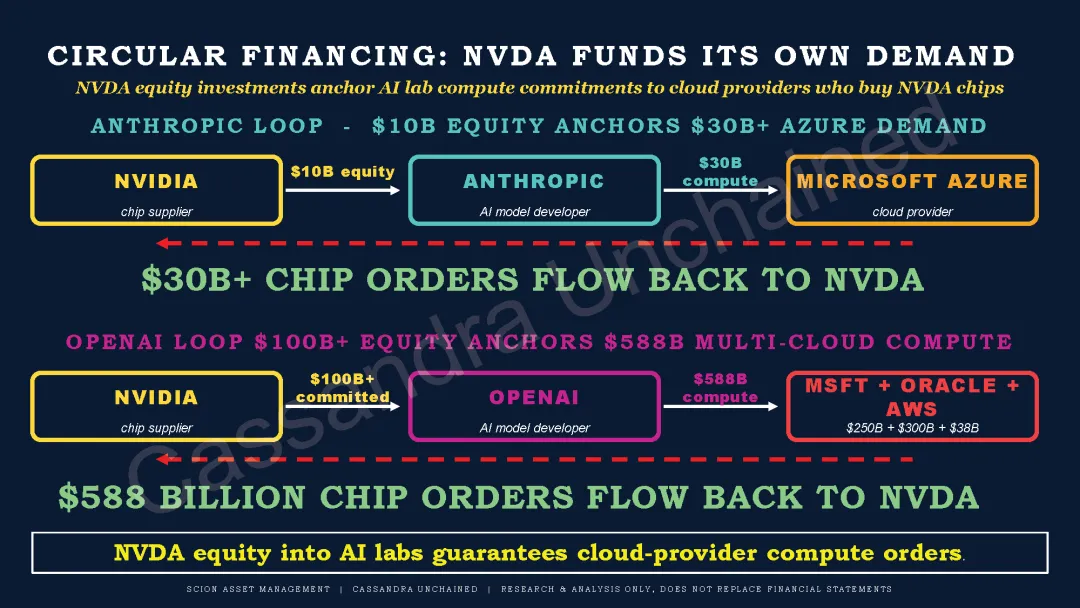
循环融资并非什么秘密组织、黑手党式的私下合谋。产业链里每一个市场主体,都只是在做符合自身利益的理性决策:英伟达当然希望需求具备可预见性,为此竭尽所能锁定长期订单;AI实验室渴求算力资源;云服务商则需要租户消化闲置产能。但整条产业链的所有参与方,都在默认采信同一套叙事、同一套假设。而这套叙事和假设,恰恰建立短期需求信号之上,这也让整个融资体系极其脆弱。
我在此唯一想补充的一句是,而这几乎不言而喻:OpenAI做出的远期采购承诺,早已超过其自身体量能够承载的范畴。该公司预计几周内启动IPO,应该很快就会向SEC递交招股说明书,届时市场就能看清其真实财务状况。
整个行业都刻意回避了一个事实,那就是有近3万亿美元的资本开支承诺需要在近期完成,已远超几个最大云厂商的经营性现金流承载能力。行业甚至不得不依赖OpenAI这类持续烧钱、现金流严重失血的初创企业,充当循环融资链条里规模最大、最关键的一环。
这不禁让人疑惑,投资者的这份信心,究竟从何而来?
寿险公司会成为救星吗?
还有一条融资路径:以芯片、数据中心作为抵押资产开展结构性融资(structured finance)。备受市场热议的资金供给方主要分为两类:一类是大型私募股权机构背书的私募信贷基金(private credit funds);另一类是自保再保险公司(captive insurance companies,大型企业集团设立的专属保险机构,通常作为再保险主体承接母公司的保单负债与关联方债权投资,实现风险自留、资金内部闭环运作)充当最终接盘方,让整套业务闭环留在自家体系之内。
我仔细捋过一遍,情况完全属实,就连这种“内部近亲式操作”也确有其事。
至于这件事是否构成了当下的实质性风险,则取决于观察视角。
美联储发布过一张示意图,直观展现了近年来寿险公司在高风险融资链条里扮演的核心角色。
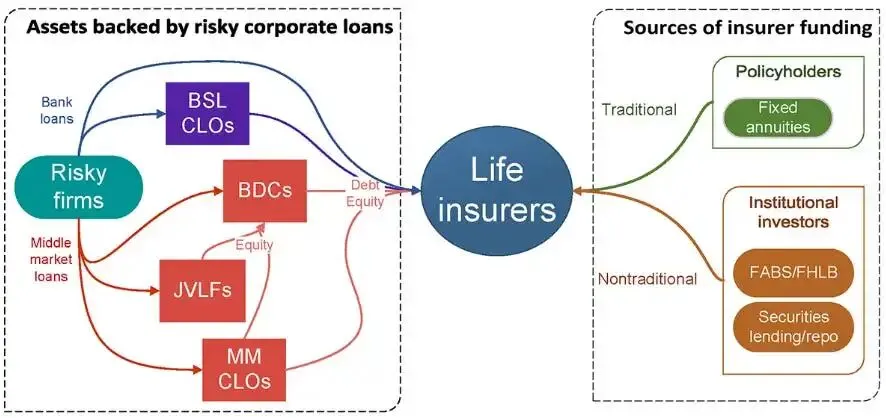
事实上,早在2023年AI热潮兴起之前,那些寿险公司就已显现出危险的趋势:它们配置高风险债务(risky debt)的比重在快速攀升。
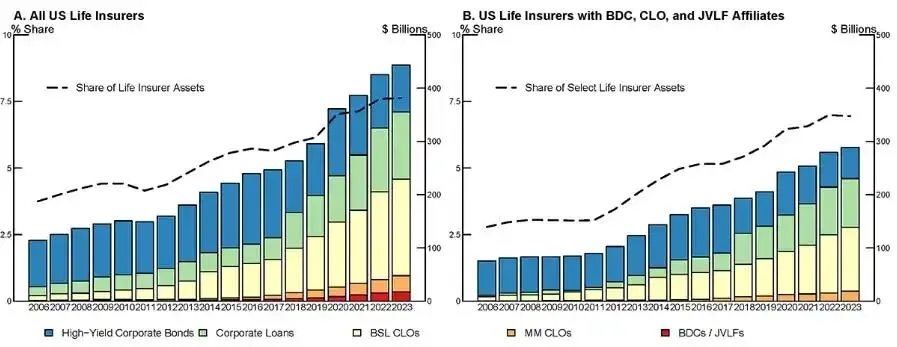
请注意,相关资产规模已达数千亿美元,这也预示着接下来将会发生些什么。
照目前形势来看,下一个AI风险买家、下一个资金提供者,可能压根不是AI企业,而是地球上最保守、最乏味的保险公司——寿险公司。
寿险公司早已在为AI数据中心建设提供融资支持。大都会人寿(MetLife)一直在发行以数据中心为底层资产的资产支持证券(Data-center-backed ABS),该证券以15-19年期的租金收入作为抵押担保。
大都会人寿之所以这么做,是因为它向美国工薪阶层销售长期退休年金产品,需要配置长久期资产(long-duration assets)来匹配年金业务形成的负债,保障未来年金足额兑付。过去,这类标的主要就是企业债、住房抵押贷款,如前文图表所示;如今,则越来越多地转向数据中心ABS,为AI数据中心建设提供资金。
不过,这些资金会绕道离岸市场完成迂回流转。自2023年AI热潮开启后,几年间,百慕大已涌现出200余家自保保险公司。
具体运作模式如下:大都会人寿发行年金产品后,会在百慕大设立一家由自身控股的实体。这家美国保险公司随即把风险分保给该百慕大再保险实体。该实体属于自保再保险公司,设立初衷就是承接母公司(大都会人寿)的保单负债再保险业务。
百慕大的资本金监管规则(比美国本土)更为宽松。因此,自保再保险公司资产负债表上承接过来的保单/年金风险,所需计提的监管资本更少,也就意味着它配置资产时可以使用更高的杠杆。对于美国本土保险公司定价偏高或是风险过高的资产,在百慕大自保再保险机构眼里,成本压力会小很多,投资价值也更高。
关键是,百慕大这类自保再保险可以给出更高报价、抬高资产竞价。这一点在私募股权、私募信贷等资管圈子里尤为重要。
猜猜这些百慕大实体都买了些啥?正是数据中心ABS、担保贷款凭证(CLOs,collateralized loan obligations)、高收益企业债(High Yield corporate debt),还有私营软件企业的债务——这类资产若在美国境内大规模持有,需占用极高的资本。这些自保再保险机构,就像是可以扩容的“垃圾袋”,几乎什么资产都能往里装(These captive reinsurers are like expandable garbage bags that can take just about anything)。
大都会人寿是一家上市险企,它将一部分自己发行的数据中心ABS留在表内自持,剩余部分则划入旗下百慕大自保再保险公司的资产负债表。
并非所有寿险公司都是上市公司,也有非上市公司。而当下,这类非上市寿险公司很多都由私募股权机构(PE)控制。
PE机构为何要收购寿险公司?PE通常拥有大量流动性较差的投资,需要寻找出路。私募开展投资,而寿险公司则可投资于支撑该PE投资项目的债券及其他证券。
PE机构可以在百慕大设立自保再保险公司,将保单风险转移至离岸实体的资产负债表,享受更宽松的资本监管要求。这就如同拿到一个可以扩容的“垃圾袋”,几乎什么资产都能装,恰好契合PE的需求。因此,自保再保险机构可以配置更多高风险债务和证券,例如流动性不足的软件公司贷款,或是数据中心ABS各层级的份额(data center ABS tranches)。
阿波罗(Apollo)集团旗下寿险平台Athene就是典型代表。母公司连同多家自保再保险实体,表内堆满了投向各类高风险项目的私募信贷,既包括软件公司贷款,也包括数据中心贷款。
百慕大对这类离岸再保险业务的信息披露十分完备,勤勉的分析师可以轻松挖掘到相关细节。
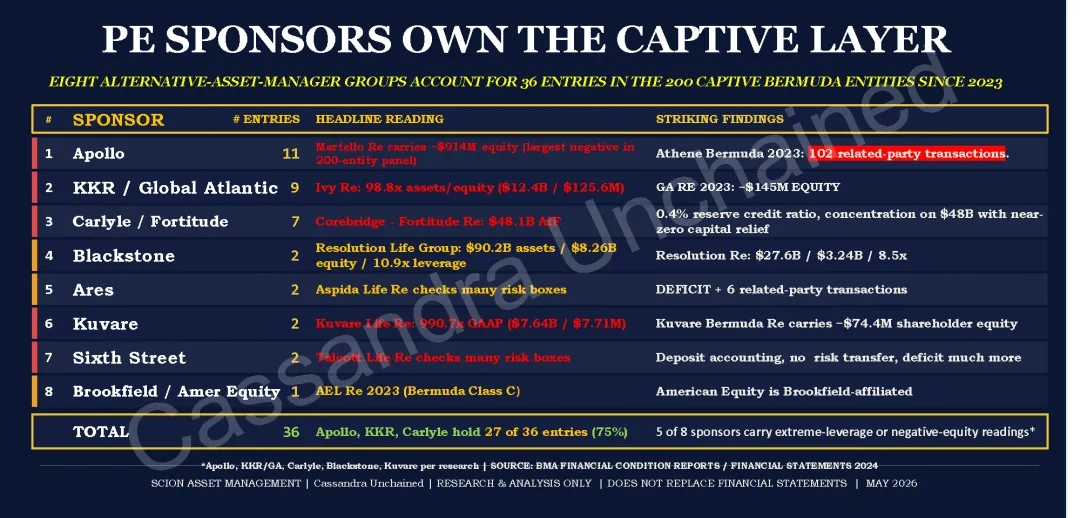
过去几年百慕大新增的200家机构当中,有36家是与PE相关联的自保再保险机构(PE-affiliated captive reinsurers)。
这些PE机构同时是私募信贷基金的主要出资方,而正是这类基金在创设、发行数据中心ABS。设立这类私募系自保再保险机构的目的,就是用来接盘自家发行的数据中心ABS。
那么,为什么美国上市寿险公司,以及私募控股的非上市寿险公司,要大费周章设立上百家自保再保险机构?
根源在于,数据中心ABS本身是一类风险很高的新型投资标的。
ABS通常是一篮子被分层切割的数据中心贷款(Tranche,资产池按照偿付先后顺序、风险高低拆分为优先级、中间级、次级等不同份额,优先级信用评级最高、违约风险最低),由评级机构出具信用评级。分层之后,各层级证券拿到的评级,高于单笔贷款、甚至高于整个贷款资产池本身所能拿到的评级。
这套(分层证券化)结构,和我20年前做空的住房抵押贷款支持证券(residential mortgage-backed securitizations,次贷危机前美国主流的地产信贷证券化产品,也是2008年全球金融危机的核心风险源头)的结构如出一辙(注:参考电影《大空头》里玛格特・罗比的讲解片段)。
期限错配(duration mismatch)是症结所在。
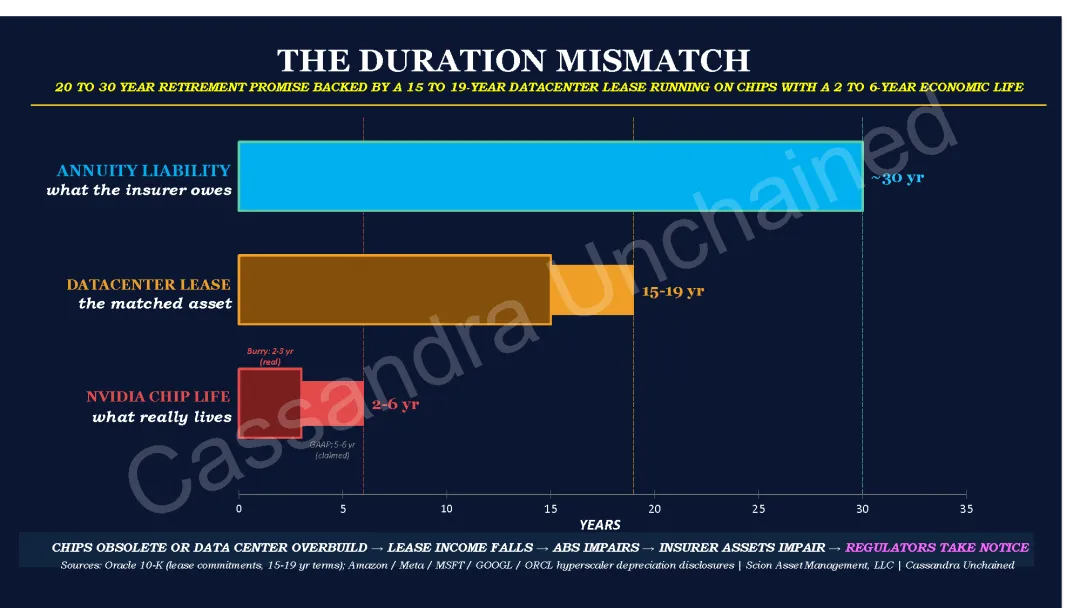
归根结底,问题在于这些贷款是不是优质贷款?在我看来,它们实在谈不上优质。融资架构里,超大规模云厂商作为项目发起方,为其数据中心贷款提供宽松的兜底保障。但这类发起人支持协议的担保效力十分薄弱,合同里设有大量免责退出条款:施工延期、电力供应故障,哪怕只是短暂停机,云厂商都有权拒付租金。
2025年微软就曾以供电问题为由,终止了多份数据中心租赁协议。Meta也采取过同样操作。
更为关键的是,一旦发生相关性风险事件(correlation event)——即同批次所有AI数据中心资产价值同步承压——这套兜底机制就会失效。该兜底机制叫做残值担保(Residual Value Guarantee,RVG,承租方承诺,若退租时物业处置价值低于约定金额,由承租方补足差额的增信条款)。穆迪(Moody's)对此风险作出如下说明:
“残值担保起到兜底作用:若科技企业终止租约或选择不续约,且那时数据中心市场价值已跌至事前约定的阈值以下,那它必须向物业业主补足差额部分。”
但若发生相关性风险事件,同一批次数据中心价值集体承压,残值担保这一兜底机制就几乎形同虚设(根本起不到保护债权人的作用)。
但凡出现足以令AAA、AA评级的云厂商放弃数据中心租约的情形,很大概率就在经历一次相关性风险事件。
穆迪测算,微软、亚马逊、谷歌、Meta、甲骨文5大云巨头,合计存在6620亿美元表外承诺义务,而美国公认会计准则(GAAP)允许它们将这类负债隐匿于表外。穆迪原文如下:
“若企业判断租约续约存在可能性,但达不到“合理确定”(reasonably certain)的标准,就无需将续约期支出、残值担保义务确认为负债。哪怕续租概率达到60%,相关义务依旧可以不在表内列示。”
但一旦出现相关性风险事件,这些隐性负债会一次性浮出水面。届时云厂商可不会善意配合那些数据中心放贷人(注:数据中心放贷人/业主本质是那些提供融资资金的金融保险机构)。
倘若局势恶化,保险监管或将出手干预。一旦监管收紧,AI数据中心第三大资金供给渠道就可能收缩出清。边际层面,大量数据中心项目可能被搁置或折价变卖。考虑到彼时市场对AI板块的情绪,最终会触发何种连锁反应,目前无法预判。
还有一层潜在隐患:两家开展百慕大离岸业务的大型寿险母公司,还被发现在美国得梅因和纽约的联邦住房贷款银行(FHLB,Federal Home Loan Banks,美国由12家区域性银行组成的政策性银行体系,主要为存款类金融机构、保险公司提供低成本批发融资,资金利率显著低于市场化私募信贷)持有大额借款。
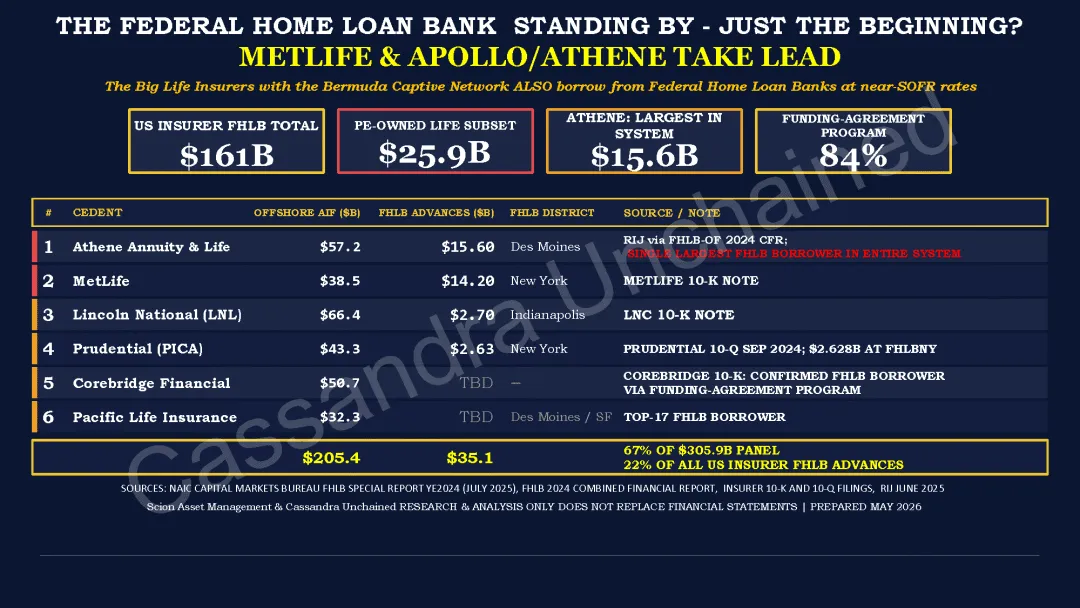
这或许仅仅是开端:保险公司参与数据中心建设(包含配套电力设施与商业地产),正在开辟一条新的资金渠道。
保险公司为何要借助联邦住房贷款银行融资?因为它是个低成本资金渠道,而当下AI基建的资金需求规模十分庞大。FHLB这个案例足以说明,本轮算力基建的融资触角已经延展到何等程度。摩根士丹利测算,到 2028 年,由保险公司出资支持、私募股权机构运作的私募信贷(private credit,不在公开交易所发行、由私募机构向企业直接投放的非标债权融资,是当前数据中心、算力基建项目最主要的融资方式之一),需要为AI基础设施建设提供8000亿美元资金,约占同期2.9万亿总规划资本开支的三分之一。
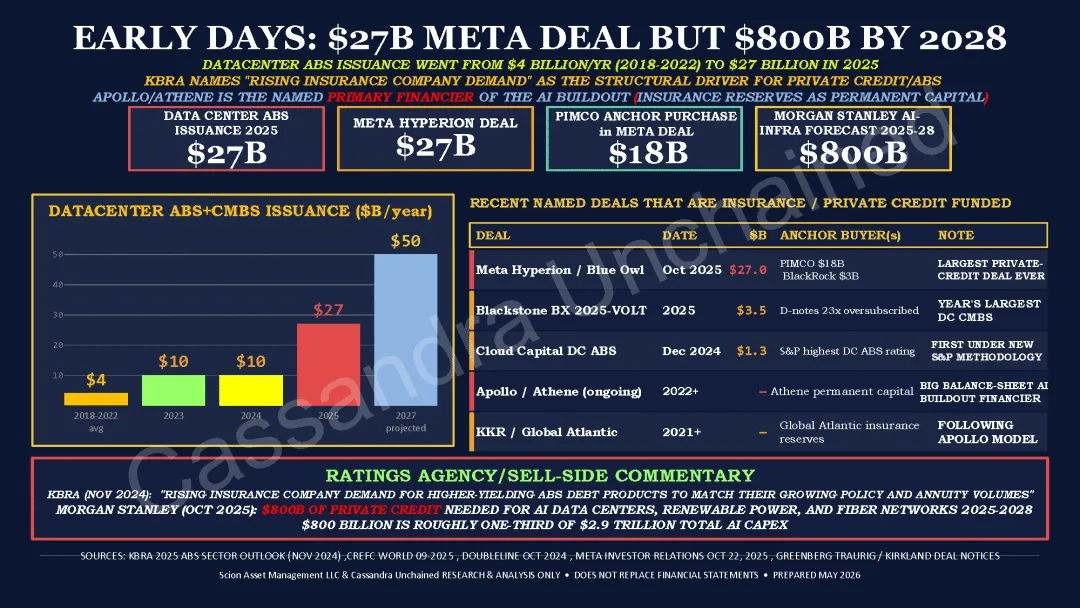
倘若数据中心实际需求不及规划预期,或是数据中心的经济价值折旧速度远快于对应贷款的摊销节奏,那当第一只“金丝雀”倒下时(注:指某个主要的市场主体率先爆雷,预示行业系统性风险正在发酵),就要由FHLB、保险监管机构以及各大评级机构(包括保险行业评级机构)来判定行业出事了。
数据中心建设阶段,银团通常会提供2-3年期只付利息的建设贷款,用于工程建设。等到租户(超大规模云厂商)入驻后,长期置换融资(permanent financing,项目建成运营后用来替换短期建设贷的中长期债务融资,匹配不动产长久期运营属性)会进场,换掉前期建设贷款。
这类长期置换融资,可以是前文提到的ABS、私募配售的债券(privately placed bond),也可以是来自保险公司或私募信贷基金的直接贷款。
如前文所述,当前数据中心ABS市场规模尚小,去年Meta那一单交易几乎就占据了市场全年总量。保险公司与旗下设有私募信贷、保险板块的私募机构已做好承接准备,只不过受软件行业疲软影响,实力略有折损。
而它们最好能顶上资金缺口。瑞生国际律师事务所(Ropes & Gray)发布的《2026年数据中心行业展望》预测,当前在建的数据中心,需要2750亿美元长期置换贷款,来替换存量建设贷款。未来2年左右,要么ABS市场实现扩容,要么私募信贷(私募股权、保险资金)加大直接放贷力度…
已有迹象表明,发放建设贷款的传统银行,已经开始对行业后续走势做出判断(注:指收紧风控)。私募信贷机构Pere Credit今年2月5日的观点:
“为甲骨文配套建设项目提供融资的银行,正把手中的贷款份额出让给商业地产私募信贷机构,这也倒逼市场(对底层项目)开展更为审慎的风险评估。”
如果一个人长时间跟踪这些东西,就能充分理解Pere Credit的此番警示。
这正是账面虚增繁荣开始停滞、陷入思考、甚至走向收缩的前兆。当初发放甲骨文Stargate项目建设贷款的银行,如今正在减持相关头寸,或许就是因为对甲骨文的风险敞口过于集中。接盘方是各类私募信贷基金,其中不少基金的控股股东或关联方,正是设立百慕大自保再保险主体的那批私募股权机构。
正如我在《Software & Payments Stocks Part 1》中所分析的,这类私募信贷基金还面临另一重难题:它们持有太多流动性很差的私营软件公司贷款,并且已经开始对这类资产计提减值。部分私募机构还可能持有一两家陷入困境的软件公司股权。
这就引出一个悬而未决的问题:当近3000亿美元建设贷款集中到期、需要大规模置换融资时,私募信贷市场能否保持充足的承接能力?
别忘了,受“词元极致消耗”这套机制影响,我们有理由对现有及未来新建数据中心的终端需求感到担忧。此外前文也提到,未来还存在19吉瓦的电网供电缺口问题。
至此,整条逻辑闭环就已完整,本篇分析就到这里。
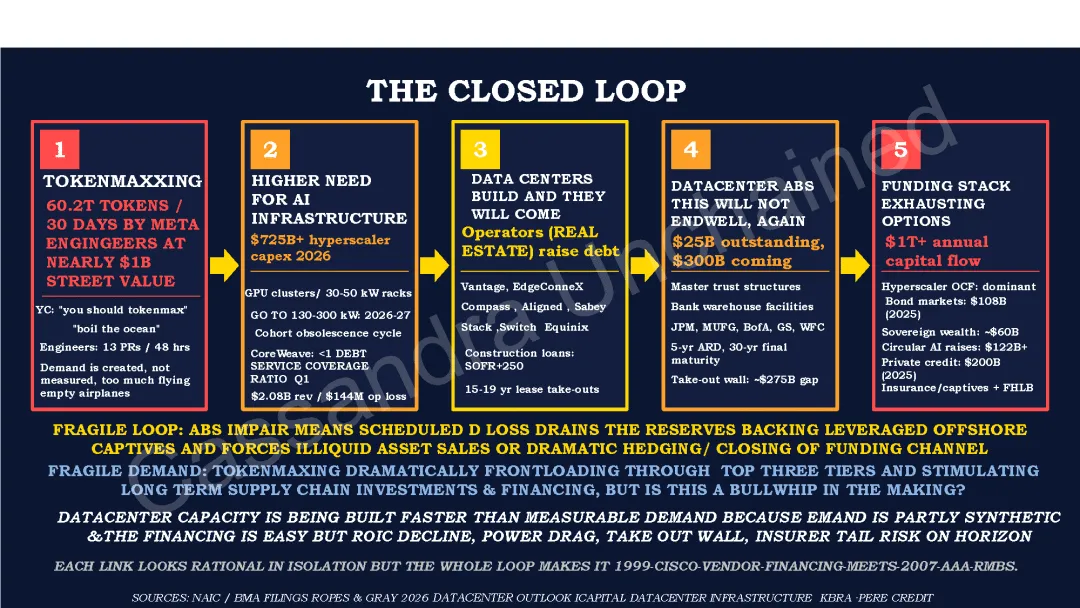
总结...
从个体经营角度,企业推行词元极致消耗大多是理性的,但却营造出算力需求永无止境的假象。
这一虚假需求信号沿着产业链向上传导,从英伟达到台积电的定制化芯片产线,而向下则催生出大量建设贷款,这些贷款到期后,需要长期置换融资接盘。由于贷款规模庞大,市场不得不依靠保险公司、私募信贷、离岸自保再保险公司共同承接,才能维持这场“账面虚增繁荣”。
所谓“虚增繁荣”,并非是指AI本身的价值是虚假的。而是说,市场把AI落地过程中成本最高的需求阶段,当作了未来常态化需求,并以此进行资本化定价。基准测试不代表真实生产力,模型训练不代表性能表现,而词元极致消耗(即依靠员工内卷竞争、疯狂刷词元)所形成的需求,也不能被视为基建投资长期需求的可靠指标。
需求收缩已经开启,并且会持续深化:企业开始缩减第三方大模型词元调用量,沿着产业金字塔向上升级,用自研方案完成替代,用小参数模型、上下文缓存、优化工作流调度等手段压低算力消耗。
所以,桑恩说的没错,他们不过是在到处飞空载航班罢了。这种行为唯一具备合理性的阶段,就是在航空产业发展初期。在此阶段,飞行员需要累积飞行时长、工程师需要采集数据、监管机构需要磨合规则。这种轰轰烈烈、不计成本的基准测试阶段,是任何有价值的新兴产业,在起步初期必然经历的过程。
但这种局面无法长期维持。