ARTICLE · 1114238
同一道题让 AI 写了 169 遍,Dots 狂玩 5 小时 32 分钟,Opus 指挥 GPT 包揽前三,Claude 自己下场只排第四和第六!
Opus 指挥,Codex 写代码
【旧智元导读】 炸裂!太突然了!最近热度很高的 OpenAI 新产品 Dots,被我请来当了一回裁判。它在自己的云电脑里,把 169 件 AI 作品全部打开,亲手玩,亲手打分,足足干了 5 小时 32 分钟。这 169 件作品出自同一组四道题,其中 160 件是我让 Claude Opus 5.5 通过 Codex 插件,指挥 8 个不同的 GPT 模型做出来的。再加上 GPT-6 Pro 先后两轮的评分,三次打分合起来,前三名全部是 Opus 指挥、GPT 动手写出来的!开到 max 档的 GPT-6.1 Sol 拿下综合第一,成本只有 Opus 自己动手的八分之一,Sonnet 只排第四,Opus 只排第六!更让人后背发凉的是,Opus 做的珠江夜游被打出了 76、97、93 三个分数,GPT-6 Pro 评了两轮,四道题的第一名居然一个都没有重样!看完这份数据,我瘫坐在椅子上,那一刻就像看到了原子弹爆炸!
❋ ❋ ❋
半夜,Opus 在自己写的代码里找到了一个让页面卡死的 bug
Opus 5.5 做过一个广州珠江夜游的网页,水面和夜空是四十多个版本里最好看的几个之一。可是裁判 GPT-6 Pro 把它打开三次,有一次动画直接停住,再也没有动起来。
Opus 顺着代码往下查,发现问题藏在一个几乎没人会留意的地方。程序先记下了一个时间,然后才去请求第一帧画面,而浏览器交给第一帧的时间,有可能比记下的这个时间还要早。第一帧的时间差于是变成了负数,时间在程序里倒退了一小步,广州塔灯光的颜色编号随之算成了负 1,程序找不到对应的颜色,当场报错,整个循环就此停止,满城夜景凝固在了那一帧。
找到原因以后,Opus 没有自己动手改。它通过 OpenAI 为 Claude Code 推出的官方 Codex 插件,写了一段说明,把修复任务交给了 GPT-6.1 Sol。三分钟后 Sol 交回结果,只改了两行,另外补了一个测试,按 API 标价折算,这次一共花了 14 美分。Opus 看完改动,跑完测试,又亲手打开页面检查了一遍,验收通过。
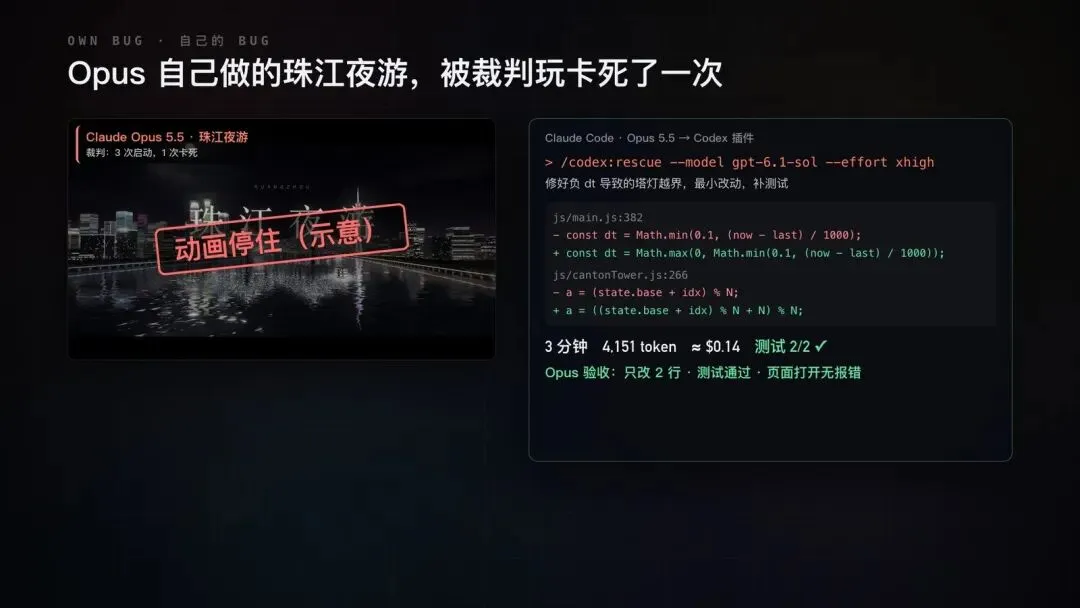
Opus 找到自己的 bug,派给 Sol 修
这件小事,让我想明白了这几天最大的收获。
在 Claude Code 里让 Opus 当总指挥,把写代码的任务交给 GPT,日常任务交给 GPT-6.1 Sol,特别难的任务交给 GPT-6 Astra,结果又好又便宜。
这个结论来自一场规模不小的测试。这几天 Opus 替我指挥了 160 个 Codex 任务,加上对照组,一共做出 169 件能玩的作品,再请两位裁判逐件亲手玩、亲手打分。第一位是 GPT-6 Pro,评了两轮,第二位就是最近很火的 Dots,独立评了一轮。
❋ ❋ ❋
Opus 通过官方插件,把写代码的任务分派给 GPT
装这个插件很简单,在 Claude Code 里输入两行命令就能完成。装好以后,Opus 可以随时把任务连同验收标准一起交给 Codex,分派时能指定使用哪个 GPT 模型,也能指定推理档位。插件里最高能直接开到 xhigh,想用 max 档的话,需要先把 Codex 的默认档位设成 max。
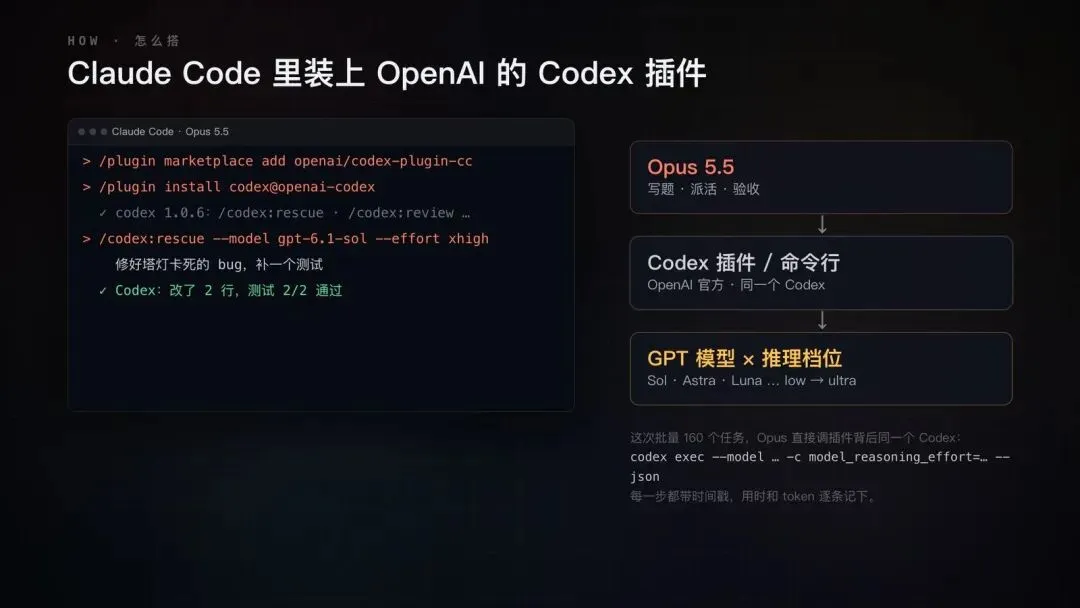
插件和指挥链
分工很清楚,Opus 负责把题目和验收标准写清楚,负责分派任务,也负责最后检查结果,真正的代码交给 Codex 来写。这次一百多个任务都要逐条记录用时和 token,所以批量测试时,Opus 直接调用的是插件背后同一个 Codex 命令行工具,每一步都带着时间戳,开头那次修复 bug 走的才是插件本身。
❋ ❋ ❋
四道题,8 个 GPT 模型,能测的档位几乎全部跑了一遍
四道题的题目一字不差,每个模型只发一次。第一道是七边形弹球,20 个带数字的球在一个慢慢转动的七边形里弹跳,球上的数字要跟着球一起转。第二道是方块世界,要能挖能放,有昼夜交替,还要能种下土豆,等它长熟再收获。第三道是太阳系逃逸,这是知乎上吵得很热闹的一个问题,太阳系是扁平的,往上飞能不能更快飞出去。第四道是珠江夜游,要有广州塔、海心沙和猎德大桥,夜游船沿着江面行驶,水里要有倒影,既能暂停,也能自由观看。
Opus 一共派出 160 个 Codex 任务,覆盖 GPT-6.1 Sol、GPT-6 Astra、GPT-6 Sol、GPT-6 Luna、GPT-5.6 Sol、GPT-5.6 Terra、GPT-5.6 Luna 和 GPT-5.5 这 8 个模型。除了 Astra,其余模型能开的推理档位都测了一遍,从 low 一路到 ultra。Astra 只测了 high 和 xhigh 两档,其他档位没有测,原因是我的额度不够用了。
对照组让 Claude Sonnet 5.5 和 Opus 5.5 在 Claude Code 里自己从头做,各做 4 件。同样因为额度不够,它们都只用了一个档位,其他档位没有测,Claude Fable 也没有参与这次测试。另外 Dots 自己做了方块世界这一道。加在一起是 43 个配置,169 件作品。
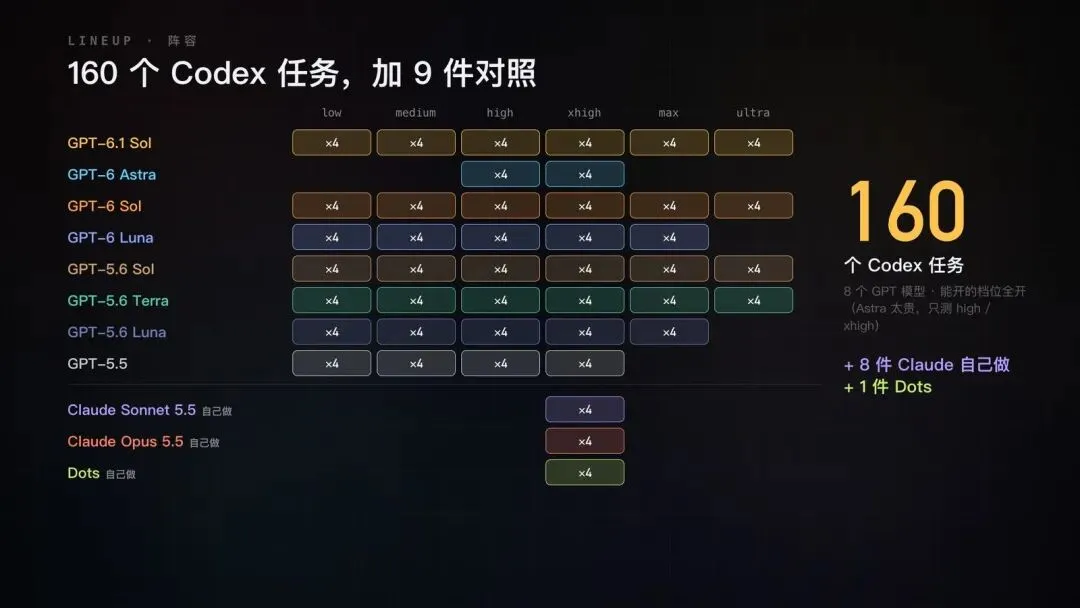
43 个配置
❋ ❋ ❋
日志最后一行写着结束,11 个任务却一个都没有完成
当指挥并不只是发号施令。测试进行到半夜,11 个 Sol 的任务因为断网失败了,可是日志的最后一行,照样写着结束二字。
Opus 一开始把这些任务当成已经做完,还这样向我做了报告。我回头逐个核对,发现这 11 个任务没有一个真正完成,其中 8 个连服务都没有连上,另外 3 个做到一半断了线,之后一个多小时都在不停重连。
从那以后我们定下规矩,一个任务必须同时满足三个条件才算数,程序正常退出,Codex 自己报告任务完成,作品文件确实存在。这 11 个失败的任务全部在干净的目录里重新运行,最终采用的是重跑的结果。
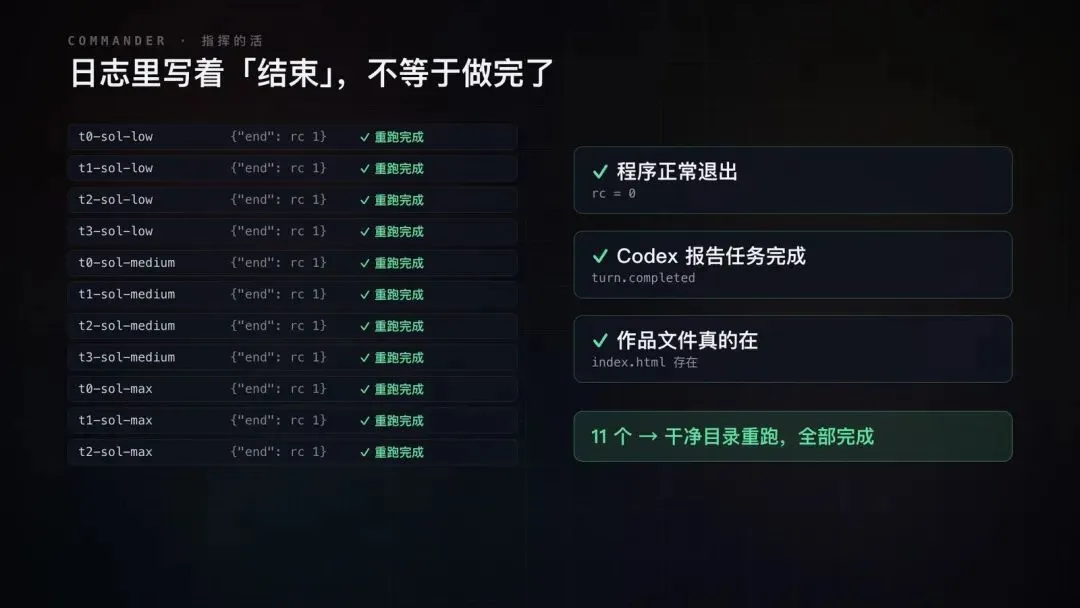
三条验收
任务派出去得越多,越容易出问题的环节就越靠近收尾,也就是以为已经做完了。执行者自己的汇报,必须有独立的证据来确认。
❋ ❋ ❋
裁判 GPT-6 Pro 自己装好浏览器环境,把每件作品都亲手玩了一遍
打分先交给 GPT-6 Pro,在 ChatGPT 网页上用 Pro 思考完成。每道题四十多件作品,都去掉了名字,打乱编号,打包成可以直接运行的压缩包,放进同一个对话里,用同一把尺子来评,我们自己拍的截图只作为参考。
裁判的做法让我很震撼。它自己装好浏览器环境,一件一件点击开始,按键盘,拖动视角。评方块世界的时候,它用虚拟时钟推着时间往前走,让土豆长熟再去收获。评太阳系的时候,它另外跑了 431 个数值案例,参考值全部由它自己算出。第一轮四道题它分别思考了 43、71、54、66 分钟,加起来将近 4 个小时。
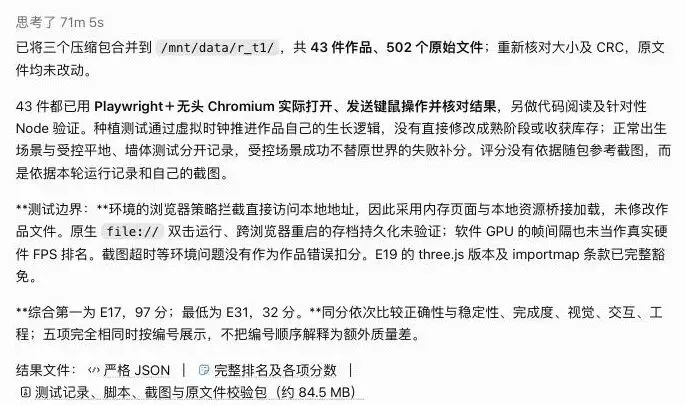
裁判的回复开头
评法换了以后,名次也跟着变了。上一期裁判看的是截图加代码,Sonnet 5.5 的均分是 87.25,排在倒数第二,这一期涨到了 94.25,其中太阳系那一题从 84 分涨到 96 分,原因在于截图看不出物理计算是否正确,实际跑一遍就一目了然。Opus 的珠江夜游正好相反,从 83 分掉到了 76 分,原因就是开头那个卡死的 bug。
裁判也有看漏的时候。上一期它在 Sonnet 和 Opus 的太阳系作品里各抓到一个问题,我们核实过,这一期两处都没有扣分。两期的评分方法不同,分数不能放在一起比较,裁判点名的关键问题,Opus 都拿回代码里逐一核对过。
❋ ❋ ❋
同一件作品被打了 76 分,也被打了 97 分
第一轮分数出来以后,我本来想把四道题的分数直接平均,排出一个总榜。动手之前我突然意识到一个问题,四道题是在四个独立的对话里评的,弹球对话里的 90 分,和珠江夜游对话里的 90 分,未必是同一把尺子,直接相加,等于默认四把尺子一样长。
我把这个问题拿去和 GPT-6 Astra 一起推敲,它提醒了我一点原本没想到的地方。把 169 件作品塞进一个对话,并不能让四道题里的一分变得一样值钱,因为作品一多,排在后面的会检查得不够细,先看到的作品又会成为后面所有评分的参照。
最后的办法是再评两次。第一次是 GPT-6 Pro 的第二轮,每道题新开一个对话,作品重新打乱编号,从头再评,四道题分别思考了 45、67、58、67 分钟。第二次交给 Dots,这是 OpenAI 刚推出的产品,背后用的是 Astra 模型,目前首月免费,额度不限。我让它在自己的云电脑里把 169 件作品全部打开,自己玩,自己打分,它一口气干了 5 小时 32 分钟。
三次打分下来,谁前谁后大体一致,每道题两两比较,名次的相关系数在 0.85 到 0.97 之间,1 代表完全一致。可是第一名极不稳定,GPT-6 Pro 评了两轮,四道题的第一名一个都没有重样!
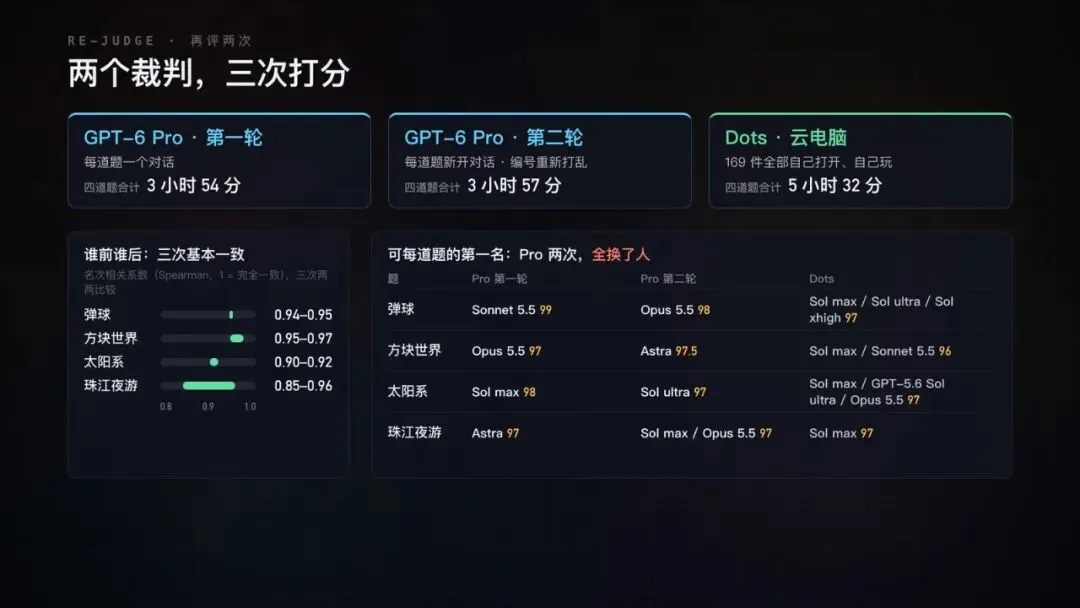
每道题的第一名,Pro 两轮全换了人
最典型的是开头那件 Opus 的珠江夜游,第一轮 76 分,第二轮 97 分,Dots 给了 93 分。卡死是偶发的,第一轮碰上了,第二轮没有碰上,同一件作品因此得到了截然不同的评价,分差高达 21 分。
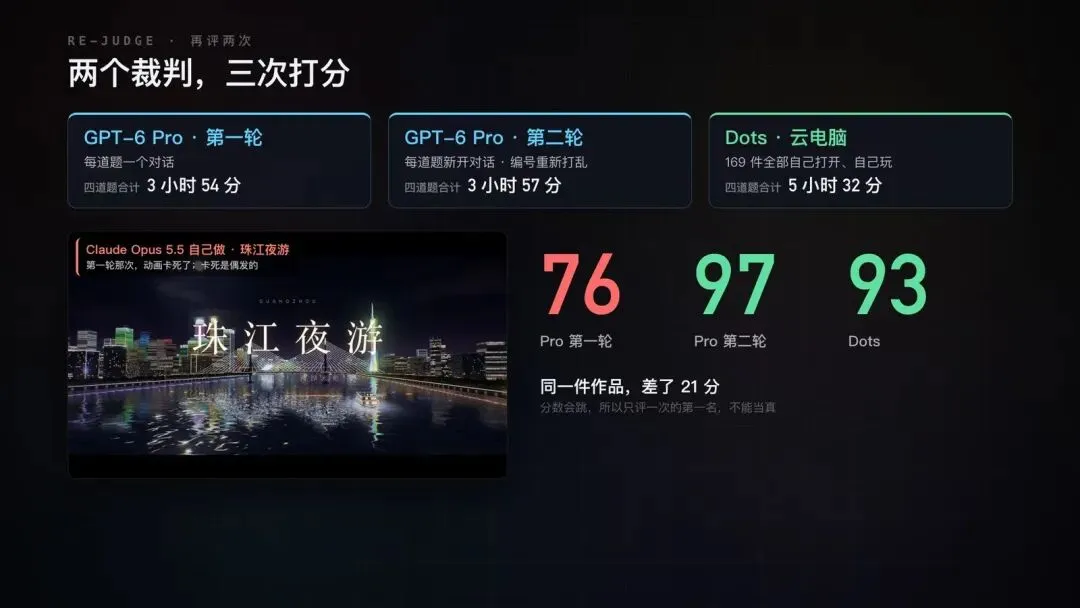
同一件作品,差了 21 分
所以总榜不比原始分,比名次。具体算法是,每道题、每次打分,都把 42 个配置排出名次,换算成 0 到 100 分,第 1 名是 100,最后一名是 0。GPT-6 Pro 的两轮先取平均,再和 Dots 各占一半,最后把四道题平均,得到的就是下文说的综合分。它说明的是谁排在前面,并不衡量前后差了多少分。
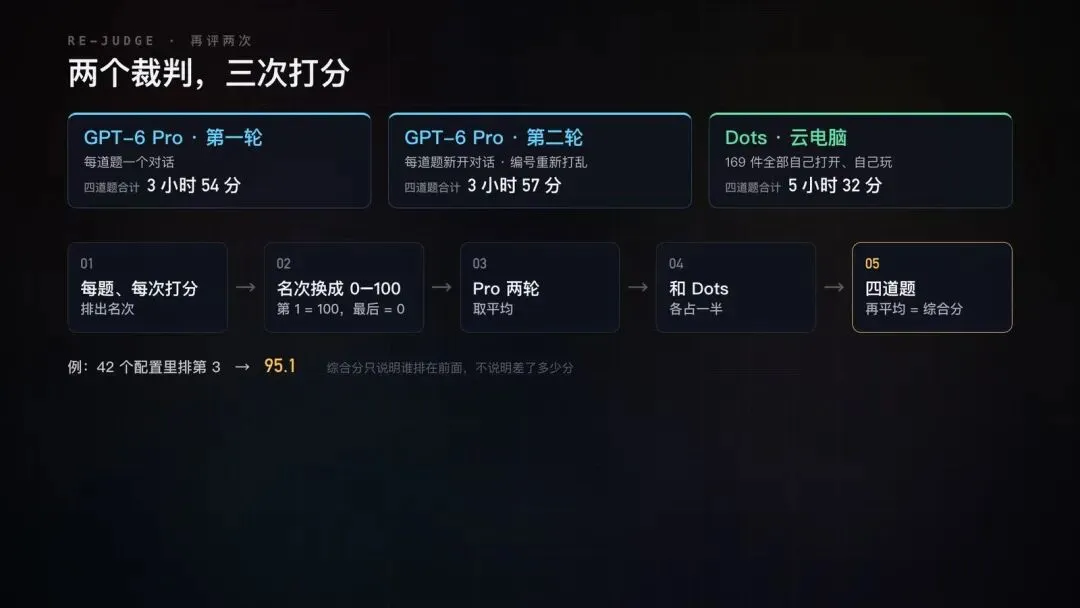
综合分怎么算
Dots 也有没有测到的部分。方块世界一共 43 件作品,它完整走通种下、长熟、收获整个流程的有 27 件,太阳系有一件作品的缩放操作对它没有生效,珠江夜游有一件作品的控制栏被画面挡住,它点不到。更有意思的是,它评到了自己做的那件方块世界,给自己打了 91 分,扣分的理由是没有使用题目指定的三维图形库版本。这一条要求是我发题时漏写的,GPT-6 Pro 的两轮评分都没有因此扣分,分别给了 94 分和 95.5 分,Dots 自己却照样扣了,所以这件作品不计入总榜,只在方块世界那一题里单独列出。
❋ ❋ ❋
榜单出炉,前三名全部是被 Opus 派出去的!
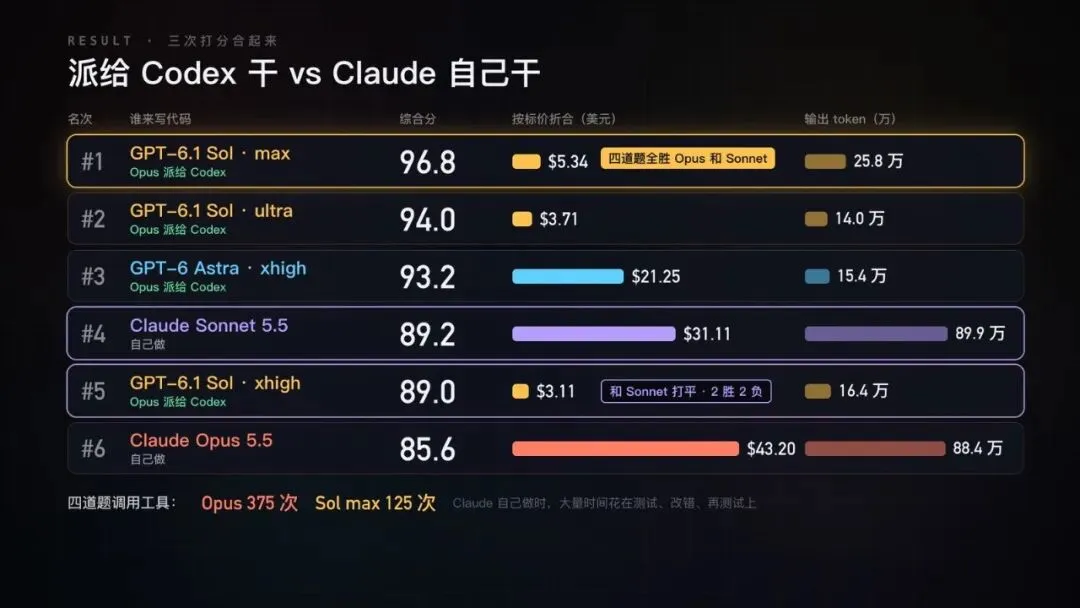
三次打分合在一起,四道题等权重,结果如下。
表里派给 Codex 的几行,只统计了 GPT 在 Codex 里写代码的花费,Opus 当指挥时自己用掉的 token 没有按题拆开,没有算进表里。Claude 自己做的两行,是它在 Claude Code 里做题的全部消耗,用的都是同一个档位,没有测试其他档位。所有金额都是按官方标价折算的等价金额,我实际使用的是订阅额度。
派给 Codex vs 自己做
综合第一是开到 max 档的 GPT-6.1 Sol。四道题里它每一道都排在 Opus 和 Sonnet 前面,随便拿掉哪一道题重新计算,它依然是第一。它做完四道题花了 5.34 美元,大约只有 Opus 自己做的八分之一! 前三名全部是 Opus 派给 Codex 的,Claude 自己下场做的作品里,Sonnet 排第四,Opus 排第六。
再看第 4 名和第 5 名,Sonnet 自己做的综合分是 89.2,派给 Sol 开 xhigh 的综合分是 89.0,四道题两胜两负,水平相当,花费却是 31.11 美元对 3.11 美元,相差整整十倍。
钱花在了哪里,从调用次数上看得很清楚。Claude 自己做的时候,大量时间耗在测试、改错、再测试的循环里,Opus 做完四道题一共调用了 375 次工具,输出约 88 万 token,Sol max 只调用了 125 次,输出约 26 万 token。
Claude 自己做的作品也有惊艳的时刻。GPT-6 Pro 第一轮里,弹球的第一名是 Sonnet,拿了 99 分,是全场唯一一件视觉拿满分的作品,方块世界的第一名是 Opus,拿了 97 分,它做成了无限世界,水会流动,还能养猪。第二轮里,弹球的第一名又换成了 Opus。只是这样的高光时刻花费高昂,表现也不够稳定。
❋ ❋ ❋
Astra 多花的钱买到了速度,在最难的两道题上排名也最靠前
Astra 做完四道题的花费,足够 Sol max 做四遍。多出来的钱花在哪里,难度排名给出了线索。
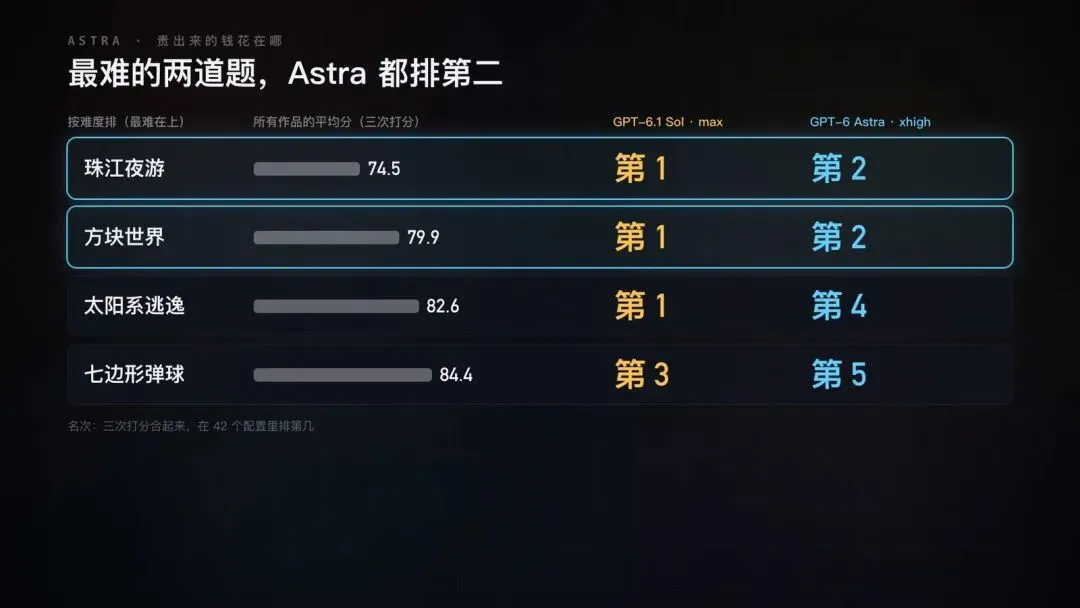
按所有作品三次打分的平均分来衡量,分数越低越难,珠江夜游是 74.5 分,方块世界 79.9 分,太阳系 82.6 分,弹球 84.4 分。在最难的两道题上,Astra 都排在第二,只输给 Sol max,在相对容易的两道题上,它只排到第四和第五。
最难的两道题,Astra 都排第二
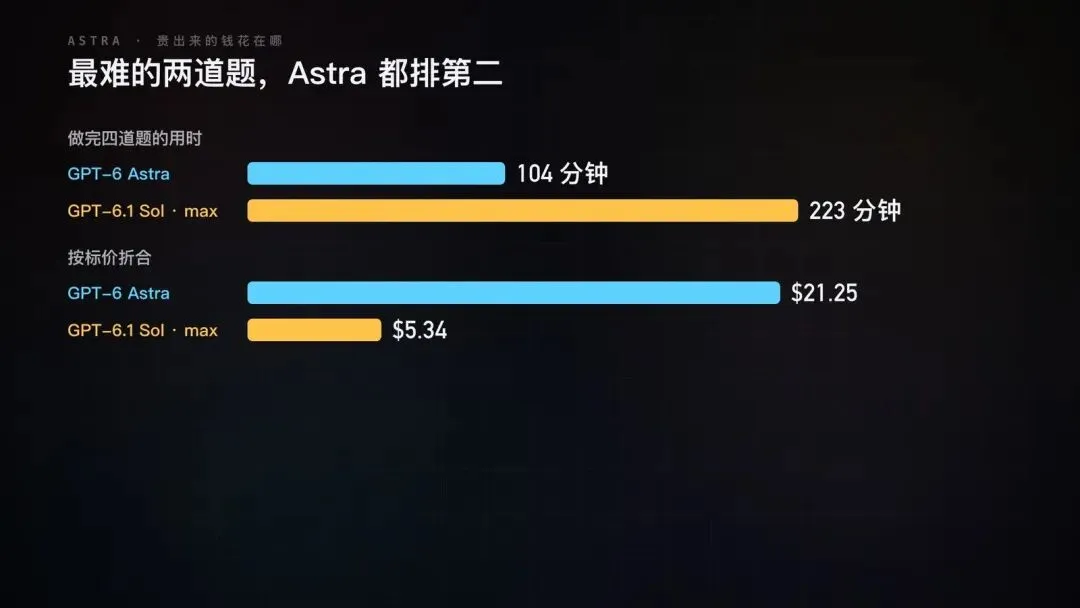
珠江夜游这一题,GPT-6 Pro 第一轮的第一名就是 Astra,拿到 97 分,小蛮腰、四片风帆、贝壳一样的单塔桥,加上水里位置对得上的倒影,全部做了出来。它还特别快,四道题一共只用了 104 分钟,Sol max 要 223 分钟,用时缩短了一半多,花费却是 Sol max 的四倍。
用时一半,花费四倍
我现在的分工因此很明确,日常任务派给 Sol,从 xhigh 起步,想要最好的结果就开到 max,又难又急的任务交给 Astra,Opus 坐镇后方,负责写题、关注进度、检查结果。Astra 更擅长难题,目前只是从两道题里看到的倾向,还谈不上定论,而且这次只测了它的 high 和 xhigh 两档,更高的档位表现如何,要等额度恢复以后再补测。在这四道题上,无论难易,综合分最高的始终是 Sol max。
❋ ❋ ❋
推理档位越高分数越高,前排只差两分,名次却差了六位
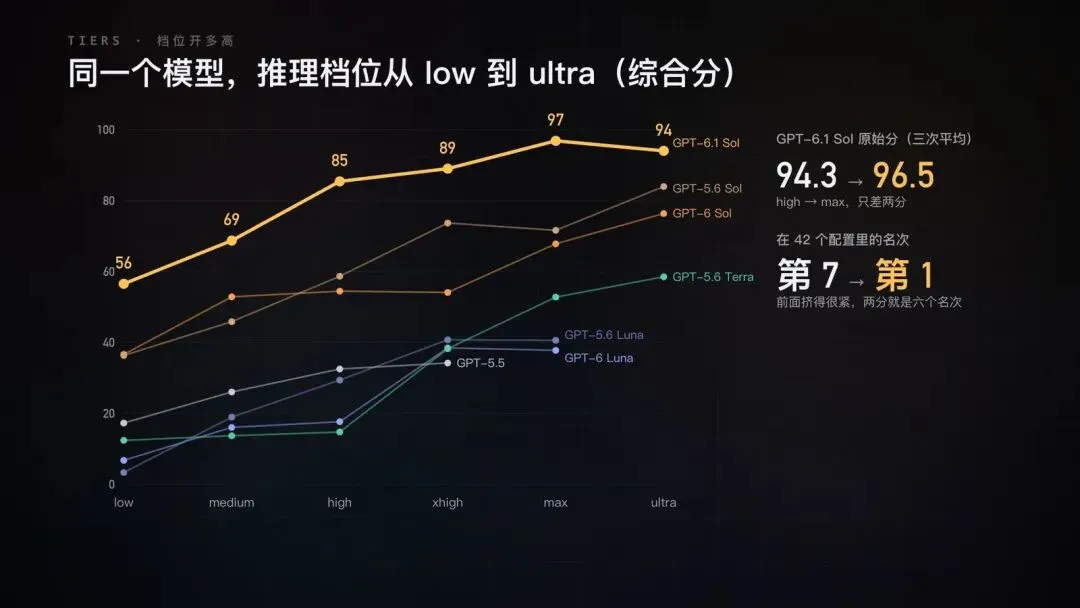
同一个模型,推理档位开多高,对结果影响很大。GPT-6.1 Sol 的综合分,low 档是 56,medium 档是 69,high 档是 85,xhigh 档是 89,max 档是 97,ultra 档是 94。
原始分也就是三次打分的平均分,其实挤得很紧,high 是 94.3,xhigh 是 95.0,max 是 96.5,ultra 是 96.0。前排实在太拥挤了,两分左右的差距,放在 42 个配置里,就是从第 7 名到第 1 名的距离。
档位曲线
代价是时间,max 做完四道题要 3 小时 43 分钟,high 要 2 小时 38 分钟,medium 只要 38 分钟。ultra 是在 max 的基础上再加上自动分派子任务,综合分反而比 max 低一截,每档只做了一次,分不清究竟是档位的差别,还是运气。
老一代模型就只能靠堆档位硬扛,GPT-5.6 Sol 开到 ultra,综合分 83.9,花了 35.74 美元,是新一代 Sol 开 max 的六倍多,分数反而更低。
❋ ❋ ❋
便宜的模型能省下大把钱,也交出了一批让人哭笑不得的作品
把 42 个配置画在同一张图上,横轴是做完四道题花的钱,纵轴是综合分,越靠左上越划算。
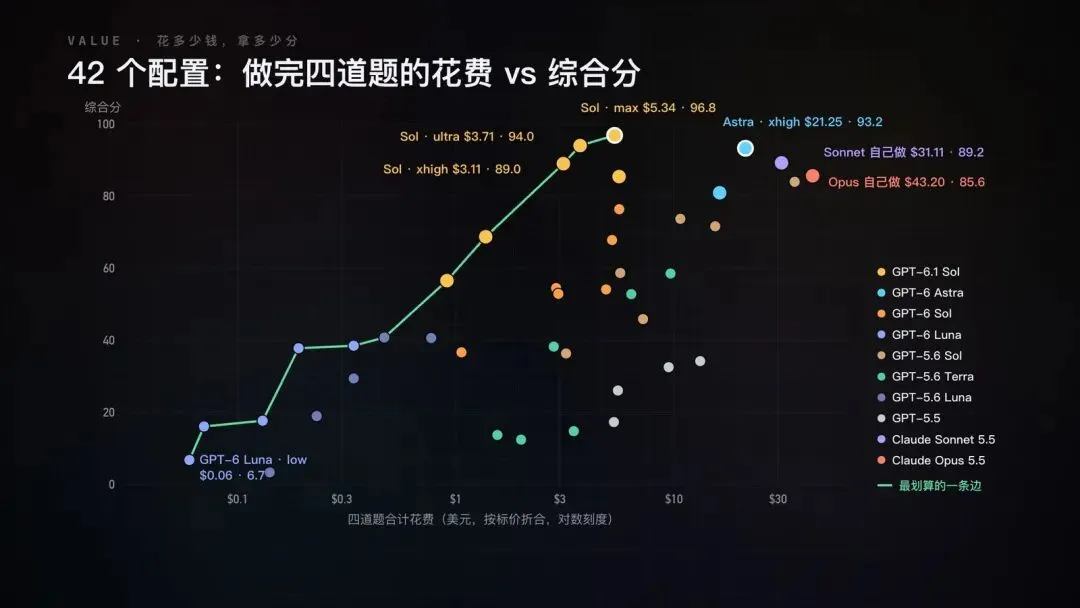
花费 vs 综合分
左上角那条边缘,从便宜到贵依次排列,最便宜的一段以 GPT-6 Luna 为主,再往上全部是 GPT-6.1 Sol。Claude 自己做的两个点都落在这条边缘的右下方,Astra 同样不在边缘上,分数比 Sol max 低,花费却是它的四倍。
Luna 的便宜是真便宜,GPT-6 Luna 开 low 档,四道题一共只花了 6 美分,开 xhigh 档也只要 34 美分,不过综合分也排在最后一截,分别是 6.7 和 38.4。便宜带来的代价,是一批让人哭笑不得的事故。
GPT-5.6 Terra 在方块世界里,high 档的作品三次打分是 33、38、35,玩家一出生就掉进了土里。世界生成时,每一块方块都摆在半格的位置上,可是走路和碰撞检测只认整数格,永远查不到地面。
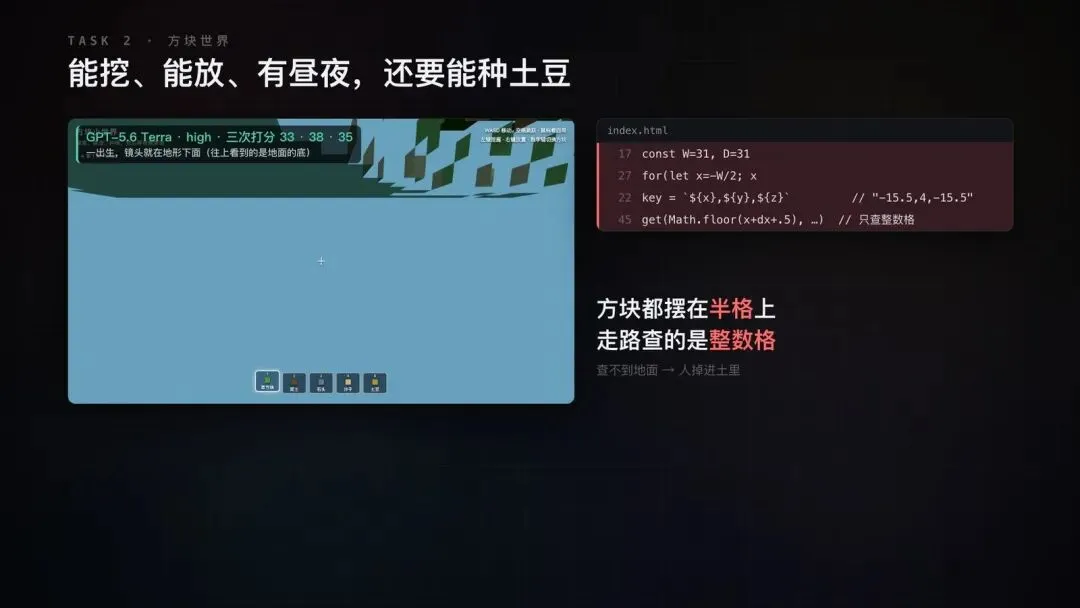
人一出生就掉进土里
GPT-6 Luna 在太阳系这一题里,xhigh 档的作品三次打分是 78、77、78,飞船会朝着相反的方向飞。逃逸轨道公式里的半长轴本来是负数,却被直接乘进了方向分量,所有能够逃逸的轨迹都被镜像了,裁判抽出它的物理函数跑了 5 个案例,确认了这一点。
GPT-5.5 在弹球这一题里,low 档的作品三次打分是 54、59、69,我们按裁判的测法自己重现了一遍,窗口缩窄到 420 像素宽以后,20 个球全部跑到了七边形外面,再也回不来,同样的操作,Sonnet 的作品纹丝不动。珠江夜游里还出现过塔悬在半空、塔被拉成两头尖的透镜、控制按钮被画面整个盖住点不到的情况。
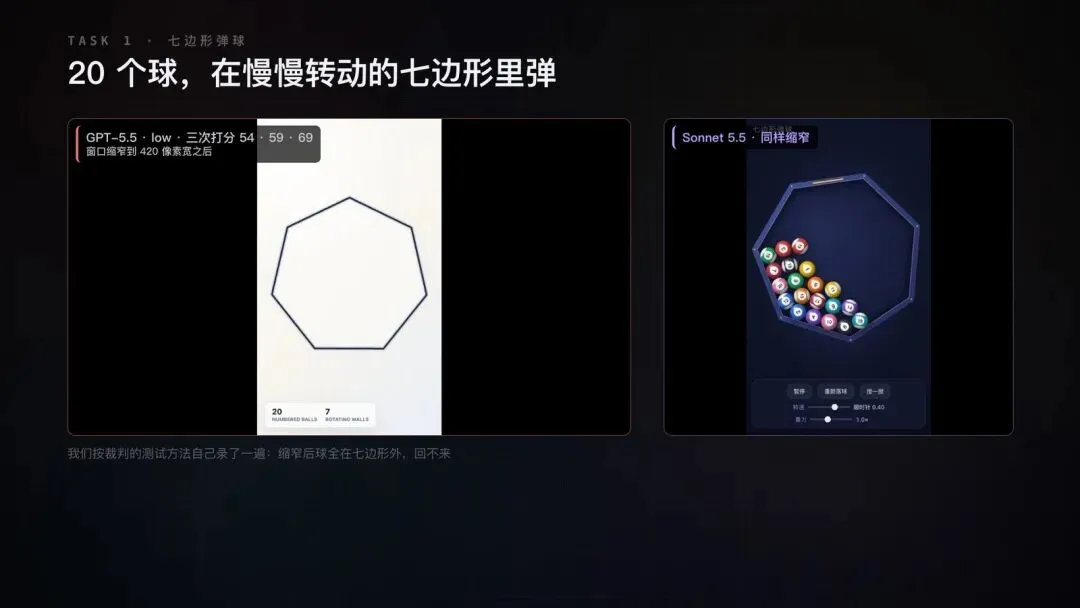
窗口缩窄后,球全在七边形外
❋ ❋ ❋
我现在的用法,只有这四条
第一,Opus 只负责三件事,把题目和验收标准写清楚,分派任务,检查结果,代码全部交给 Codex 来写。
第二,日常任务用 GPT-6.1 Sol,从 xhigh 起步,想要最好的结果就开到 max,又难又急的任务换成 GPT-6 Astra。
第三,检查结果要看三样东西,程序是否正常退出,Codex 是否报告完成,文件是否真的存在,不要只看日志里的结束二字。
第四,分数要多评几次,换对话,换裁判,裁判指出的 bug 要回到代码里核对一遍,只评一次的话,连第一名都可能换人。
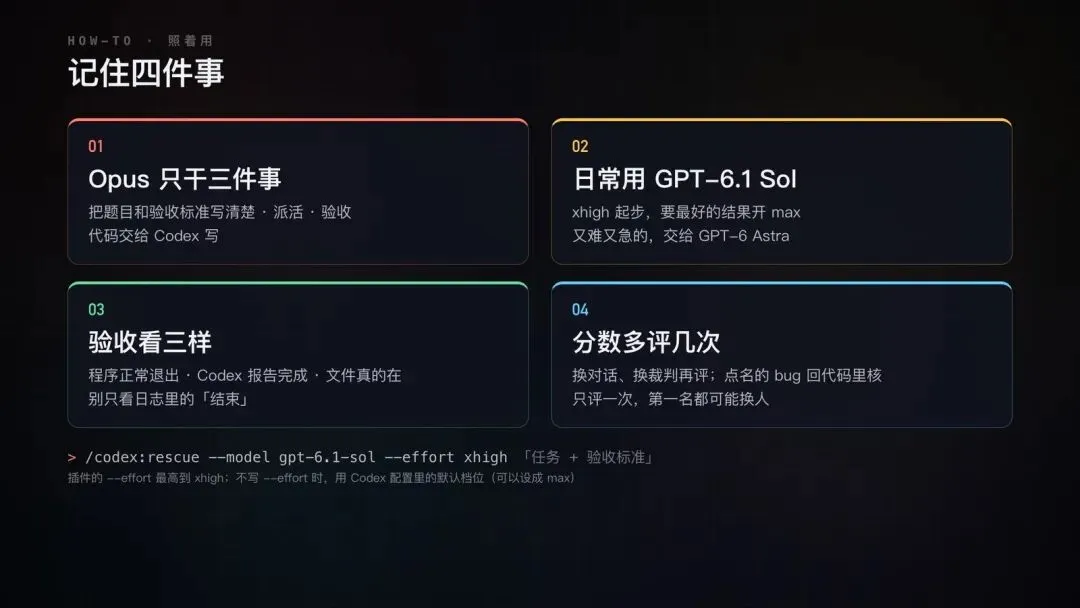
记住四件事
❋ ❋ ❋
写代码、验收、评分拆给不同的模型以后,每一层都有另一双眼睛盯着
这场测试里,有几点想法比榜单本身更有价值。
第一点关于成本。同样的四道题,Opus 自己做调用了 375 次工具,Sol max 只调用了 125 次,用了三分之一的次数,拿到了更靠前的名次。反复测试、反复修改,并不会自动换来更好的作品。把写代码交给另一个模型以后,Opus 可以把精力集中在两件最有价值的事情上,一件是把验收标准写清楚,另一件是检查结果是否真的达标。
第二点关于完成的判断。11 个任务的日志写着结束却没有完成,珠江夜游的卡死,也是裁判打开了三次才暴露出来。执行者对自己成果的汇报,往往比实际情况更乐观,每一层都需要另一个角色拿出独立的证据来确认。
第三点关于评分。一次评分给出的数字看起来很精确,同一件作品却可以在不同轮次里差出 21 分,所以名次比分数更可信,多评几次,比把一次评得更细更可靠。
这组数据的适用范围也很清楚。这次有几处没有测全,原因都是额度用完了。Astra 只测了 high 和 xhigh 两档,Sonnet 5.5 和 Opus 5.5 各只用了一个档位,Claude Fable 没有参与。所以榜单里 Claude 自己做的成绩,只代表测试时用到的那一个档位,Astra 的成绩也只代表这两档,它们在更高档位上的表现,这次没有测到。
每个配置每道题只做了一次,重新评分能消除裁判的随机性,消除不了做题的随机性,所以名次相邻的几个配置之间差距很小,更适合用来看整体走势。综合分由名次换算而来,原始分在前排挤得很紧,第 1 名和第 2 名可能只差半分。两位裁判都来自 OpenAI,作品虽然去掉了名字,同一家的风格仍有可能被认出来,我没有让 Claude 当裁判,Claude 只负责把裁判点名的问题带回代码里核对。另外用时受机器负载影响,有好几个任务是同时运行的,只能作粗略参考。
❋ ❋ ❋
169 件作品全部做成了在线擂台,每一件都能亲手玩
这 169 件作品我全部做成了在线擂台,每一件都能直接打开游玩,三次打分、裁判的五项打分和理由,以及每件作品花了多少钱、用了多少时间,全都能看到。擂台里还有一节专门讲三次打分,每道题的名次相关性、第一名是怎么换人的、关键对决拿掉任意一道题之后是否依然成立,都完整列了出来。另外还有一个盲猜小游戏,把两件作品放在一起,不给名字,猜哪一件的分数更高。
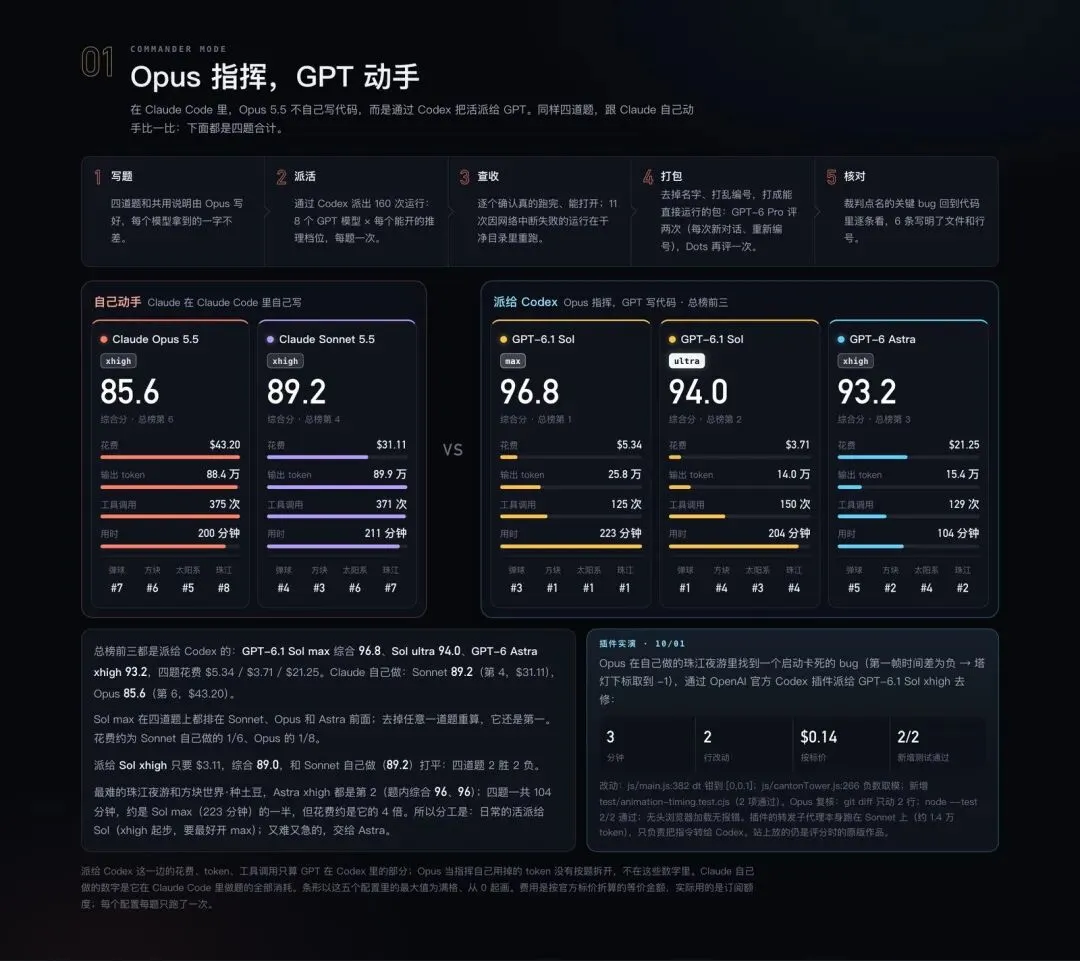
在线擂台,派任务 vs 自己做
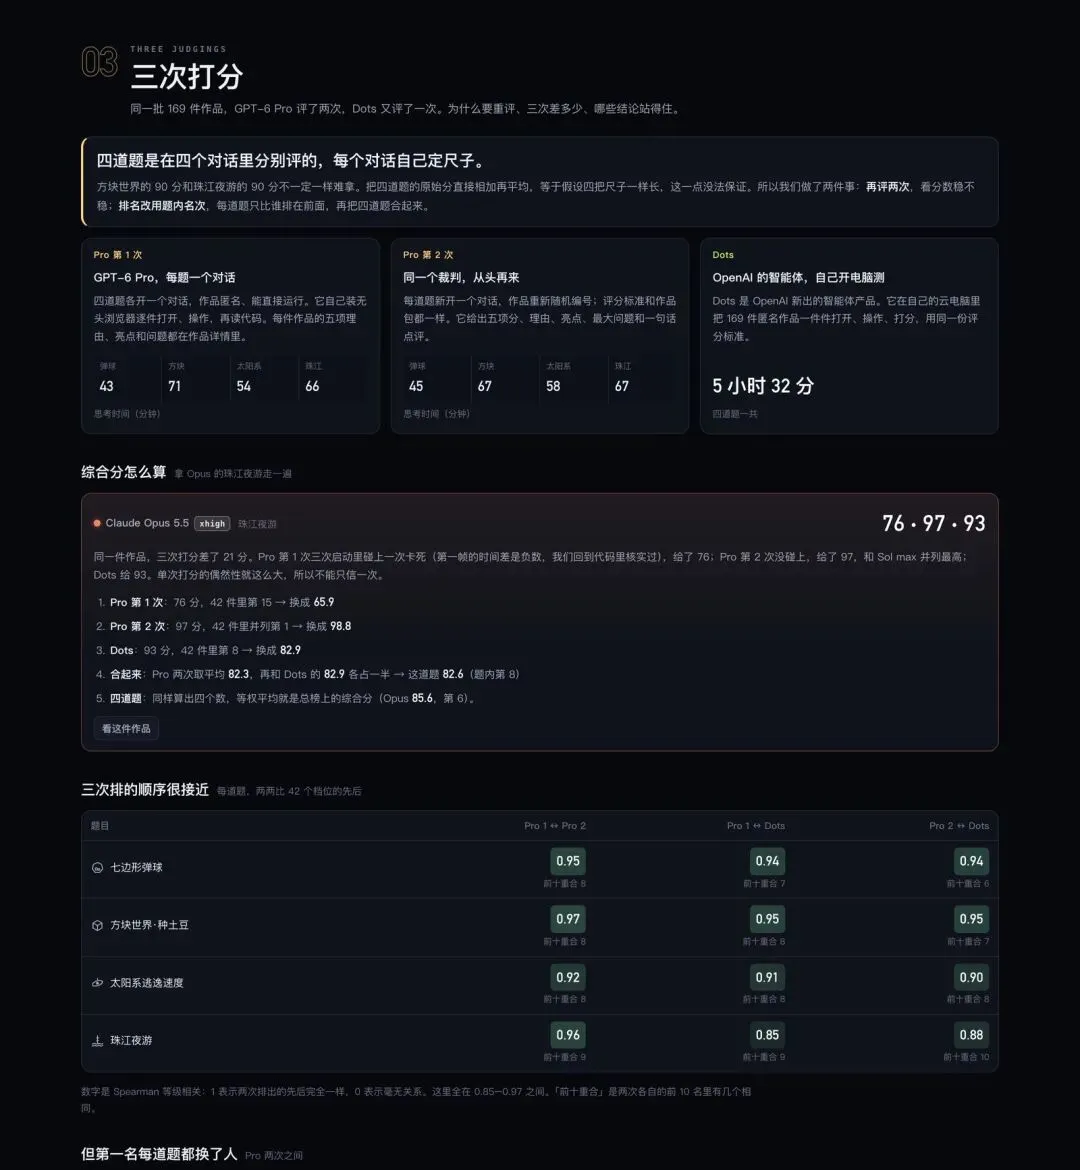
在线擂台,三次打分
这一次,写代码的是 GPT,当指挥的是 Opus,打分的是 GPT-6 Pro 和 Dots,核对裁判所指问题的又是 Opus,没有哪一个模型从头到尾自己完成全部流程,而排在最前面的作品,恰好就是这样做出来的。
新的写代码方式已经出现在眼前,我们都是这段历史的见证者,快去亲手试一试吧!
阅读原文,可以看到包含全部评测题目和评测结果的可视化,169 件作品都能直接打开玩,三次打分和裁判给出的理由也都在里面。