ARTICLE · 1129871
AI的钱第一次烧反了:用模型233亿,造模型190亿
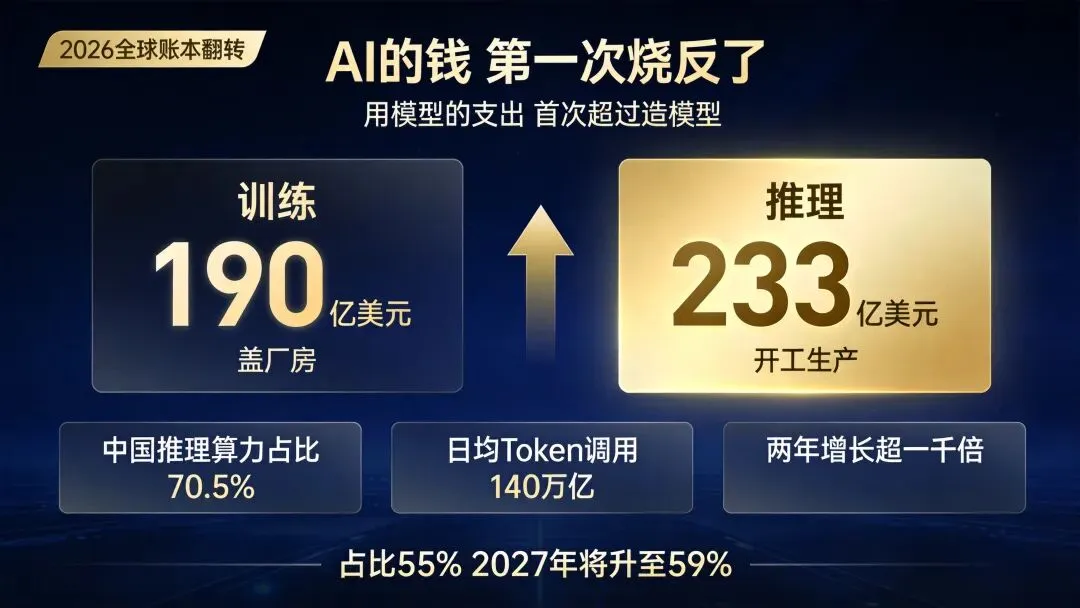
Gartner的最新预测:2026年,全球花在AI推理上的钱,将达到233亿美元;花在训练上的,是190亿美元。
人类第一次,在"用AI"上花的钱,超过了"造AI"。
差出来的43亿美元,就是AI从"造"转向"用"的第一道分水岭。
这件事为什么值得专门写一篇?因为它翻的不只是一张报表——过去三年,整个行业讲故事的方式,可能都要跟着换台词了。
01 建厂的钱,第一次输给了开工的钱
先把两个概念掰开。
训练,是"建厂"——盖厂房、装设备、调生产线,把一个大模型从图纸变成成品。万卡集群、千亿参数,都是建厂叙事。
推理,是"开工"——你每问模型一个问题,Agent每执行一步任务,生产线就转一次。转一次,烧一次钱。
过去三年,AI行业的聚光灯全打在建厂上:谁买了多少卡,谁训出了更大的模型。开工?那是未来时。
现在,未来时变成了现在进行时。
Gartner的完整预测是:2026年推理支出233亿美元,首次超过训练支出的190亿美元,占AI IaaS总支出的55%;到2027年,这个比例将升至59%。
📊 Gartner预测卡(2026年,AI IaaS口径)
推理支出:233亿美元(占55%)
训练支出:190亿美元
2027年:推理占比升至59%
原因判定:代理式AI提升计算强度,市场重心从训练向推理转移
数据来源:Gartner预测,据科创板日报2026年10月4日报道
更有意思的对照,藏在Gartner 9月16日发布的官方新闻稿里:2026年全球AI总支出2.67万亿美元,其中基础设施吃掉1.48万亿、占56%;而最风光的生成式AI模型,只分到283亿美元——约1%。
算笔账:每往模型公司投1美元,就有52美元以上流向了机房、芯片和网络。台前的人拿零头,幕后的人拿一半。
Gartner杰出副总裁分析师John-David Lovelock的原话是:"AI数据中心的建设,是人类历史上最大的基础设施项目。"
厂房越盖越大,但今年账本上第一次写着:开工的钱,超过了建厂的钱。
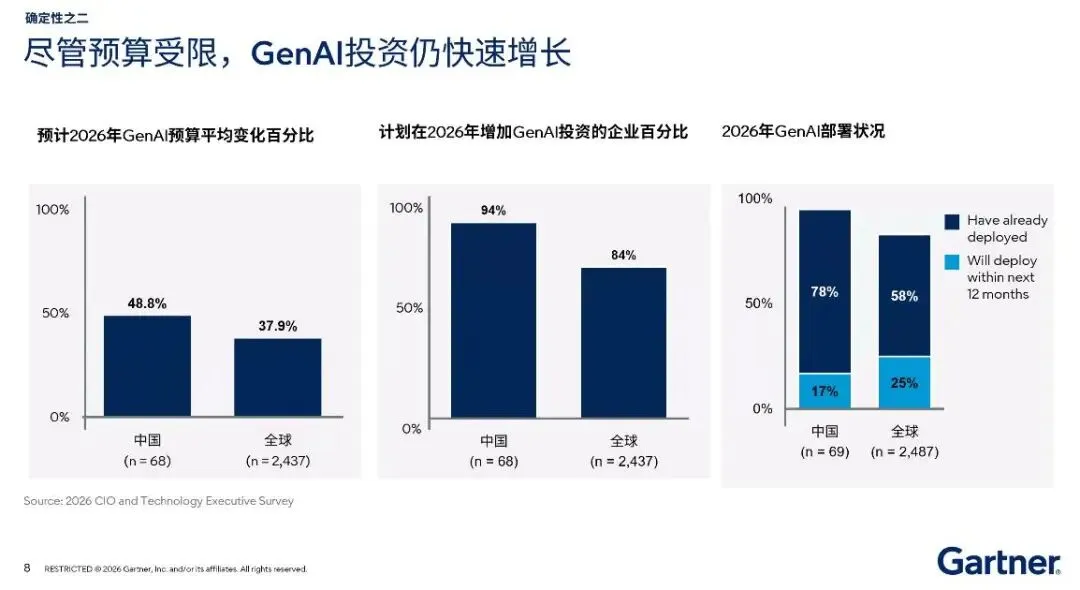
Gartner《2026 CIO and Technology Executive Survey》:94% 的中国企业计划在 2026 年增加 GenAI 投资(中国样本 n=68)
02 中国的曲线,比全球陡得多
全球是55%对45%的温和翻转,中国这边几乎是跳变。
信通院9月22日在国际信息通信展览会上发布了《词元(Token)经济发展研究报告(2026年)》,里面预计:2026年,推理算力占中国AI算力总负载的比重将达到70.5%。
全球55%,中国70.5%。这不是一个量级的翻转。
📊 信通院「推理时代」数据卡
2026年推理算力占AI算力总负载:70.5%
全国智能算力总规模:2185 EFLOPS(FP16,截至2026年6月底)
万卡级智算集群:2025年累计建成42个
日均词元调用量:2024年初约1000亿 → 2026年3月突破140万亿
数据来源:中国信通院《词元(Token)经济发展研究报告(2026年)》,据科创板日报报道
两年,一千倍。信通院总工程师何宝宏的原话:产业关注点正转向"用得好、用得起、用得安全"。
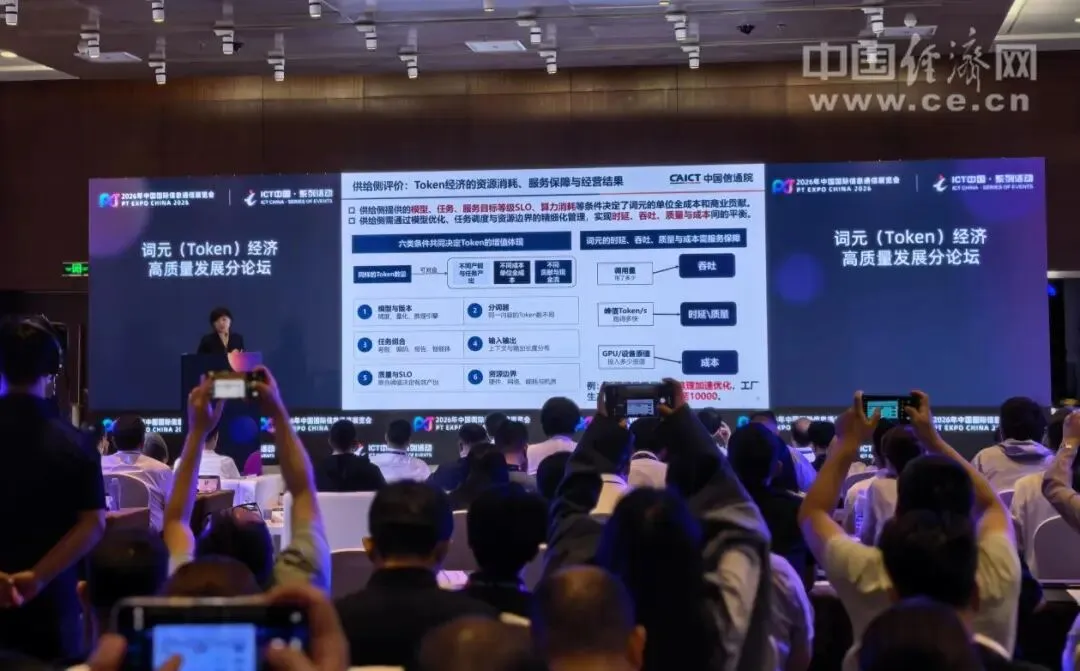
9月22日,《词元(Token)经济发展研究报告》在中国国际信息通信展览会分论坛发布,信通院现场分享"供给侧评价:Token经济的资源消耗、服务保障与经营结果"
注意这三个词——没有一个是关于"训得大"的。
另一份来自中国电信研究院的《智能体时代AI基础设施发展研究报告(2026年)》更激进:预计2026年我国Token消耗量将达10亿亿,2029年推理算力市场占比将达80%。中国移动甚至成立了两个顶级管理机构——算力办和Token办,一个管建设,一个管消费。
工厂逻辑彻底显形:建厂是一次的,开工是每天的。
03 于是,行业把话挑明了:不叫数据中心,叫"Token工厂"
如果说Gartner和信通院给的是宏观判断,一线公司的动作更诚实——它们已经开始用"工厂"这个词介绍自己了。
这批玩家,业内叫它们"Token工厂":不只是卖算力,而是把裸金属变成可交付、可计费的模型推理能力。
📋 Token工厂公司矩阵卡
#火山引擎|2025年中国公有云大模型调用量市占49.5%,第一
#阿里云|市占28%,第二
#百度智能云|市占10%,第三——三家合计近九成
#硅基流动|独立MaaS服务商,2026年累计股权融资近29亿元
#Fireworks AI|有消息称考虑新融资,目标估值300亿美元
#优刻得|全球28地区36可用区,巴基斯坦、哈萨克、乌兹别克节点上线
#润建股份|"星算云池",五象云谷智算中心转向Token工厂
#天亿马|1号国际词元工厂首期2000P,部分设备已投产
#三大运营商|电信星辰TokenHub、移动MoMA 2.0、联通"星罗"跨域混训
数据来源:IDC(调用量份额);科创板日报综合报道
按IDC数据,2025年中国公有云大模型调用量达1944万亿Tokens,同比涨了16倍。1944万亿是什么概念?平均到每一天,是5万多亿个token被生产、被消费。
三大运营商已集体转向"Token经营":电信星辰TokenHub、移动MoMA 2.0、联通"星罗"
一批公司集体改名换姓奔向"工厂",不是因为词时髦,是因为钱的方向变了——工厂比的不是谁的厂房大,是谁的开工率高。
04 开工之后,比的是良品率
工厂开工,就绕不开一个问题:生产出来的东西,值不值钱?
信通院那份报告里,藏着一个极少被讨论的数字:词元价值密度。
同样是100万个token,消费级场景——闲聊、娱乐问答——价格约0.01美元;产业级场景——药物研发、金融量化、精密代码生成——价值可达1000美元。
差十万倍。
📊 Token价值密度卡(信通院口径)
消费级场景:约0.01美元/百万词元(闲聊、娱乐问答)
产业级场景:可达1000美元/百万词元(药物研发、金融量化、精密代码)
差距:100,000倍
数据来源:中国信通院《词元(Token)经济发展研究报告(2026年)》,据科创板日报报道
一个真实的案例来自GoodVision AI CEO David Wang:一家生物医药客户,过去1到2个人花7天处理实验数据;引入Agent后,压缩到10分钟,token消耗只有个位数美元。
听起来是"AI又赢了"的故事?David Wang的下一句话更值钱:"客户买的不是Token数量,是业务任务完成结果。"
甚至,通过路由优化减少无效调用和重试,token消耗下降,任务价值反而在提升。
翻译一下:客户不按零件数付钱,按成品付钱。工厂时代真正的分水岭,不是产量,是良品率。
05 出货量第一,不等于回款第一
写到这,必须泼一盆冷水——还是滚烫的那种。
根据OpenRouter最新数据测算,9月21日至27日这一周,全球大模型总调用量146万亿token,环比增长13.18%。中国大模型的周调用量,已经连续22周超过美国,稳居全球第一。
很提气?西南证券传媒首席分析师苟宇睿一句话把气球扎破了:"Token首先是工作负载指标,不是财务指标。"
OpenRouter统计的只是经由它路由的流量——不含模型厂商自有API、不含企业私有化部署、不含开发者下载权重后本地跑的。拿它当出海成绩单,等于拿物流公司的发货数据当全国GDP。
PPIO的AI产品专家谢晋把话说得更透:模型出海,本质是权重开源出海,像"配方"公开出去,建立的是技术影响力,不直接产生收入;Token出海,才是推理服务出海,海外用户按实际消耗付费——那才是真金白银。
一个是发了朋友圈,一个是收到了回款。两码事。
06 三条边界,帮你看清这份新账本
第一,支出翻转不等于盈利翻转。推理的钱花得多,不等于赚得多。谢晋的判断是,当前Token出海的主要收入还是API调用,"一种卖水电煤的模式"——单价持续下降,收入增长完全依赖调用量指数级增长。一旦增速放缓或价格战加剧,利润空间会被严重挤压。
第二,调用量不等于收入。146万亿是全球周调用,但有多少转化成了付费、留存的客户?没人能从调用量里算出来。何况连信通院自己都说,当前市场处于"规模爆发、价格分化、效益不明"的阶段——官方口径里那句"效益不明",就是给全行业泼的冷水。
第三,这次翻转主要是结构性的,不是否定训练。训练支出还在涨,只是推理涨得更凶。别把"开工超过建厂"读成"不用再建厂"——没有厂房,开工无从谈起。
07 回到开头那两个数字
233亿,190亿。
差额只有43亿美元,象征意义却大得多:AI这门生意,正式从"建厂时代"进入"开工时代"。
好消息是:工厂终于开工了,生产线24小时在转,订单两年涨了一千倍。坏消息是:开工只是上半场,下半场叫回款——良品率待考、价格战在途、"效益不明"四个字还挂在官方报告里。
厂房盖了三年,灯火通明。但真正决定这门生意的,从来不是厂房有多气派,而是每一条生产线上,跑出来的东西有没有人掏钱。
开工易,回款难。谁先把"效益不明"熬成"效益分明",谁就拿到这场翻转的真正红利。
📊 一张表记住这篇文章
233亿美元——2026年全球推理支出,首次超过训练
190亿美元——同年训练支出,建厂的钱第一次屈居第二
55%→59%——推理占AI IaaS比重今明两年的爬升路径
70.5%——信通院预计2026年中国推理算力占比,比全球陡得多
140万亿——中国日均token调用量,两年涨了一千倍
1944万亿——2025年中国公有云大模型调用量(IDC)
0.01 vs 1000美元——消费级与产业级每百万词元的价值差,十万倍
146万亿——OpenRouter口径全球单周调用量,工作负载≠财务指标