ARTICLE · 1153933
同一份文档,切法不同召回差 9 个点
同一份四十页的行业报告,按 512 token 切和按 2048 token 切,召回出来的段落可能完全不同,而这个选择在多数框架里就是一行没人改过的默认配置。
前后两道工序都有现成工具的默认值,清洗有规则可循,唯独切块没有标准答案。
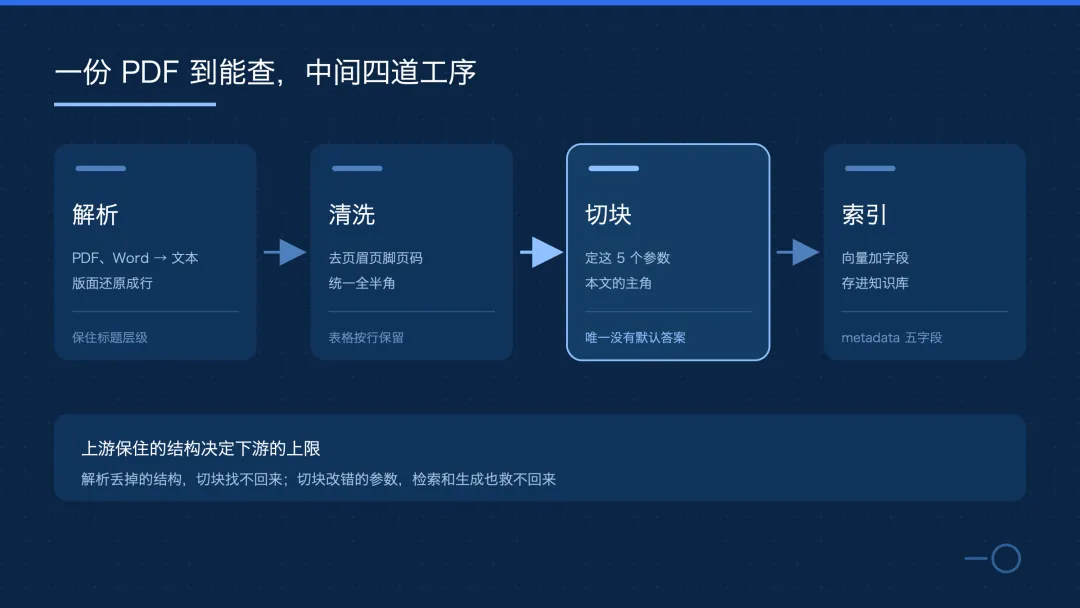
上一期把三代 RAG 摆开讲清楚,检索由谁决定是那条分界线。这一期开始动手,把一份文档变成能查的库。中间排着四道工序,解析把 PDF 变成带结构的文本,清洗去掉页眉页脚和乱码,切块把长文本切成检索单元,索引把每块向量化并存好字段。
我把切块里真正要拍板的事情收敛成五个参数,先说清每个参数取什么值、为什么是这个值,再对照五种常见切法,给出一份可以直接拷走的配置文件和一套入库前的自检流程。数字来自论文、官方文档和公开的工程实践,来源都列在文末。
先给四道工序下个定义,后面几节都围绕它们展开。解析负责把 PDF、Word、网页这类带格式的文件还原成文本,同时尽量保住标题层级、表格和列表的结构。清洗负责去掉每页重复的页眉页脚、页码和版权声明,统一全半角,处理多余空白,表格按行保留或转成模型好读的格式。切块负责把长文本切成检索单元,本文后面五个参数全在这一步。索引负责把每块向量化,连同字段存进库,供检索取回。
一个真实例子能说明工序的顺序有多重要。公司把产品手册做成 PDF 入库,解析阶段没有保留标题层级,所有小节被拉成一条平铺的文本流。切块时工具按固定长度硬切,一块的前半截是安装步骤,后半截是安全警告,召回回来的段落读起来通顺,内容却是拼接的。责任不在切块,解析就已经把结构丢了,切块只是把这个损失固定下来。
结构丢失的代价有实测。2026 年 9 月一项覆盖 72,000 行的因子实验测出解析器与切块器之间存在显著交互,p 值小于 0.0001,两个环节单独看都最优的配置,拼在一起未必最优。
清洗阶段同样容易留噪声。扫描件每页都有页眉,页眉那几行字在每一块里重复出现,向量被这批重复内容拉近,检索时同一批文档互相抢排名。表格被拍成连续文本也很常见,一行列名接一行数值,中间没有换行,模型看到的是一串对不上表头的数字。
所以这四道工序是一条流水线,上游保住的结构决定下游的上限。切块是其中唯一没有默认答案的一环,也是本文要展开的部分,其余三道先按工具的合理默认走,问题出现再回头修。
四道工序里,切块的试验成本最低。解析和清洗返工一次要重跑整个语料库,动辄几小时,切块改一个参数几十秒就能重切一遍。把参数对比实验放在切块这一步做,代价最小。
五个参数,先把取值说清楚
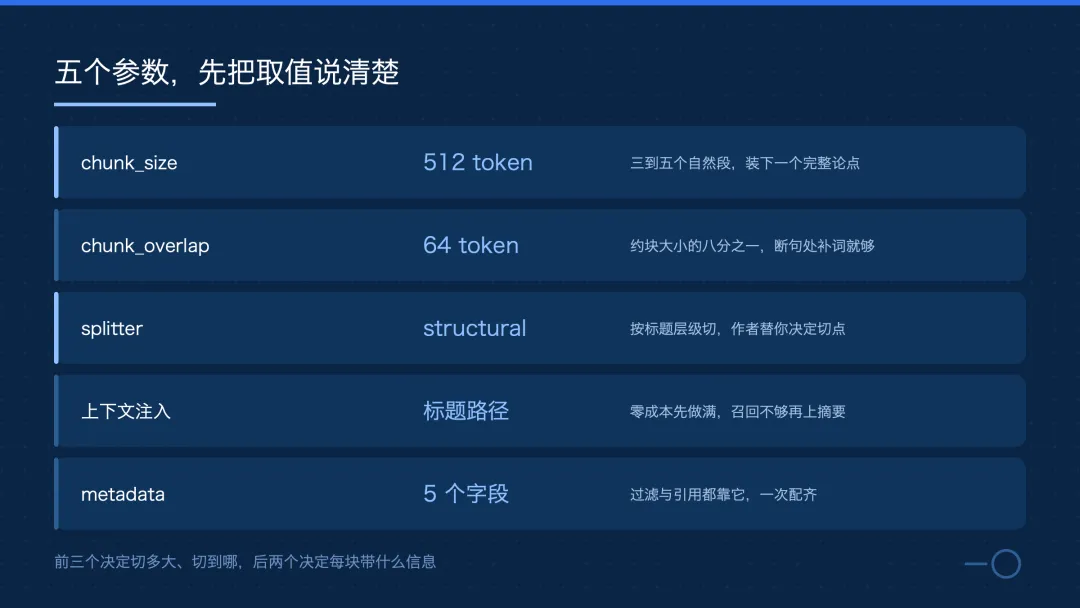
五个参数里,前三个决定切多大和切到哪,后两个决定每块带什么信息,合起来构成一次完整的切块决策。
第一个参数是 chunk_size,块的大小,按 token 计。512 是工程上常见的起点,大约对应三到五个自然段,够容纳一个完整论点。框架的默认值反倒偏大,LangChain 的切分器基类默认 4000 字符,LlamaIndex 的句子切分器默认 1024 token,这两个数适合先粗切再细调,直接拿来入库往往要吃亏。短对话和 FAQ 降到 256,长综述放到 1024,前提都是问题需要这个粒度。
第二个参数是 chunk_overlap,块与块的重叠。64 token 比较合适,约为块大小的八分之一,让被切成两半的句子在后半块里还能带上前半句几个词。重叠不是越大越好,两组实验都测到了上限。Chroma 的一组对照里,把重叠加到 125 token 曾把召回从 77.1 抬到 82.4;2026 年 9 月那项因子实验在监管文档语料上测出 32 token 最优,加到 64 反而变差。口径不同,指向同一件事,先按八分之一取,再用探针问题往上试。
第三个参数是 splitter,切分依据。fixed 按字符数硬切,最容易切断句子;sentence 按句子边界切;structural 按标题和列表的层级切;semantic 按段落的语义相似度切。框架默认值几乎都是 fixed,因为实现最简单。实际项目里 structural 性价比最高,文档本身就有结构,按结构切等于让作者替你决定切点。
第四个参数是上下文注入,给每一块补上它从原文里丢掉的信息。最便宜的做法是把标题层级拼到块头,一份手册 3.2 节下面的段落,块头带上「第 3 章 安装 · 3.2 首次启动」,检索时就能回答这块属于哪一节。更贵的一档是让模型给每块写摘要,每块多一次调用,等召回不达标再开。
第五个参数是 metadata,块上要存哪些字段。source、doc_type、version、page_range、updated_at 这五个一开始就配齐,过滤和引用都靠它们。答案要显示出处页码时,缺 page_range 就只能显示文件名,用户还得自己翻原文。
五个参数互相牵制,改了 chunk_size,overlap 的比例要跟着改;换了 splitter,注入的标题路径才有地方挂。所以下一节先把切法分清楚。
五种切法,各自适合哪类文档
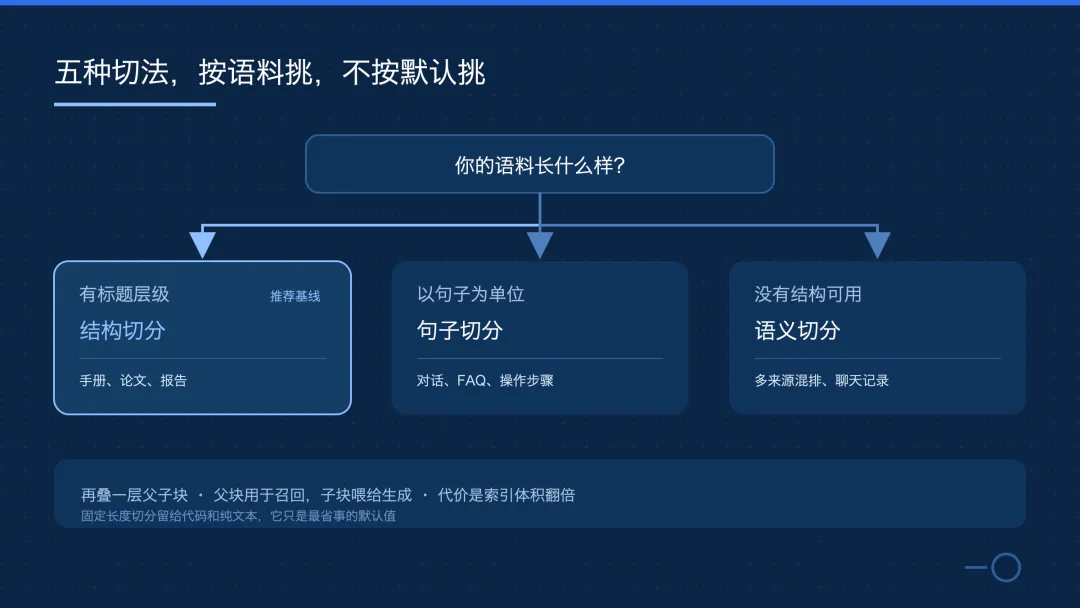
固定长度切分是所有框架的默认实现,按字符数累加,攒够就断。它对代码和纯文本够用,对自然语言不友好,一段话被从中间劈开是常态。价值在于确定性,同一份文档每次切出的块完全一样。
句子切分先分句,再把句子拼到接近目标大小为止。对话记录、FAQ、操作步骤适合用它切,这类语料以句子为单位,边界落在句号上,召回的段落就是完整句子。代价是块大小不均匀,实际长度浮动两三成。
结构切分按标题、小节、列表的层级断开,Markdown 文档天然适合,PDF 解析后保住了标题层级也一样能用。优势是每块自带语义边界,一个二级标题下面的内容讲的是同一件事,检索时不容易捞到半截。
语义切分按相邻段落的相似度,在明显下降处断开。它解决结构不规整的语料,比如聊天记录和多来源合集,没有标题时按内容切。代价是入库多跑一次相似度计算,块大小也失去可预测性,先确认结构确实丢了再用它。2026 年一项统一评测在 BEIR 六个数据集上排序,语义切分的平均 nDCG@10 垫底,段落和固定长度这类简单切法反而靠前,语义相近并不总等于检索需要的边界。
父子块切分是在任一种切法之上多做一层索引,父块存全文用于召回,子块喂给生成,召回时放宽阈值、命中父块再取回子块。它适合答案需要完整段落、直接索引大块又检索不准的文档。
实际项目里,结构切分加父子块能覆盖大部分文档类需求,语义切分留作结构丢失后的补救。切法定下来,剩下的就是配参数。
块太大和块太小,代价是两种
块太大时,检索精度先掉下来。嵌入模型把整块文本压成一个向量,块里若混了三个主题,向量落在三个主题的中间位置,跟哪个问题都不够近。召回回来的段落还带着大量无关内容,生成环节的上下文被稀释,模型容易顺着这些段落跑偏。
块太小时,语义完整性被破坏。答案需要跨两块的段落时,只召回其中一块,模型看到的是半句话,要么猜,要么拒答。引用也跟着出问题,每块只剩几十个 token,回答里挂的引用指向的是一段失去上下文的片段,用户点开看不出所以然。
两种代价都不轻,但性质不同。块太大是质量问题,检索排序不对;块太小是覆盖问题,该捞的捞不全。判断落在哪一边,靠真实问题测,不靠感觉。同一份语料至少试 256、512、1024 三档,用二十个真实问题跑召回,看哪一档先达标,做法在第七节展开。
切块参数的影响会在后面每一道工序里放大。检索排序错一次,重排还能救回来一部分;块本身缺了内容,后面再怎么调都变不出来。这是把切块放在系列第二期先讲的原因,上游少了一块信息,后面的配置都在给不完整的信息做优化。
两种失败的样子不一样,看结果就能分清。排序不对时,召回回来的段落跟问题只沾一点边,模型顺着跑题。覆盖不全时,召回的段落都相关,答案却缺了关键那半句,模型开始含糊其辞。测试时把这两类现象分开记,才知道该调大还是调小。
还有一段可以找的折中位置。块大小从 256 往上加,召回率先涨后平,拐点通常出现在答案能被一个完整段落装下的地方。找到拐点就停,再往上只有成本没有收益。
同一件事有第三方测量。Chroma 在 2024 年 7 月的评测里用同一份语料比了多种切法,最好与最差之间召回差约 9 个百分点,口径是 token 级召回。2026 年 9 月一项覆盖 72,000 行的因子实验把解析器、切块器和嵌入模型放在一起测,在那批语料上 256 token 配 32 token 重叠最优。数字口径不同,结论方向一致,块大小和重叠都有一个由语料决定的位置,试出来比照抄经验值可靠。
检索端看不见的信息,靠注入补回来
切块有个天生的损失,块被切出去之后,它属于哪份文档、哪一节、前后讲了什么,这些信息不跟着走。检索端看到的是一段孤立的文本。问题问的是安装那节说的超时参数,块里若没有节名,向量就对不上。
Anthropic 在 2024 年 9 月的工程博客里把这件事量化过。基线配置下,top-20 检索的失败率是 5.7%,平均每五个问题就有一个捞不到该捞的块。给每块注入 50 到 100 token 的上下文之后,失败率降到 3.7%,降幅 35%。注入同时用在嵌入和关键词两路上,失败率降到 2.9%,降幅 49%。再加一道重排,先取 150 块打分、留 20 块进模型,失败率降到 1.9%,降幅 67%。
成本也有出处。注入的上下文由小模型生成,每块多一次调用,配上提示词缓存之后延迟降一半以上、成本最多降九成,折算下来每百万文档 token 一次性花 1.02 美元。同一篇博客还给了条更省事的边界,知识库小于 20 万 token,约等于 500 页材料,直接整库塞进提示词就行。
不花模型调用的路也有。Jina 与 Weaviate 在 2024 年 9 月的论文里提出 late chunking,先用长上下文模型对整篇文档编码,在向量层面再切块,每块保留的是全文语境下的表示。在 BEIR 基准上,这套做法的 nDCG@10 平均比先切后嵌高出 1.5 到 1.9 个点。边界条件要记住,优势集中在小块,另一篇对照论文在 BGE-M3 上测到相反结果,NDCG@5 从 0.246 掉到 0.070,换嵌入模型之前先跑自己的探针。
注入也不是每次都有收益。2026 年 10 月的一组安慰剂对照给出解释,起作用的是标题里的信息本身,不是多出来的那几十个 token;另一组因子实验发现,把标题注入塞进解析器、再配结构感知切块,收益反而变负。注入补的是这块属于哪一节,块本身内容缺了,这句话补不回来。
三种做法对应三档预算,标题路径注入适合结构完整的文档,上下文注入适合结构残缺但重要的语料,late chunking 适合嵌入模型支持长输入的场景。选择顺序也按这个来,先把零成本的做满,再考虑花钱的。
注入解决的是这块讲什么,切块解决的是切多大,两者不互相替代。到这一步,五个参数就都交代完了,剩下的工作是把它们写进配置,跑通入库。
配置与代码,切块就这几行
参数定完,剩下的就是把五个参数写进配置。文件放在当期目录的 artifacts/chunking.yaml,换语料时改三处就够,parse 那组跟着文档类型走,chunk 那组决定切法与大小,eval 那组决定什么时候算过关。
逐字段说一遍取值理由。chunk_size 取 512,前面给过依据。chunk_overlap 取 64,约为块大小的八分之一。splitter 取 structural,文档类语料的默认选择。context 里的 inject_header_path 打开,inject_summary 关着,等召回不达标再开。metadata 五个字段一次配齐。
parse 那组有两个容易忽略的开关。keep_header_footer 关掉,清洗阶段会把每页重复的页眉页脚去掉,扫描件语料务必检查这一项。table_mode 取 rows,表格按行保留,模型才能把列名和数值对上。扫描件和导出 PDF 混用的语料里,先确认这两个开关,再回头调块大小。第一节那个交互实验说明,别在丢了结构的语料上调参,调得再准也救不回来。
eval 那组是这期和第六期的接口。probe_questions 指向二十个真实问题的文件,recall@5 是过关线,定在 0.9。改动之后跑一遍,分数掉了就回滚参数,这一条比任何经验之谈都可靠。
## chunking.yaml(节选,完整文件见 artifacts/chunking.yaml)parse: keep_header_footer: false # 每页重复的页眉页脚进库就是噪声 table_mode: rowschunk: chunk_size: 512 # 通用起点,短文本 256,长综述 1024 chunk_overlap: 64 # 约块大小的八分之一 splitter: structural # fixed | sentence | structural | semanticcontext: inject_header_path: true # 标题层级拼进块头 inject_summary: false # 召回不达标再开metadata: fields: [source, doc_type, version, page_range, updated_at]eval: probe_questions: eval/probe-20.jsonl recall@5: 0.9这份配置要进版本库,跟代码一起提交,每次改动配一句说明,写清为什么改、探针分数变了多少。三个月后回头看,这条记录把当时的问题、参数和结果连在一起,比任何笔记都管用。
解析与切块合起来看更直观,骨架只有几行,工具的默认值已经能跑,要改的都在配置里。
from unstructured.partition.pdf import partition_pdffrom langchain_text_splitters import MarkdownTextSplitterelements = partition_pdf("handbook.pdf", strategy="hi_res")doc = "\n".join(e.text for e in elements)splitter = MarkdownTextSplitter(chunk_size=512, chunk_overlap=64)chunks = splitter.split_text(doc) # 每块再补标题路径与 metadata骨架里两个工具的选择都有讲究。partition_pdf 取 hi_res 策略,表格和版面都能识别,速度比 fast 慢,入库前跑一次就够。MarkdownTextSplitter 按井号断小节,正好对应 structural 切法,换成自己写的分隔符就退回了固定长度。真要上生产,把切完之后补标题路径的那步也写进去,代码不超过十行。
入库之前,先攒二十个真问题
自检流程分三步,加起来不到半天,能省掉后面几周的反复。
第一步在切块之前,攒二十个真实问题,这是后面两步的尺子。问题从用户嘴里来,从客服工单里挑,从文档目录反推也行,要求覆盖三类,单跳事实题、需要跨段落的题、要求引用出处的题。二十个够用,多了跑得慢,少了没有代表性。
第二步选三组参数跑召回。chunk_size 取 256、512、1024,其余参数不动,每组跑完记录 recall@5。哪组先到 0.9 就用哪组,都不达标说明问题不在大小,在切法或者解析,回头检查标题层级有没有保住、页眉有没有混进块里。
第三步抽块人工看。随机抽二十块,看有没有从句子中间断开,看页眉页脚还在不在,看表格是不是连成了数字串,看 metadata 里 source 和 page_range 有没有值。这一步机器替代不了,抽出来的每类问题都对应前面某个参数或工序。发现的问题按工序归类,属于解析的记进 parse,属于切块的记进 chunk,下次改配置时对号入座,不用从头再猜。
三步的顺序别调换。先跑参数再攒问题,测出来的只是自己想象中的问题;先看块再定参数,看到的毛病往往和召回结果对不上。这一步给配置留下的是一条基线,后面换语料、换嵌入模型、换框架,拿同一套探针跑一遍就知道有没有退步。跑测试的成本很低,二十个问题手写半天够用,一轮召回实验的开销比一次嵌入调用还便宜。省下来的是几十次凭感觉调参的来回。
三步做完,配置才算定稿。把探针问题和参数一起提交,后面每次改动都跑同样这一套,这期的配置就有了第六期评估的接口。
切块做对了,后面每一步都便宜
这期从四道工序讲到五个参数,再对照五种切法,最后给了一套自检流程,落点只有一个。切块是整个流程里最早、也最值得花时间的一步,它不需要训练模型,不需要采购服务,需要的是对照真实问题做几组对比实验。
不变的那部分也要说清楚。块里没有的信息,检索永远捞不回来,这句话对三代 RAG 都成立。这期的所有动作都在补同一件事,让每一块既完整又可定位,完整靠切法,可定位靠注入和元数据。
下一期把四道工序往后推一步,讲检索配置,向量、关键词和重排怎么配才准。到时候召回率的分子分母,都要用这期攒下的探针问题来算。
拿走三件事。块大小先试 512,切法先用结构切分,元数据五个字段一次配齐。再拿走两步动作,入库前跑二十个探针,改动之后跑同一套探针。配置在当期目录的 artifacts 里,拷走改三个字段就能用。
系列走到第二期,选型和入库两件事都落地了,检索、评估、上线排在后面几期。每期的配置往后累积,第六期的评估集接的就是这期的探针文件。第八期的上线清单也要求它存在。
① 总结 文档进知识库有四道工序,切块是唯一没有默认答案的一环。五个参数先定下来,chunk_size 取 512,chunk_overlap 取 64,切法优先结构切分,上下文注入先做零成本的标题路径,元数据五个字段一次配齐。入库前攒二十个真实问题,三组参数跑 recall@5,达标再提交。
RAG 知识库实战系列 · 第 2 期
我是 leadme96,长期写 AI 工具与工程实践,《RAG 知识库实战系列》每天更新。觉得有用的话,关注 leadme96,新一期出来你就能收到。
参考资料
• Anthropic, Introducing Contextual Retrieval(2024-09-19)[1] • Günther et al., Late Chunking(Jina/Weaviate,arXiv 2409.04701)[2] • Smith & Troynikov, Evaluating Chunking Strategies for Retrieval, Chroma(2024-07-03)[3] • Singh, Parser, Chunking, and Embedding Interactions(arXiv 2609.31660)[4] • Kuehlkamp et al., Does Document Structure Help Dense Retrieval?(arXiv 2610.10170)[5] • Zhou et al., Beyond Chunk-Then-Embed, 切块策略统一评测(arXiv 2602.16974)[6] • Merola & Singh, Reconstructing Context(arXiv 2504.19754)[7] • LangChain 文本切分器文档与源码默认值[8]
引用链接
[1] Anthropic, Introducing Contextual Retrieval(2024-09-19): https://www.anthropic.com/engineering/contextual-retrieval[2] Günther et al., Late Chunking(Jina/Weaviate,arXiv 2409.04701): https://arxiv.org/abs/2409.04701[3] Smith & Troynikov, Evaluating Chunking Strategies for Retrieval, Chroma(2024-07-03): https://www.trychroma.com/research/evaluating-chunking[4] Singh, Parser, Chunking, and Embedding Interactions(arXiv 2609.31660): https://arxiv.org/abs/2609.31660[5] Kuehlkamp et al., Does Document Structure Help Dense Retrieval?(arXiv 2610.10170): https://arxiv.org/abs/2610.10170[6] Zhou et al., Beyond Chunk-Then-Embed, 切块策略统一评测(arXiv 2602.16974): https://arxiv.org/abs/2602.16974[7] Merola & Singh, Reconstructing Context(arXiv 2504.19754): https://arxiv.org/abs/2504.19754[8] LangChain 文本切分器文档与源码默认值: https://docs.langchain.com/oss/python/integrations/splitters