ARTICLE · 1167513
从预测到决策:AI 如何进入科研闭环?
真正的材料研发,并不只是一次预测,而是:提出假设 → 实验验证 → 修正模型 → 再次设计 → 再次验证。科学的发展,本质上就是不断利用实验修正认知。AI 如果不能进入这个循环,再大的模型,也只是一个离线分析工具。
上一篇文章中,我们介绍了结构化数据提取。很多朋友问:文献和实验记录抽取好了,是否就意味着 AI 可以真正参与科研了?
AI-ready 数据解决的是 AI 能不能读懂过去。它只是让 AI 有资格进入研发体系的第一步。这些数据如何帮助模型产生新的决策,以及新的实验结果返回之后,我们又应该改变什么?才是研发过程中真正重要的问题。
以我们正在做的 Suzuki 偶联反应条件筛选项目为例。截至目前,我们已经积累了上千条高通量反应数据。催化剂、配体、溶剂、温度、水含量、氧含量都被成功结构化地记录下来;进一步地,液相色谱(HPLC)结果也经过校准,被换算成可靠的产率和组分信息。基于此结构化数据训练的模型,预测的准确度已不再是瓶颈。给定一组条件,模型很快就能预测出大概能得到多少产物。
但预测准了,并不意味着整个研发工作流就可以结束。摆在实验人员面前的一个更难的问题反而出现了:下一轮实验究竟应该做什么?最直接的答案看似是:挑模型预测产率最高的那一组参数进行实验。但真实情况,远比此复杂。
起初,在 MeOH / Me-THF 体系中,我们的模型表现欠佳。此时如果继续调参,便只是在一个本来就不合适的搜索空间里反复试错。
在之后的推进中,我们把氧含量降了下来,发现一些反应确实变好了。但这时最值得做的,并不是立刻沿着这个方向追求更高产率,而是补充对照实验:「氧究竟是不是导致变化的关键变量」?还是它只是与其他条件共同变化?这两种选择看起来只差几组实验,背后的目标却完全不同。追求高产率是在“优化”,而后者是在“获得证据”。
此外,我们还发现底物和目标产物在 HPLC 上有时会共洗脱。如果无视这种情况,继续拿峰面积当优化依据,后面所有推荐都建立在错误的标签上。这种情况下最合理的动作是停下来,先把分析方法修好。
从上述例子可以看到,同样是「低产率」三个字,背后可能对应着完全不同的科学含义,指向完全不同的下一步操作:条件不合适时,应该更换条件; 证据不足以确定关键变量时,应该做验证实验; 分析结果本身不可信时,应该先修数据和测量体系。如果 AI 只会寻找「哪组条件产率最高」的参数,它很容易在错的数据、错的假设、错的实验空间里持续优化,给出一个看起来最优、实际上毫无意义的推荐。
这也是为什么,我们逐渐把研发闭环看成几个不同层次的问题:AI 先要理解数据,然后做出决策;实验给出反馈,系统再判断究竟应该更新数据、模型、假设,还是下一轮实验策略。
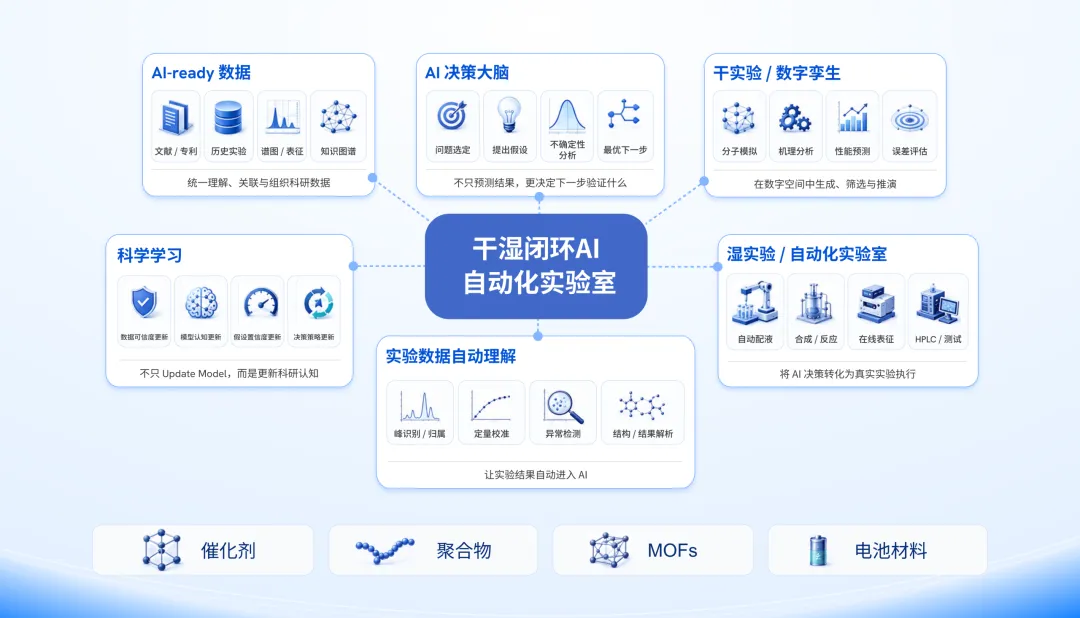
干湿闭环AI自动化实验室
很多材料研发过程,实际上就是不断压缩缩小变量空间的过程。但科研本身还多了一层:有时候实验并不是帮我们排除错误方向,而是在告诉我们,原来问题的定义就不对。
在真实研发里,真正昂贵的往往不是多跑一次模型,而是多做一轮没有信息增量的实验。因此,我们并不把“预测得更准”作为唯一目标。更重要的是:有限的实验预算,能不能持续换来对问题更好的理解。
值得强调的是,这里所说的「AI决策闭环」,并非在传统机器学习语境里的「将结果加进数据集重新训练」。因为真实科研里的实验反馈,不是一个标签那么简单。一次失败,可能是条件无效,可能是测量出了问题,可能是数据处理有偏差,可能是模型跑到了失效区间,也可能原来的科学假设就是错的。
还是以我们在 Suzuki 偶联反应预测中真实经历为例。我们在做了批次复核、实验对比和多组分独立校准之后,诊断出各种各样的数据异常,追查下去发现并不是什么新的化学规律:有的是实验批次差异,有的是 HPLC 数据序号错位,有的是多组分没纳入质量平衡,还有的是不同化合物紫外响应差异造成的系统性定量偏差。我们能够清楚分辨:哪些是真实的化学信号,哪些只是观测体系自己制造出来的"信号"。
因此,对于「更新模型」这件事,AI需要分情况采取不同的举措:异常来自数据质量,要先更新的是数据可信度和测量体系; 模型只在某一块化学空间失效,要更新的是它的适用边界; 新实验跟原有机理判断冲突,要重新评估的是科学假设; 如果一次实验根本无法区分几种解释,那么需要改的甚至不是模型,而是实验设计本身。
简而言之,AI真正有价值的回答只有一个:这次实验,改变了我们对问题的什么理解。
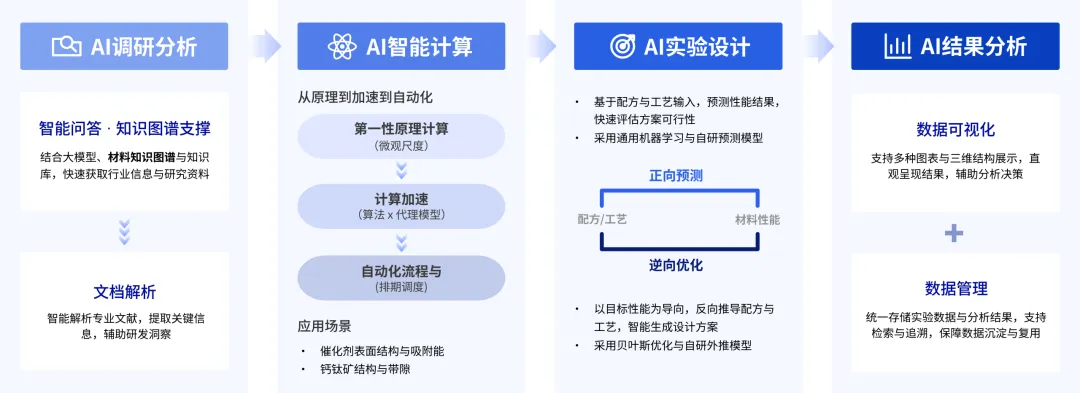
DeepVerse AI 研发流程
如果做一个并不完全严格的类比:AI-ready 数据相当于预训练的语料,而自动化实验室便是那个能够给出真实反馈的环境。今天两者最大的区别在于反馈周期或者节拍,模型一天可以迭代很多次,而一次材料实验需要三个月才能返回服役数据,那么真正限制当前 AI 驱动的材料科研的瓶颈,并不是CPU和GPU的算力,而是物理世界本身的反馈。
值得强调的是,除了反馈的速度,反馈的质量也是同等重要。在具体的实验流程中,HPLC 可能出现共洗脱,产率标签可能带有系统偏差,实验执行可能有批次漂移……对 AI 来说,这些不是普通的数据噪声,而是在破坏整个学习闭环的反馈信号。如果反馈本身不可靠,AI 就分不清一次决策是真的错了,还是实验执行、测量、数据处理出了岔子。更麻烦的是,错误反馈一旦进入自动化闭环,系统会基于错误认知继续选下一轮——自动化程度越高,错误被放大得越快。
因此,我们把标准化实验管线、HPLC 定量校准、独立复核和实验过程自动化,看成同一件事的不同部分,即给 AI 建一个稳定、可重复、可追溯的验证体系。真正的自主,不是 AI 可以自己动手做实验,而是AI的每一次行动,都能被真实世界稳定地验证,并据此决定下一步该怎么改。
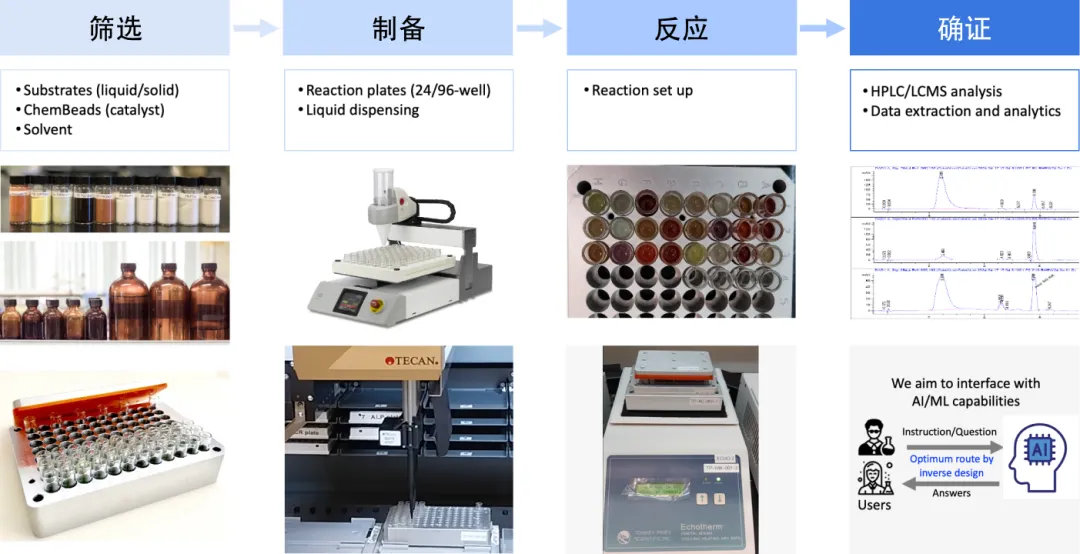
学习闭环
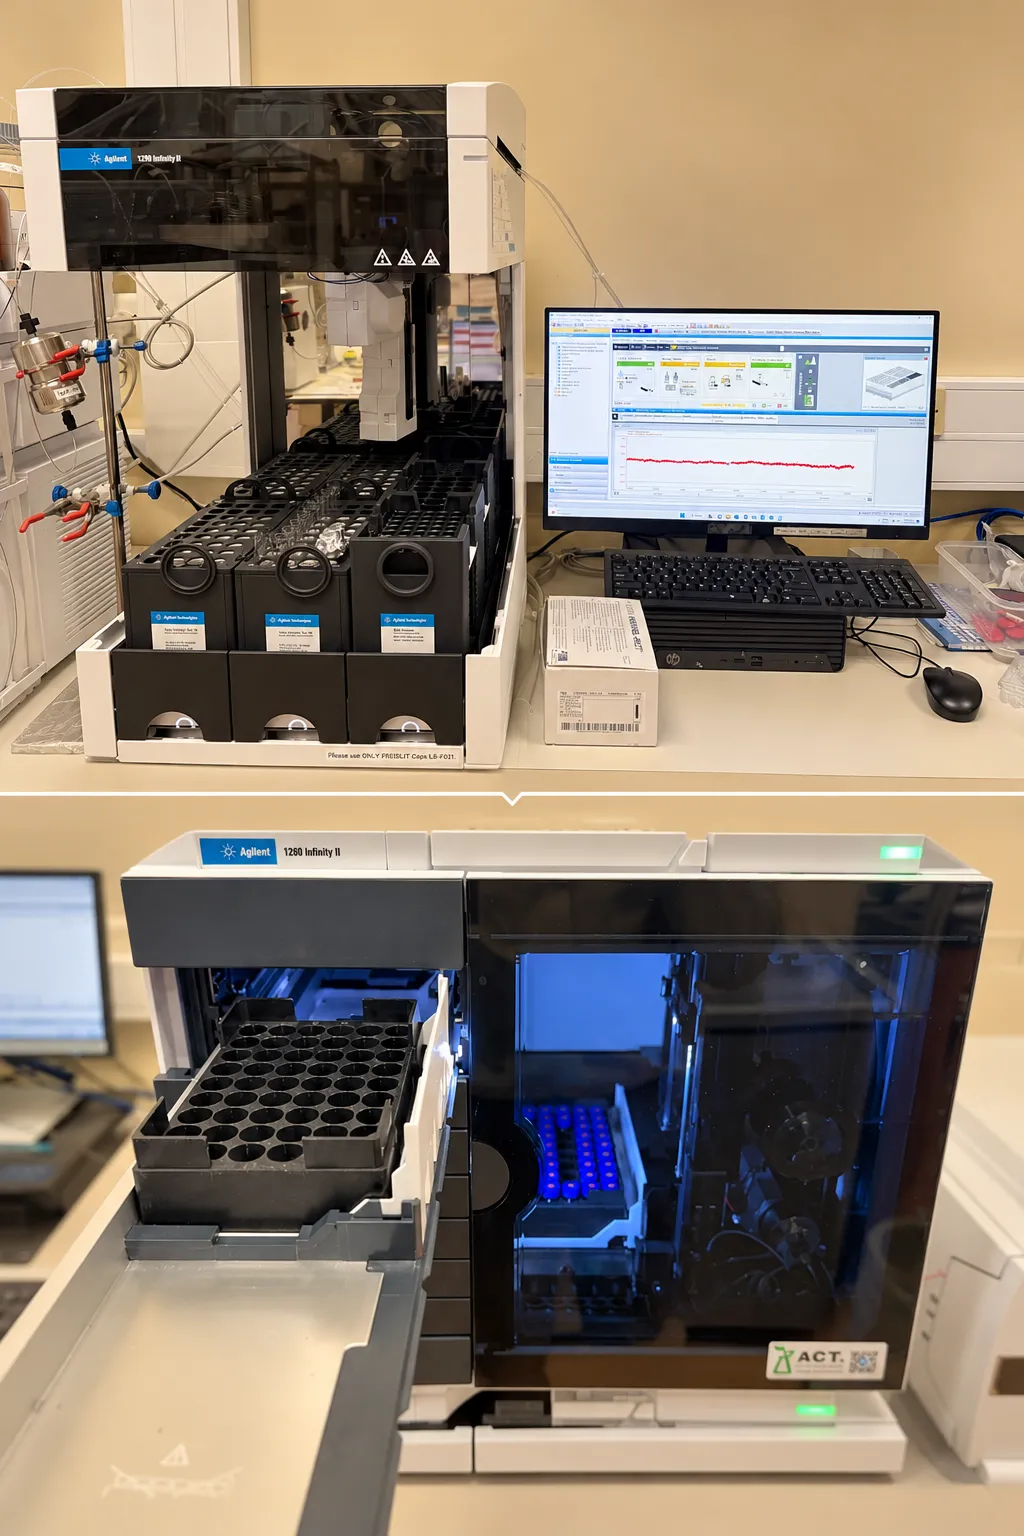
回过头看,从「AI-ready 数据」到「AI 决策」再到「自动化实验室」,我们做的其实始终是一件事:让 AI 与真实世界之间的距离越来越短。数据让 AI 看见过去发生了什么;模型和智能体尝试判断下一步决策;真实世界负责修正 AI 的科研认知,这个判断对不对,以及为什么不对。新的认知再进入下一轮迭代。所以我们更愿意吧材料研发理解成一个持续运行的循环, 「数据 → 决策 → 实验 → 验证 → 认知更新 → 下一次决策」,这跟现在常见的「数据 → 模型 → 预测」最大的不同是实验不再是模型最后的验证环节,而成为AI学习过程的一部分。
也许真正值得追求的并不是一个大模型,一台机器人,一个“什么都会做的AI科学家”,而是一套知道自己哪里可能错、知道下一步应该验证什么,并且能够被真实世界不断纠错的科研系统。