ARTICLE · 1202181
加一个空格,大模型就看不懂长文档了?
加一个空格,大模型就看不懂长文档了?字节跳动 Seed 团队(联合普林斯顿、斯坦福等)在 arXiv 上发表论文《Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression》,揭示了一个被平均分长期掩盖的奇怪现象:在用了“分块 KV 缓存压缩”技术的大模型(比如 DeepSeek-V4)里,同一条信息放在不同位置,模型找不找得到它,会呈周期性剧烈波动——论文把这种现象称为“相位敏感”(phase sensitivity)。 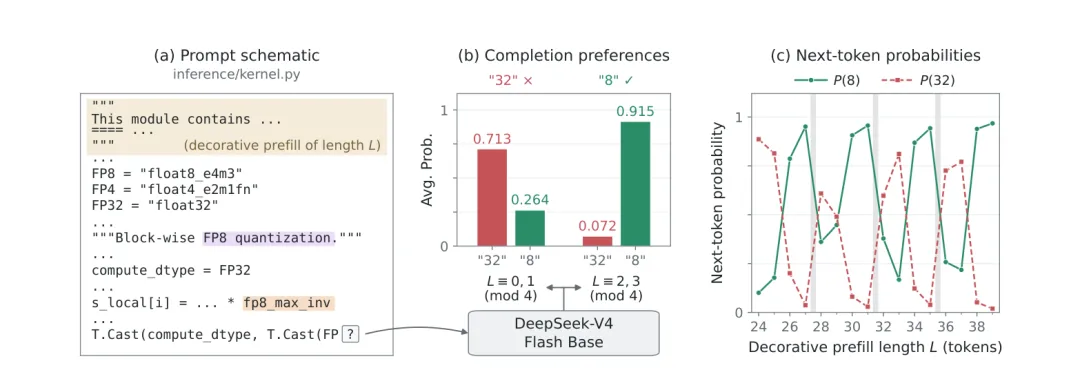
代码一字不改,只在开头加一行装饰性注释、每次多写一个等号,DeepSeek-V4 对同一个补全位的答案就每隔 4 个 token 翻一次面 先抛三个最有冲击力的数字: 换句话说,AI答不答得对,可能只取决于信息“坐”在了第几个位置——而这恰恰是所有平均分评测看不见的东西。 先把事情说清楚:KV缓存本身没问题,这篇论文也完全没有“推翻 KV”的意思。 大模型读长文本时,会把每个 token 的“钥匙”(Key)和“答案”(Value)记在一个小本本上备用,这就是 KV 缓存。上下文越长,本子越厚,显存和计算开销越大。为了给本子减负,业界想了很多招:完整记录但只细算重要的(稀疏注意力)、定期划掉不用的页(缓存淘汰)、把旧内容压成摘要(各种压缩方案)……“分块 KV 缓存压缩”只是其中一招:把连续 token切成固定长度的窗口,每个窗口只留几条摘要,按固定步长滚动推进。DeepSeek-V4 用的就是这一招。 问题就出在这个“固定步长”上。窗口每 S 个 token 出现一次边界,于是每个token除了绝对位置,又多了一个相对坐标:相位,也就是位置除以步长后的余数。同一段信息落在窗口里的排位不同,被压成摘要时的“分量”就不同——把输入整体平移几个token,内容、语序什么都没变,但所有信息的排位全变了。论文把这种“同一信息,换个排位,表现天差地别”的现象称为相位敏感。 论文针对的只是“固定分块压缩”这一种设计。压缩让长上下文从“用不起”变成“用得起”,价值巨大;论文说的是这类设计存在结构性弱点,不是压缩思路不行,更不是 KV 缓存该被淘汰。 最有画面感的证据,来自一次“自己考自己”:研究者让 DeepSeek-V4 补全一段代码,代码就来自它官方的推理程序。补全的位置前面写着 T.Cast(compute_dtype,T.Cast(FP,照着上下文的意思,接下来显然该补“8”(凑成FP8,一种低精度数值格式)。但模型时不时会补成“32”(FP32)——相当于标准答案摆在眼前,它偏偏选了另一个。 蹊跷的还在后面。研究者在代码最前面加了一行纯装饰用的注释,里面塞一串等号,然后每次只多加一个。代码内容、标准答案什么都没变,只是整段代码整体往后挪了一个 token。结果模型的答案开始“翻烙饼”:等号数量除以 4 余 2 或 3 时稳稳答对,余 0 或 1 时大概率答错,两个候选答案的概率差能从 +0.95 一路摆到 -0.79。对错每隔 4 个 token 翻转一次——而 4,恰好是 DeepSeek-V4 压缩窗口的滚动步长。 换种写法凑长度、换成后训练版本、换成步长为 2 的 V4.1,“翻烙饼”的周期也跟着变成对应的步长;而没有用分块压缩的DeepSeek-V3.1,在同样的 64 次测试里只有 4 次站错队,而且优势都很小。 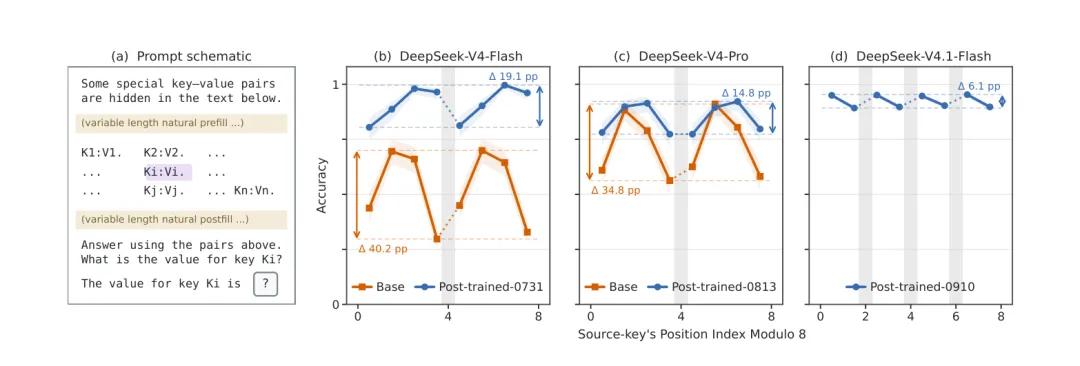
128K 上下文大海捞针:只把考题位置相对于压缩边界挪一挪,DeepSeek-V4 家族的准确率最大相差 40.2 个百分点;后训练能缩小,但消不掉 研究者做了个“大海捞针”实验:给模型一篇 128K token(差不多是一本书的厚度)长的文本,里面埋 16,000 组“钥匙—答案”对,挑一组靠近中间的当考题。关键操作是:同样的钥匙、同样的答案、同样的总长度,只把考题相对于压缩窗口边界的位置挪一挪,看模型还能不能找对。结果:DeepSeek-V4-Flash-Base 最大相差 40.2 个百分点;Pro-Base 34.8 个;后训练能把准确率和差距一起改善(19.1 / 14.8 个),但消不掉;V4.1-Flash 差距最小(6.1 个),但偶数位置的四组依然全部高于奇数位置的四组。 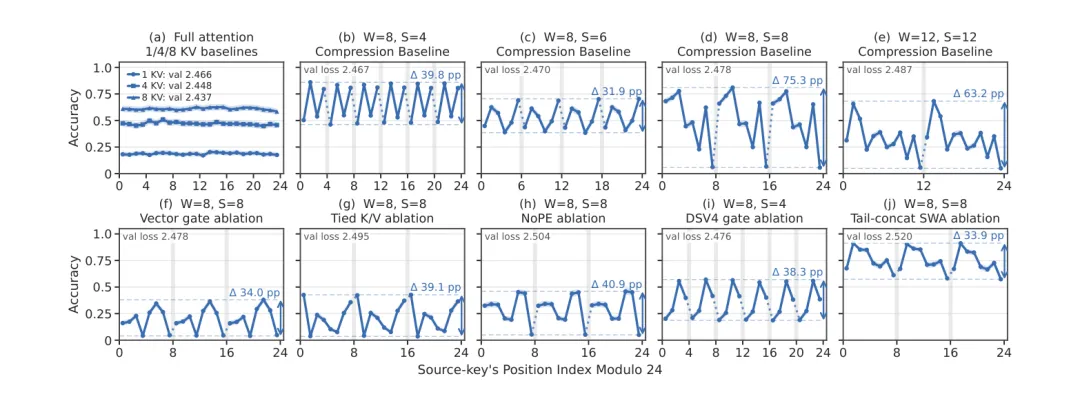
从零预训练的模型家族:只要用固定分块压缩,就出现跟随步长的周期性弱点;全注意力基线全程平坦(差距不超过 6.1 个百分点) 光在真实模型上看到现象不够,研究者又从零训练了一整棵Qwen3-0.6B模型家族,“分块压缩”是唯一改动的架构,训练量 100B token。结论很干净:所有压缩模型都出现跟随步长的周期性(步长设成 4/6/8/12,波动周期就是 4/6/8/12),全注意力基线全程平坦;去掉位置编码 RoPE、把学习门控换成最简单的平均分配、换成 DeepSeek 同款压缩核、让窗口重叠……没有任何改本能消除周期性弱点,平均分配最好也只能把差距从 75.3 收窄到 19.2 个百分点。 还有一个反直觉的细节:最自然的解释是“被窗口边界劈开的键值对更难找”。但在步长 8 的设置下,只有一个排位的键值对会被劈开,其余七个都完整待在同一个窗口里——可它们的准确率差距依然超过 50 个百分点。 看到这你可能会问:DeepSeek后来修了吗?从公开信息看,答案是——没有放弃分块压缩这条路,反而是继续推进压缩能力,同时做工程缓解。 2026 年 9 月发布的 DeepSeek-V4.1-Flash,官方定位就是“推进 KV 缓存压缩的极限”:全局 KV 缓存被压到每 token 890 字节,只有 V4-Flash 的四分之一(作为参照,初代 DeepSeek-V1 是每 token 约 39 万字节);手段包括新的 CSA2 稀疏注意力(部分层生成全局 KV 和索引,后面的层直接复用)、FP4 低精度存缓存,以及 20 层编码器加 20 层解码器的 CED 结构。模型本身也不小:552B 主干参数加 196B Engram 参数,原生支持 100 万 token 上下文。 对相位问题影响最直接的改动是:压缩步长从 4 砍半到了 2。步长小了,一个周期内的“排位”就少了,强弱槽位的差距也被摊薄——在字节的同一套测试下,V4.1-Flash 的最好与最差排位差距降到了 6.1 个百分点(V4-Flash-Base 是 40.2 个),波动周期也从4个token缩短为2个。后训练同样能明显缩小差距(V4-Flash-0731 缩到 19.1 个,V4-Pro-0813 缩到 14.8 个)。 但要看清两件事:第一,6.1不是0,周期性依然存在,只是从“深渊”变成了“浅坑”;第二,V4.1报告的官方口径是“推进压缩极限”(成本),并没有声称修掉了相位问题。更准确的说法是:DeepSeek用工程手段把问题缓解到了可接受的范围,分块压缩这条路线不仅还在用,而且越压越狠。 优点一:问题真实,而且就藏在最流行的模型里。 这不是合成玩具。现象出现在 DeepSeek-V4 全系(V4/V4.1、Base/后训练版本),出现在 128K 真实长度负载上,连“翻车”案例都取自 DeepSeek-V4 的官方推理代码——AI 在自家代码上栽了跟头。对任何依赖长上下文的团队来说,这都是身边的地雷。 优点二:证据链从现象一路闭环到理论,每一层都有对照。 现象层(代码翻转 + 大海捞针 40 个百分点的差距)→ 受控复现层(从零预训练,压缩是唯一变量,锁定因果)→ 机制层(敲除实验发现“相位专精”、门控偏好的涌现、门控移位干预验证因果)→ 理论层(两个定理:最优压缩必然是集中的;训练用的梯度下降会把门控推向“认死理”的静态偏好)。 机制层的做法值得多说两句。所谓“敲除”,就是把某个注意力头的输出替换成它在大量其他文本上的平均表现,再看检索掉多少分。结果是:全注意力模型里,每一层在每个位置的贡献都差不多(热力图上是整齐的横条纹);压缩模型里,则有的头专管靠前的位置、有的头专管靠后的位置。更巧的是,第 9/10/14 层的“压缩门控”恰好分别偏爱窗口的早/中/晚段,和它被敲除后掉分最多的位置一一对应。研究者还把门控参数整体循环移位几个位置,准确率曲线就跟着平移几个位置——这不是碰巧的相关,而是有因果。 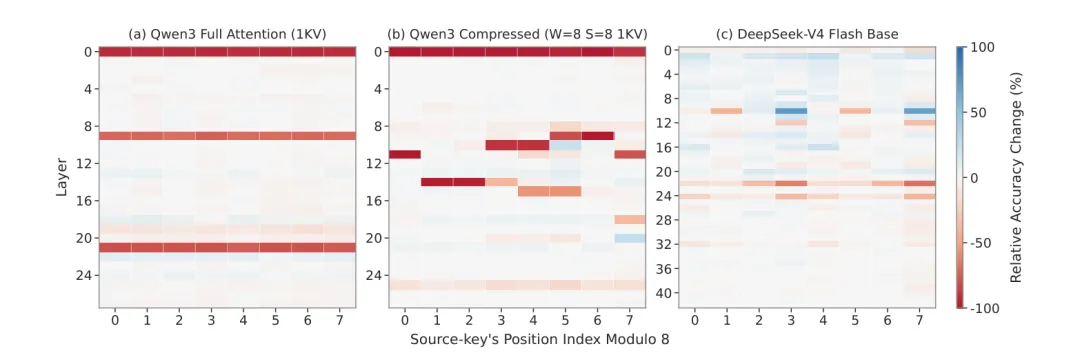
KV 头敲除实验:全注意力模型每层贡献均匀(左),压缩模型不同头在不同位置的贡献高度不对称(中、右)——“相位专精” 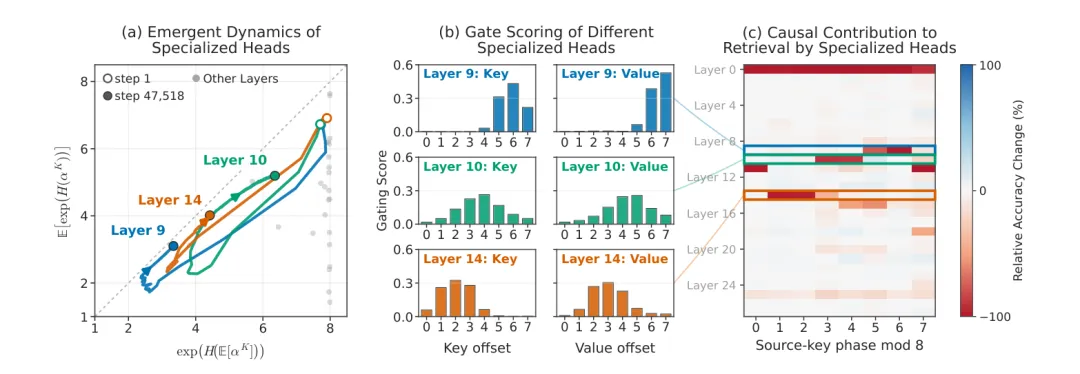
第 9/10/14 层的压缩门控在训练中形成静态集中(分别偏好窗口早/中/晚段),且与其真正发挥作用的排位吻合 优点三:结论立即可用,低成本改变评测习惯。 论文给出的行动建议朴素得可爱:评估带压缩的模型时,把输入平移几个token多测几遍,看跨相位表现,别只看平均分。不需要新框架、新指标,改的只是评测姿势。对天天跟平均分打交道的人,这等于免费升级了一次体检。 问题一:机制拼图还缺最核心的一块。 论文自己承认:门控移位能修复“窗口内”的不对称,却修不回“边界排位”的表现。边界效应和窗口内偏好这两个机制如何叠加、哪个主导,没有统一解释。换句话说,“为什么某些排位特别弱”这个问题,论文只回答了上半场。 问题二:理论是高度理想化的玩具模型。 两个定理建立在不少理想化假设上(精确的向量几何、固定的词嵌入、只做“找下一个词”的归纳任务)——干净,但离真实模型很远。论文自己也说,真实模型的门控“比理论极限软得多”。理论说明的是“静态偏好有可能这样涌现”,而不是“真实模型相位敏感性的完整成因”。 问题三:敲除实验的因果解释有明确边界。 把头的输出换成平均值,不等于“删除记忆”:其他头可能存有冗余信息,一个头也可能在干别的活而不只是携带答案;敲除效应小,也不证明这个头没用。论文坦承没有做“原样替换”的对照实验,也没有在留出的测试集上验证“门控提名”的头;热力图上最显著的损失是从全量扫描里挑出来的,属于探索性分析。 问题四:实际影响和修复方案,都留在了未来。 论文用不小篇幅讨论“意思不变的平移会不会改变模型的拒绝/顺从”,但明确把这留给未来工作;至于怎么修——跨头跨层协调、不牺牲平均性能和压缩效率——完全是开放问题。对想立刻上手减损的工程师来说,这篇论文给了诊断,没给药方。 相位敏感最深远的影响,可能在评测文化层面。RULER早就证明简单的“大海捞针”测试会高估可用上下文;也有前作(Chen 等,ACL 2026)证明聚合分数会掩盖 KV 压缩的特异性失败。这篇论文把这件事又推进了一步:失败不仅有“中间迷失”,还有“周期性塌方”——而后者连残差图都看不见,必须显式地跨相位测量。 往深了想,社区里已经有人在讨论更彻底的解法:让切块“活”起来,根据内容的重要性动态决定边界(动态分块、延迟分块等方向都在探索)。没有固定排位,就没有相位差——代价则是显存管理和硬件对齐的全面重构,短期内指望不上。 可以马上做的倒有不少:训练时加入相位均衡目标;推理时对输入做小幅抖动、多位置集成;压缩率越激进的模型,越应该把跨相位测试当成发布门槛。对国内做高效注意力和长上下文基础设施的团队,这篇论文是一记及时的提醒——压缩换来的效率,可能正在以“周期性弱点”的形式计息。 同一个模型,同一份信息,答不答得对只取决于它坐在第几个位置——这件事本身就该让所有依赖平均分的人后背一凉。但KV压缩本身没有“输”,长上下文该省的钱还得省;字节这篇论文的价值,在于给习惯了看均分的“长上下文评测”装上了一台按相位扫描的显微镜。效率与鲁棒的这笔账,以后恐怕要按相位一笔一笔算。 (本文数据与图片均来自论文《Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression》(arXiv:2609.36322v1);DeepSeek-V4.1-Flash 相关信息来自其技术报告(arXiv:2609.19969))
论文地址:https://arxiv.org/pdf/2609.36322
在128K上下文(约一部长篇小说的体量)的“大海捞针”测试里,DeepSeek-V4-Flash-Base的检索准确率在不同位置之间最大相差 40.2 个百分点(最低 29.69%,最高 69.92%); 在从零预训练的压缩模型家族里,这一差距最高达到78个百分点,而不用压缩的全注意力基线最多只有 6.1个百分点; 最直观的例子:给 DeepSeek-V4 的代码补全任务加一行装饰性注释,只改注释长度、代码一字不动,模型对同一个补全位的答案每隔4个 token 翻转一次。
01 什么是 KV 缓存压缩?“相位”又是什么?
02 论文做了什么:从一次“代码翻转”到完整证据链
03 后续:DeepSeek 没有抛弃压缩
04 这篇论文为什么值得看:三个明显的优点