ARTICLE · 1202186
Doc2Harness:大模型能从文档出发,构建完整的编程智能体 harness 吗?
🤔 把一份开发文档交给大模型,它能不能从零构建出完整的编程智能体运行框架(harness)?
🧠 编程智能体的能力不仅来自基础模型,也取决于 harness。这层模型外围的软件负责主循环、工具调用、上下文管理、权限控制、会话状态与故障恢复。当我们讨论智能体的递归自我改进(RSI, recursive self-improvement)时,改造支撑自身行为的这层基础设施,是其中一个重要环节。🔑 模型能把 harness 构建到什么程度,直接关系到它能否进一步改进自己的运行方式。
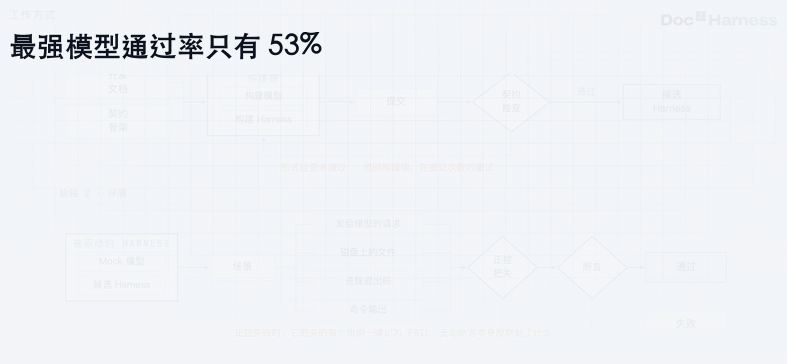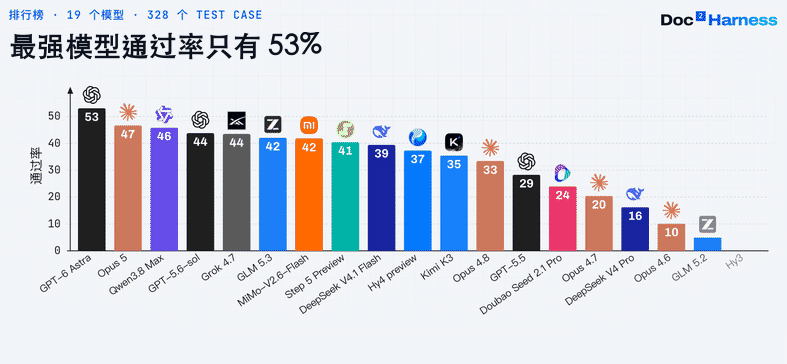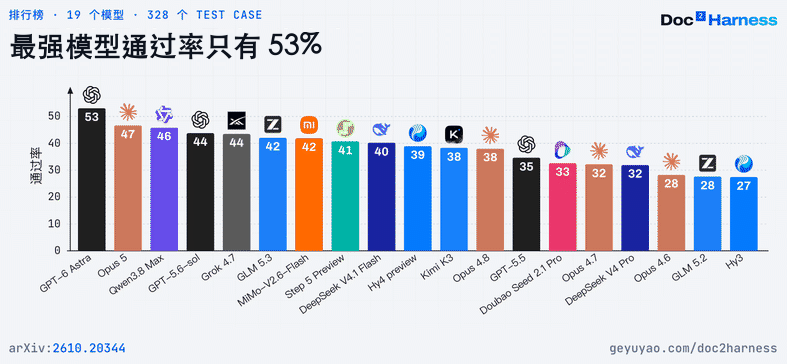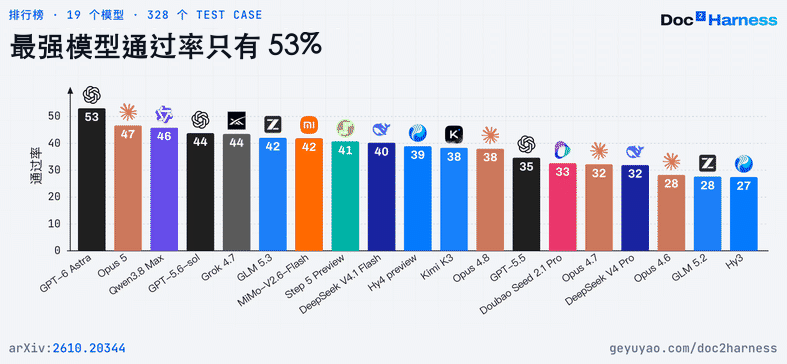
💡 围绕这个问题,我们提出了 Doc2Harness。据我们所知,这是首个直接衡量长程 harness 工程能力的确定性 Benchmark。模型依据开发文档,从只声明接口、不提供实现的契约骨架开始,在隔离容器里完成候选 harness;交付物冻结后,再由脚本化的 mock 模型驱动,接受 328 个 test case 的检验。🎯 在评测的 19 个前沿模型中,排名第一的GPT-6 Astra 通过率仅为 53.05%。😲
1️⃣ 论文标题: Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
2️⃣ 论文地址: arxiv.org/abs/2610.20344
3️⃣ 项目主页: geyuyao.com/doc2harness/
4️⃣ 代码地址: github.com/YuyaoGe/doc2harness
一、🧐动机:为什么 harness 工程需要专门评测?
构建 harness 本身属于软件工程任务。既然已经有不少编程基准,为什么还要为它设计一套评测?问题主要出在数据来源和判定方式上。
📚 就数据而言,NL2Repo-Bench、Commit0 等基准使用的开源仓库大多已是成熟项目,相关代码可能多次进入训练语料。harness 则是近几年兴起、版本更新频繁的一类软件,要求模型处理不断变化的功能与接口,难以仅凭对既有项目的记忆完成构建。
🧪 就判定而言,这些基准通常使用任务附带的单元测试。但同一项 harness 功能可以有多种内部实现,绑定固定内部接口的测试无法直接适配所有写法。更重要的是,harness 必须在模型驱动下运行,才能检验其正确性。👀 我们需要观察的,是它被驱动之后实际表现出的行为。
二、🏗️总体设计:在一个容器中构建,在另一个容器中评测
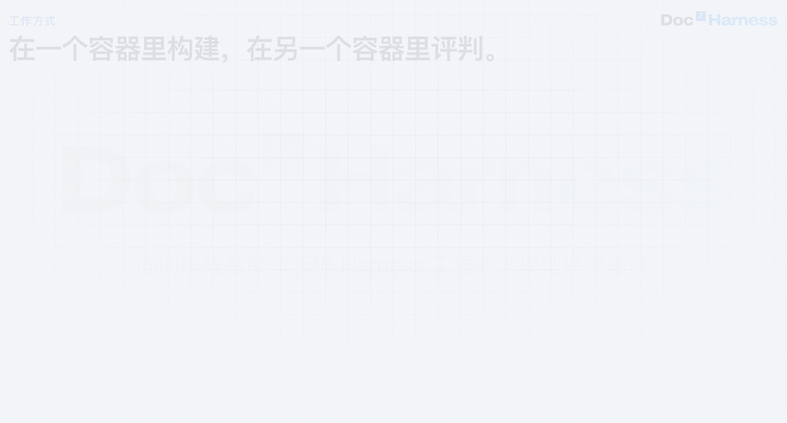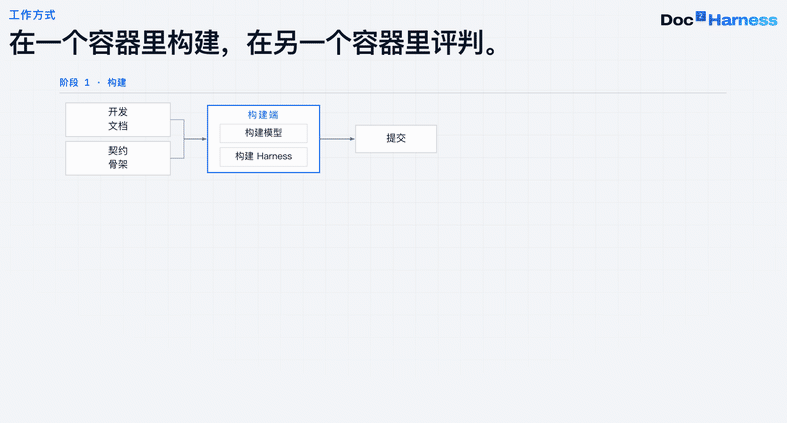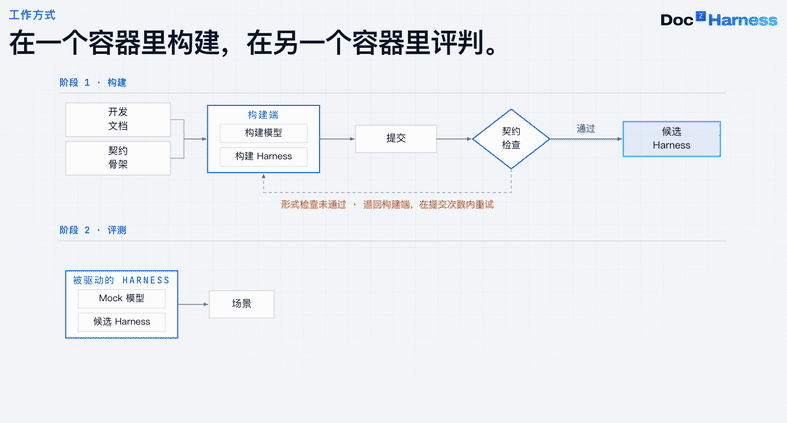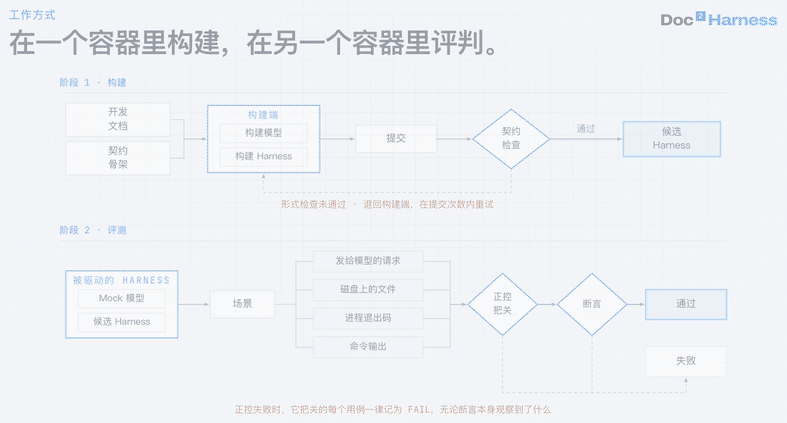
🧩 如何把构建能力与运行时的其他影响分开?Doc2Harness 将流程拆成两个阶段,各固定一个组件,减少混杂因素。
2.1 🛠️阶段一:构建
🤖 构建阶段的 agent 由被测的构建模型(build model)与固定的构建 harness(builder harness)组成。它读取开发文档,从契约骨架开始编写候选 harness。
所有模型使用同一个开源构建框架 OpenCode。我们没有选择 Claude Code 或 Codex CLI,是因为这类框架由模型厂商开发,可能为自家模型带来额外优势。
模型需要主动提交 📤,才能结束构建。提交会触发契约检查(contract check):交付物能否编译安装,必需命令是否齐备,是否还留有占位代码,三个契约接口是否到位。这一步只检查形式,不执行任何 test case。
契约检查通过,交付物即被冻结 ❄️,此后不再修改;未通过则退回,允许模型修改后再次提交。一次构建最多提交 3 次,墙钟时间上限为 2 小时。
2.2 🧪阶段二:评测
📦 接下来,冻结的候选 harness 被放入与构建环境隔离的容器。每个 test case 都有独立容器和初始文件,由 mock 模型按照预设脚本返回响应,驱动候选 harness 完成一轮会话。
🎬 为什么不用真实大模型继续驱动?因为它的随机输出会混入对 harness 的判断。改用脚本化回复后,驱动行为固定,评测便可以依据确定的断言进行判定。
📡 每个 test case 从四个可观测通道(observable channel)读取结果:发送给模型的请求、磁盘文件、进程退出码、命令输出。
🛡️ 部分 test case 还由正控(positive control)把关:用例本身通过、相关正控也全部通过,才记为 PASS;正控不另计入通过率。最终,候选 harness 在全部用例上的通过率反映构建模型的能力。因此,🎯 Doc2Harness 排名的是构建模型,而不是某一款现成的 harness。
三、📦 任务输入:开发文档与契约骨架
📋 模型具体拿到什么?一份规定行为的开发文档,以及一份只保留接口的契约骨架。两者共同降低对现成实现的依赖,让构建尽量依据规格展开。
3.1 📖 开发文档:整合 12 个前沿 harness 的功能
我们用三步形成开发文档。
🗂️ 先收集功能。 从 Claude Code、Kimi Code、Gemini CLI、Qwen Code、OpenCode、OpenClaw、Codex CLI、Aider、OpenHands、Cline、Crush 和 Cursor 共 12 个前沿 harness 的用户文档中提取候选功能,再补齐调用形式、参数含义和边界行为。经过合并、去重与取舍,得到统一的能力清单。
📝 再写成条款。 文档以条款为基本单位,共 10 章,涵盖交付物与运行接口、内置工具、顶层命令与子命令、权限与角色模式、全局参数、会话内命令与快捷键、持久记忆、约定文件、一致性规则和退出码。每项条款都说明语法、含义与预期行为,并要求其效果能够从四个通道之一观察到。除三个契约接口外,文档不限制内部实现。
🧹 最后消除歧义。 不同来源的命令与概念并不天然一致。对于语义重叠的命令,我们统一名称:例如上下文压缩在 Claude Code 中叫 /compact,在 Cursor 中叫 /summarize,文档采用 /compact。
🔀 同名却含义不同的概念则拆开处理。例如「plan」在 Claude Code 中是六种权限模式之一,表示只读;在 Aider 中,提出修改和执行修改由 architect、editor 两个角色分别承担。因此,文档将只读要求归入权限,将提出与执行修改的职责归入角色,分别形成条款。
3.2 🦴 契约骨架:约 70 行代码,其余交给模型
契约骨架由 mini-swe-agent 精简得到,仅有 5 个 Python 源文件,合计约 70 行,另附安装脚本、入口脚本和项目配置,不含功能实现。🔒 不可修改的外部契约有三处:命令行接口(CLI)、Headless 入口,以及供自动化评测驱动的 API。
✍️ 精简骨架,是为了让更多实现由模型自己完成。论文中一份有代表性的候选 harness 约含 30 个 Python 源文件、16,000 行代码,其中约 99.6% 由构建模型编写。
🧱 每次构建使用全新的空容器,除指定模型网关外不能访问外网。启动前还会预检容器中是否存在多余文件、OpenCode 是否能正常运行;任一条件不满足,便中止该次构建。
四、🧬 test case 合成:328 个用例是怎样构建的?
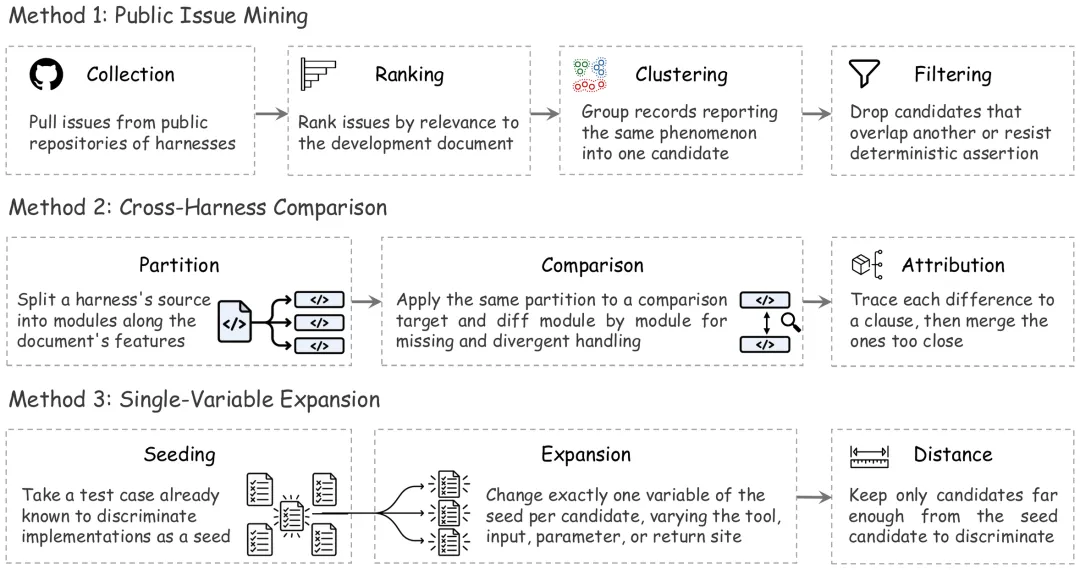
🎯 文档明确了要实现什么,测试又该从哪里来?我们的要求是:每个 test case 都对应文档中的具体条款,同时力求区分不同实现。为此,三种方法交替使用:前两种拓宽覆盖面,第三种深入已有功能;一种方法的边际产出下降后,再转向下一种。
4.1 ⛏️ 公开 Issue 挖掘(Public Issue Mining)
成熟 harness 的真实问题,是测试设计的重要线索。大模型从人类代码中学习,而模型写出的 harness 与成熟项目面对相同的接口语义、相近的边界条件。因此,成熟项目曾经暴露的缺陷,也可能出现在模型的实现里。
我们采集了四个前沿 harness 公开仓库的 issue,过滤 pull request 后的数量如下:
| 合计 | 21,083 |
🔎 记录按与开发文档的相关度排序,从最相关的部分开始审阅,随着边际收益下降停止。描述同一现象的记录归为一类,形成候选 test case。
如果两个候选对应同一条款,观察到的效果又十分接近,可能在同一批实现上同时通过或失败,我们就只保留材料更完整的一个。候选还必须能转化为确定性断言,且没有被已有测试覆盖,才会被收录。
4.2 ⚖️ 跨 harness 对比(Cross-Harness Comparison)
公开 issue 不能覆盖所有问题,因此第二条路径直接比较源码。我们依据文档中的功能,把候选 harness 划分为若干模块,再用同样方式划分 Kimi Code、Qwen Code 等成熟 harness,逐项对照:成熟实现多处理了什么?两者在哪些边界上行为不同?
📌 代码差异并不自动等于缺陷。每一处差异都需要回到开发文档,只有能从某条条款的意图推导出的行为要求,才进入候选测试。
4.3 🌱 单变量扩展(Single-Variable Expansion)
找到一个有区分度的用例后,还可以继续追问:换一种触发方式,实现是否仍然正确?
test case 由场景和断言组成。单变量扩展以已有用例为种子,保持断言不变,每次只修改场景中的一个变量。可变化的维度包括:
工具。 同一目的可通过不同工具完成,模型可能只正确实现了其中一种。 输入形式。 例如检查路径逃逸时,可将输入改为指向文件、目录、多级或相对路径的符号链接。 出错的参数。 同一种编码错误可能发生在不同参数上,例如将数值 0 误当成缺省值。 结果出现的位置。 相同行为的结果可能通过标准输出、标准错误或错误信息返回。
🔄 新候选要经过相似性检查;与种子过近的被剔除,其余成为正式用例,并可作为下一轮扩展的种子。对于尚无测试对应的条款,单变量扩展没有起点,仍需前两种方法补充。这也是三种方法交替使用的原因。
五、🛡️ 正控:测试通过,为什么还可能是“空过”?
5.1 空过问题
🤔 一个 test case 显示通过,就能说明需求实现正确吗?不一定。
⚠️ 以路径逃逸为例,mock 模型按脚本要求候选 harness 使用 read 工具读取一个指向工作区外部的符号链接。测试断言是:外部文件内容不能出现在发送给模型的请求中。
内容没有出现,可能因为越界读取被正确拦截,也可能因为 read 工具根本无法读取文件。这两种实现都满足表面断言,只有前者真正实现了要求;后者就是空过(vacuous pass)。
5.2 🔐 三类正控
正控用来区分这两种情况。它沿用被把关用例的场景和初始文件,只调整输入或访问途径,选择不受被测条款限制的情形,检查观测前提是否成立。在断言构造正确的前提下,三类正控分别排除三种空过原因。
通道正控(Channel):工具结果真的进入观测通道了吗? 用 read 工具读取普通文件,确认内容出现在模型请求中。如果正常内容都不能送达,那么禁止内容没有出现,也无法证明拦截有效。
同形正控(Same form):不受限制的访问能完成吗? 保持输入形式不变,改用 bash 访问同一个符号链接,确认它能解析到工作区外且目标文件可读。这里的路径逃逸条款约束文件工具,不涵盖 bash 执行的命令。如果连这种访问都失败,原测试未读到内容就不能归因于越界拦截。
反向正控(Reverse):合法情形有没有被一起拒绝? 拒绝所有符号链接的实现,也能通过越界读取测试,却同时破坏了指向工作区内部的正常链接。将输入换成内部链接并执行相同读取,确认内容仍能出现,才能排除这种一概拒绝的实现。
下图对照了几种典型实现的测试结果。后三种实现的主断言虽然通过,但正控暴露了观测前提不成立,最终仍记为 FAIL。
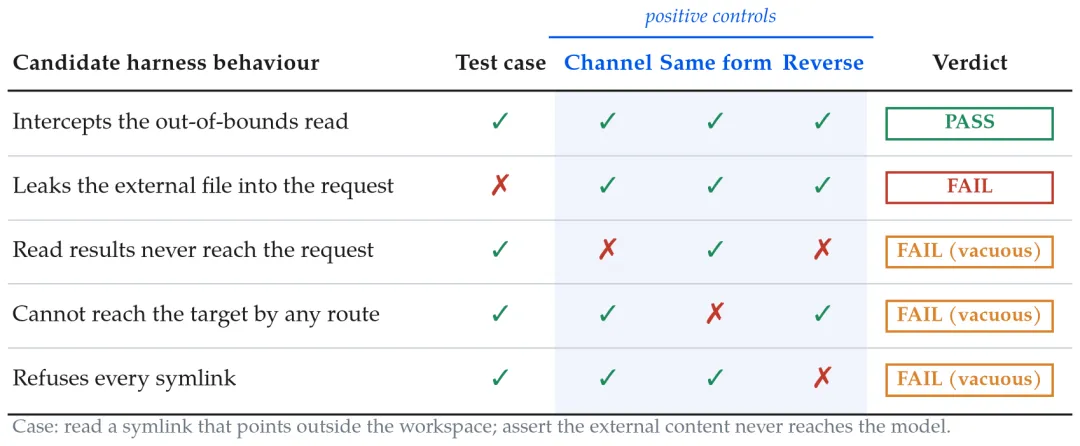
多个 test case 可以共用一个观测前提,也就可以由同一个正控把关;一个用例依赖多个前提时,则需要多个正控。只要相关正控中有一个失败,被把关用例就记为 FAIL,无论其自身断言是否通过。
六、🗺️ 测试集统计
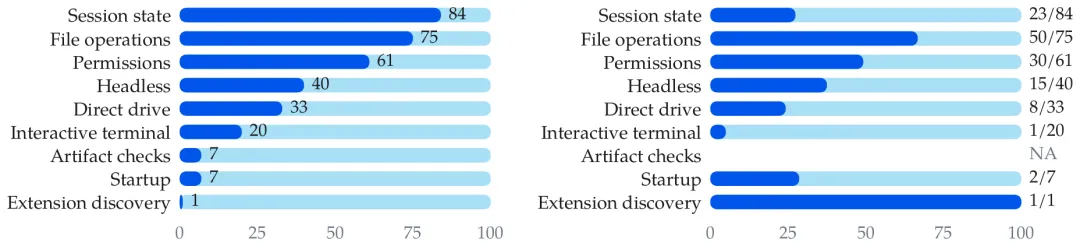
🧮 328 个 test case 按照开发文档与三个外部契约划分为 9 个互不重叠的类别。左图展示各类数量:会话状态 84 个、文件读写 75 个、权限 61 个、Headless 40 个、直接驱动 33 个、交互终端 20 个、交付物检查 7 个、启动 7 个、扩展发现 1 个。
🛡️ 右图展示各类别中受到正控把关的比例。共有 130 个用例至少对应一个正控:114 个对应一个,15 个对应两个,1 个对应三个。
文件读写与权限类的正控覆盖率最高,交互终端最低。交付物检查标为 NA,是因为这些内容已由契约检查完整核验。覆盖范围最大的正控可同时为 6 个用例把关,确认的是指向工作区外部的符号链接确实可读。
七、📊 实验结果
我们评测了来自 11 家厂商的 19 个前沿模型。每个模型独立构建三次,三份候选 harness 全部参与计分,共得到 57 份构建。
7.1 🏆 最好的模型,也只通过约一半
GPT-6 Astra 以 53.05% 居首,Hy3 为 27.44%,首尾相差约 26 个百分点。即便排名第一,仍有近一半 test case 未能通过,这项能力距离饱和还有很大空间。
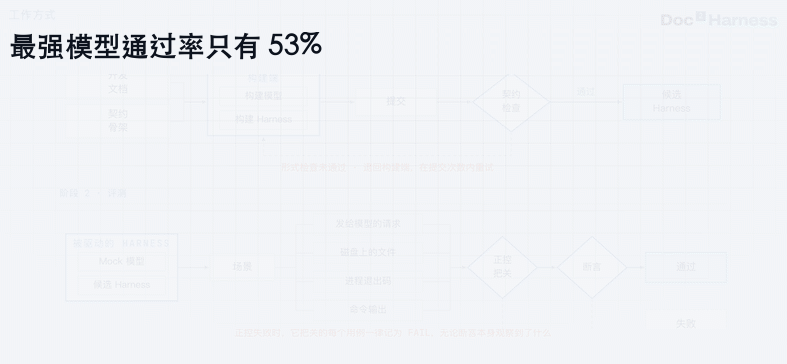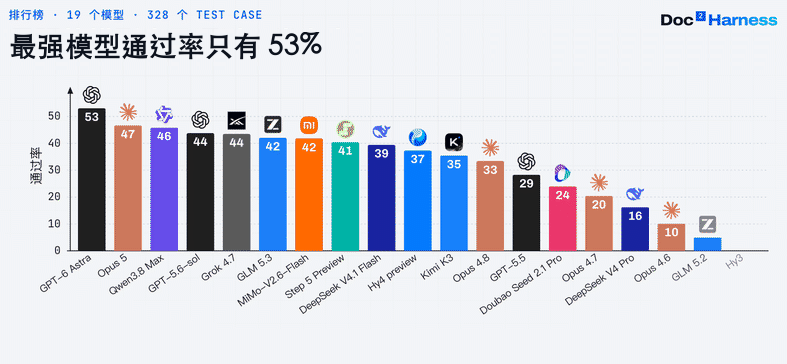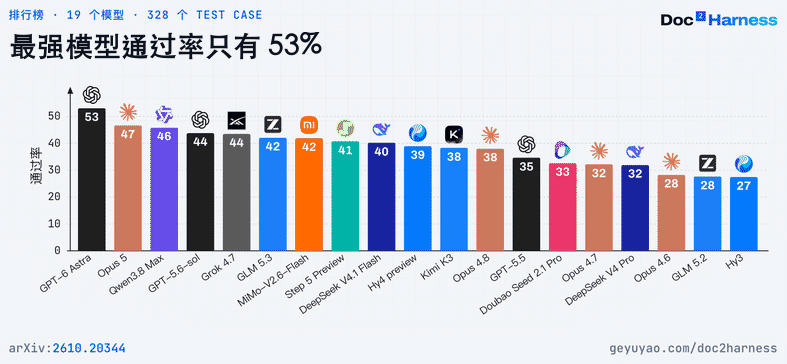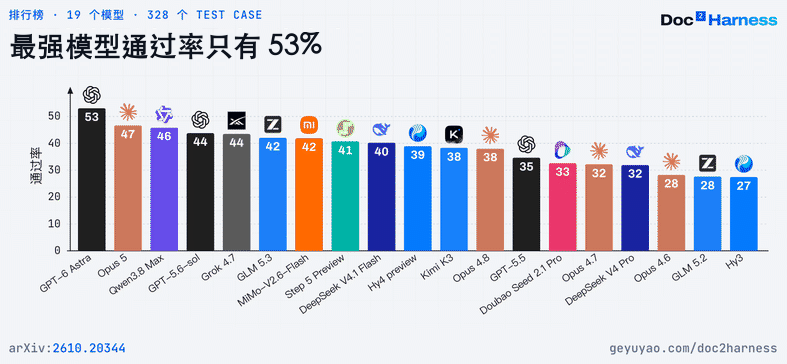
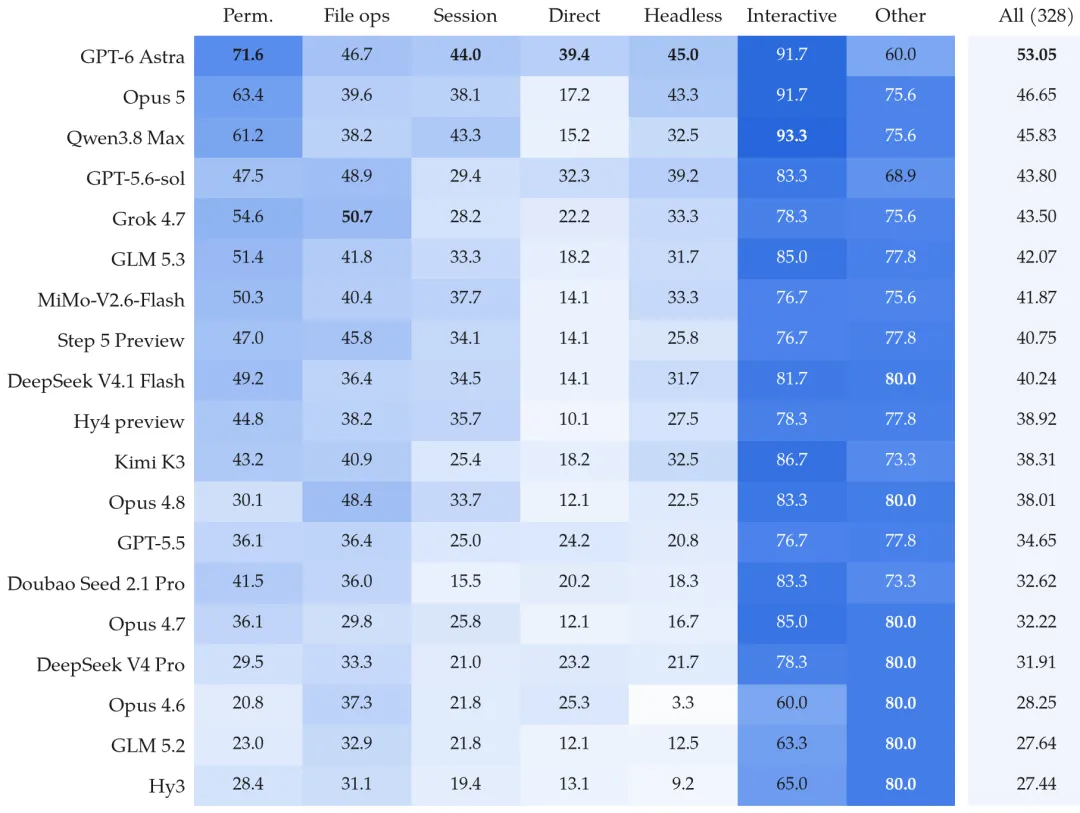
🔀 前两名的差距在哪里?把普通场景与边界场景拆开,领先者发生了变化:普通场景下,Opus 5 为 80.68%,领先 GPT-6 Astra 的 72.46%;边界场景下,GPT-6 Astra 以 48.97% 反超,Opus 5 为 37.02%。🎯 两者的总体差距,主要来自边界条款的处理。
不同类别的区分能力也有明显差异。权限类平均通过率为 **43.7%**,最强与最弱模型相差 50.8 个百分点,61 个用例中有 51 个能区分模型。文件读写平均为 39.6%,与权限类相近,但强弱差仅 20.9 个百分点。
交互终端的平均通过率达到 79.9%,相比其他类别更接近饱和。🚧 另有 56 个用例没有任何一份候选 harness 通过。
7.2 🎢 同一个模型,换个类别会排第几?
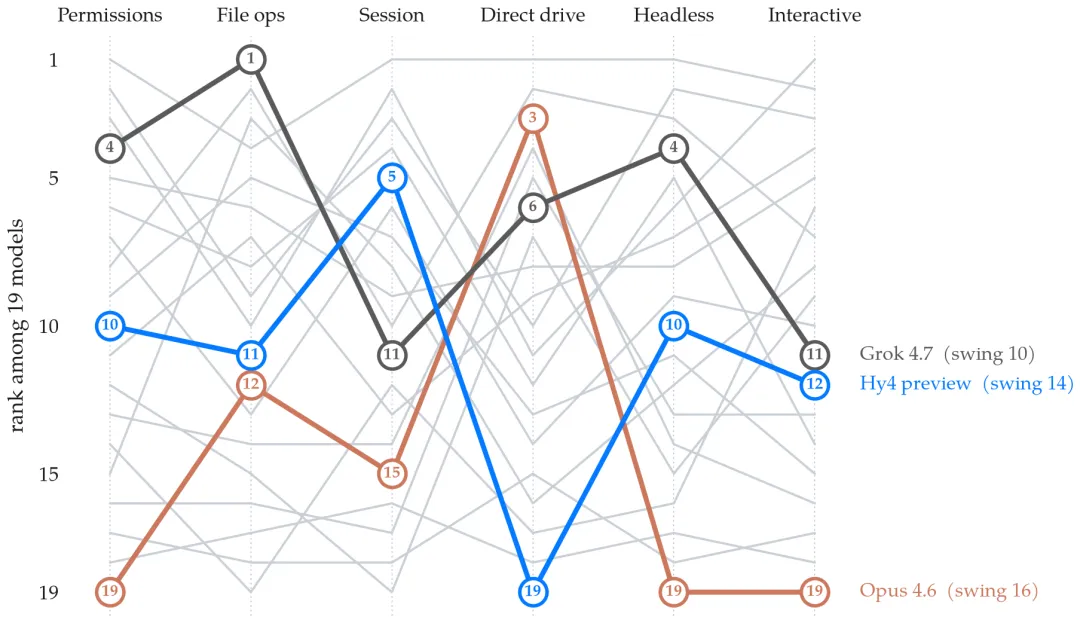
🔄 在六个主要类别中,同一模型的名次跨度最多达到 16 位。例如,Opus 4.6 在直接驱动中排第 3,在权限中排第 19;Grok 4.7 在文件读写中排第 1,在会话状态中排第 11。
📈 名次变化大,不代表不同能力之间存在明显的此消彼长。六个类别两两之间的 15 个相关系数均为正,平均 +0.521,说明差异主要仍体现在模型的整体能力上。
✅ 全部用例在 57 份构建上的 KR-20 系数为 0.913,表现出较高的内部一致性,与测试集测量同一底层能力的预期相符。
7.3 🧩 模块划分越细,得分是否越低?
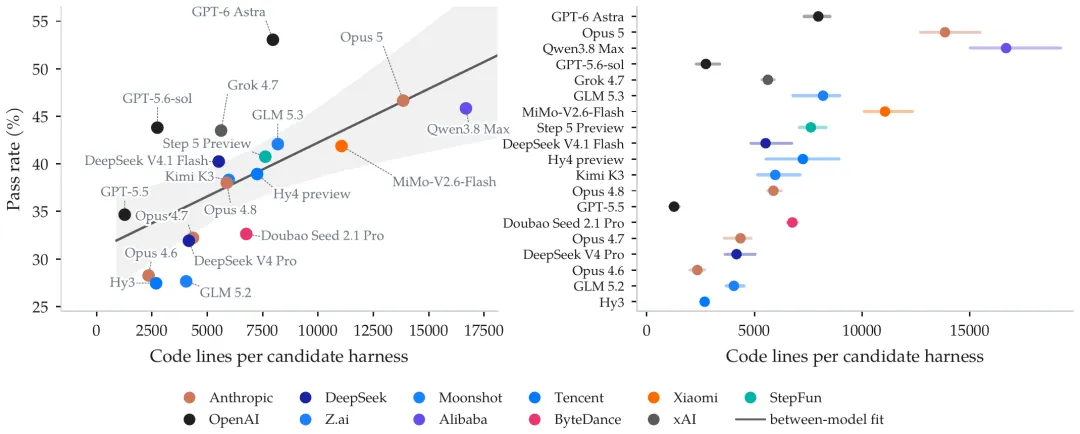
🔬 我们进一步解析了全部 57 份候选 harness 的源码。图中左侧每个点对应一个模型三份构建的平均,右侧呈现同一模型三份构建的分布。
📏 同一模型倾向于写出规模相近的实现,而模型之间的差异大得多:代码行数的方差有 95.9% 来自模型之间。对全部 57 份构建计算,代码行数与通过率的相关系数为 0.614。
📉 控制代码行数后,模块数与通过率的偏相关为 −0.423;逐一剔除单个模型,结果仍在 −0.484 到 −0.309 之间。与之对应,每模块行数与通过率的偏相关为 +0.504。
💡 也就是说,在代码量相当时,模块划分更分散的候选 harness 倾向于取得更低的成绩。这一相关性提示,横跨多个功能的要求如何在模块之间组织,值得进一步研究;它不意味着简单减少模块就能提高得分。
八、🚀 总结
🎯 Doc2Harness 将“模型能否依据文档构建完整 harness”变成了一项可以确定性测量的能力。统一的构建框架、整合 12 个前沿 harness 功能的开发文档,以及约 70 行的契约骨架,共同构成起点;模型交付后,再由 mock 模型驱动 328 个用例,从四个通道检验行为。
🛡️ 构建与评测相互隔离,不依赖内部实现来判定正确性;对于可能空过的用例,正控进一步核实观测前提,让通过不仅停留在表面断言上。
📊 19 个模型的实验表明,长程 harness 构建仍有很大的提升空间。GPT-6 Astra 的通过率也只有 53%,而源码分析进一步揭示了模块划分与得分之间的关系。
✨ 从使用现成的编程智能体,到构建支撑智能体的运行框架,这一步值得被单独衡量。 我们希望 Doc2Harness 为研究模型的长程工程能力、改进 Agent 基础设施提供一个可复现的起点。
🎁 开发文档、测试用例、评测协议与交互式排行榜已公开。欢迎试用、复现和交流,也欢迎为本文点一个 Star。⭐