ARTICLE · 1203624
一个坏了七年的小工具,我用 AI 三分钟修好了 记录Rea一次简单的逆向
文中的软件名称、公司信息、接口地址与最终网址均已做脱敏处理。
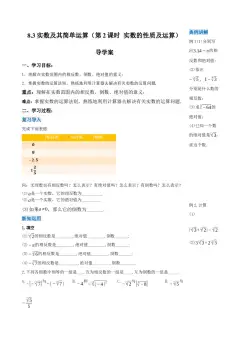
一、起因:一个永远显示 1970 年的小工具
事情很小。
我有个用了几年的小软件,功能简单到不能再简单——自动校准电脑时间。点一下按钮,它去网上抓个标准时间,跟本机比一比,差得多就校准,差得少就不管。
直到最近我发现,它一直在骗我。
界面永远是这两行:
服务器时间: 1970-01-01 08:00:05服务器获取时间失败
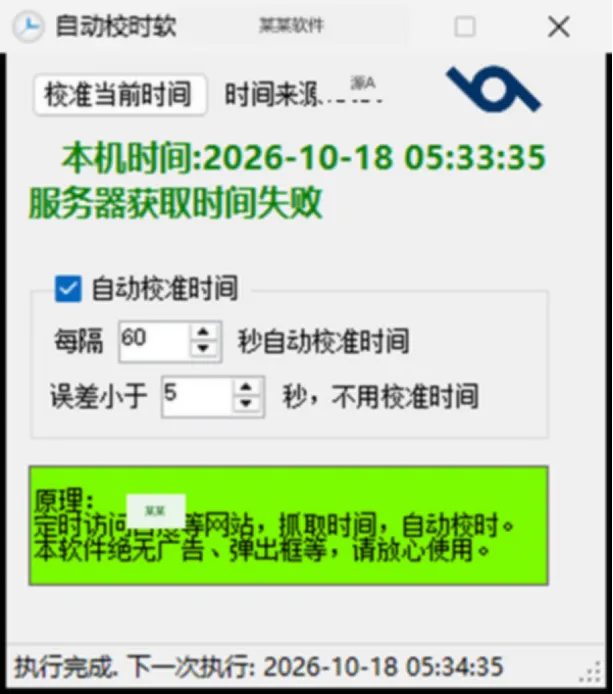
原软件界面实拍(已脱敏)——本机时间正常,但「服务器时间」永远是 1970 年
打开日志一看,问题比我想的严重——17 万条失败记录,横跨四个月。而且再往前翻,能翻到一个明确的分界点:某一天之前一切正常,之后全部失败。
2026-06-08 服务器时间:2026-06-08 13:58:24 误差:0s ← 最后一次正常2026-06-09 服务器时间:1970-01-01 08:00:05 抓取失败...(此后全是失败)
那个1970-01-01 08:00:00不是随机数,它是Unix 时间的原点(东八区)。
一个时间工具,拿到的值是 0。
二、先请出工具:REA 到底是什么
我这次用的主力工具叫REA,全名是「Reverse Engineer Anything」——逆向任何东西。
它火得有点夸张,GitHub 上 30 万 star,涨得比很多明星项目还快。但它不是又一个聊天机器人,理解它只需要一句话:
它给 AI 编程助手装上了一双能拆程序的手。
平时你用 AI 问「这个功能怎么实现的」,它多半只能靠经验猜,给你一段似是而非的伪代码。
接上 REA 之后就不一样了——AI 会真的去把程序拆开:解包、反编译、提取字符串、追调用链路,然后拿着证据回来跟你说话。
它的工作流程是五步:
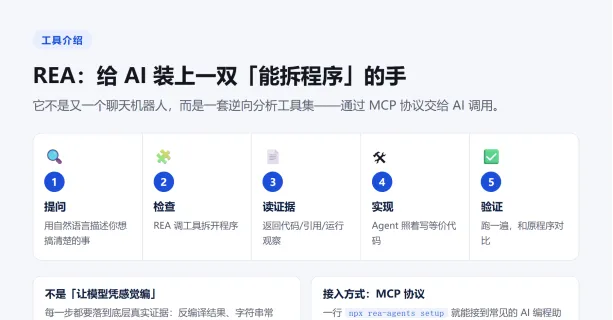
关键在「读证据」这一步。REA 不会让模型凭感觉编,每一步都要落到底层真实数据上:这条指令是什么、这个字符串常量是什么、这个函数被谁调用。
接入也很简单,一行命令:
npx rea-agents setup
它会自动扫出你机器上装了哪些 AI 编程助手,勾选一下就配置好了(改配置前会自动备份)。装完重启助手,直接说人话就行:
「帮我分析这个程序的某个功能是怎么实现的」
剩下的它自己会做。
三、第一步:让它自己说出病在哪
我把那个 exe 丢给 REA,问了一个很朴素的问题:
这个程序是去哪拿时间的?为什么拿不到?
REA 先做了件基础工作——识别程序类型。结论是:.NET 程序,x86,不到 100 个方法,结构不复杂。
接着它把里面的字符串常量全捞了出来。这一步直接命中:
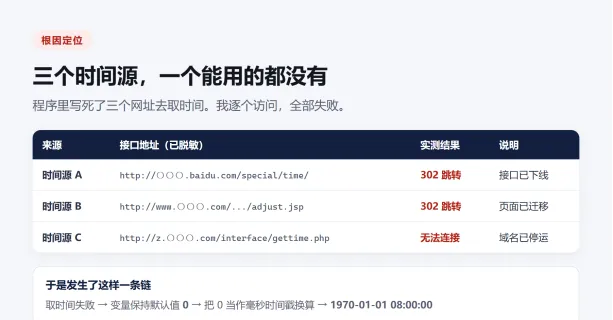
程序里写死了三个时间源网址,全部来自十来年前的主流服务。
我挨个手动访问了一遍——一个能用的都没有:
来源 | 实测结果 | 说明 |
时间源 A | 302 跳转 | 接口已下线 |
时间源 B | 302 跳转 | 页面已迁移 |
时间源 C | 无法连接 | 域名已停运 |
到这里,病根基本清楚了。但为了确认,我又让它往下挖了一层。
四、第二步:把黑盒拆开,看清那条因果链
我让 REA 把程序里跟时间有关的方法全部列出来,然后逐个还原逻辑。
结果非常干净——三个方法长得几乎一模一样,只是网址和截取位置不同:
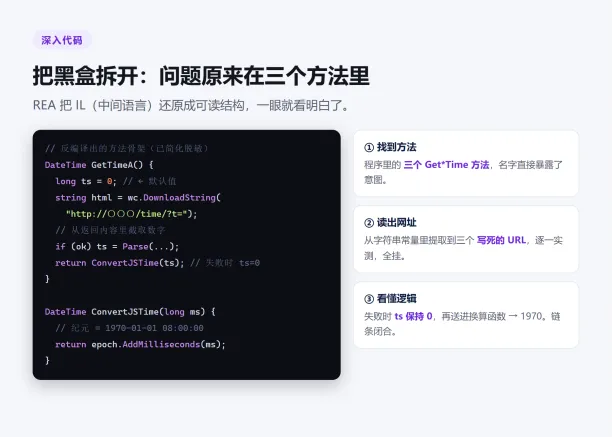
看这段骨架就明白了:
DateTime GetTimeA() { long ts = 0; // ← 默认值是 0 string html = wc.DownloadString( // ← 请求写死的网址 "http://〇〇〇/time/?t="); if (ok) ts = Parse(...); // ← 成功才赋值 return ConvertJSTime(ts); // ← 失败时 ts 还是 0}DateTime ConvertJSTime(long ms) { // 纪元 = 1970-01-01 08:00:00 return epoch.AddMilliseconds(ms); // 0 毫秒 = 就是纪元本身}
因果链闭合了:
网址全部失效 ↓请求抛异常 → 走 catch 分支 → ts 保持 0 ↓0 被当成毫秒时间戳送进换算函数 ↓epoch + 0 毫秒 = 1970-01-01 08:00:00 ↓界面显示「1970-01-01 08:00:05 抓取失败」
那个多出来的 5 秒,是程序在失败路径上又叠了几次重试的时间累积。
不是电脑时间错了,是这个工具从来没拿到过正确的时间。
五、第三步:修,有两条路,但只有一条走得通
知道病因之后,摆在面前两条路:
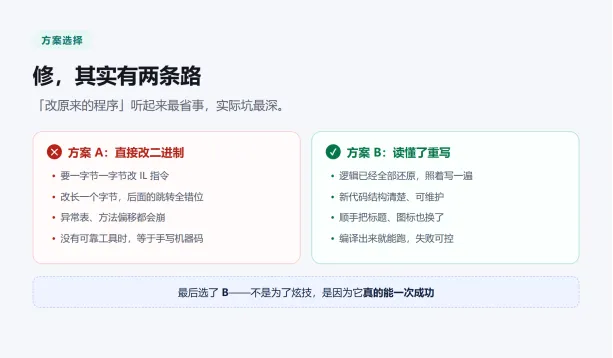
方案 A:直接改原来的程序。
听起来最省事——既然问题在三个方法里,把它们的逻辑改掉不就行了?
实际动手才知道有多坑:
·要改的是IL(中间语言),不是源码
·IL 是变长编码,改长一个字节,后面所有跳转偏移会全部错位
·异常处理表的偏移也会跟着崩
·手上没有可靠的 IL 汇编器,等于手写机器码
我试了一下就停了。这条路的风险远大于收益。
方案 B:读懂了,重写一遍。
逻辑已经全部还原出来了,而且结构极简。与其在二进制里动刀,不如照着重写一个——功能一致,代码干净,还能顺手把想改的地方一起改了。
我选了 B。
六、第四步:重新设计时间获取
重写时最关键的一件事:不能再赌一个接口。
原程序的问题是「三个源全挂就彻底失败」。新版本改成三级降级:
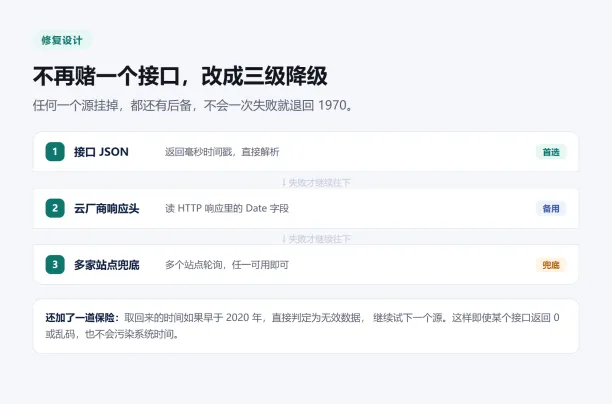
三级设计:
1.接口 JSON —— 找一个还在正常返回毫秒时间戳的接口,直接解析(首选)
2.云厂商响应头 —— 任何 HTTP 响应都带 Date头,读它就行(备用)
3.多家站点兜底 —— 多个站点轮询,任一可用即可(兜底)
只要还有一个活着的源,就不会退回 1970。
另外加了一道保险:取回来的时间如果早于 2020 年,直接判定为无效,继续试下一个源。这样即使某个接口返回 0 或者返回一个错误页面被解析出乱码,也不会污染系统时间。
我还把「自动轮询」改成记住上次成功的源——下次优先用它,减少无效尝试。
七、第五步:交给用户选
修的过程中我意识到一件事:时间源是会变的。
今天能用的接口,三年后可能又没了。所以我干脆不写死——把选择权交给用户:
界面上加一个下拉框:
·自动(推荐) —— 三级轮询,任一成功即用
·指定源 A / B / C —— 固定用某一个
·自定义 URL —— 填你自己维护的时间接口
选自定义时,程序会弹窗让你输入地址,支持两种返回格式自动识别:
·JSON 里的时间戳(13 位毫秒 / 10 位秒)
·HTTP 响应头的 Date字段
选择会存进配置文件,下次启动自动恢复。
这比把三个网址写死在代码里,强太多了。
八、验证:不是「看起来对了」,是真的跑通了
改完必须验证,而且要验到能拿出证据。
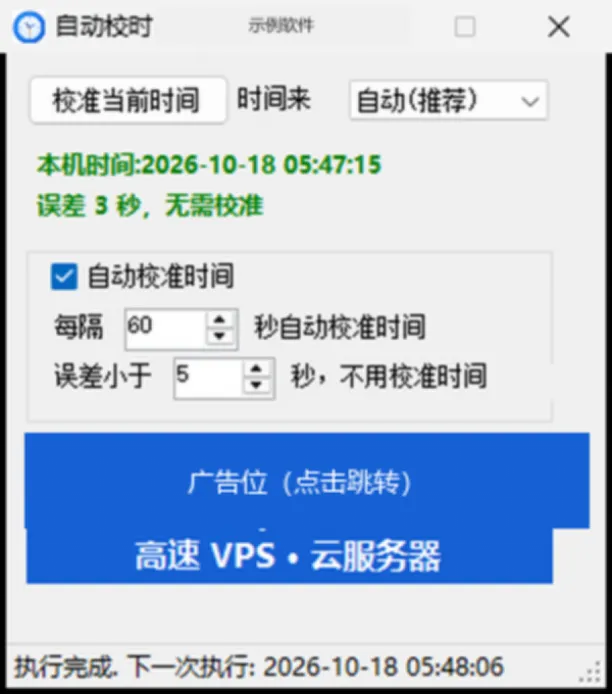
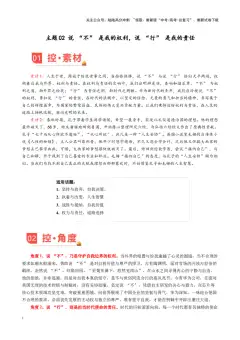
修复后的实际界面(已脱敏)——时间源可选,误差 3 秒
我在一个全新的空目录里,只放一个 exe,双击运行:
第一条证据 —— 进程正常启动
进程存活: True运行日志: 已生成 40 bytes配置文件: 已生成 240 bytes
配置文件里能看到新增的字段:
<Setting> <Auto>true</Auto> <Span>60</Span> <Diff>5</Diff> <Source>0</Source> ← 时间源选择 <CustomUrl /> ← 自定义地址</Setting>
第二条证据 —— 时间真的拿到了
程序自动跑了一轮,日志直接给出答案:
2026-10-18 05:47:06 服务器时间:2026-10-18 05:47:03本机时间:2026-10-18 05:47:06误差:3s
界面同步显示:误差 3 秒,无需校准。
从「1970 年抓取失败」到「误差 3 秒」,问题彻底解决。
九、顺手做的一件事:点击能跳转
修完之后我又加了个小功能——界面底部有个广告条,点一下应该能打开网址。
第一次写完,点了没反应。
排查发现两个问题:
4.只绑了 `Click` 事件,某些环境下 Label 的点击不灵 —— 改成 Click + MouseClick双绑定
5.`catch { }` 把异常吞了,失败时毫无提示 —— 改成三级降级:
try { // 首选:ShellExecute 走系统默认浏览器 Process.Start(new ProcessStartInfo { FileName = url, UseShellExecute = true // ← 关键 });} catch { try { Process.Start("explorer.exe", url); } catch { MessageBox.Show("无法打开浏览器,请手动访问:" + url); }}
`UseShellExecute = true` 是关键。新版 .NET 默认不解析 URL 协议,必须走 ShellExecute 才会调起系统默认浏览器。
改完实测:
点击前浏览器进程数: 57点击后浏览器进程数: 59 → Delta=+2
浏览器窗口标题确认已打开目标站点。
这个细节值得记住:功能「写了」不等于「能用」,必须点一次看结果。
十、六条经验,比技术本身更值钱
整个过程走下来,技术上的收获其实有限,但方法论上的教训很多:
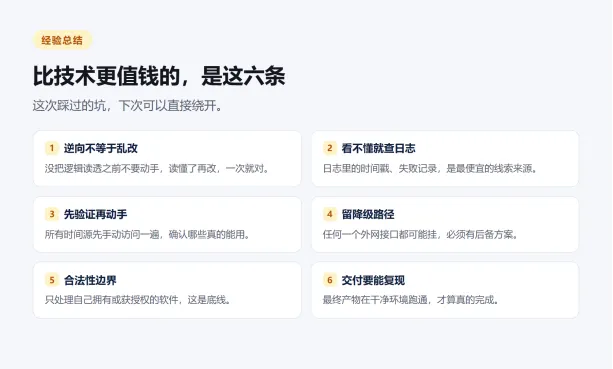
① 逆向不等于乱改
没把逻辑读透之前不要动手。我一开始想直接改 IL,试了几分钟就意识到风险太大——读懂了再改,一次就对。
② 看不懂就查日志
那 17 万条失败记录,是所有线索里最便宜的。日志里的时间戳、失败模式、分界点,能直接把范围缩小到某一天、某个功能。
③ 先验证再动手
所有时间源先手动访问一遍,确认哪些真的能用。这一步花两分钟,省下后面两小时。
④ 留降级路径
任何一个外网接口都可能挂。单点依赖的设计,迟早会在某一天集体失效——就像这个程序的三个源。
⑤ 合法性边界
只处理自己拥有或获授权的软件。这是底线,不是建议。
⑥ 交付要能复现
最终产物必须在干净环境跑通,才算真的完成。我的验证方式是:解压到空目录,只留一个 exe,双击,看结果。
最后
这次修复最让我意外的,不是「AI 能反编译」这件事本身。
而是它把逆向的门槛拉到了普通人够得着的位置。
以前遇到一个坏掉的、没有源码的软件,选择只有两个:忍着用,或者扔掉。现在多了第三个——读懂它,然后自己修。
那个 exe 现在已经能正常工作了。整个过程从「看不懂的黑盒」到「能改能修能重写」,用了三天。
而真正花时间的,其实不是技术,是耐心:耐心看日志、耐心读代码、耐心验证每一个假设。
工具能加速,但代替不了这一步。
说明:本文涉及的所有软件名称、公司信息、接口域名与最终网址均已脱敏或替换。
逆向分析仅用于软件架构学习与自有软件维护,请遵守相关软件许可协议与法律法规。