ARTICLE · 1209699
AI 求职助手 5.29 万星:默认 fork 是公开仓库
10 月 19 日早上,MadsLorentzen/ai-job-search 排在 GitHub Trending 日榜第一,页面显示 2,213 stars today。仓库已有 52,918 个星标、17,325 个 fork,最新提交在 10 月 18 日 19:38 UTC。
这不是一个新仓库,建仓时间是 2026 年 3 月 18 日。它今天重新被推上来,靠的是一个很具体的工作流:把 Claude Code 改造成求职助手。
/setup 建立职业档案,/scrape 搜索岗位,/rank 按匹配度排名,/apply 读取职位描述、改简历、写求职信、让另一个 agent 审稿、编译 PDF,再检查文本层;/interview 准备面试,/outcome 记录申请结果。项目把自己定位成“求职工作流”,不是自动投递机器人。材料最后仍由使用者自己发出去。
它把改简历做成了交付流程
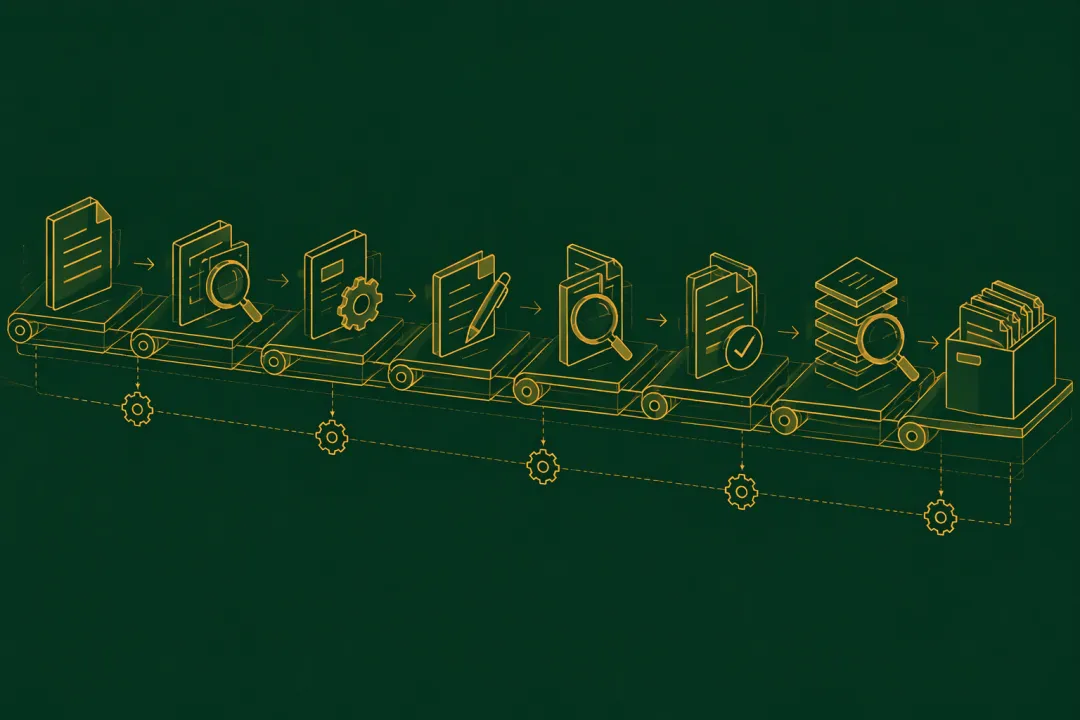
普通简历工具大多停在生成一份文档。这个项目把 /apply 拆成起草、复审、编译和检查四段。
起草阶段读候选人的真实档案,按职位要求重排经历和关键词。复审阶段启动一个独立上下文的 reviewer,专门找遗漏、弱表达和无法自圆其说的内容。编译阶段用 lualatex 生成简历、用 xelatex 生成求职信,要求简历正好两页、求职信正好一页。最后一步用 pypdf 或 pdftotext 提取 PDF 的文本层,检查邮箱、电话、日期和关键词在 ATS 眼里是否还在。
这一步有意义,因为 LaTeX 编译成功不代表 ATS 能读到内容。联系方式只放在图标或超链接里、多栏排版把阅读顺序打乱、日期里的连字符被排版成别的字符,都可能让一份看起来正常的 PDF 在招聘系统里变成另一份文件。项目把这些检查写进了工作流,而不是留给使用者凭感觉判断。
作者自述用这套流程投了 69 次定制申请,拿到 20 次首轮面试,并在 2026 年 6 月入职。这个结果是他自己的经历,不是独立测评,但它解释了项目为什么会围绕“反复改简历”长出这么多步骤。
README 自己写了:fork 是公开的
项目的 Quick start 第一步是:
gh repo fork MadsLorentzen/ai-job-search --clone紧接着的 Important 提示写着:这个仓库的 fork 永远公开,GitHub 不允许把公开仓库的 fork 设为私有;而 /setup 会把姓名、联系方式、工作经历和薪资预期写进 tracked 文件。如果只是拿它做自己的求职,不是要向上游贡献代码,应该建一个私有仓库,把原仓库作为 upstream。
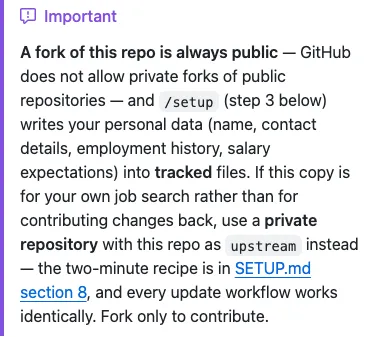
“写进 tracked 文件”不等于按下保存就对外公开。风险发生在 commit 和 push 之后:个人档案进入公开 fork 的 Git 历史,之后即使删掉工作区里的文件,历史里仍然留着。
项目在 2026 年 8 月 29 日的 v1.7.0 发布说明里记录过一次真实泄露:gh repo fork --clone 会把 upstream 设为 gh 的默认仓库,而 gh 创建 issue 时默认使用这个仓库。一个用户的自动化流程在 fork 里执行 gh issue create,目标求职公司、匹配分数和个人限制就被发到了上游公开 tracker。发布说明记录的是“一周内来自两个用户的四个 live instances”。
修复方式是在 SETUP 里加上 gh repo set-default <your-username>/ai-job-search,并在 issue 模板里提醒。现在的 /setup 还会在写文件前检查 origin,发现是公开 fork 就先停下来询问。这道护栏有用,但它只覆盖 /setup 这一条路径,判断也依赖 gh 和远端配置;使用者仍然要自己保证不把个人提交推到公开仓库。
职位描述也会进入 Agent 的上下文
项目把职位描述当成不可信输入:不执行招聘启事里夹带的指令,不抓取正文里的链接,研究公司时从用户确认的公司名重新搜索。这些规则写得很具体。
但项目自己的 SECURITY.md 也写明,这些是指令级防御,不是 sandbox。Agent 仍然同时拥有文件访问、网页读取和个人档案。WebFetch 和 WebSearch 不在 Bash 的 allowlist 范围内,招聘页面上的内容一旦进入上下文,能不能守住边界要靠模型遵循规则和人事后检查。
截至 10 月 19 日,主分支的 job-application-assistant 技能仍在 allowed-tools 里授予裸的 Bash、Edit、Write;job-scraper 技能给的是 .agents/skills/*/cli/src/cli.ts 通配。.claude/settings.json 当前有 18 条 allow,没有 ask 或 deny 规则。
10 月 18 日开出的 PR #642 正在收窄这些技能授权、补 ask/deny 和 GET-only 抓取脚本;PR #654 继续加职位内容完整性检查和最小权限的 fetch/score/review agent。两项在核验时都还没有合并。它们说明维护者已经看见问题,也说明现在装下的是收口前的版本。
门槛不只在 Star 数
README 写得很直白:Claude Code 没有免费档,需要 Pro、Max、Team 订阅或 API 额度;还要 Python 3.10+、Bun,以及带 lualatex 和 xelatex 的 LaTeX 发行版。对不写代码的人,这不是装一个 App。
项目自带六个岗位搜索 CLI:四个是丹麦本地门户,另外两个是 LinkedIn 公开岗位和 freehire.me。LinkedIn 那条明确标了仅供个人使用,自动化访问违反它的服务条款;freehire 主要覆盖技术岗位。中文市场的岗位门户要自己用 /add-portal 生成,或者把 JD 直接粘贴进去。中文求职者能用,但开箱即用的本地化程度有限。
它适合已经在用 Claude Code、愿意维护 LaTeX、并且确实要针对不同岗位反复改材料的人。私有仓库、gh repo set-default、检查技能授权、少让 Agent 自动抓取不熟悉的网站,都属于这套工作流的运行条件,应该和安装步骤一起处理。
如果只是偶尔投几份简历,普通文档工具更省事。Star 数证明的是很多技术人对“把求职过程工程化”感兴趣,不等于这套环境适合每一个求职者。
中文供给已经不少。CSDN 10 月 17 日的深度报告拆了三层架构和 PDF/ATS 验证,也提到 LaTeX、Bun、Claude Code 的技术门槛;Text Matrix 8 月 6 日的文章把流程和局限讲得更清楚,10 月 10 日更新;AI工具集则给出了 fork 命令和功能清单。三篇都没有展开公开 fork 与个人数据的关系。现有材料多在回答“它能做什么”,很少回答“我的简历会去哪”。
5.29 万星说明它确实击中了一个需求:求职材料需要被认真对待。材料里有姓名、经历和薪资预期,决定是否使用时,公开仓库与权限边界应当和功能清单放在同一张表上。