ARTICLE · 1220270
Mac 本地 AI 真快了 6 倍?我在 M4 Mac mini 上实测 PyTorch 2.15
Mac 本地 AI 真快了 6 倍?我在 M4 Mac mini 上实测 PyTorch 2.15
一张关于 PyTorch 2.15 的截图最近很容易让 Mac 用户兴奋:Qwen 大模型推理快了 6 倍,Wan 视频解码内存从 270GB 降到 8GB,FP8 又能把模型体积砍半。把这些数字放在一起,像是在宣布一件事:普通 Apple Silicon 一夜之间成了本地 AI 工作站。
数据本身大多来自 Hugging Face 的官方测试,问题出在它们被抽离了测试条件。
我在一台 M4、24GB 统一内存的 Mac mini 上安装了两个完全隔离的环境,用 PyTorch 2.14.1 稳定版和 2.15.0 候选版做 A/B。结果很有代表性:同一块 GPU、同一套硬件,BF16 大矩阵线性层只快了约 1.11 倍,长词表 softmax 却快了约 4.96 倍;一个小型 padding 测试约快 1.15 倍。与此同时,2.14.1 无法在 MPS 上创建 FP8 tensor,2.15 已经可以执行 FP8 scaled matrix multiplication。
所以答案不是“真”或“假”。PyTorch 2.15 确实是 Mac 本地 AI 很重要的一次底层升级,但它没有给 M4 增加新的晶体管,也没有消除统一内存的物理上限。真正发生的事情,是 PyTorch 的 MPS 后端开始集中偿还多年积累的软件债。
图:Hugging Face PyTorch 团队发布的 MPS in PyTorch 2.15。
第一件要说清的事:2.15 还不是稳定版
截至 2026 年 10 月 20 日,PyTorch GitHub 的最新稳定版本仍是 2.14.1。2.15 处于 release candidate 阶段,官方安装命令走的是 test channel;2.15 发布跟踪页[1]显示,项目刚进入基于 RC build 的扩展稳定性与性能测试阶段,计划正式发布日期是 10 月 28 日。
这不是抬杠。MPS 的历史上既有性能问题,也出现过 silent correctness bug。2.14.1 的正式 release notes 就专门列出 SVD、least-squares 等 MPS 正确性修复。一个算子跑得更快,如果结果悄悄错了,代价远高于慢几秒。
因此,2.15 现在适合在独立环境中验证,不适合不做兼容测试就覆盖生产环境。我这次也没有动现有 Python 或 ComfyUI 环境,而是分别创建 2.14.1 与 2.15.0 的 Python 3.11 虚拟环境。全部测试完成后,可以直接删除实验环境,不影响日常工作流。
为什么同一块 Mac,软件更新能带来 5 倍甚至 6 倍?
Apple 为 PyTorch 提供的 MPS backend,会把计算图和 primitives 映射到 MPSGraph、Metal Performance Shaders 以及定制 Metal kernel。早期阶段,优先目标是让更多 PyTorch 算子“能在 GPU 上跑”;当兼容面逐渐铺开后,瓶颈开始暴露在更细的地方:图编译开销、CPU 与 GPU 同步、通用算子拼接、临时内存分配,以及某些真实模型反复调用的小算子。
PyTorch 2.15 的关键变化,是越来越多热点路径不再完全依赖通用 MPSGraph,而改用针对 Apple GPU 写的 Metal kernel。对某些工作负载,这只是百分之十几的优化;对另一些路径,它消除的是整段不必要的同步或内存膨胀,结果自然可能相差数倍。
这也解释了为什么不能用一个“平均加速倍数”描述 2.15。它更像一次道路整修:有的路原来已经很顺,只是重新铺了路面;有的路曾经每经过一个收费站都要停车,现在收费站被拆掉;还有一条路原来绕了几百公里,现在终于接上直线。
“Qwen 快 6 倍”是真的,但不是普遍规律
Hugging Face 官方文章[2]给出的最抢眼结果,是 Qwen3.6-35B-A3B 在 M3 Ultra 上从 9.4 tokens/s 提升到 61.3 tokens/s;LFM2.5-8B-A1B 则从 23.6 提升到 123.6 tokens/s。
这两个模型有一个共同点:它们都是 MoE。
Qwen3.6-35B-A3B 的官方 model card 写得很清楚:模型共有 35B 参数,但每个 token 只激活约 3B。MoE 每一步只调用部分专家,理论上可以少做大量计算;实际速度却取决于路由、专家分组矩阵乘法、kernel launch 与内存访问是否高效。旧的 MPS 路径没有把这种结构的潜力充分释放出来,2.15 的原生 grouped matrix multiplication 和 torch.compile 正好命中这个瓶颈。
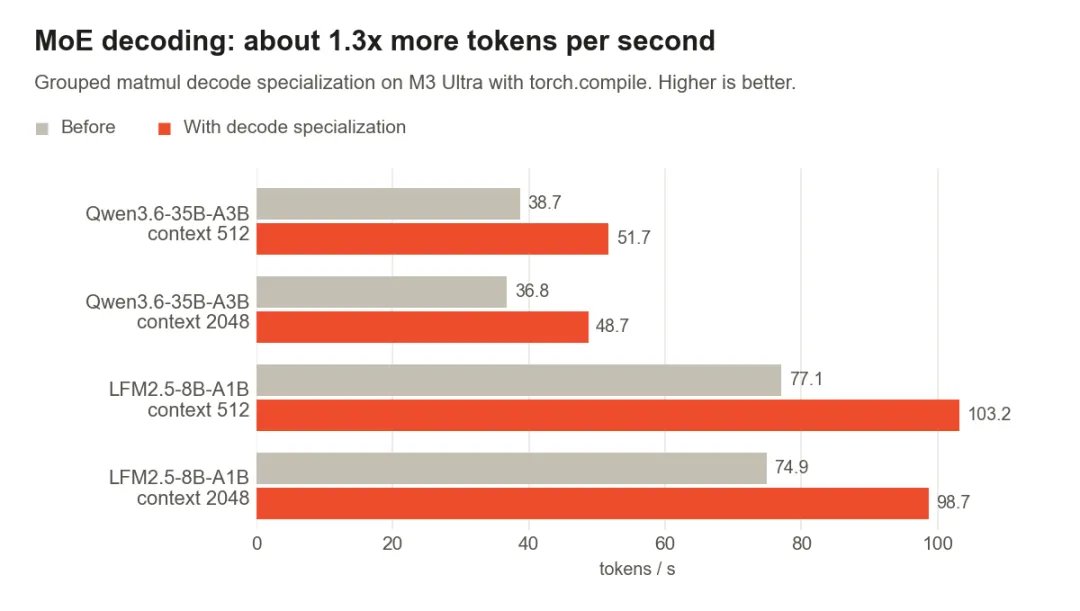
图:Hugging Face 官方 MoE decode throughput 测试。大幅提升集中在特定 MoE 解码路径。
如果把测试换成普通 dense 模型,结果会温和很多。官方还测了 96 组 BF16 单行 linear shape,几何平均提升约为 1.23 倍,而许多大层接近 1 倍。这个数字与我的 M4 测试很接近:4096×4096 BF16 linear 从 454.8 微秒降到 409.8 微秒,只快 1.11 倍。
这并不矛盾。6 倍描述的是一辆原来被堵在特定路口的车;1.11 倍描述的是一段原本就没有严重拥堵的高速公路。截图把前者写成所有道路的限速提升,才造成了误解。
我在 M4 Mac mini 上测到了什么
测试设备是 10 核 CPU 的 M4 Mac mini,24GB 统一内存,macOS 26.6.2。两个版本各自顺序运行两轮,报告两次 run median 的中位数。之所以强调“顺序”,是因为让两个环境同时占用同一块 GPU 会污染结果。
F.linear,权重 4096×4096 | |||
[1,128256] | |||
[1,16,128,128] | |||
torch.mps.Stream | |||
scaled_mm |
最值得注意的是 softmax。长词表大模型在每个 token 的采样阶段都要把 logits 转成概率分布。官方对 [1,128256] 的测试从约 57 微秒降到 7 微秒,接近 8 倍;我在普通 M4 上从 58.6 微秒降到 11.8 微秒,也有接近 5 倍。
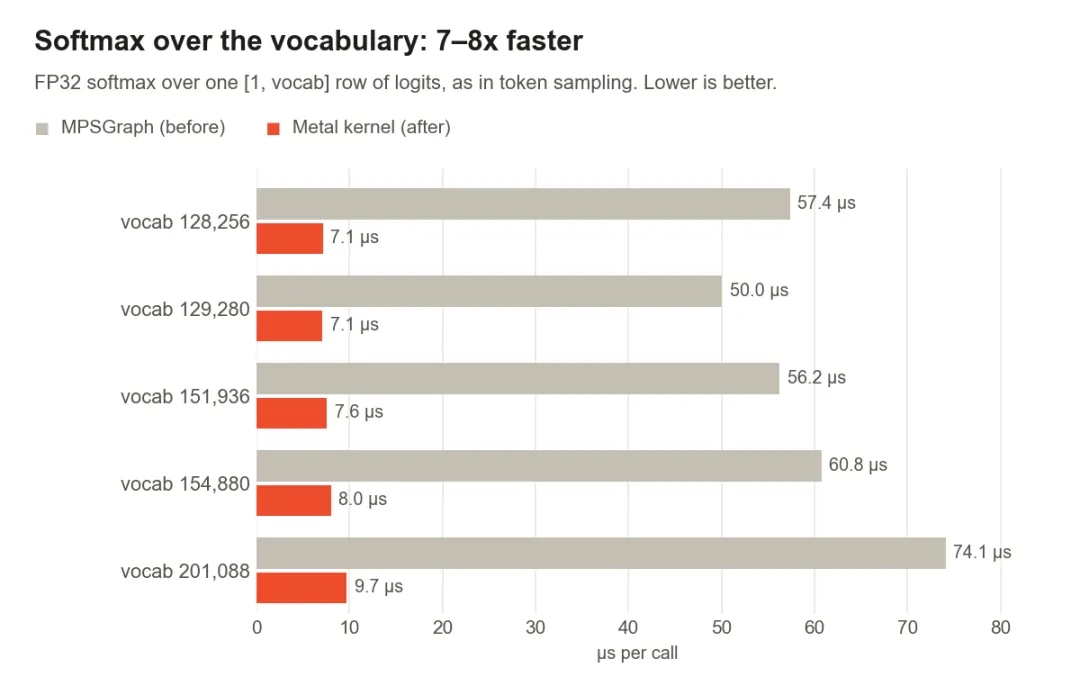
图:Hugging Face 官方测试显示,长词表 softmax 与 multinomial sampling 是 2.15 的明确受益路径。
这些数据只能回答两个问题:哪些底层路径确实变快了,哪些新能力从“不能运行”变成“能够运行”。它们不是完整 Qwen 或 Wan 模型的端到端 benchmark,更不能拿来预测每个 ComfyUI workflow。严谨的结论应该是:2.15 的收益高度取决于你的工作负载能否命中新 kernel、编译路径和内存修复。
270GB 降到 8GB,修复的到底是什么?
截图里最震撼的数字来自 Wan2.2 TI2V-5B 的 tiled VAE decode。官方记录显示,PyTorch 2.14 的 MPS driver memory 峰值约为 270.135 GiB,2.15 降到 8.108 GiB;allocator-reserved memory 前后都在约 8.07 GiB。
后一组数字非常关键。它说明模型真正由 PyTorch allocator 保留的内存并没有从 270GB 变成 8GB。失控的是 driver memory:旧 constant padding 路径在一次 VAE 解码中被调用 8,764 次,产生大量临时分配或驱动层资源无法及时释放。2.15 用定制 Metal kernel 替换该路径后,driver memory 不再一路膨胀。
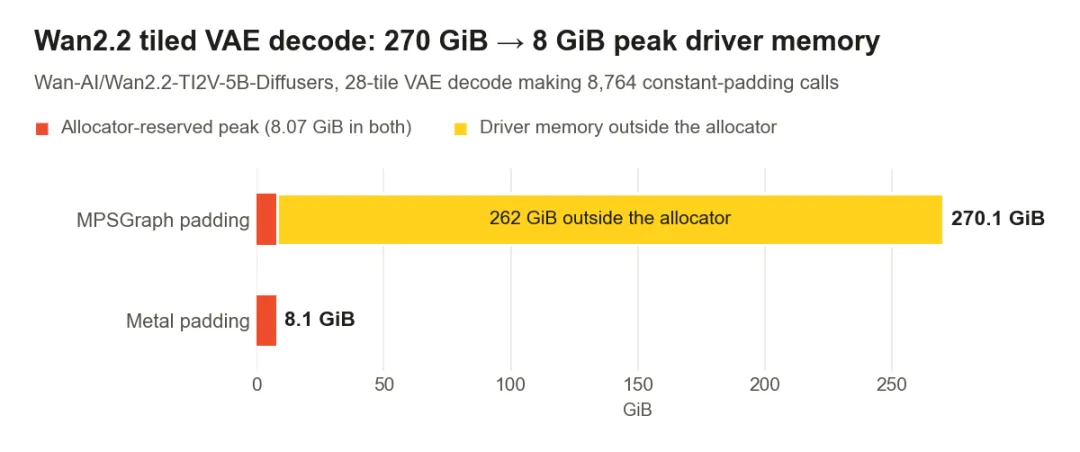
图:官方测试中的 270.135 GiB 与 8.108 GiB 指 MPS driver memory 峰值,不是完整视频模型所需的统一内存。
这是一项很有价值的修复。过去一些 Mac 视频工作流失败,不一定是模型理论上装不进统一内存,而可能是后处理阶段被驱动层的临时内存拖垮。2.15 让 tiled VAE decode 更接近它本来应有的内存规模。
但它绝不等于“8GB Mac 可以完整运行 Wan2.2”。VAE 只是视频生成链路的一部分,主 denoising model、text encoder、latent、KV 或其他中间张量仍需内存;测试指标还是 driver memory,而不是 Activity Monitor 中整台机器的总占用。把一个阶段的病态峰值修复写成完整模型显存需求,是截图中第二个严重误导。
FP8 能把模型减半,但不能把 35B 塞进 24GB
PyTorch 2.15 为 MPS 加入 float8_e4m3fn tensor 和 scaled matrix multiplication。按每个权重的存储看,FP8 确实只有 BF16 的一半。我的测试也验证了功能边界:2.14.1 在 MPS 上创建 FP8 tensor 会报 Undefined type Float8_e4m3fn,2.15 则能创建 tensor 并完成 scaled_mm。
这里仍有两个容易被忽略的问题。
第一,PyTorch 支持 FP8,不代表你硬盘上的 BF16 模型升级后自动减半。权重必须以 FP8 形式保存或量化,加载代码、scale metadata、Transformers/Diffusers 路径和后续算子都要支持。任何一环回退到 BF16,都可能吃掉预期收益。
第二,MoE 的“激活参数少”解决的是每个 token 做多少计算,不等于只需加载这些参数。Qwen3.6-35B-A3B 每步激活约 3B,但模型总权重仍是 35B。即使粗略按每个权重 1 byte 计算,FP8 权重的十进制下限也约 35GB,还没算 scale、embedding、运行时 buffer、KV cache 和 macOS 自身占用。
因此,这个模型不会因为 2.15 就原样装进 24GB Mac mini。若使用 4-bit 量化或 CPU/SSD offload,体积可能进入可运行区间,但那已经是另一套精度、吞吐和内存权衡,也不会复现 M3 Ultra 上的 61.3 tokens/s。
对 24GB M4 用户,真正有价值的是什么
如果你用 Mac 做本地 AI,2.15 的价值可以按工作负载拆成四类。
第一类是视频与图像后处理。 Wan2.2 tiled VAE 的 driver memory 修复,可能减少 ComfyUI、Diffusers 在解码阶段莫名爆内存或把系统拖入 swap 的情况。Qwen-Image-2.1 的 padding 修复还把官方 VAE encode-decode PSNR 从 10.06 dB 提高到 29.95 dB。对内容工作流来说,“结果不再悄悄损坏”比 benchmark 数字更重要。
第二类是可以放入内存的 MoE。 LFM2.5-8B-A1B 这类总参数更小的模型,更可能同时享受到 grouped matmul 的计算收益和可接受的权重体积。35B MoE 的计算可能很省,驻留体积却仍然超出 24GB。
第三类是长词表采样与编译路径。 softmax、top-k、multinomial sampling 等小算子每次只省几十微秒,但生成数千 token 后会累积。公开 MPS streams 也让应用有机会把数据搬运与计算更好地重叠。
第四类是生态兼容。 MLX 仍是 Apple Silicon 上非常原生的推理生态,尤其适合已经量化好的本地模型。PyTorch 的优势是 Hugging Face、Diffusers、训练代码和跨平台项目的覆盖面更广。2.15 并没有宣布 MLX 失去意义,而是在减少“同一个 PyTorch 项目到了 Mac 就缺算子、错结果或异常慢”的摩擦。
现在要不要升级?
我的建议很简单。
如果这台 Mac 承担生产任务,现在不要覆盖稳定环境。新建 Python 3.11 虚拟环境,从官方 test channel 安装 2.15 RC,只复制一个真实 workflow 进去验证。优先测试你自己的瓶颈,而不是照抄 M3 Ultra 上的数字。
对我的工作流,正式版发布后最值得做的两组 A/B 是:一组 ComfyUI/Wan 的 VAE decode,观察峰值内存、swap、耗时与输出一致性;一组能装入 24GB 的小型 MoE,测 prefill、decode、首 token 延迟和长文本稳定性。Qwen-Image 编辑也值得复测,因为这次修复涉及正确性,而不仅是速度。
升级后还要保留可回滚环境,并用固定 seed、固定输入、相同输出参数验证结果。速度变快但输出偏色、错位或数值漂移,不能算升级成功。
这次更新真正改变了什么
PyTorch 2.15 没有让普通 Mac 获得 M3 Ultra 的带宽,也没有把 35GB 权重压进 24GB 统一内存。它改变的是软件栈对 Apple GPU 的使用效率。
过去,Mac 本地 AI 的讨论常被简化成芯片对比:M4 有多少 GPU core、统一内存多大、带宽多少。2.15 提醒我们,硬件规格只给出上限,软件后端决定你离上限还有多远。当一个 softmax 从 58.6 微秒降到 11.8 微秒,当 8,764 次 padding 不再制造 270GiB 的 driver memory 峰值,当 FP8 tensor 从报错变成可执行,这些都不是营销意义上的“新芯片”,却会直接改变模型能否稳定运行。
所以,截图中的数字值得重视,但正确的标题不该是“Mac 从此快 6 倍”。更准确的说法是:PyTorch 终于开始把 Apple Silicon 当成一等 AI 平台来优化。某些长期被软件卡住的路径会突然释放,另一些原本就接近硬件上限的路径只会小幅前进。
RAM 的物理限制仍在,模型总参数仍要驻留,RC 仍可能出 bug。真正令人期待的,是 Mac 本地 AI 的瓶颈第一次更清楚地从“平台不支持”转向“这台机器究竟有多少资源”。这不是魔法,却比一次被夸大的 6 倍加速更重要。
参考资料
Hugging Face:MPS in PyTorch 2.15[3] PyTorch 2.15.0 General Availability Tracker[4] PyTorch Releases[5] Apple Developer:Accelerated PyTorch training on Mac[6] Qwen3.6-35B-A3B Model Card[7] LFM2.5-8B-A1B Model Card[8] Wan2.2 TI2V-5B Diffusers Model Card[9]
引用链接
[1]2.15 发布跟踪页: https://github.com/pytorch/pytorch/issues/199813
[2]Hugging Face 官方文章: https://huggingface.co/blog/mps-pytorch-2-15
[3]Hugging Face:MPS in PyTorch 2.15: https://huggingface.co/blog/mps-pytorch-2-15
[4]PyTorch 2.15.0 General Availability Tracker: https://github.com/pytorch/pytorch/issues/199813
[5]PyTorch Releases: https://github.com/pytorch/pytorch/releases
[6]Apple Developer:Accelerated PyTorch training on Mac: https://developer.apple.com/metal/pytorch/
[7]Qwen3.6-35B-A3B Model Card: https://huggingface.co/Qwen/Qwen3.6-35B-A3B
[8]LFM2.5-8B-A1B Model Card: https://huggingface.co/LiquidAI/LFM2.5-8B-A1B
[9]Wan2.2 TI2V-5B Diffusers Model Card: https://huggingface.co/Wan-AI/Wan2.2-TI2V-5B-Diffusers