ARTICLE · 1221972
DenseNet 源码精读:残差相加换成特征拼接,0.8M 参数怎么追平 10M 的千层 ResNet
1001 层的 pre-activation ResNet 带着 10.2M 参数,在 CIFAR-10 增强设置下测得 4.62% 的误差;同一张表里,100 层的 DenseNet-BC 只带 0.8M 参数,4.51%。参数省下九成,误差还低了一线。这就是 CVPR 2017 最佳论文 DenseNet——那一届本奖两篇并列,另一篇是 SimGAN。共同一作 Zhuang Liu 的官方 Torch 仓库至今完整可读,我把论文和代码对着读了一遍。
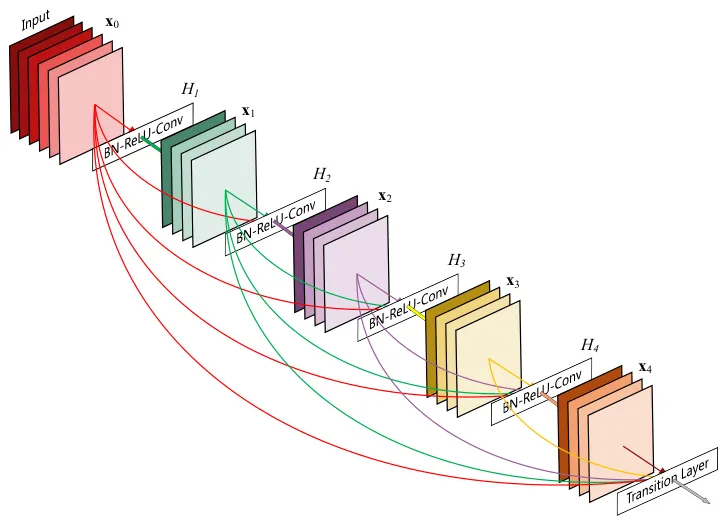
01 先看结论
DenseNet 动的地方只有一处:层和层怎么连。ResNet 把恒等支路和变换支路的结果相加;DenseNet 改成把前面所有层的特征图在通道维上拼接——第 ℓ 层的输入,是从第 0 层到第 ℓ−1 层全部特征的拼接张量,自己的输出再喂给后面所有层。L 层网络因此有 L(L+1)/2 条直连,而不是 L 条。
这个改法换来的两件事都有表撑着。参数效率:同精度只需要 ResNet 约三分之一的参数,这是论文图 4 中图在 CIFAR 上量出来的。抗过拟合:CIFAR 不做数据增强的设置下,误差相对此前最好的 FractalNet 降了约三成,C10 从 7.33 到 5.19,C100 从 28.20 到 19.64,见论文表 2。
停在什么条件:ImageNet 的训练配方完全沿用为 ResNet 调好的超参,作者在第 4.4 节自己说明,更充分的超参搜索可能还能再涨;仓库里 Torch 预训练模型已标停维护,README 建议改用 torchvision 的 DenseNet 权重。只看一个文件的话,看 models/DenseConnectLayer.lua,dense 连接的实现只有十来行。
02 问题背景
2016 年前后,深层网络的训练问题刚被 ResNet 解决:恒等支路让梯度直通,百层网络可训。但两个麻烦留在原地。一是冗余,stochastic depth 那篇工作训练时随机丢掉 ResNet 的整层,网络照常收敛,说明很多层贡献很小。二是相加这种融合本身,论文第 3 节的说法是:恒等函数和变换输出靠求和合并,这可能阻碍网络内部的信息流动。
参数账同样别扭。论文把传统前馈网络比作逐层改写状态的状态机:每层读完上层状态、写回下层,想保留的信息只能一直带着走。ResNet 用加法把「保留」显式化了,可每层照样要配一整套自己的权重,哪怕这层只产出很少的新特征。
DenseNet 的赌注是:如果每层都能直接看到前面所有层的特征,相似的东西就不必反复重学。每层只往全网共享的特征池里添少量新图,其余原样保留,谁都能读。
03 方法拆解
主线一句话:块内全连接,块间走过渡。尺寸不同的特征没法拼接,所以网络按分辨率切成若干 dense block,块内所有层同尺寸、任意两层直连;块与块之间用 transition 层换尺寸,即 BN、1×1 卷积、2×2 平均池化。CIFAR 上三个块,特征图从 32×32 走到 16×16 再到 8×8。
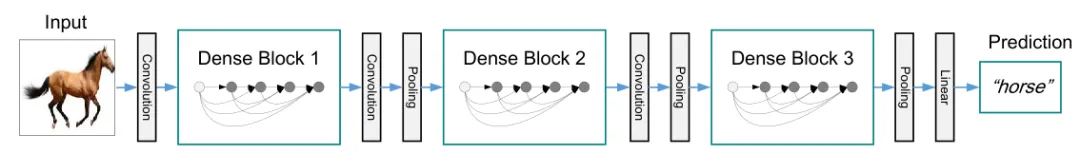
必要公式是论文的式 (2):x_ℓ = H_ℓ([x_0, x_1, …, x_ℓ−1])。三个量分开说:x_ℓ 是当前层的输出;H_ℓ 是复合函数 BN-ReLU-3×3 卷积;方括号表示把前面所有层的特征图沿通道维拼成一个张量。
第一个设计是 growth rate。每层只产出 k 张新特征图,第 ℓ 层的输入通道数是 k_0 + k×(ℓ−1),k=12 就够用。窄层能成立,前提正是这种全量访问——特征图是全网的共享状态,每层往里添 k 张,任何位置都能读,不必每层重学底层特征。
第二个设计是 DenseNet-BC 的两处压缩。块内在 3×3 卷积前加一道 1×1 卷积,输出 4k 通道;块间 transition 把 m 张特征压到 ⌊θm⌋,θ 取 0.5。这两刀砍下去,0.8M 参数的模型才有 4.51 的成绩。ImageNet 用的 DenseNet-121 四个块各 6、12、24、16 层,growth rate 32,见论文表 1。
04 源码对照
调用链:main.lua 解析参数、起 epoch 循环;models/init.lua 的 setup 按选项组装模型、挂显存优化、多卡时包 DataParallelTable;models/densenet.lua 按数据集搭骨架;块内每个层由 models/DenseConnectLayer.lua 生成;train.lua 管 optim.sgd 与学习率调度;数据侧 dataloader.lua 多线程调 datasets/cifar10.lua。
第一处对读:式 (2) 的拼接连接,落在 DenseConnectLayer.lua 的标准层函数里,论文位置是第 3 节 dense connectivity 一段。
return nn.Sequential():add(nn.Concat(2):add(nn.Identity()):add(net))
nn.Concat(2) 沿通道维拼接两路:Identity 是前面所有层输出的累积张量,标准实现里它本身就是逐层递归拼出来的;net 是这一层新产出的 k 张特征图。两路一拼就是下一层的输入,和式 (2) 逐字对得上。
net 内部带瓶颈时是 BN-ReLU-Conv1×1(输出 4k)-BN-ReLU-Conv3×3(输出 k),正是论文第 3 节瓶颈层一段写的 H_ℓ 结构,1×1 卷积出 4k 通道这一点一字不差。隐患也在这几行里:递归拼接让第一层的输出在显存里被复制 N 份,models/README 算过这笔账,块深 N 时显存按 1+2+…+N 平方级增长,这是后面 optMemory 系列要填的坑。
第二处对读:深度折算与通道账本,落在 densenet.lua 的开头和 addDenseBlock 函数里。
local N = (opt.depth - 4)/3if bottleneck then N = N/2 end
for i = 1, N doaddLayer(model, nChannels, opt)nChannels = nChannels + opt.growthRateend
(L−4)/3 拆出每块的层数:三个块之外还有初始卷积、两个带卷积的 transition 和最后的全连接层,共 4 层不进块;带瓶颈时每个层含两个卷积,按论文的深度计数法折半。循环里每加一层,通道数加一个 growthRate,就是论文的 k_0 + k×(ℓ−1);transition 处的 math.floor(nChannels*reduction) 就是 ⌊θm⌋;最后一个 transition 不做卷积,直接 8×8 全局平均池化。ImageNet 分支把 121/169/201/161 的块配置写死在 stages 表里,DenseNet-121 的 {6,12,24,16} 与论文表 1 一致。
默认行为与实验选择分开读:optMemory 默认 2 不是 0;dropRate 默认 0,论文里 C10/C100/SVHN 不增强组的数字是 0.2 跑出来的;lrShape 默认 multistep,cosine 是后来技术报告加进去的模式。
05 实验配置
CIFAR 与 SVHN:batch 64,CIFAR 训 300 轮、SVHN 40 轮;学习率 0.1 起,在总轮数的 50% 和 75% 处各除以 10。这条在 train.lua 里有逐字对应:epoch >= 0.75*nEpochs and 2 or epoch >= 0.5*nEpochs and 1 or 0。
ImageNet:90 轮、batch 256,论文写第 30 和 60 轮各降十倍;代码的写法是 floor((epoch-1)/30),实际在第 31、61 轮生效,一处取整上差一轮的细节。
优化与初始化:SGD,Nesterov 动量 0.9、无 dampening,权重衰减 1e-4,train.lua 的 optimState 里 nesterov=true、dampening=0.0 原样可查;卷积权重按 normal(0, sqrt(2/n)) 初始化,即论文所说的 He 初始化,在 densenet.lua 的 ConvInit 里。
数据:CIFAR 5 万张训练、1 万张测试,中途留 5 千做验证,最终一轮用全部 5 万张训练;增强是 4 像素填充后随机裁 32、加水平翻转,对应 datasets/cifar10.lua 的 RandomCrop(32,4) 与 HorizontalFlip(0.5),归一化用训练集统计量 {125.3, 123.0, 113.9} 和 {63.0, 62.1, 66.7}。ImageNet 120 万张训练图,测试单裁或 10 裁 224×224。
公平性的做法单说一句:ImageNet 对照直接用 fb.resnet.torch 的公开实现,只把 ResNet 模型换成 DenseNet-BC,其余设置一字不动,论文 4.4 节明写。训练硬件论文没写;README 提到 190 层的 BC 模型在 optMemory 4 下单张 TitanX(12G)用 8.3G 显存可训。最影响可比性的两条:超参是照 ResNet 调的;不增强组的模型带 dropout 0.2。
06 结果怎么看
CIFAR 与 SVHN(论文表 2):容量趋势清晰,C10+ 误差随参数从 1.0M、7.0M 涨到 27.2M 依次是 5.24、4.10、3.74。最强一行是 DenseNet-BC L=190 k=40:C10+ 3.46、C100+ 17.18,低于表内所有对照。参数效率那组:BC-100-12 用 0.8M 拿 C10+ 4.51、C100+ 22.27,1001 层 pre-activation ResNet 用 10.2M 是 4.62、22.71。
无增强设置的差距更大:C10 从 FractalNet(drop-path)的 7.33 降到 BC-250-24 的 5.19,相对降 29%;C100 从 28.20 到 19.64,约三成。SVHN 上 DenseNet-100-24 到 1.59,压过 Wide ResNet 的 1.64;250 层的 BC 反而回到 1.74,论文的解释是任务偏简单、极深模型容易过拟合。全表唯一一处越宽越差:C10 无增强下 k 从 12 加到 24,误差 5.77 变 5.83。
ImageNet(论文表 3,单裁/10 裁):DenseNet-121 top-1 25.02/23.61,169 是 23.80/22.08,201 是 22.58/21.46,264 是 22.15/20.80。图 3 给性价比:20M 参数的 DenseNet-201 与 40M 出头的 ResNet-101 误差相当;算力维度上,计算量约等于 ResNet-50 的 DenseNet 与 ResNet-101 打平。仓库 README 另列 Torch 单裁成绩,121 是 25.0、161(k=48)是 22.2——DenseNet-161 不在论文表 1 和表 3 里,属于后来的补充。
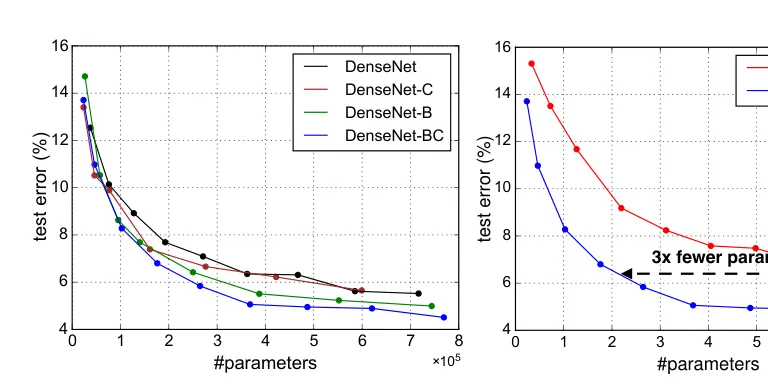
图 4 的三张小图是参数效率的正面证据:BC 变体在同参数量下误差最低;同精度只需 pre-activation ResNet 约三分之一的参数;右图里 0.8M 的 100 层 DenseNet-BC 与 10.2M 的 1001 层 ResNet 测试误差咬合,后者训练损失更低,没兑现成测试优势。图 5 的权重热图补了机制侧证据:块内各层的权重摊在多个输入上,transition 的输出拿到的权重最低,这些特征冗余,正是 BC 用 θ=0.5 压掉的那部分。以上全部是论文口径的数字,我没有跑。
07 论文与代码
对得上的:Concat(2) 对式 (2);瓶颈层 4k 通道;⌊θm⌋ 对 reduction;train.lua 的分段降学习率对论文 4.2 节;He 初始化;ImageNet 的 stages 表对论文表 1。
实现补充的:optMemory 0 到 4 的显存优化管线。论文只在 4.2 节注了一笔,指向后来的显存技术报告;models/README 有实测,DenseNet-BC-100-12 在 TitanX 上标准实现 5453M、0.153 秒每批,optMemory 4 降到 1655M、0.175 秒,省显存,慢一点。
只是配置选择的,别当成缺陷。论文实现细节一段写初始卷积「16(DenseNet-BC 用 2k)」通道,代码统一写死 2*growthRate,plain 版 k=12 时起始通道是 24 不是 16;transition 的行文只说 BN、1×1 卷积加 2×2 池化,代码在 BN 后还接了 ReLU 再进卷积。
同类的还有两处:opts.lua 的 CIFAR 默认轮数 164,是 fb.resnet.torch 给 ResNet-110 留下的值,README 示例与论文都显式传 300;论文表 1 有 DenseNet-264,代码 stages 只内置 121/169/201/161,264 要用 -d1 到 -d4 手动给。
08 复现路线
原版环境是 Torch7 加 cuDNN,安装文档直接指向 fb.resnet.torch 那份说明;今天在新机器上装 Torch7 成本不低,只想要权重的话,README 的建议是直接用 torchvision 的 DenseNet 系列。
最小样例照抄 README:th main.lua -netType densenet -dataset cifar10 -batchSize 64 -nEpochs 300 -depth 100 -growthRate 12。跑起来盯每个 epoch 的 test top1,DenseNet-BC-100-12 在 C10+ 应落在 4.5% 一线,论文数字是 4.51。ImageNet 版在 README 里的命令多了 -depth 121 -growthRate 32 -nGPU 4 -optMemory 3。
容易看错的三处:opts 默认 nEpochs 是 164 不是 300,忘了传就少训近一半;默认 optMemory=2,想复现论文原始实现要显式给 0;无增强列的数字带 dropout 0.2,拿默认 dropRate=0 去对 C10/C100/SVHN 的无增强列,会对不上。
09 判断
有证据的价值:拼接连接在四个基准上以更少参数拿到同等或更好的精度,三分之一的参数量、无增强设置约三成的相对降幅,都有表 2 和图 4 支撑;特征复用不是口号,图 5 显示块内各层确实在用很早的特征,transition 输出的冗余与 BC 的压缩正好互为印证。工程采纳也实在:torchvision 收录了预训练模型,README 的跟进名单里有实时检测、语义分割、移动端网络一串后续工作。
限制同样清楚:ImageNet 的超参是 ResNet 的,作者自己承认还有调参空间,264 的单裁 22.15 对同深度档位 ResNet 的领先幅度不大;单裁与 10 裁是两套数字,引用时必须分清;dense 连接的显存账单在标准实现里是平方级,靠 optMemory 或后来框架的融合算子才压下来,用现成框架测的显存和速度与论文年代不可直接比。
省参数的幅度还随数据规模收窄:CIFAR 上约三分之一,ImageNet 上 20M 对 40M 出头,大约一半。这个趋势摆在那里,选骨干的时候,这笔账得按自己的任务重新算。