ARTICLE · 1221977
PDF 里的表格和公式怎么交给 AI?MinerU 把文档拆成可用的内容
AI 工具追踪
PDF 里的表格和公式怎么交给 AI?MinerU 把文档拆成可用的内容
把 PDF、扫描件和办公文件变成 Markdown 等结构化内容,方便交给 AI 继续整理。
AI产品与工具更新AI公众号
导语
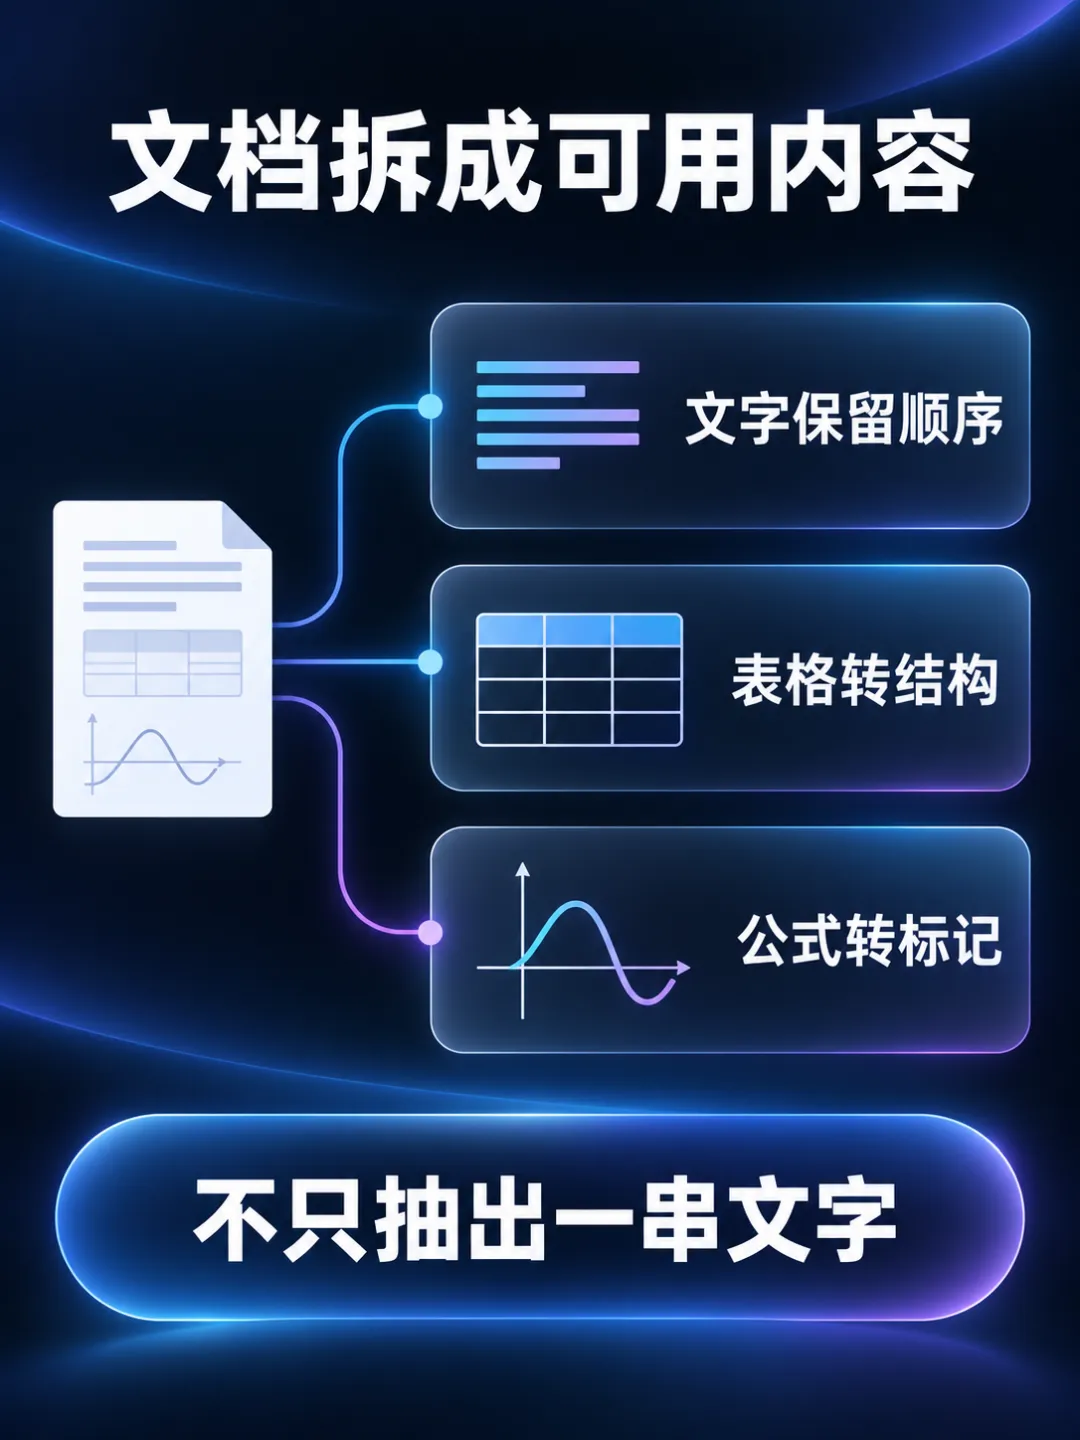
从 PDF 里复制一段文字不难,碰上双栏排版、跨页表格和公式,就没那么省心了。MinerU 做的是文档解析:把页面里的内容拆出来,变成 Markdown 等格式,方便交给 AI 做摘要、检索或继续整理。
不只抽出一串文字
MinerU 支持 PDF、扫描图片,也支持 Word、PPT、Excel 等办公文件。它关注的不只是识别字,还包括页面里的表格、公式、图片和内容顺序。官网列出的输出中,表格可以转成 CSV、HTML 或 Markdown,公式可以转成 LaTeX、MathML。具体入口能导出哪些格式,要看对应功能。
举个用途:一份带表格和公式的报告,先解析成结构化内容,再让 AI 根据材料整理结论;比起把整页截图反复搬来搬去,这种文件更方便搜索和再加工。这是用途说明,本文没有做转换实测,也不据此承诺所有复杂表格都能完整还原。
只想先试一份文件,可以从官网 mineru.net 的在线解析入口开始,不必一上来搭本地环境。在线和本地是不同使用方式:在网页提交文件会把材料交给在线服务,不能当成本机离线处理。
本地转换,注意现在的命令
截至 10 月 21 日读取的官方 README,当前说明对应 MinerU 4.0,要求 Python 3.10 到 3.14。下面是官方快速开始里的 Linux/macOS 安装和转换路径,不是本文运行记录:
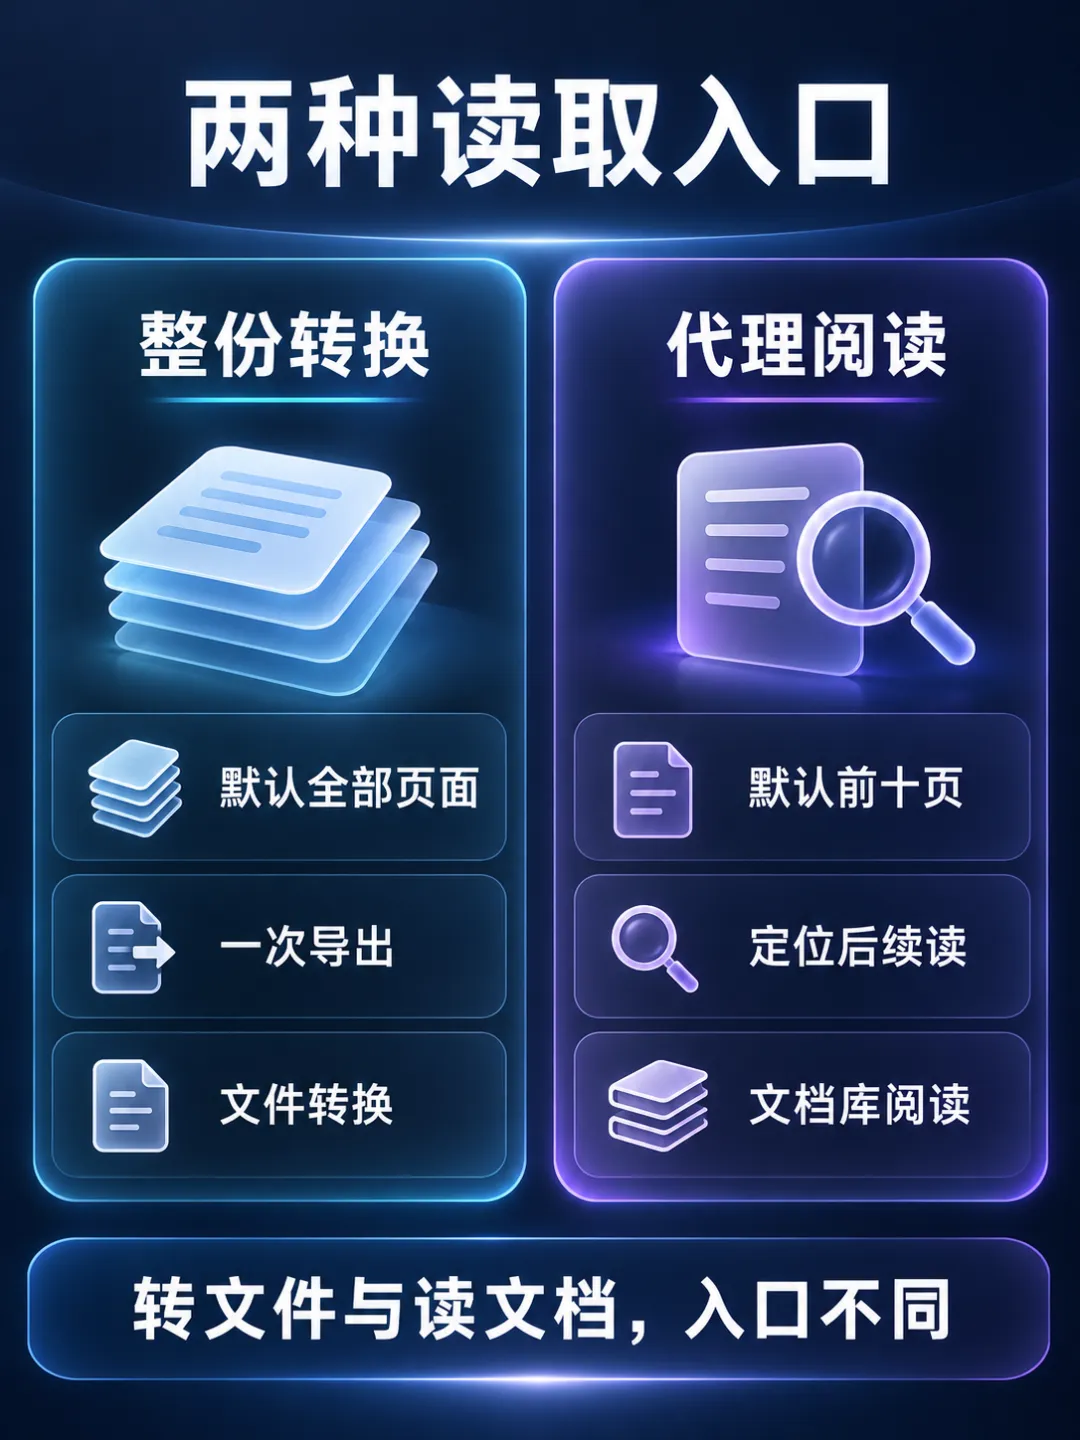
pip install uvuv venv .mineru --python 3.12source .mineru/bin/activateuv pip install -U 'mineru>=4.0,<5'mineru-kit parse document.pdf -o document.md --tier standard把 document.pdf 换成自己的路径,document.md 是输出文件。这里用的是 mineru-kit parse,面向一次性的文件转换,默认处理全部页面。standard 是解析档位,不是文件格式。
PDF 和图片有 Flash、Basic、Standard、Advanced 四档;Office 等文件则采用本地 Flash 原生解析。需要的运行模型和速度也会因档位、设备而异,不能把“能装上”理解成所有机器转换速度都一样。
如果要让代理一页页读
同一个项目还有 mineru parse 这个入口,服务的是本地文档库和代理阅读。按当前 README,它默认先处理 PDF 前 10 页,再用返回的页码或内容块定位继续读;不是换个命令名就等于整份导出。
项目还提供文档搜索,以及能定位到页面、内容块的引用标识。对长文档来说,这让代理可以先找到相关内容,再接着读,而不必每次都把整份文件塞进去。它本身不是一个现成的“上传文件就能聊天”的 RAG 应用。
如果只是想把手上的 PDF 整理成材料,先看在线入口或 mineru-kit 的转换就够了;需要代理反复搜索、按页读取时,再看文档库用法。项目采用带附加条件的 MinerU Open Source License,并非原样 Apache 2.0;需要集成或分发时,应阅读仓库许可证。
来源
• 主来源:https://github.com/opendatalab/MinerU • 补充来源:https://mineru.net/