ARTICLE · 1300971
同事的 3 个 Excel,42 行 Python 交差
周五下午的时候,同事发来 3 个 Excel:说老板要一季度的、二季度的、三季度的,让你合并、去重、按区域汇总,下班前要。
你开始一个一个复制粘贴到第 37 行,发现日期格式又变了。
但是对于这种活,使用Python来自动化做很合适。Python 并没有Excel 高级多少,但是它的好处是第二次、第三次、第三十次,都能用同一条命令重跑。
我拿了3个 Excel、1000 多行数据走了一遍:合并、去重、补缺失、按月汇总、出一张图,三段代码合起来 42 行,跑完全部只花了 0.39 秒,并且后续就可以一直使用这个脚本。
不用是程序员也会,今天就说一件事:在4 周内跑通一个能贴进周报的项目,中间顺手跑 3 个脚本——hello 验环境、字典统计练语法、Excel 合并出图交作业。
先看结果:3 个 Excel 怎么变成一张图
数据是 3 个季度的销售明细:2026Q1.xlsx、2026Q2.xlsx、2026Q3.xlsx,一共 1220 行,7 列。
这份数据是我用脚本生成的,用来演示;换成你的表名,列名对上就能跑通。
这个里面有 20 行重复订单、30 个单价缺失。真实表格数据只会更乱更差,先把这份跑通。
第一步,把 3 个文件读进来,拼成一张表。
输出(节选):
我在本地跑了一遍:3 个文件、1220 行、8 列。先把行数对上再说。
source_file 这一列是我加的,用来追溯每一行来自哪个文件。合并时先按列名对齐,别按列的位置拼。
第二步,去重、转日期、补缺失、按月汇总。
输出:
transform("median") 这行可以看下:它按原行数返回,所以能直接填回原表;换成 agg 会塌成 3 行,填不回去。
我推荐你把这块代码看看,把 transform 和 agg 各跑一次,看看行数怎么变。
为什么用中位数,不用均值?中位数不怕极端值。一个 1200 元的大单能把均值拉高,中位数不动。
第三步,使用 python 出图。
出图这 10 行,可以先按照代码敲。使用中文的那两行别删,删了图里的中文会变方框。
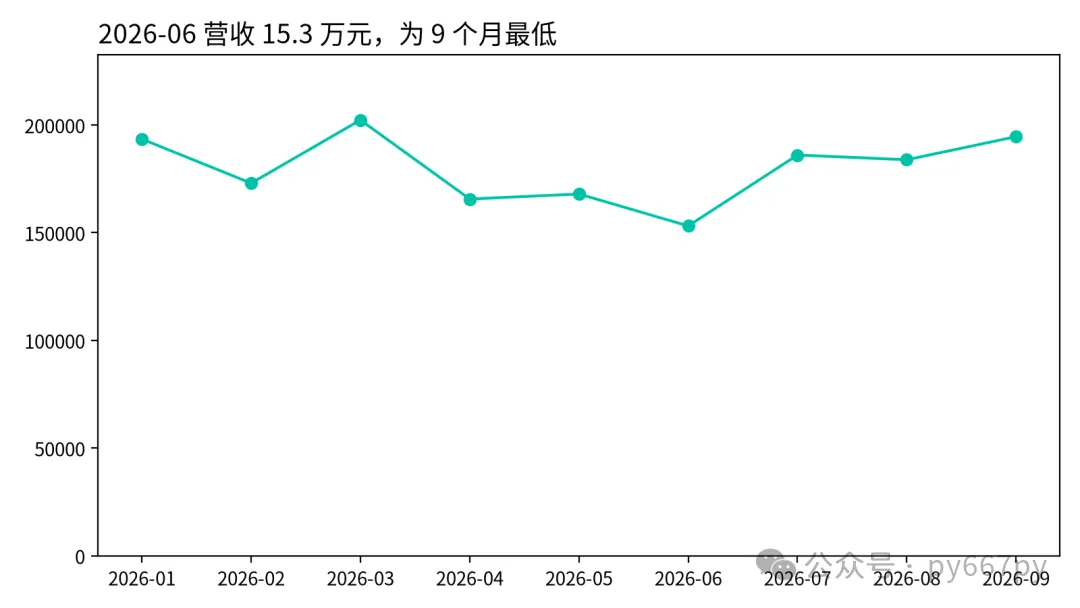
图 1:6 月营收 15.3 万元,是 9 个月里唯一低于 16 万的月份。
这段代码里,groupby 只是表面。真正要懂的是三个代码。
第一,先 df.shape 和 df.isna().sum(),知道数据有多大、哪里缺。
第二,去重和补缺失都要有依据。我用同类目的中位数补单价,不随便填 0。
第三,结果要落盘。monthly.csv 给后续分析,monthly.png 给周报。
我特意试了另一种填法:把缺失的 unit_price 填 0。总额从 1,620,179.46 降到 1,592,534.20,少了 27,645.26 元。
29 个缺失值,足以让结论偏 1.7%。填 0 看起来省事,实际上是在替业务做假设。
如果让我给新手只留一条清洗建议,我会说:先看缺失比例,再决定填什么。
我还试了把 unit_price 读成字符串——加一个 dtype={"unit_price": str} 就行。quantity * unit_price 不报错,结果是 '21.7421.7421.7421.74'。
那一行 quantity 是 4,文本乘 4 就是把 21.74 抄 4 遍。数字乘 4 是加法,文本乘 4 是复读。
先看 df.dtypes,比事后找 bug 省时间。我的建议是:读完数据先看类型,别急着算。
这两次对比让我更确定:清洗的第一步是确认类型和缺失机制,再决定 fillna 用什么。
Python 能干什么:4 个常用的场景
自动化重复工作。 合并 Excel、批量改文件名、按区域拆表、把日报发到邮箱。分工是:pandas 管表格数据,openpyxl 管 Excel 的格式和公式,pathlib 管文件名和路径。
Stack Overflow 2026 的调查里,77.3% 的开发者说自己在写小脚本和自动化。这是常见的用途,不是“训练大模型”。
数据分析。 读 CSV/Excel,处理缺失值和重复值,按维度汇总,画图。pandas 加 matplotlib 是常见的组合。
它的价值在流程:读数据、清洗、汇总、出图,可以存成一条命令。下次数据更新,重跑就行。
抓数据、接 API。 用 requests 拉公开数据,用 json 解析,再存成 CSV。只抓公开数据,遵守 robots,不碰个人隐私,不高频请求。
AI 和大模型。 Python 是调用大模型 API 最顺手的语言。清洗数据、做 RAG、把模型接进业务流程,主流库几乎都先支持 Python。
我学习了 6 年的 Python,经验来看:新手先从自动化开始,最容易看到回报。数据分析排第二,AI 可以放到最后。
Stack Overflow 2026:在 AI 相关开发中,Python 使用率 39.0%,排第一。
还有 Web 后端、桌面工具、游戏脚本,但这些不适合当第一个目标。第一目标越具体,越容易跑通。
边界也要说清楚:手机 App、前端交互、极致性能,先别选 Python。它的强项是把数据、文件和工具串起来。
为什么现在学 Python 仍然划算
你可能会问:AI 都能写代码了,还有必要学 Python 吗?
我的判断是:AI 越会写代码,越需要有人能看懂、能验证、能把结果接进业务。Python 正好是这门“胶水语言”。
TIOBE 2026 年 10 月:Python 19.23%,排第一;第二名 C 是 11.33%,差了 7.9 个百分点。它的评分同比降了 5.23 个百分点,但仍是第一。
PyPI 索引里 889,796 个包(2026-11-02)。你遇到的绝大多数问题,大概率已经有人写过库。
代价也说清楚:纯 Python 循环处理几千万行,比 C/Go 慢一个数量级;环境冲突也常把新手卡住。
我的判断是:它适合“数据量大但计算不复杂”的活,极致性能、实时系统,换语言。
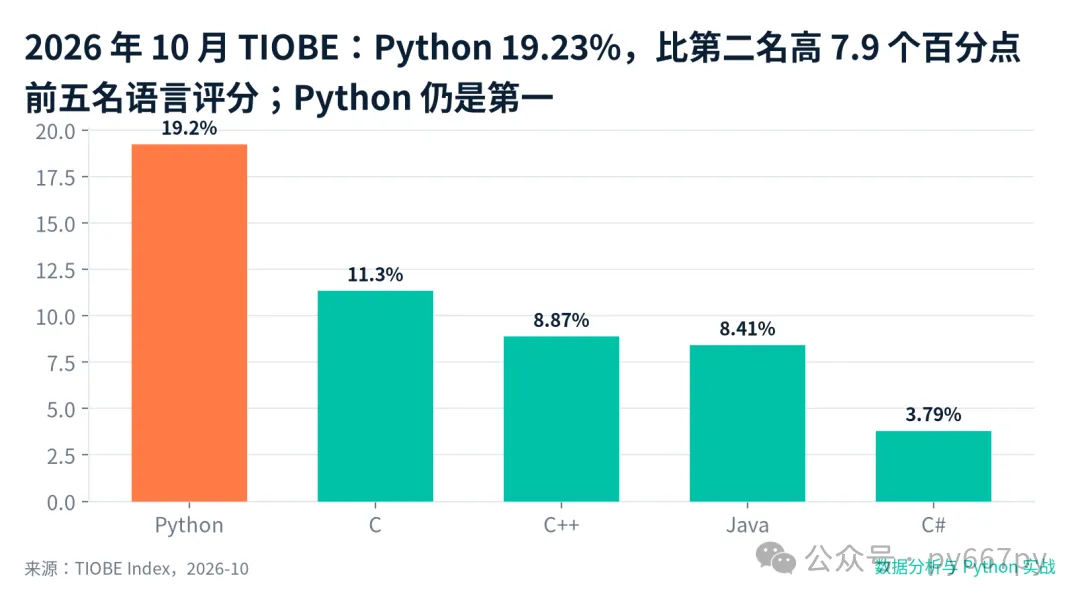
图 2:Python 的领先幅度是第二名的 1.7 倍——但评分同比在降,这是“仍然第一”,不是“继续扩大”。
学 Python 不等于好找工作。招聘看行业、项目、学历和沟通,语言只是其中一项。对想转数据分析的人,缺的往往是项目,不是数学。
怎么开始:装好、跑通、再学 4 个东西
第一步,装环境。两条路,选一条。
省事的路:装 uv,它会把 Python、虚拟环境和依赖一起管了。装好后,uv run --python 3.12 python 会自动下载 Python 3.12 并进入交互环境。我实测用的是 3.11,3.12 一样跑得通。
传统的路:从 python.org 下载安装包,装完在终端里确认 python --version,然后 pip install pandas matplotlib openpyxl。
第二步,跑通第一行。
保存成 hello.py,在终端里运行 python hello.py。看到那行字,环境就通了。
第三步,只学 4 个东西:变量、列表/字典、循环/判断、函数。别急着学类和装饰器。
这段代码跑一遍,你会碰到 Python 最重要的两个习惯:缩进用 4 个空格;报错从最后一行往上读。
我的学习顺序是:先跑通脚本,再学字符串、列表、字典,再学 for/if/函数,最后学库。反过来先学类和继承,最容易在第二周放弃。
第四步,用起来。学语法像背单词,做项目才是开口说话。上面那个 3 个 Excel 的项目,就是你的第一个项目。
新手第一天最容易卡住的 3 个地方
FileNotFoundError:Excel 不在脚本同一个文件夹。要么 cd 到文件夹,要么写绝对路径。
中文乱码:Excel 导出的 CSV 常是 GBK,读的时候加 encoding="gbk";图里的中文要设字体,代码里那两行别删。
终端不一样:Windows 用 PowerShell 或 CMD,Mac 用 Terminal;有的系统是 python3,不是 python。
公司电脑没有管理员权限?先用在线 Jupyter(比如 Colab)跑通,再让 IT 走审批。别在装环境这一步放弃。
4 周路线:每周只学一个东西
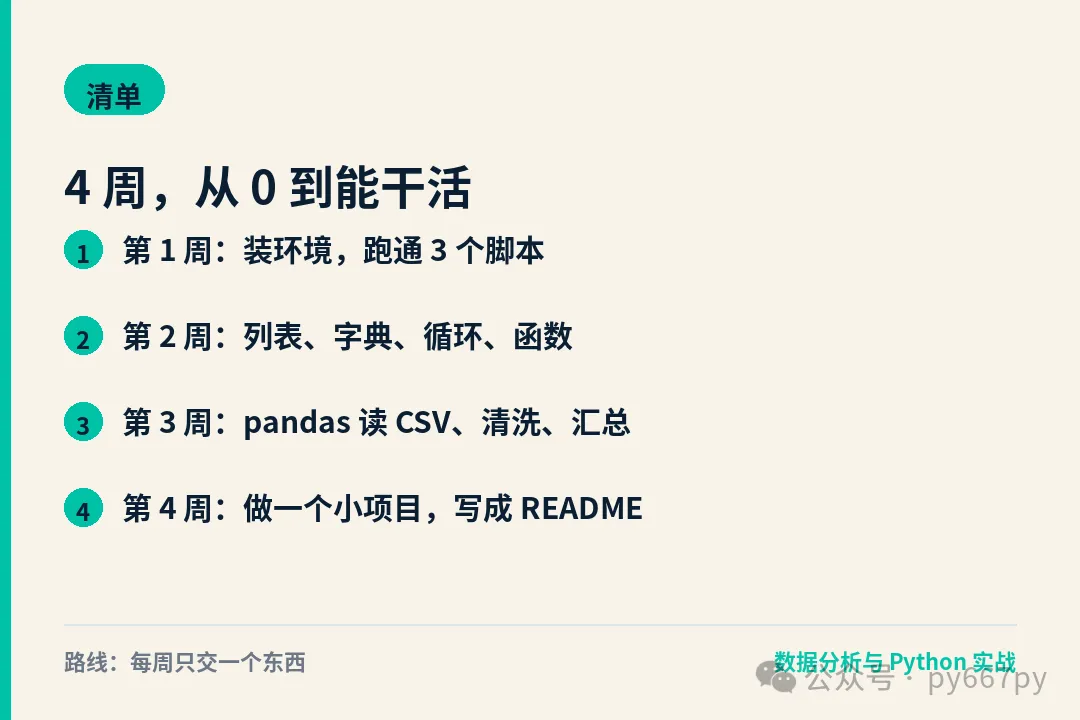
图 3:前三周都是准备,第 4 周那个 README 才是别人看得见的东西。
很多人学 Python 卡住,问题不在智力,在目标太大。把 4 周拆成 4 个交付物,每周只交一个。
第 1 周:装环境,跑通 3 个脚本。批量改文件名、读一个 Excel、把 3 个文件合并。目的不是学会,而是确认“我能跑起来”。
我的建议:第 1 周只做这一件事,别同时买课、装插件、配环境。先把“能跑”确认下来。
第 2 周:补语法。列表、字典、循环、判断、函数,够用就行。写 10 个小练习,比如词频统计、成绩分级、文件名清洗。
第 3 周:pandas 加 matplotlib。找一份脏数据,做一次完整清洗:缺失值、重复值、类型转换、分组汇总、3 张图。
第 4 周:做一个小项目,写成 README。README 只写四件事:解决什么问题、输入是什么、输出是什么、怎么运行。
验收标准:能说出数据有几行几列、哪里缺;能改一个参数重跑;别人拿到能复现。GitHub 可选,脚本放桌面加一页 README 也算交付。
每天 30 分钟怎么排:10 分钟看一个知识点,20 分钟敲代码。4 周大约 14 小时。别连续三天不碰代码,手感会断。
这条路线没法承诺你 4 周就能找工作,但 4 周后你有一个可以演示的东西。面试时,一个能跑的项目比“学过 Python”有说服力。
我用 AI 学 Python 的 3 个用法
第一,让 AI 解释报错,不要让它直接重写。把最后一行报错和最小代码贴进去,问:这个报错什么意思?先别改代码,告诉我从哪一行开始查。
第二,让 AI 出练习题,不要出答案。比如:给我 10 个 pandas 清洗练习,附一份 100 行的脏 CSV,先不要给答案。
第三,让 AI 做代码审查。把代码贴进去,问:指出 3 个可能出错的地方,按严重程度排序,不要重写。
我的判断:AI 最适合当陪练,不适合当代打。Stack Overflow 2026 里,48% 的人只在能验证结果时才信任 AI;学 Python 也一样,先能看懂,再让 AI 加速。
公司的表,先看合规;不确定就脱敏,别把客户名单贴进去。
新手最容易踩的 6 个坑
第一,收藏 300 集课程,不动手。课程的作用是查漏补缺,不是通关。先做项目,遇到问题再回去看。
第二,环境没装好就怀疑自己。Python 的环境问题很常见,不是你笨。用 uv 或干净的虚拟环境,把版本固定下来。
第三,复制代码不运行、不读报错。先读报错,再改代码;看不懂就把报错复制去搜。
第四,一开始就学 Django、爬虫、深度学习。这些都能做,但不适合当第一个项目。先把 Excel/CSV 自动化跑通,建立正反馈。
第五,把 Python 当 Excel 替代品。一次性的小表,Excel 更快;每周都要重复的活,Python 才划算。工具没有高低,场景有。
第六,让 AI 直接生成代码,却不验证。让 AI 写可以,但你要能解释每一行在干什么。
我的判断:新手最该防的,是“收藏了就等于学了”的错觉。收藏夹不会替你跑通第一行代码。
新手最常问的 3 个问题
数学不好能学吗? 做数据分析,四则运算、百分比、平均数、分位数够用;做算法或机器学习,才需要线性代数和统计。先学能用的,遇到公式再补。
英语不好能学吗? 能。常用关键字不到 50 个,报错可以复制去查。把常见报错的中文意思记下来,比背单词有用。报错去哪问?先搜报错关键词加你的操作,再问 AI。
要不要先买课? 先别买。官方教程、一个项目、AI 陪练,够你跑完前 4 周。卡住了再买课,带着问题去听,效率更高。
如果你想要一份最短资源清单:Python 官方教程(跟版本走)、pandas 的 10 minutes to pandas(数据方向)、Automate the Boring Stuff(办公自动化)。三个都免费,够用一阵。
谁适合学,谁不适合
适合:运营、财务、市场、分析、产品,每天和表格打交道的人;想转数据分析,需要补项目和编程的人;想用 AI API 做小工具的人。
不适合:只想做手机 App 或前端交互的人;需要极致性能、底层控制的人;不愿意每天动手 30 分钟、只想收藏课程的人。
想转数据分析,缺的往往是项目,不是数学。你能把一份脏数据洗干净、把结论讲清楚,比多背几个公式有用。
如果你已经在用 Excel 做重复报表,Python 的第一价值是“下次不用从头再来”,不是“分析更深”。
我更愿意你把时间花在项目上,而不是收集教程。一个跑通的脚本,胜过十个收藏。
如果你今天只想做一件事:装好 Python,跑通 print("你好,Python"),然后把每周最烦的那张表读进 pandas。
入门的分水岭不是你看完多少课,是同一件事第二次不用你动手。
参考资料与数据来源:
TIOBE Index,2026-10 Stack Overflow Developer Survey 2026 PyPI Stats,2026-11-02 pandas 3.1.0 release notes uv 官方文档
下一篇:一份脏 Excel 从读入到出图,要洗哪几步。你最常处理的是什么表?