ARTICLE · 1303563
PDF转成表格后,先别急着求和
数字没有少,关系也可能变了。
01
能选中文字,还不等于能还原表格
同事发来一张PDF报价单,只有两行项目。你把里面的文字复制出来,数字一个不少,却发现数量、单价和金额挤成了一列。想算个合计,还得回原页重新认。
容易误会的地方就在这里:拿到了文字,不一定拿到了行和列。先别急着给每个数字套上表头,看看它在原页上到底属于哪一行。
pypdf的官方文档解释,PDF里的表格往往是按位置摆放的文字,抽取程序还需要判断它们之间的关系。文件能显示得整齐,并不保证普通文本抽取也按你看的顺序输出。
02
用一张自建报价单,试一下差别
这次做了一张虚构报价单:桌牌2个,单价120元,金额240元;资料袋10个,单价8.50元,金额85元。两项合计325元。它不对应任何真实供应商,也不是采购建议。
为了把问题看清楚,生成文件时特意按列写入文字,页面上仍然排成正常表格。随后用本地pypdf的普通文本抽取读取,数字顺序先是2、10,再是120.00、8.50,最后才是240.00、85.00、325.00。
这说明本例抽出的数字没有按行排好。如果直接每三个数字凑一行,第一行就会变成2、10、120.00,已经不是原来的那笔项目。
这不是所有PDF都会出错的证据,也不评价任何商业转换软件。布局还原、表格识别或人工核对可以采用不同办法;这个实验只提醒你,抽出文字以后还多了一道确认结构的工序。
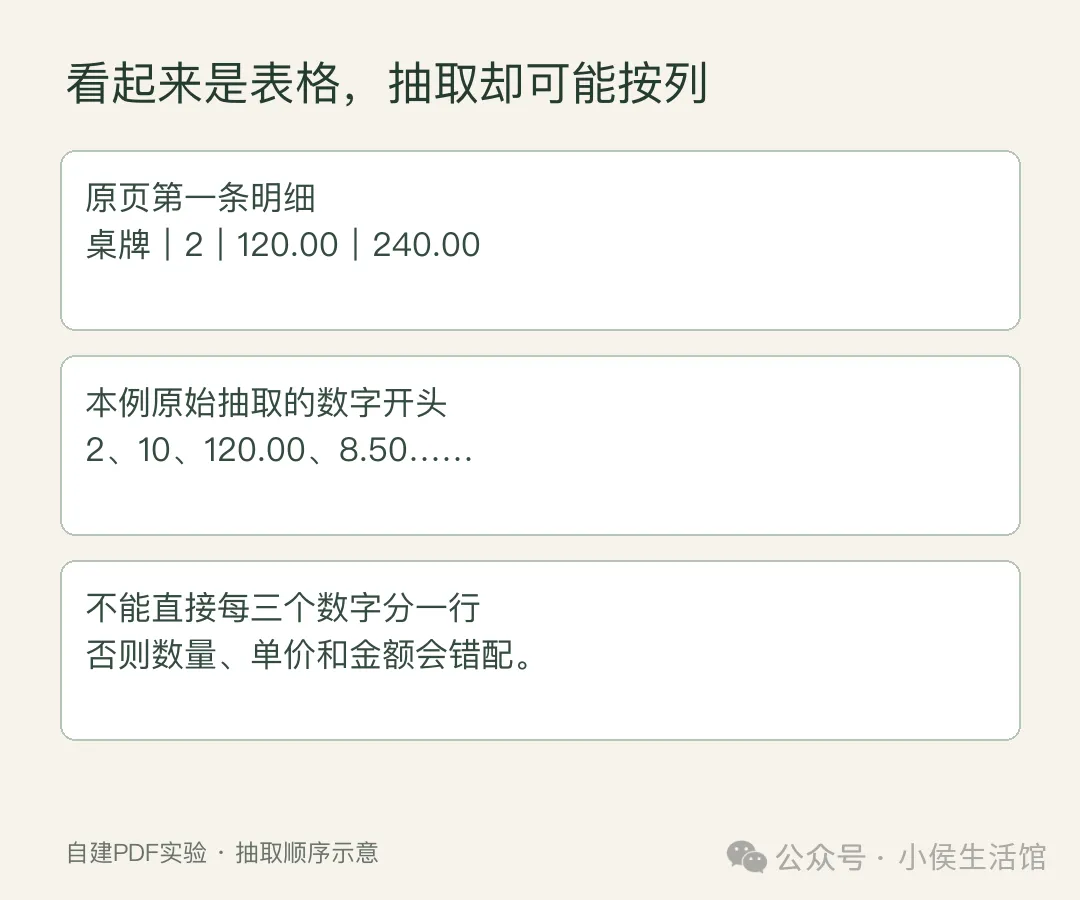
写法示意,不对应实际公司或项目。
03
转完之后,先核对行,再核对数
先把原PDF放在旁边,选一行核对完整关系:项目名、数量、单价、金额是否仍在同一行。不要只看表头有没有回来,也不要因为列宽很整齐就直接求和。
再看合计有没有混进明细。这里两行金额是240和85,325是合计。如果把合计也当成第三条明细,再加一次,得到650,数字看起来仍然很像那么回事。
最后检查单位和备注。单价是元还是万元,数量是件还是箱,有没有“不含税”“另计运费”之类的说明?本例没有这些费用条款,不应自行添加;真实文件里有,就不能在转表时丢掉。
拿不准的格子先标待核对。若手里有原始电子表格,优先向提供方索取。少一次格式转换,通常也少一处需要追溯的中间结果。
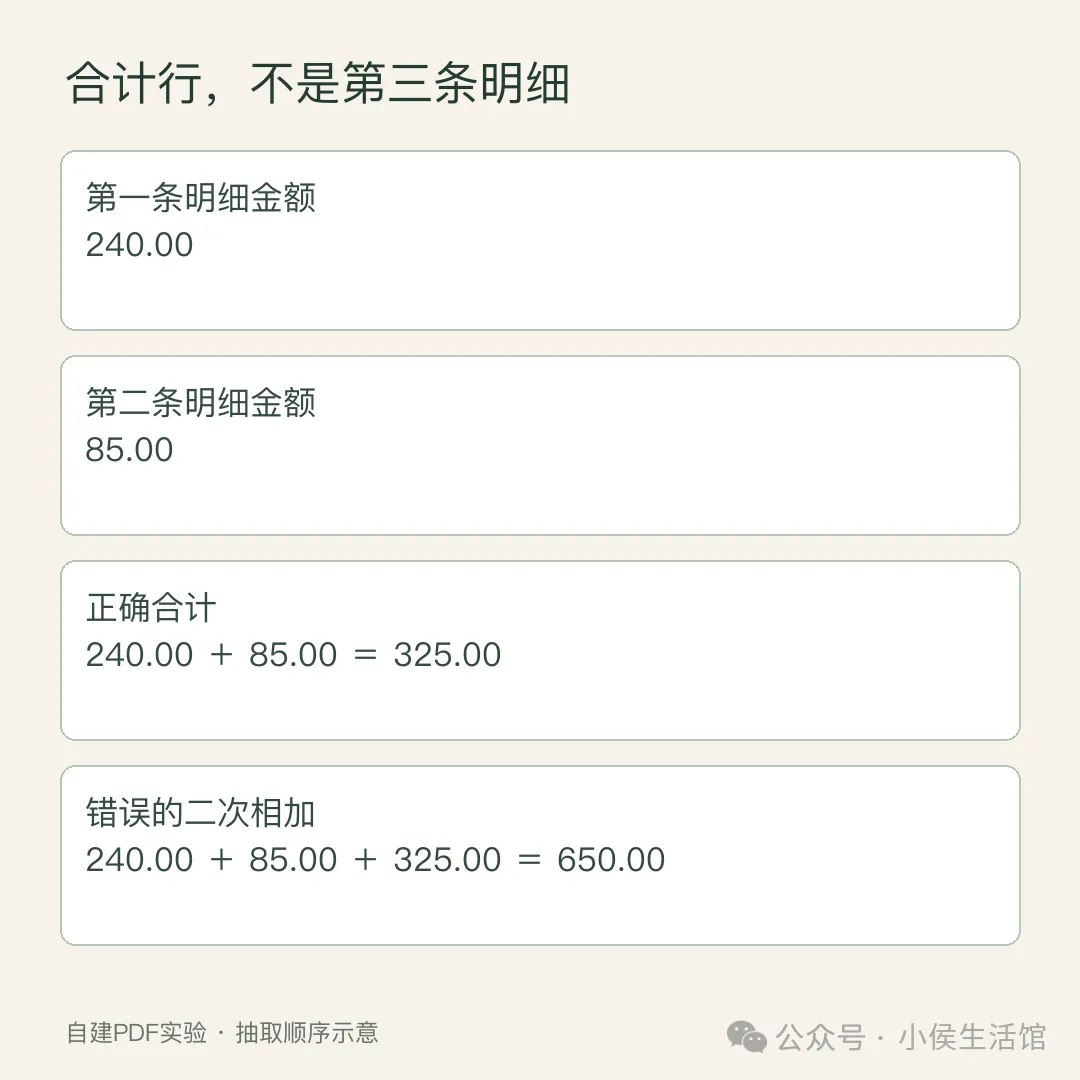
写法示意,不对应实际公司或项目。
04
试转换工具时,把这一步也试完
打开试用页之后,别只上传一份没有合并单元格的简单文件。可以先用一份不含敏感信息的小样,确认行列、合计和备注,再换成与你实际工作相近的版式。
试用完成的标准应当包含导出:文件能否打开,金额能否继续计算,项目名称和数量是否还对应。遇到扫描件,还要检查识别出来的字和数字,不能把能选中当成已经识别准确。
这次保留了生成脚本、原PDF、原始抽取文本和核对后的参照文件。你不用学写脚本,也可以沿用同一个检查顺序:先看结构,再看数字,最后才开始汇总。
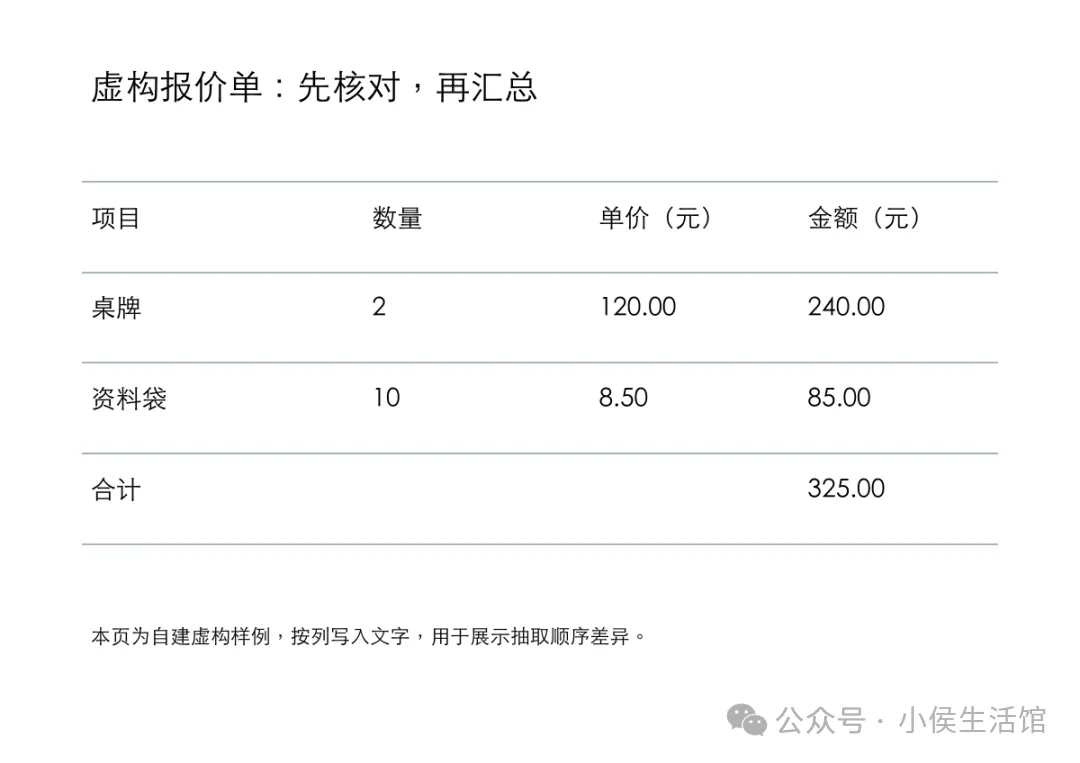
本地自建报价单的实际PDF页渲染。
小侯生活馆|把工作里的小麻烦,一件件做明白。
参考:pypdf官方文档,Extract Text from a PDF。查阅日期:2026年11月3日。查看原文