ARTICLE · 1353422
DeepSeek 把整个 App 拆成了 API:联网搜索、读文件、语音全开放,千次搜索 5 块钱
■ 临界观察 · 068 DeepSeek · 全家桶应用 API
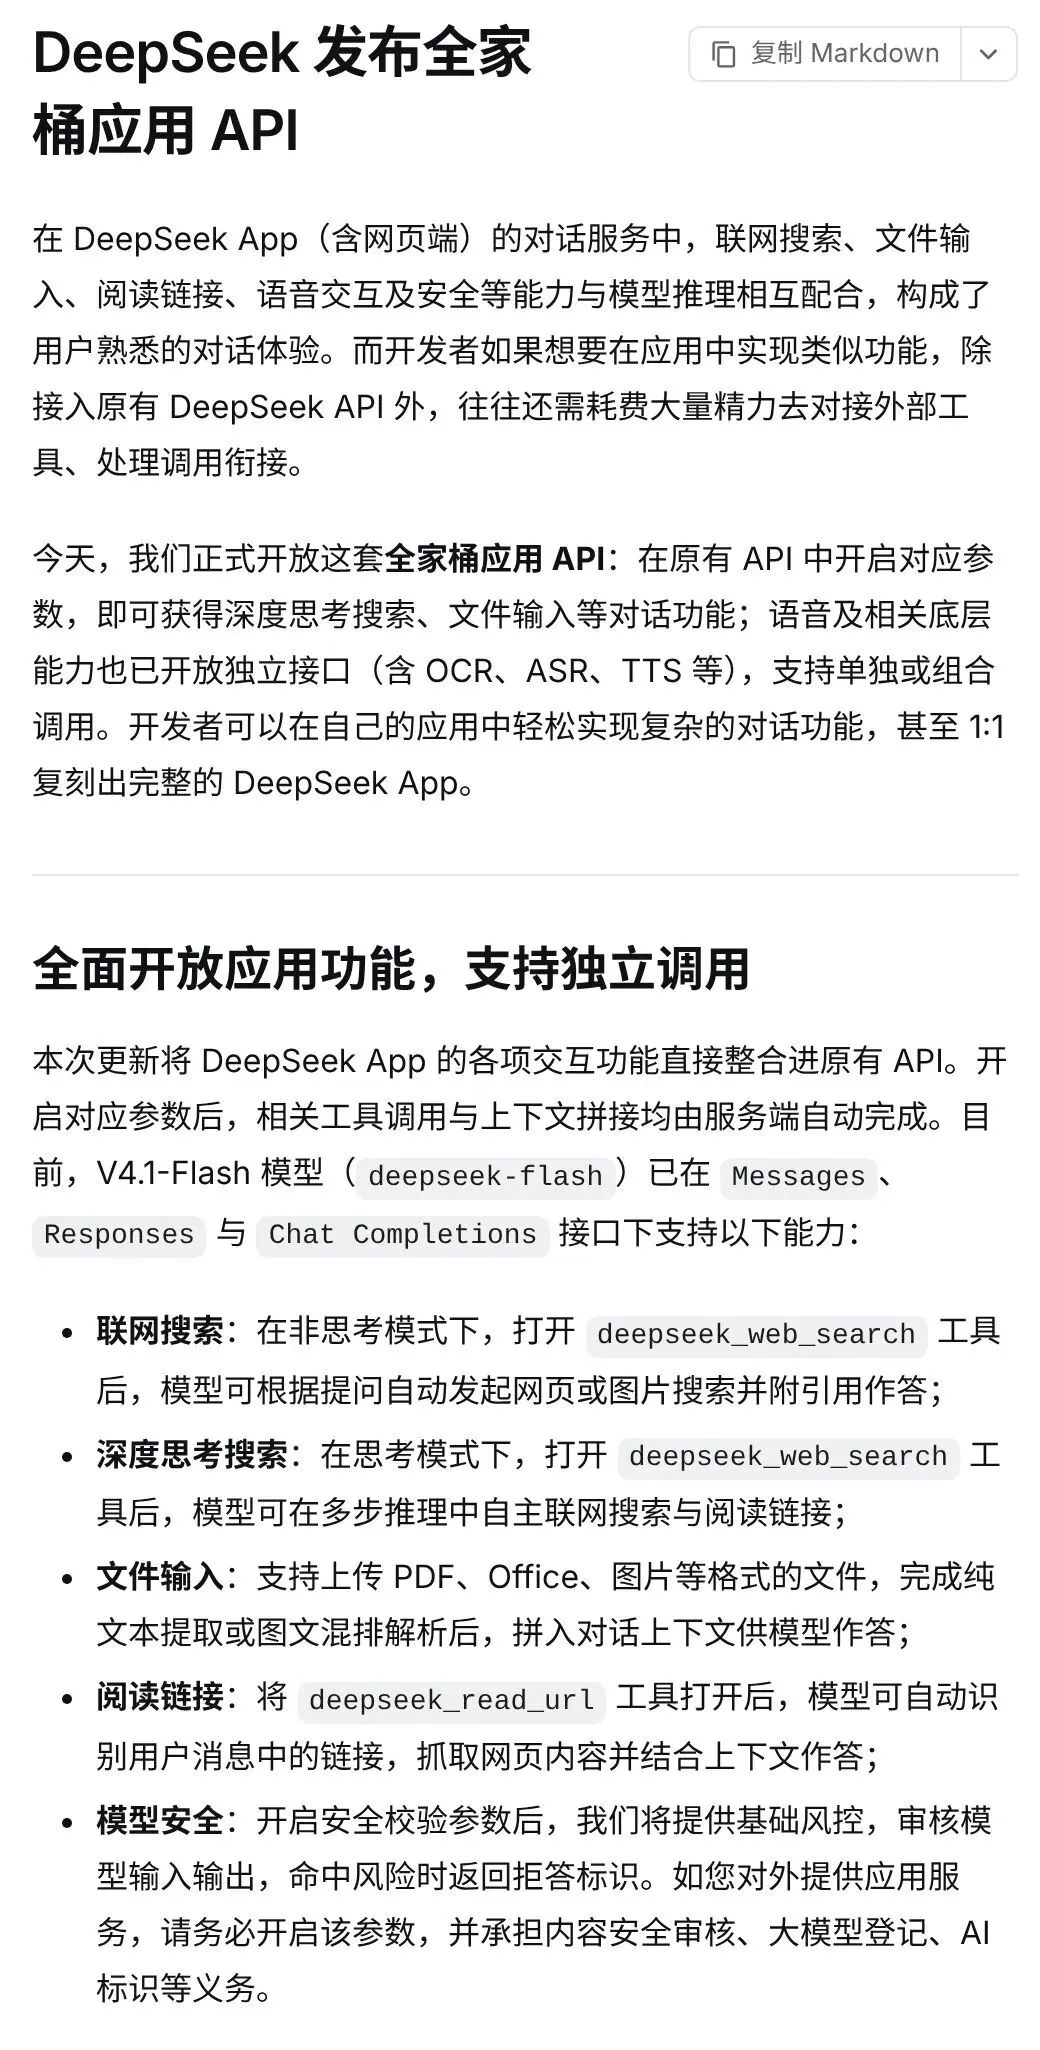
昨晚,DeepSeek 在 API 文档的新闻栏里挂出一条更新:全家桶应用 API。
App 里那些我们每天在用的能力,联网搜索、深度思考搜索、上传文件、阅读链接、语音、安全审核,现在全部搬进了 API。开一个参数就能用,工具调用和上下文拼接都在服务端做完。
官方的原话很直接:开发者可以在自己的应用里 1:1 复刻出完整的 DeepSeek App。
为了证明这句话,DeepSeek 还顺手开源了一个演示客户端,能把你在 DeepSeek 网页端导出的聊天记录整包导进去,接着聊。
价格也一起公布了。搜索 5 元一千次,文字识别 1.5 元一千页,语音识别限时 5 折,0.39 元一小时。
01 / 发生了什么
一个模型,三套协议,App 的能力全在里面
以前想做一个带联网的聊天应用,要做的事情很多。
先接一个搜索引擎,再写网页抓取和正文清洗,PDF 和 PPT 要找解析服务,语音输入和朗读各接一家。最麻烦的是把这些结果拼进上下文,还要处理模型什么时候该搜、搜完怎么标引用。
这次 DeepSeek 把这些活全揽到了服务端。
承载这些能力的是 deepseek-flash,也就是上个月 17 日更新的 V4.1-Flash-1017。它同时支持三种接口格式:Anthropic 风格的 Messages、OpenAI 风格的 Responses,以及老牌的 Chat Completions。
手上的代码用哪家的 SDK 写的,基本都能直接接。
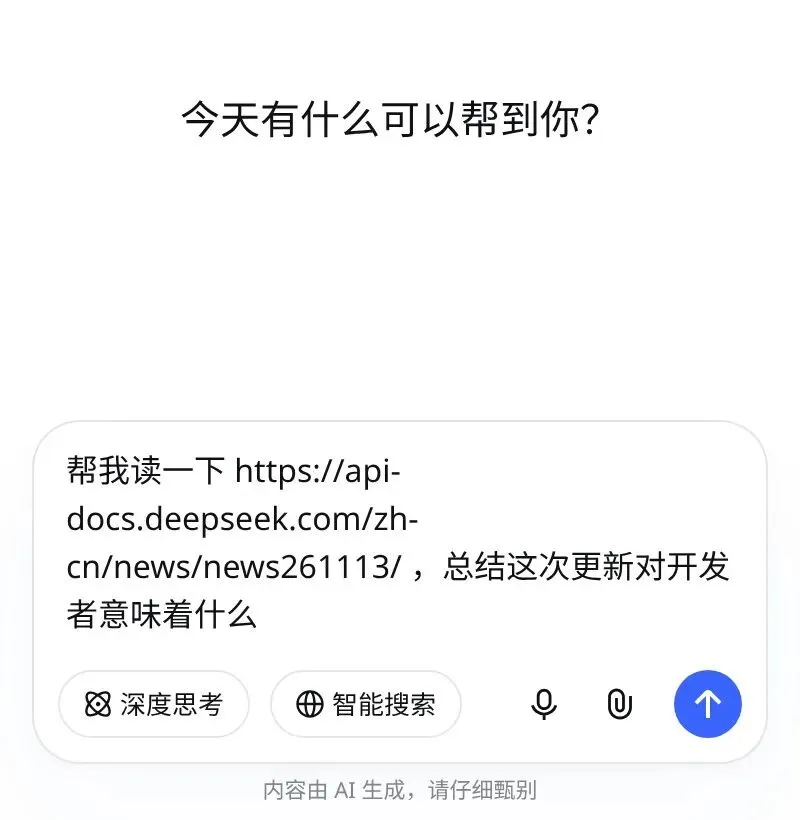
上面这张是我在手机上打开官方演示客户端的样子。深度思考、智能搜索、语音输入、附件上传四个按钮,和 DeepSeek 网页端的输入框是同一套布局。
02 / 联网
搜什么、读哪页,模型自己决定
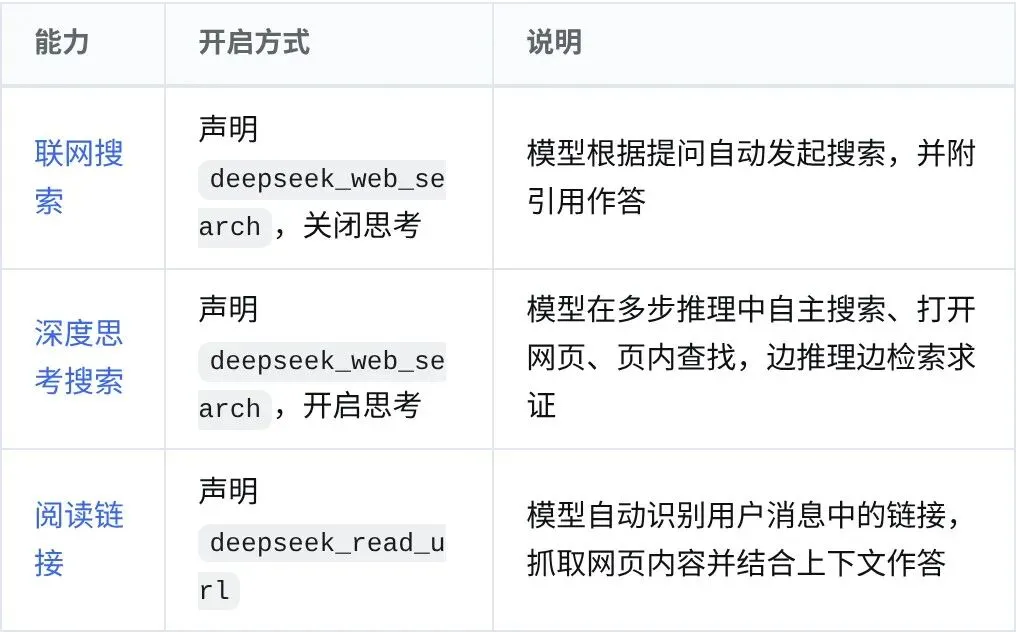
联网这块拆成了两个服务端工具,组合出三种用法。
在 tools 里声明 deepseek_web_search,关掉思考,就是我们熟悉的联网搜索:模型判断要不要搜,搜完带着引用角标回答。一次搜索可以同时发出好几个查询词。
同样的工具,打开思考,就变成深度思考搜索。模型在推理过程中自己搜索、打开网页、在页内查找关键词,边想边查,查完再接着想。
第三种是阅读链接,声明 deepseek_read_url。用户消息里贴了网址,模型会自己去读,最多看前 10 个不同的链接,读哪几个由它挑。
有个设计挺有意思:tool_choice 里没法强制指定这两个工具,硬指定会直接报错。要不要搜、读不读,交给模型判断,这和网页端的体验保持一致。
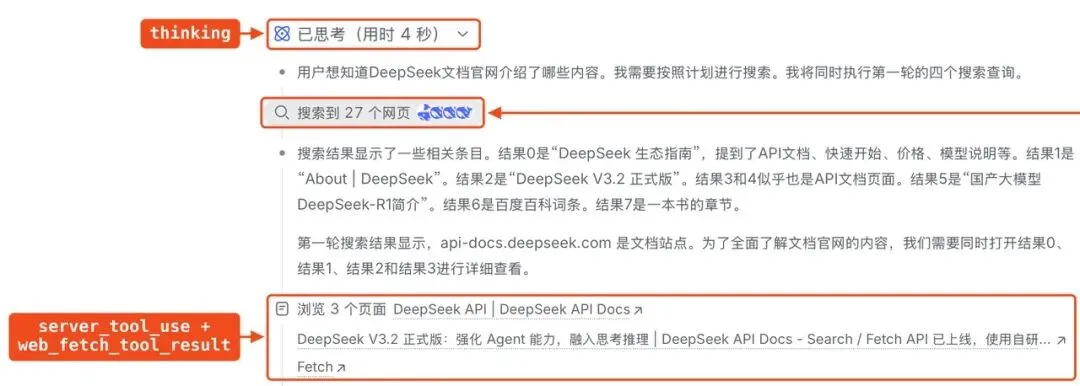
这张是官方文档里的标注图,我觉得是整套文档里最有用的一张。
一次回答返回的内容块,和网页端界面一一对应:先是可折叠的思考过程,然后是「搜索到 27 个网页」的搜索块,再是「浏览 3 个页面」的抓取块。
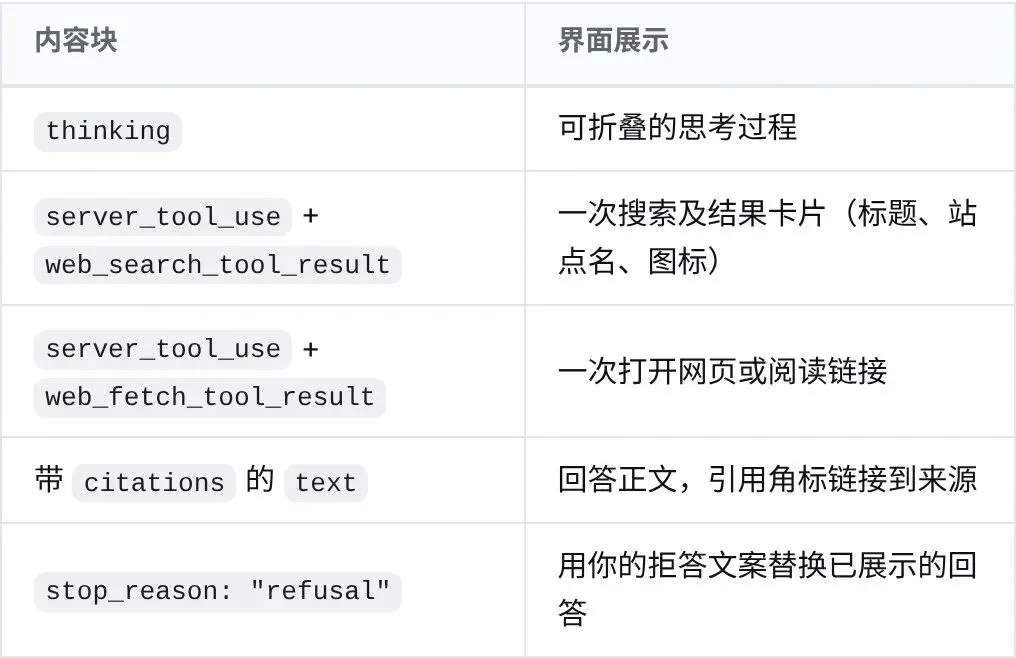
最后是带引用角标的正文。万一触发安全审核,响应以拒答结束,前端把已经显示的回答替换成自己的文案。
块的命名沿用了 Anthropic 那一套,server_tool_use、web_search_tool_result、web_fetch_tool_result。用过 Claude 联网工具的人,前端渲染代码几乎不用改。
抓下来的网页正文加密后放在 signature 字段里,客户端只管展示标题和链接,下一轮原样回传就行。
03 / 一个请求
十几行 curl,App 的骨架就有了
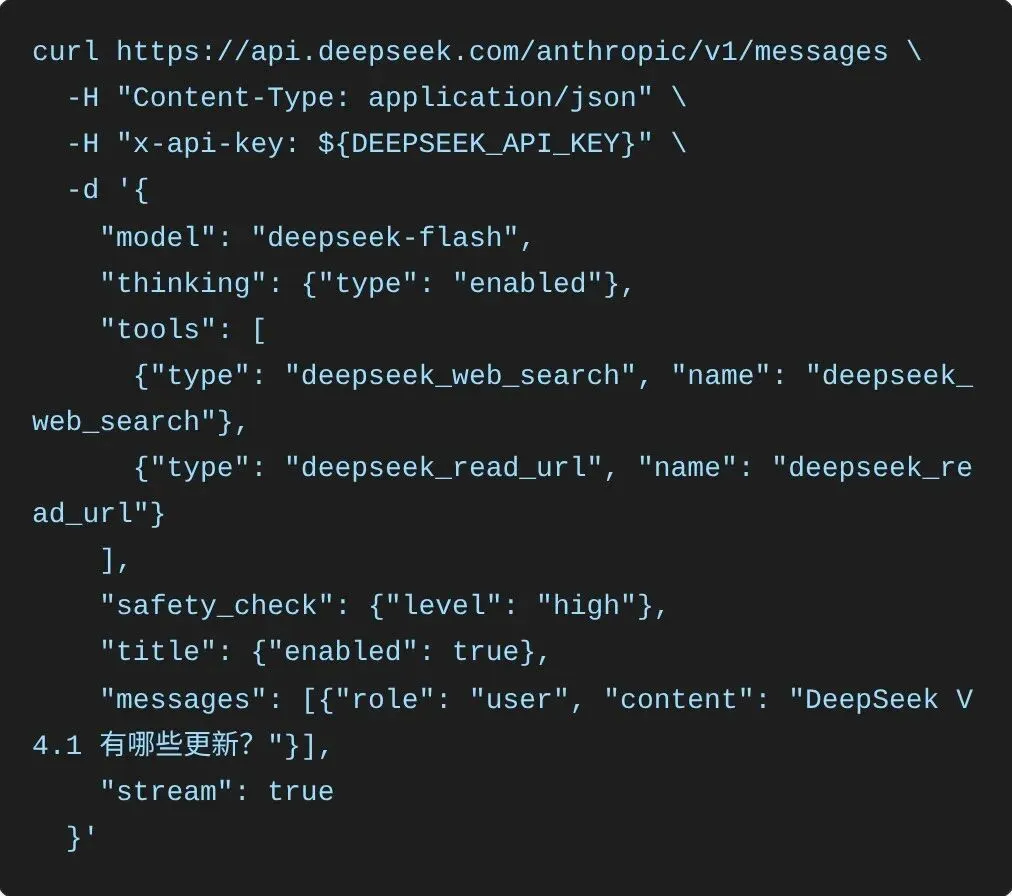
官方给的快速示例只有十几行。
模型填 deepseek-flash,打开思考,声明搜索和读链接两个工具,safety_check 设成 high 开启安全审核,title 设成 true 让模型顺手起一个会话标题,再打开流式输出。
这一个请求,覆盖了 DeepSeek App 一轮对话里的大部分动作。
开了这些扩展以后,temperature、top_p 这类采样参数由服务端接管,传了也会被忽略。max_tokens 照常生效,限制的是每一步推理的输出长度。
04 / 读文件
图表也能看懂,解析一次,后面只算 token
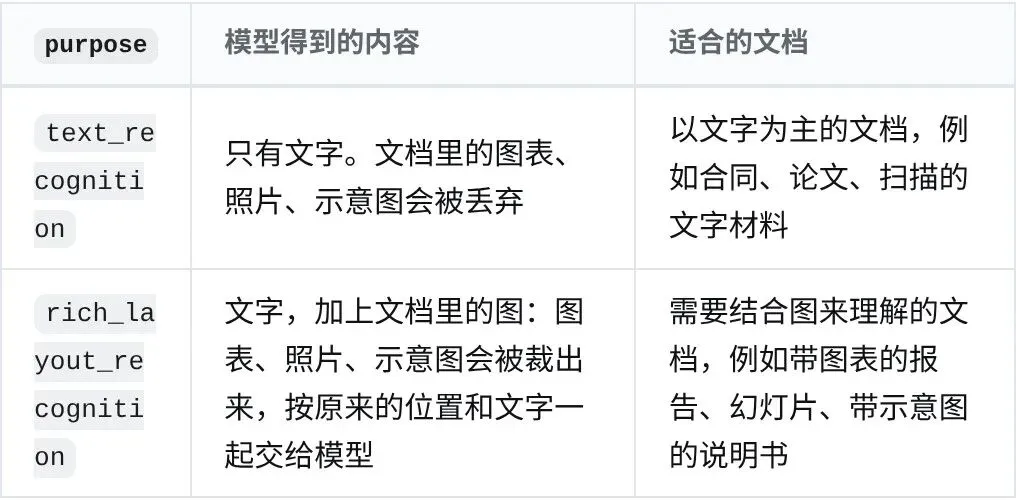
文件输入分两步。先把 PDF、Word、PPT 或图片传到 Files 接口,拿到 file_id,再在对话里引用它。
上传时要选解析方式。text_recognition 只提文字,适合合同、论文。rich_layout_recognition 会把文档里的图表、照片、示意图裁出来,按原位置和文字一起交给模型。
官方举的例子很实在:一份财报里有张营收趋势图,用户问「这张图说明了什么」,只有第二种方式能答上来。
一个请求最多引用 20 个文档,文字合计 8 MiB。多轮对话里,历史消息引用过的文档会完整保留在上下文里,超长时直接返回 400,绝不悄悄截断。
计费也算得清楚:上传解析成功时按页数收一次,1.5 元一千页。之后每次对话引用,只按拼进上下文的 token 收费。
独立的 OCR 接口一次能吃 1000 页、100 MiB 的文件。逐页识别的结果里带着 0 到 1000 归一化的坐标框,拿来定位文字、自己裁图都很方便。
05 / 全家桶
九项能力,连会话标题都替你想好了
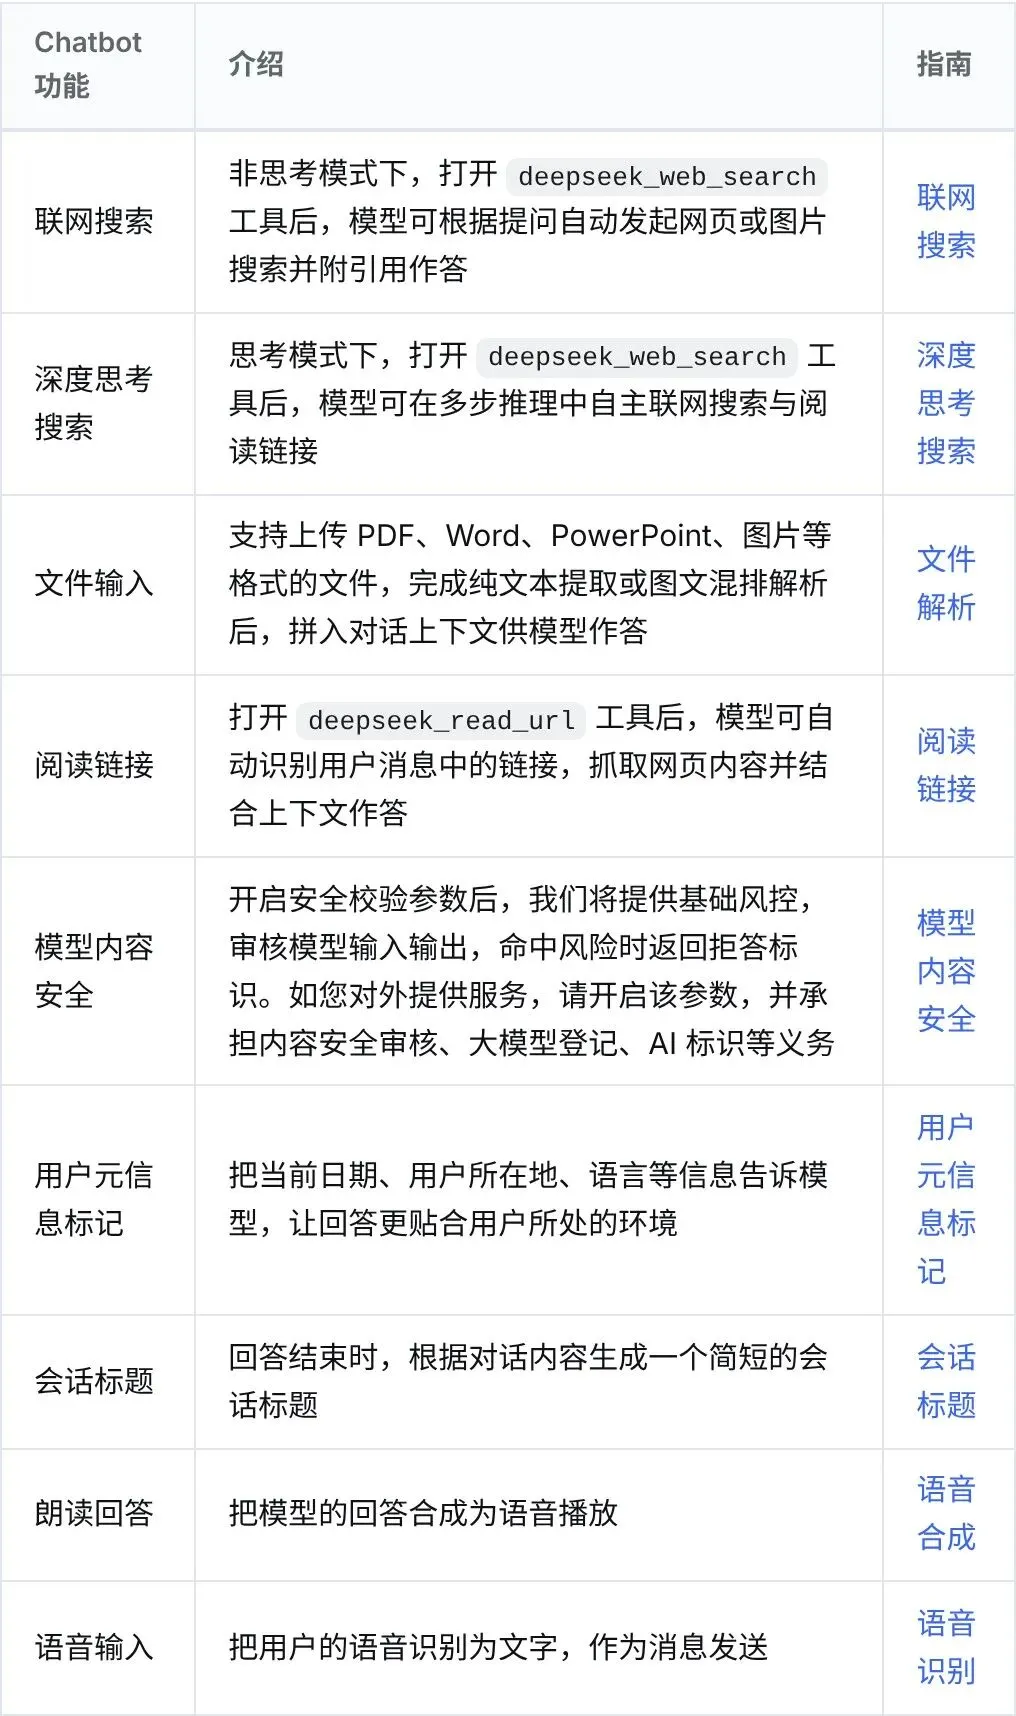
这张功能对照表,列的就是一个完整聊天应用需要的全部零件。
除了前面说的联网和文件,还有几项小功能,做过产品的人会懂它们有多省事。
用户元信息标记:网页端会悄悄告诉模型今天几号、星期几、用户在哪、用什么语言。API 里新增了一个 latest_reminder 角色,格式像这样:2026-11-11,星期三,新加坡,Web,中文。问「今天有什么新闻」时,模型就知道该按哪天、哪个地区去找。
会话标题:回答结束时顺带生成一个短标题,用来填对话列表,不额外收费。
语音合成:两个音色,女声「海星」和男声「暗潮」,支持普通话、粤语、英语等 10 种语言。除了整段合成,还有 WebSocket 流式接口,模型边生成,语音边播放。
语音识别:支持中文、粤语、英语等 21 个语种,自动判断语种,单段最长 120 秒,按秒计费。
06 / 演示客户端
静态网页,导入你的历史对话
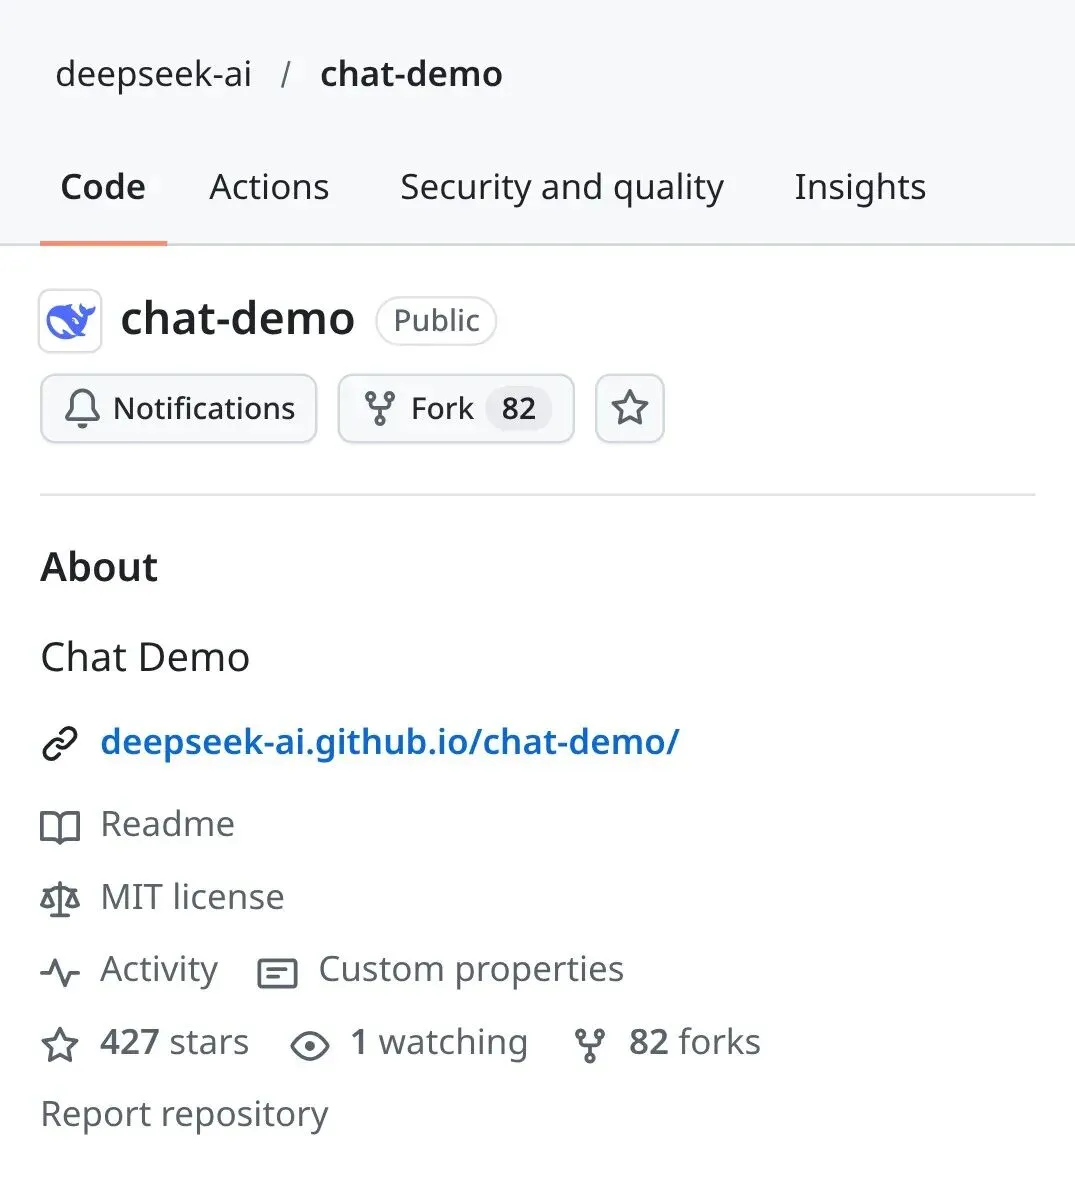
演示客户端放在 GitHub 上,叫 chat-demo,MIT 协议,TypeScript 写的。我截图的时候,它已经有 427 颗星、82 个分叉。
它是一个纯静态网页,没有后端。浏览器直接连 DeepSeek API,API Key 和设置存在本地浏览器,聊天记录和附件放在浏览器的本地数据库里。
下载压缩包,解压,双击 index.html 就能用,连构建都省了。
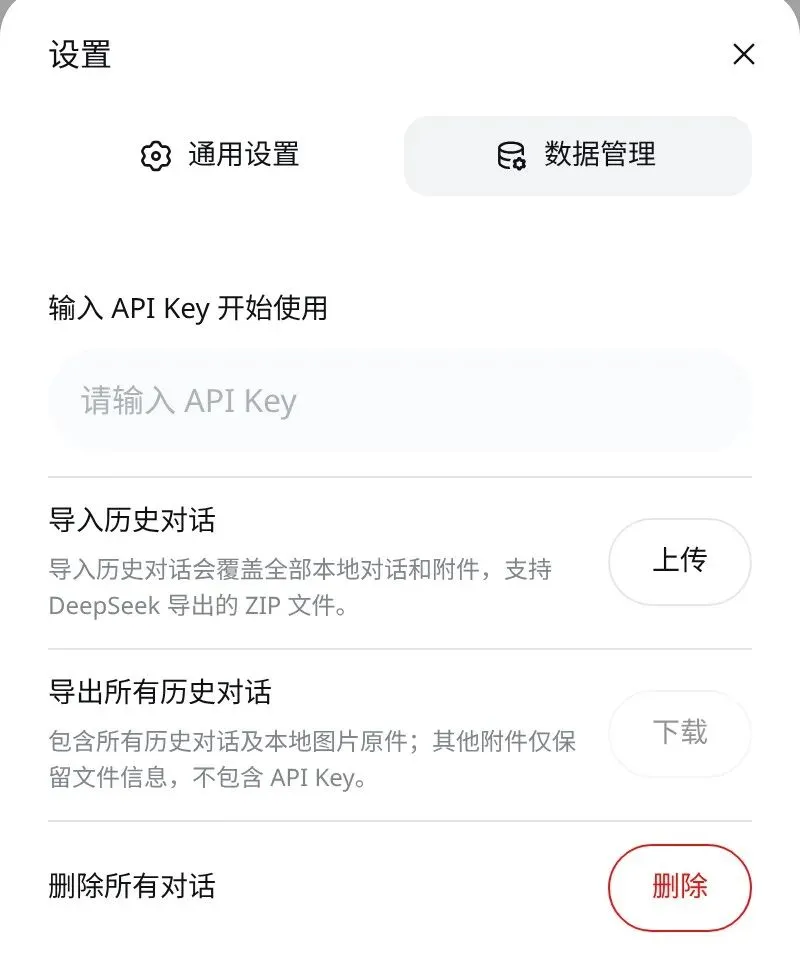
设置里第一项就是填 API Key。下面是导入历史对话,支持 DeepSeek 网页端导出的 ZIP 文件。
这一点我挺喜欢。在 DeepSeek 里攒了几个月的对话,可以整包搬到自己掌控的客户端里,接着用同一个模型往下聊。
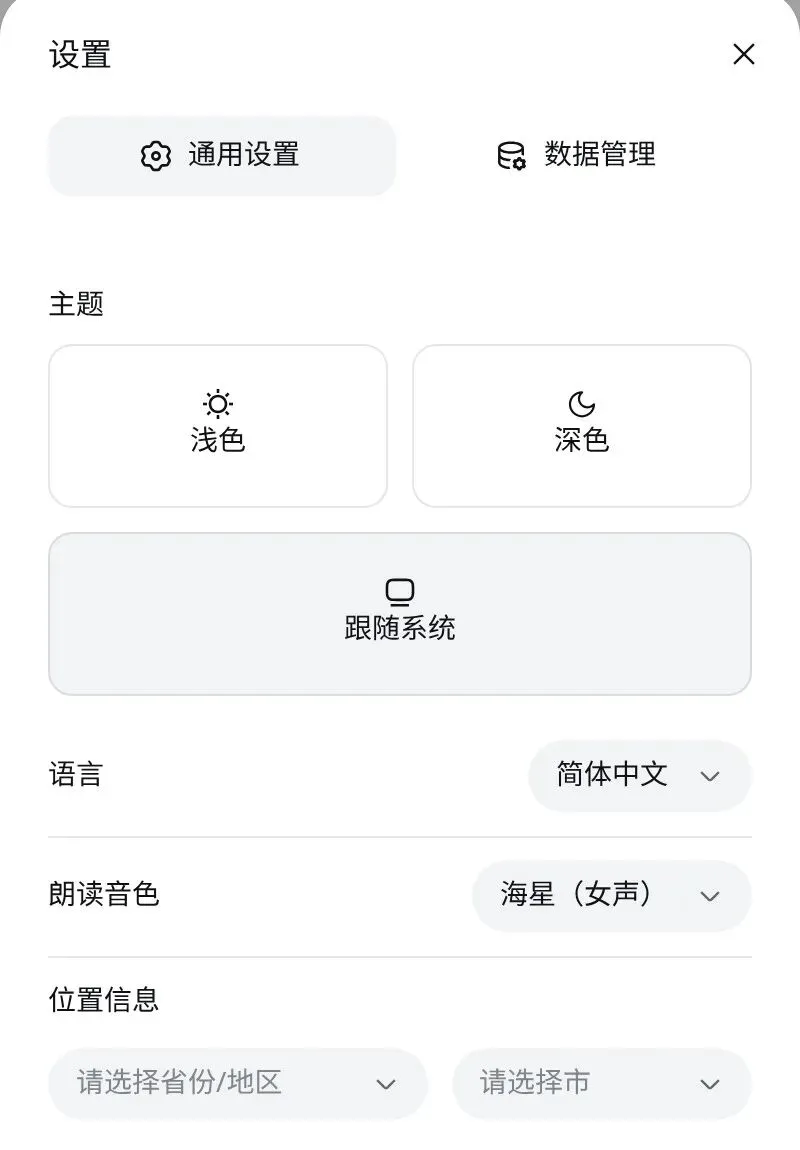
通用设置里能选朗读音色,默认是海星(女声),还能选省份和城市。这个位置信息,就是作为前面说的用户元信息标记传给模型的。
功能清单里还有 Markdown 和 Mermaid 图表渲染、公式、多分支消息、继续生成、深浅色主题。一个周末,就能改出一个带自己品牌的聊天产品。
07 / 价格
算一笔 1000 次联网问答的账
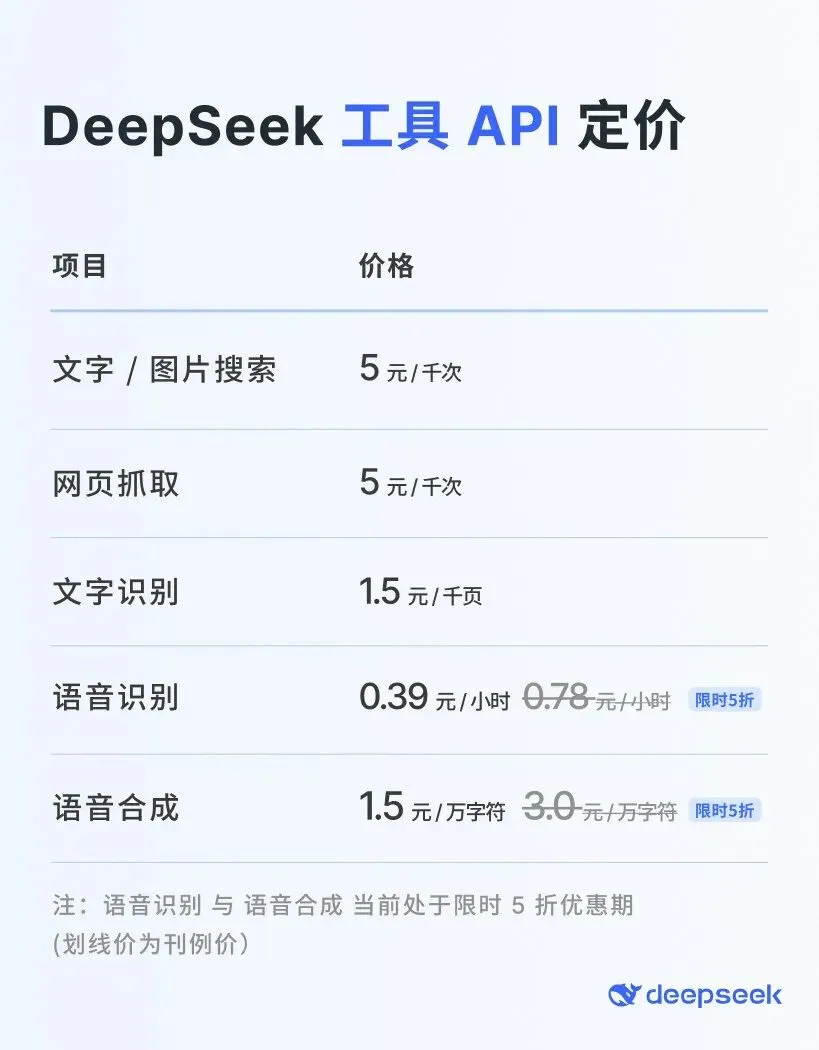
工具价格一共五项。文字和图片搜索 5 元一千次,网页抓取 5 元一千次,文字识别 1.5 元一千页。语音识别 0.39 元一小时,语音合成 1.5 元一万字符,这两项眼下都是限时 5 折,原价翻倍。
计费规则写得很细,我挑几条重要的。
搜索按查询词计次,一次调用带 3 个查询词就算 3 次,失败或者没搜到结果不收钱。深度思考搜索里,只有真正从网络抓取网页才计费,重复打开同一页、页内翻页、页内查找都免费。
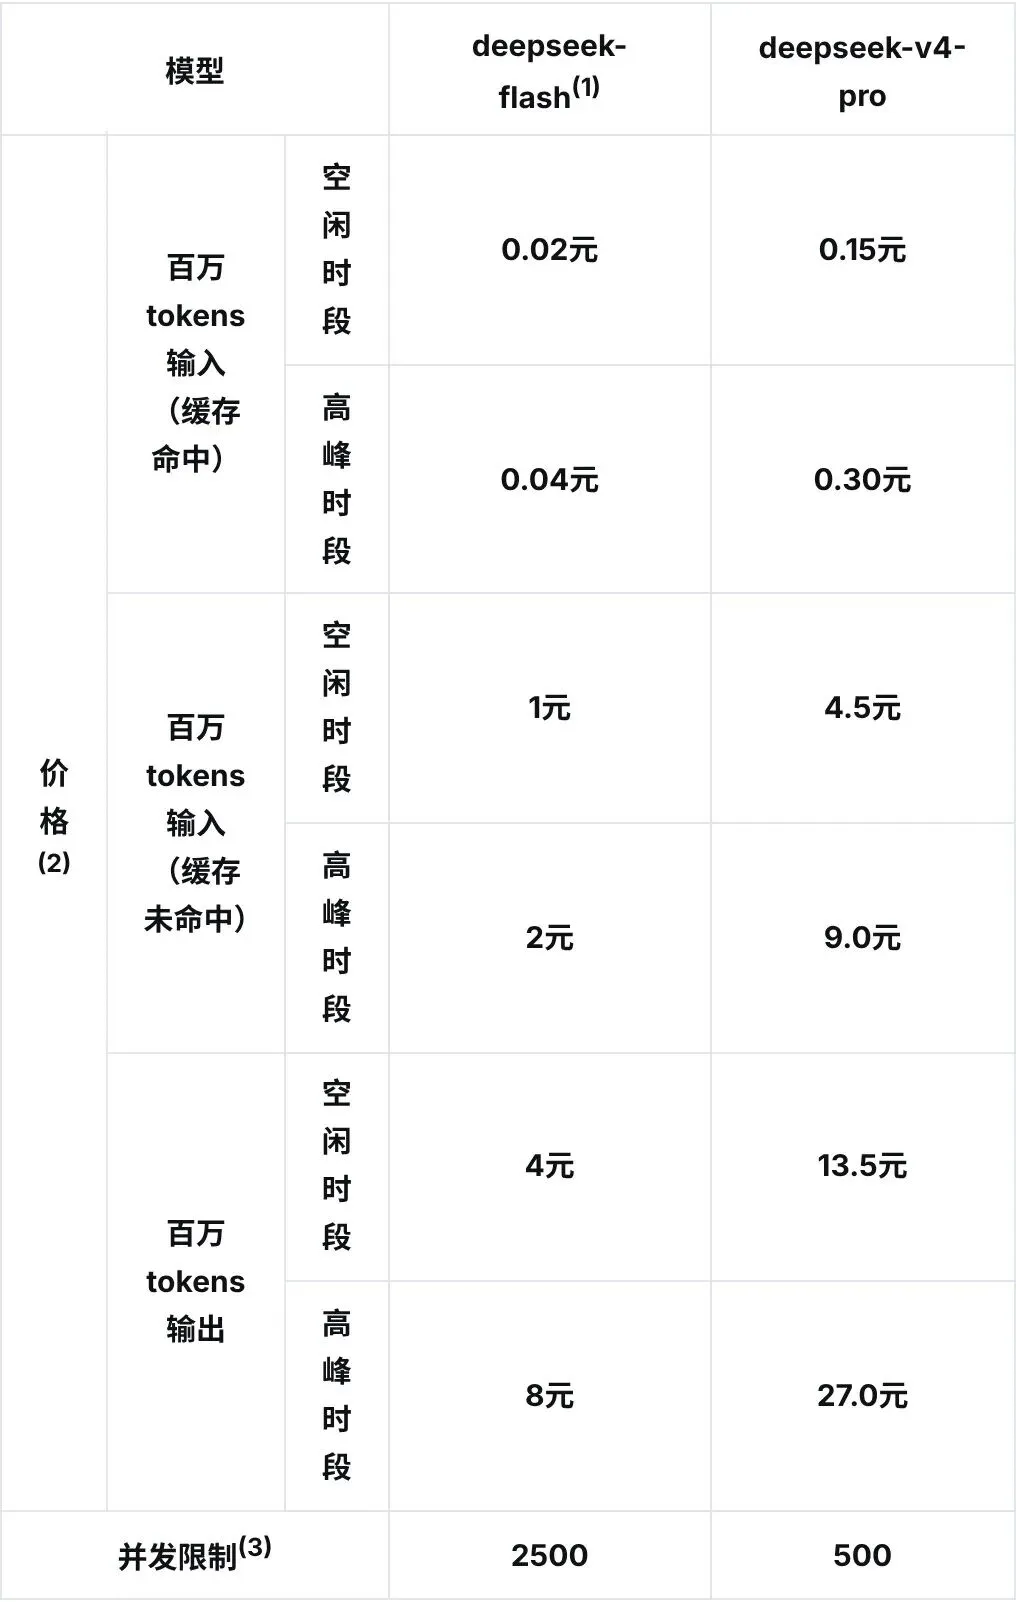
token 价格沿用峰谷定价。工作日 9 点到 12 点、14 点到 18 点是高峰,其余时间包括周末全天,都按半价。
deepseek-flash 缓存未命中的输入,空闲时段 1 元每百万 token,高峰 2 元;输出空闲 4 元,高峰 8 元;缓存命中的输入低到 0.02 元。
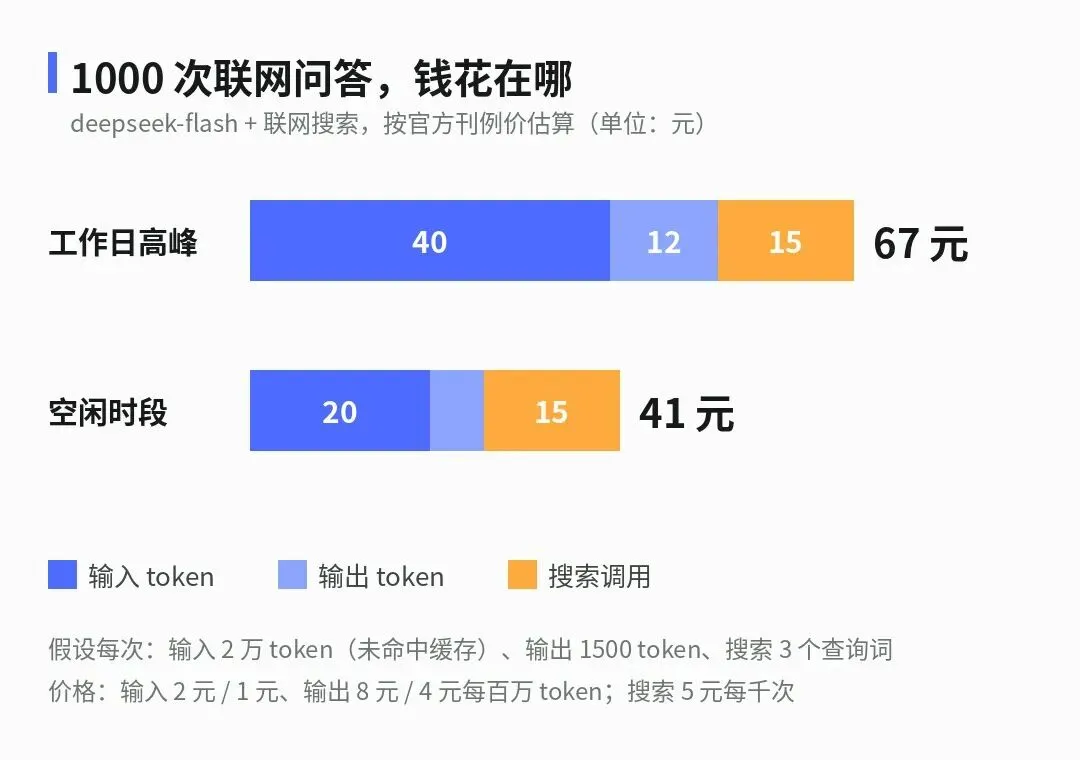
我按一个比较常见的联网问答估了一下:每次输入 2 万 token,输出 1500 token,搜索 3 个查询词。
1000 次问答,工作日高峰大约 67 元,空闲时段 41 元。搜索费固定 15 元,在空闲时段占到三分之一以上。
对一个日活几千人的小应用来说,这个成本已经可以放心去试。
08 / 底座
V4.1-Flash-1017,一块多钱跑出 77% 的 DeepSWE
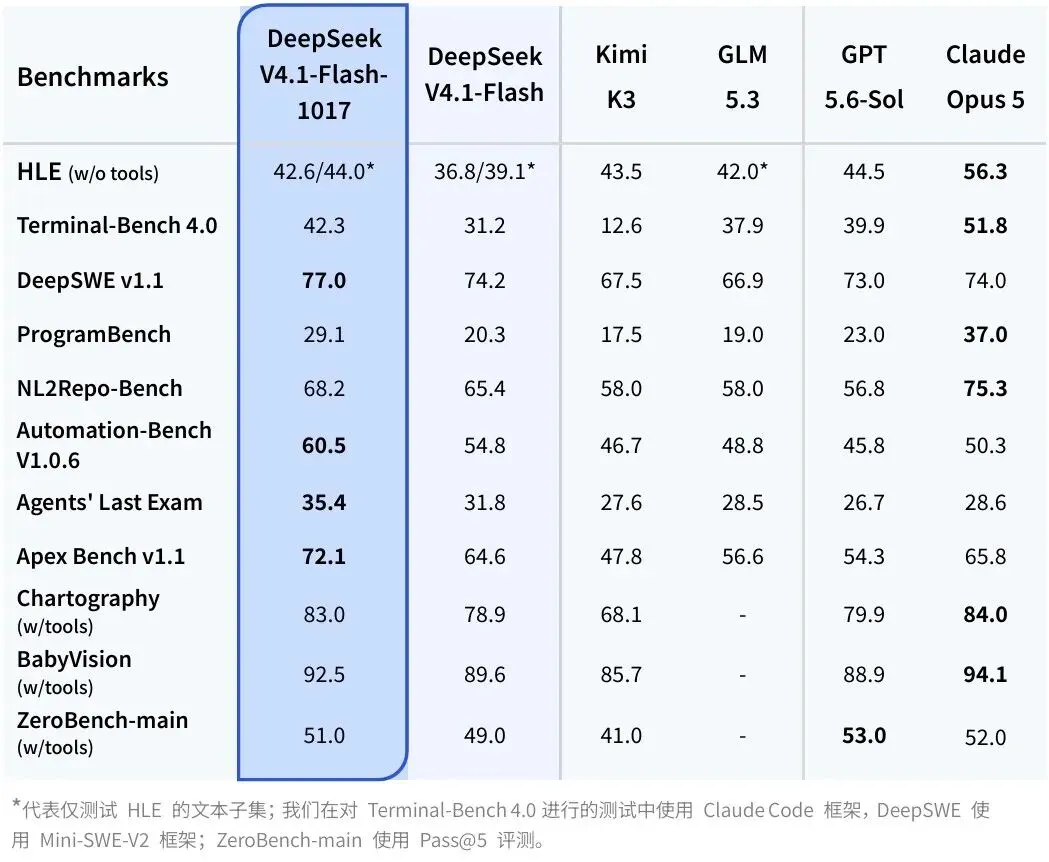
这套 API 能撑起来,靠的是底下那个模型。
V4.1 Flash 是 552B 参数的 MoE,输入激活 8B、输出激活 16B,上下文 100 万 token,最长输出 384K。上个月 17 日的 1017 版本,又用基于自反馈的强化学习,加强了从零搭建完整项目的能力。
官方对比表里,它的 DeepSWE v1.1 拿到 77.0,高于 Claude Opus 5 的 74.0 和 GPT 5.6-Sol 的 73.0。Automation-Bench 60.5、Agents' Last Exam 35.4、Apex Bench 72.1,也都是整张表里最高。
Opus 5 领先的项目集中在终端和长程编程,Terminal-Bench 4.0 是 51.8 对 42.3,ProgramBench 是 37.0 对 29.1。
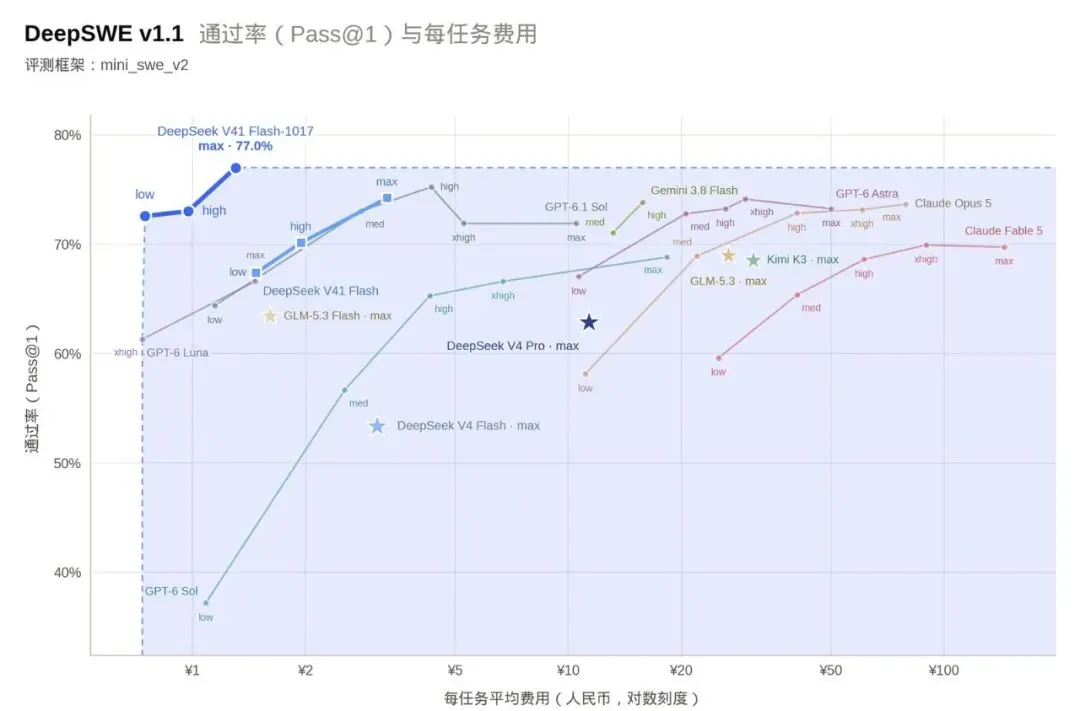
这张性能与费用图更能说明问题。横轴是每个任务花的钱,对数刻度。DeepSeek V4.1 Flash-1017 最高档落在 77% 的位置,每个任务一块多人民币。
图上能摸到 73% 以上的其他模型,GPT-6.1 Sol 每个任务要四块多,Gemini 3.8 Flash、GPT-6 Astra 和 Claude Opus 5 要十几到几十块。
deepseek-flash 单账号并发上限 2500。拿它做一个面向大量用户的联网助手,算力和价格两头都扛得住。
09 / 合规
基础风控做进了参数里
国内的开发者做对外服务,内容安全审核、大模型登记、AI 标识这几件事绕不开。
DeepSeek 把基础风控做成了一个开关。safety_check 设为 high,模型的输入、输出、读到的网页、文档里裁出来的图片都会过一遍审核。命中风险时,响应会带着拒答标识结束,前端换成自己的拒答文案即可。
官方也把话讲在前面:这个参数帮你满足合规要求,服务提供者依然是内容安全的第一责任人。做产品的人看到这句,心里就有数了。
10 / 判断
我的看法
过去一年,大模型公司比的主要是模型本身,跑分、价格、上下文长度。
DeepSeek 这次往前多走了一步。它把自己 App 背后那套搜索引擎、文档解析、语音、风控,连同界面怎么渲染、计费怎么算,整套交给了开发者。搜索底层用的是它自研的引擎,官方说索引了千亿级网页。
对国内做 AI 应用的小团队来说,一个账号、一份账单,就能拿到模型、搜索、文档、语音和基础合规。以前要拼五六家供应商的活,现在一个下午能跑通。
官方在公告最后写了一句:现有的对话产品,只是人与模型交互的一种基础形态。
我理解这句话的意思是,DeepSeek 想看看别人能用同一套零件,搭出什么它自己没想到的东西。
NEXT / 下期预告
用演示客户端把我在 DeepSeek 网页端的历史对话导进去,深度思考搜索连用一周,把账单拆给大家看。
Singularity 临界点
不只介绍 AI 工具,更关注它们能否真正进入工作。