ARTICLE · 1046077
投了OpenAI上百亿,微软却在法庭上说:这是"人类史上最大盗窃"!
9月17日,一批法庭文件解封。
里面有句话出自微软一位高管之口,形容AI公司抓互联网数据训练模型这件事——
"人类史上最大规模的劳动力盗窃。"
微软,OpenAI最大的投资方,往后者身上砸了超过一百三十亿美元。
金主在法庭文件里骂自己投的公司是小偷。这个画面就有意思了。
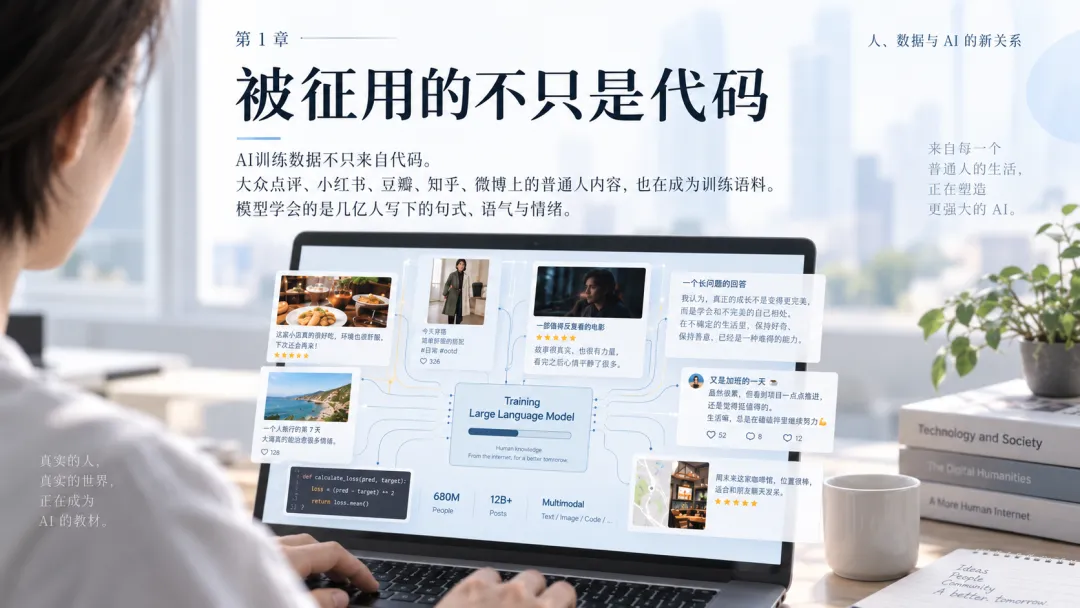
一、被征用的不只是代码
大多数人以为"AI训练数据"就是GitHub上的开源代码、Stack Overflow上的技术问答。这些确实在被大量使用。
但法庭文件披露的规模远超想象:OpenAI的训练数据集中,仅《纽约时报》、纽约每日新闻和调查报道中心的作品就有91,692份被完整复制。另一个代号为"Project Mango"的数据集,包含了至少160,903篇来自新闻媒体的文章。
模型学会了人类的表达方式,然后把这套能力打包,卖给下游的"AI客服""AI写作助手""AI陪聊"。
更关键的是,文件显示OpenAI员工曾讨论“如何绕过《纽约时报》付费墙直接查看付费内容”的方法。当研究员Nick Ryder告诉Greg Brockman他找到了"绕过NYT付费墙的hack"时,Brockman回复:"ah nice。"
整个过程,内容创作者不知情,没同意,也没拿到一分钱。
二、为什么是微软的人先说
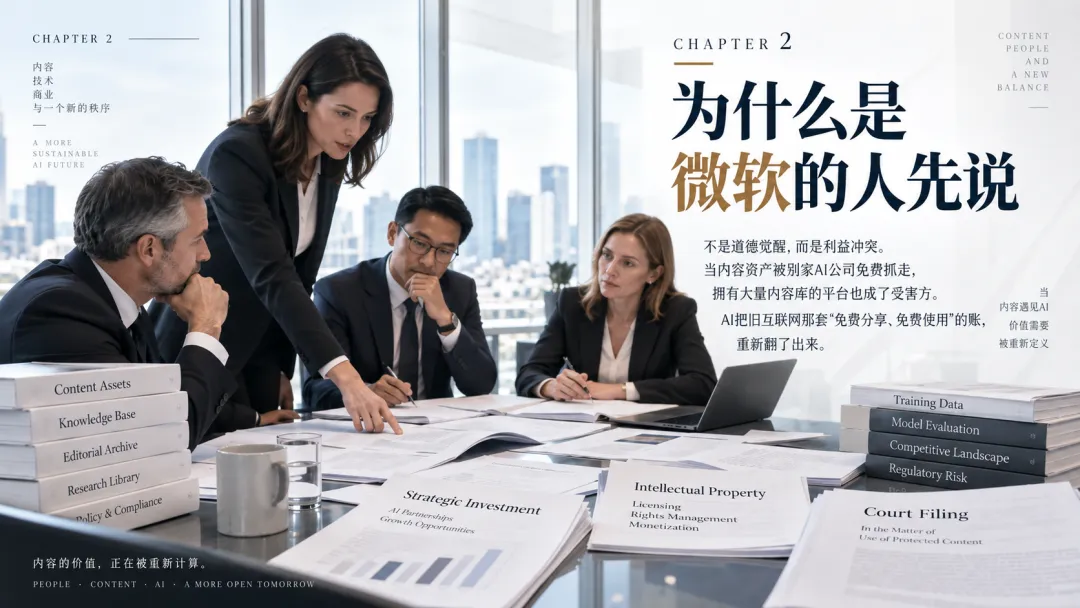
答案很现实:微软自己也拥有大量被AI公司盯上的内容。
Windows技术文档、Office模板库、LinkedIn上几亿篇职场文章、Bing的搜索索引——当别家AI公司免费抓走这些去训练竞品模型,微软就成了受害方。
所以这句"盗窃"不是道德觉醒,是利益冲突。微软在法庭上争的,是自家内容能不能被白用。
但这句话无意间戳开了一个更大的口子。微软CEO Satya Nadella在今年的证词中说:"任何付费墙后面的内容,任何想用它的人都应该获得许可。"他还表示,如果早知道OpenAI抓取了付费墙后的内容来训练,他会要求OpenAI重新训练模型。
文件还披露了一组数据:微软自己的Copilot导致《纽约时报》来自Bing搜索的点击率下降了最多93%。微软内部将这种下降称为"doom loop"(死亡循环)。
以前是平台用你的内容赚钱,现在是平台和AI公司一起用你的内容赚钱,而你依然是那个免费的。
三、普通人能做什么
老实说,目前能做的有限。
关于AI训练数据的诉讼,原告都是有版权资产的大机构——《纽约时报》告OpenAI、Getty Images告Stability AI(该案已于2023年和解)。普通人没有任何工具查询自己的内容被喂进了哪个模型,更没有分账或退出的机制。
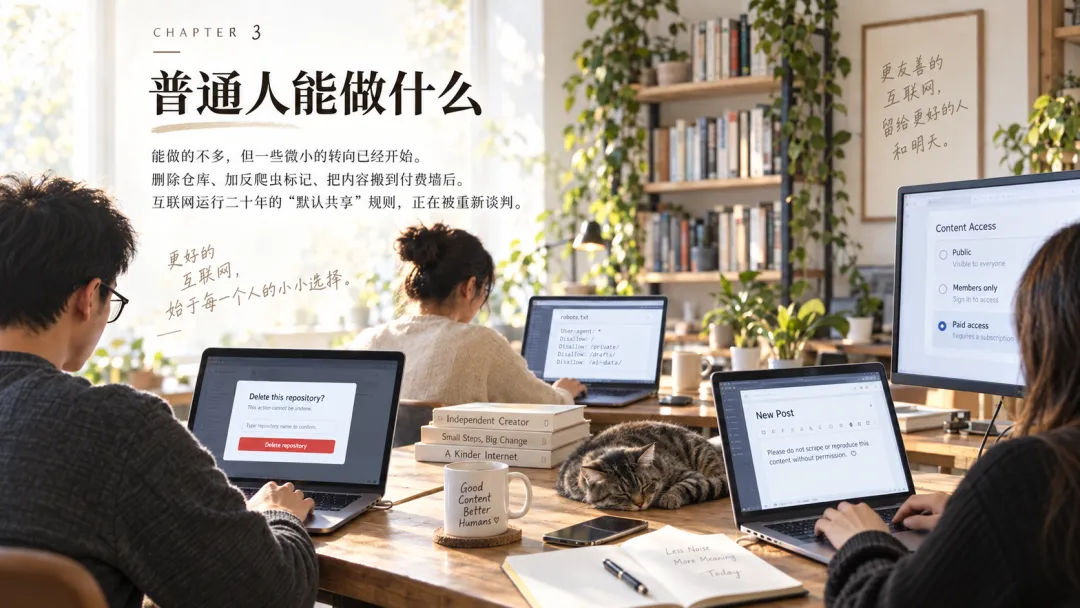
但有一些微小的转向正在发生。
GitHub上的开发者开始修改开源许可证,明确禁止AI训练使用;Reddit在2023年宣布API收费,部分原因就是抵制AI公司免费抓取用户讨论;有些内容创作者把内容从公开平台搬到了付费墙后面。
单独看,每一个动作都小到可以忽略。但它们指向同一个方向:
互联网运行了二十年的"默认共享"规则,正在被重新谈判。
四、这场谈判没有你的座位
一个不舒服的事实是,关于"AI能不能用你的数据"这场谈判,谈判桌上没有普通人。
大公司和AI公司打官司,争的是版权费和市场份额。无论判谁赢,钱都流向公司,不会流向在大众点评上写了三年餐厅评价的你。
这场博弈的终点,大概率是大公司之间达成某种分账协议——你用我的内容训练,付我授权费。普通人产出的那部分语料,会被打包进"公开互联网数据"这个模糊概念里,继续被免费使用。
OpenAI ChatGPT负责人Nick Turley在内部通信中承认,这类产品对出版商构成"existential threat"(生存威胁),且"将在变得更好的过程中越来越具替代性"。
所以那句"人类史上最大规模的劳动力盗窃",说得很重,但它的适用范围可能比说话的人想承认的更广。
被盗的不只是大公司的版权资产,还有几亿普通人二十年里免费写下的字。