ARTICLE · 1046074
AI改变生活:国产大模型哪个最好用?
AI改变生活:国产大模型哪个最好用?“哪个国产大模型最好用?”我们从2026 年 9 月这个时点,国产大模型的格局长什么样,每家强在哪,以及为什么“哪个最好用”来解答这个问题。 一 先看牌桌:第一梯队已经定型 7 月底,中国数据研究中心发了一份《2026 中国 AI 大模型竞争力 TOP20》,对国内 68 家厂商做了四维评估——技术、商业、生态、潜力。 榜单前十是:豆包、通义千问、DeepSeek、智谱 GLM、文心一言、腾讯混元、Kimi、MiniMax、华为盘古、阶跃星辰。 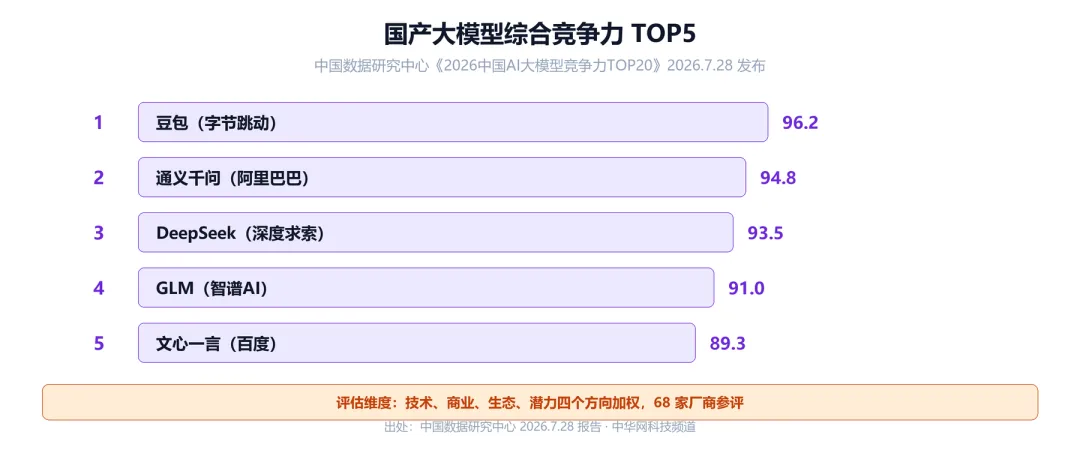
国产大模型综合竞争力 TOP5(2026.7 数据) 分数拉不开是这份榜单最值得琢磨的地方:第一名 96.2,第三名 93.5,差距不到 3 分。 放到两年前,这种贴身肉搏是不可想象的——那时候国产模型跟 GPT-4 之间隔着一条鸿沟,现在鸿沟没了,队内也开始分不出高下。 综合各家社区选型指南的口径,第一梯队五强的画像大概是这样: 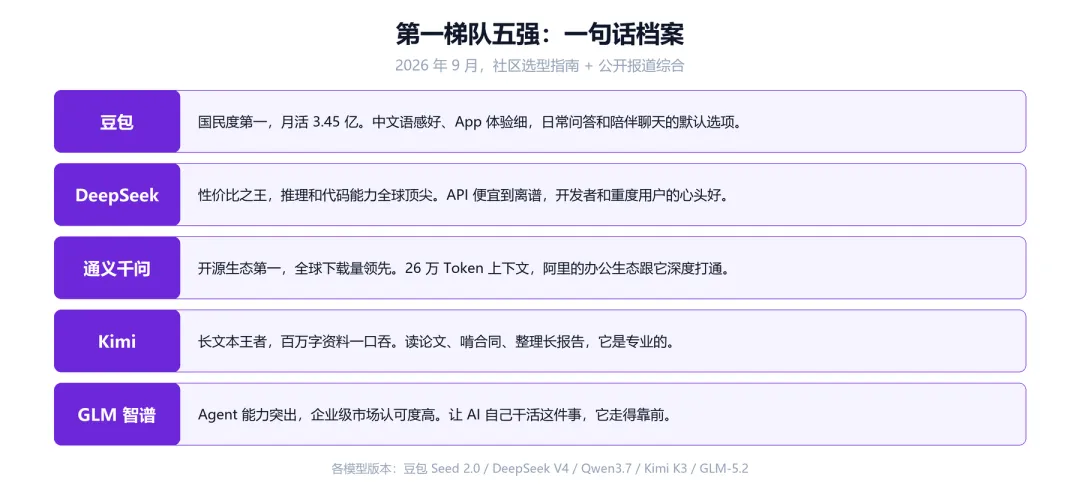
五强一句话档案(2026.9 综合) 注意一个词:画像,不是排名。 豆包月活 3.45 亿是国民度第一,不等于答题最强;DeepSeek 推理顶尖,不等于你拿来写小红书文案顺手。五家各有各的地盘,这才是 2026 年的真实格局。 这份名单跟两年前比还有个大变化:名字换了一批。 曾经刷屏的某些名字掉到了第二梯队甚至更靠后,新面孔挤了上来。 大模型这行没有终身制,一次版本掉队,声量几个月就没了——这也是看榜单时该有的警觉:今天的名单,未必是明年的名单。 二 “最好用”三个字,坑就坑在“最好” 为什么我不直接给一个名字?因为“最好用”取决于三件因人而异的事。 第一件,你拿它干什么。写周报、解数学题、读论文、陪娃聊天,是四种完全不同的活,对应四种完全不同的强项。让 Kimi 去写朋友圈文案,让豆包去啃三百页的招股书,都是杀鸡用牛刀反过来用——不是不行,是浪费,体验还别扭。 第二件,你从哪用。手机上随手问一句,App 的流畅度和语音体验权重就高;电脑前干正事,网页端的长文能力和文件上传就重要;写代码的程序员,看的是 API 便不便宜、稳不稳定。同一家产品在不同终端的体验差异,有时比不同家之间还大。 第三件,你已经有什么。用 WPS 办公的人接通义会顺,苹果全家桶用户的考量又不一样,公司规定只能用某家的 API 那更没得选。工具是嵌在生活里的,不能单拎出来打分。 所以更靠谱的问法是:我常干这几件事,选哪家?下面这张表按场景给答案。 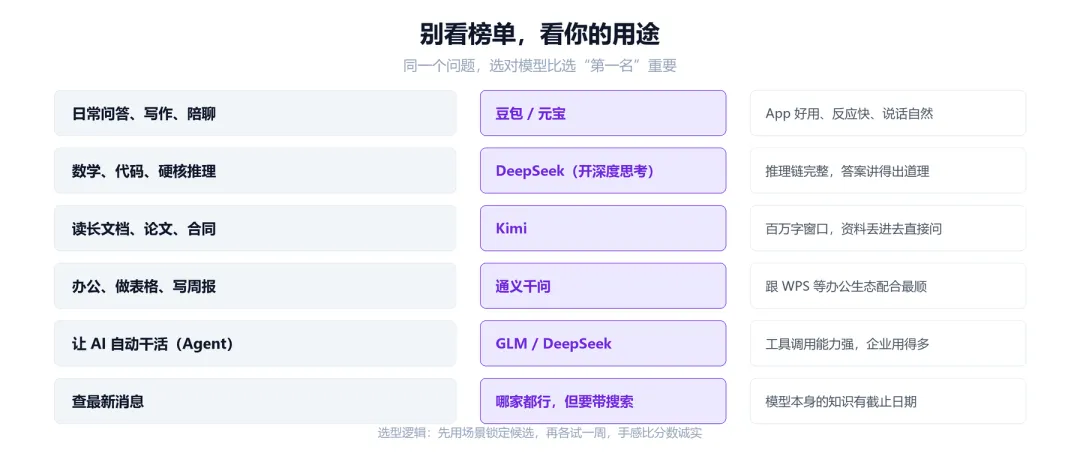
按需求选模型:场景到推荐的对照表 这张表里的推荐都有前提:带“深度思考”的模型推理强但慢,急性子慎用;长文本是 Kimi 的主场,但日常短问答它的灵气一般;“查最新消息”那行要特别划重点——模型自己的知识都有截止日期,问它昨天的新闻,它只能靠内置搜索,搜不搜得到另说。 第二梯队也顺带交代:文心一言和混元背靠大厂,生态稳但声量小;MiniMax 语音和多模态生成有特色,出海做得好;讯飞星火在教育和方言场景守着自己的基本盘。这些模型不是不能用,是你要为某个特定需求去够它们,不如第一梯队那么“顺手就来”。 对普通人来说,第一梯队五家的免费额度,已经足够覆盖九成九的日常需求。 三 榜单能信几分? 榜单不是没用,是它的用法跟你以为的不一样。它能告诉你谁被淘汰出局了、谁在第一梯队没掉队,这些“范围信息”相当可靠——今天没有任何一家靠谱机构会把榜首之外的模型排进第一梯队。 但它给不了你“第一名是谁”这个答案。 原因有三个: 一是各家评测维度和权重不同,同一批模型在不同榜单上名次能差出五六位; 二是模型迭代太快,7 月的榜单,9 月可能就有新版本翻盘,今年国产主流模型基本保持在两三个月一次大更新的节奏; 三是榜单测的是通用能力,你用的往往是一两个具体场景,通用第一不等于你的场景第一。 还有一个更隐蔽的坑:版本名。 很多报道说“豆包很强”,但豆包有标准版、Pro 版、思考版,能力差异不小;DeepSeek 的 V3 和 V4、R1 和 V4 也是两码事。 看评测先看测的是哪个版本,不然结论完全错位。 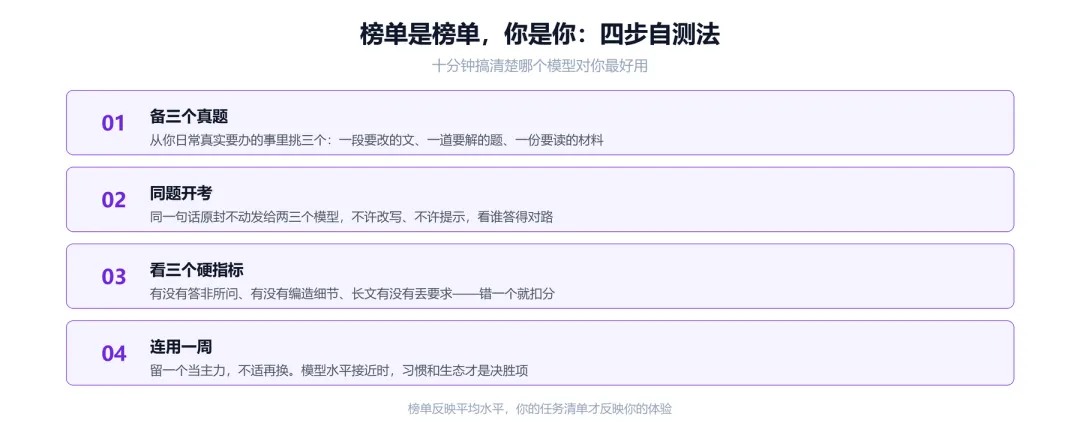
四步自测法:用你自己的任务测模型 四 我的实际用法,供你抄作业 我自己手机里常驻两个:豆包当日常主力,语音聊天、拍照识物、随手问事都靠它,体验最顺滑;DeepSeek 装着当顾问,遇到要动脑的问题——对比方案、理思路、解难题——开深度思考模式问它。 Kimi 在电脑上用,读长材料的活儿全是它的。 通义和 GLM 主要在干活场景里遇到:做表格时通义顺手,让 AI 自动跑流程时 GLM 和 DeepSeek 靠谱。 这个搭配逻辑很简单:一个全能的当默认,一个深度的当顾问,一个专业的管长文。三家全部免费,不存在成本问题。 你可以照抄,也可以按上面的四步法自己测。 真题一定要从你自己的活儿里挑——你要改的方案、你要读的报告、你要辅导的题。同一道题发给两三个模型,别改写、别加提示,看原始发挥。答非所问、编造细节、长文丢要求,犯一条扣一分。测完连用一周,不合适再换,反正免费,换模型的成本是零。 测的时候有个心态提醒:别拿“下五子棋”“写首藏头诗”这类段子题当考题。段子题测的是新鲜感,测不出你要用的能力。模型答段子答得再俏皮,跟你改方案改得好不好,半点关系没有。 另外,四步里最值钱的是第二步“同题开考”——变量只留一个,结论才作数。你拿不同的问法问不同的模型,测出来的不是模型差距,是你手抖。 五 最后说两句实在的 国产模型的水平差距,已经小到普通用户感知不出来的程度。 2024 年那时候,“哪家最强”是真问题,强弱之间隔着肉眼可见的鸿沟;到今天,第一梯队五家在绝大多数日常任务上的表现,差距远小于你换一种问法带来的波动。 你把提示词写清楚一点带来的提升,比换一个“更强的模型”大得多。 真正值得关注的变化是格局本身:国家队和大厂的模型追上来了,开源阵营(通义、DeepSeek)在全球打出了存在感,价格被打到了地板上。对我们用户来说,这是最好的时代——神仙打架,凡人受益,哪家涨价就换哪家,主动权在你手里。 所以别再问“哪个最好用”了。打开两三个 App,把你手头真实的活儿丢进去跑一圈,答案自然浮现。你自己的任务清单,比任何榜单都诚实。