ARTICLE · 1126274
手搓AI智能音箱全攻略:ESP32方案50元入门,树莓派方案完全本地跑
本期导读:市售智能音箱几百上千元,数据还要经过大厂服务器。但你可能不知道,一块几十块钱的ESP32开发板,就能做出一台能对话、能控制家电、数据不经过第三方服务器的AI音箱。
这篇文章给你两条手搓路径——一条50元入门,半天跑通;一条完全本地运行,隐私优先。从零件清单到烧录命令,每一步都有具体型号和操作步骤。
一、两条路径,两种玩法
对比维度 | ESP32 + 小智方案 | 树莓派+ ATHENA方案 |
主控板 | ESP32-S3(16MdB Flash + 8MB PSRAM) | Raspberry Pi 4(8GB) |
核心成本 | 约50-80元(开发板) | 约2000元(全套BOM) |
AI推理 | 云端接入(Qwen/DeepSeek/豆包,可换) | 完全本地运行(Whisper + 本地LLM + Piper) |
唤醒方式 | 本地离线唤醒(ESP-SR),不联网也能喊醒 | 本地唤醒词检测 |
隐私性 | 默认语音数据经过云端API(可自建服务器解决) | 数据完全不出本地 |
最适合 | 想低成本快速上手、一次跑通 | 追求数据隐私、愿意折腾 |
隐私提示先行:ESP32方案最大的特点是便宜、上手快,但默认固件会把你的语音数据发送到公网服务器进行识别和处理。如果你对隐私有要求,有两个选择:一是自建服务器(后文会讲具体操作),二是直接走树莓派ATHENA方案,所有处理都在本地完成。
ESP32方案总成本可控制在50-80元(不含3D打印外壳),社区教程非常完善。树莓派方案的参考BOM约275美元(约2000元),包括树莓派4 8GB(55美元)、6麦克风阵列(35美元)、定制PCB(25美元)、扬声器系统(45美元)、3D打印外壳(30美元)、LED环(8美元),可选显示屏另加35美元。
两条路径你都可以选。下面的操作以ESP32+小智为主线,树莓派方案的差异点单独标注。
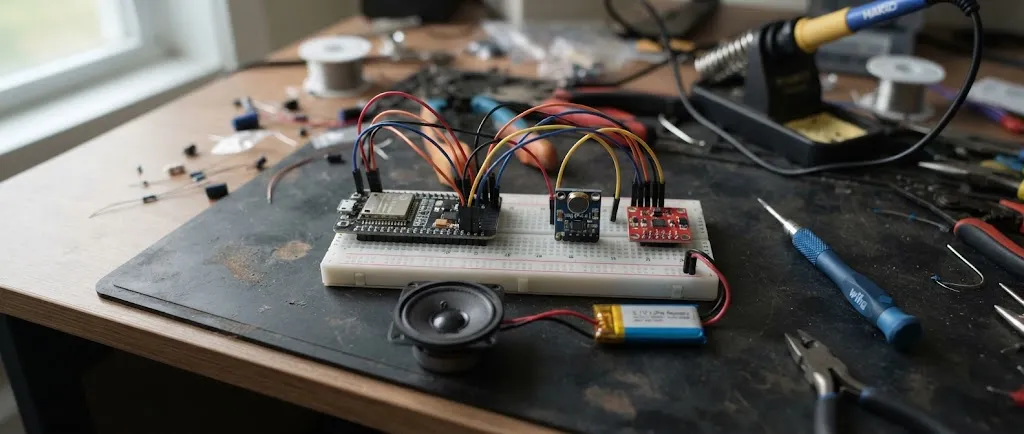
二、ESP32方案:50元手搓AI音箱完整操作2.1 准备阶段:买齐零件(总成本50-80元)
核心硬件清单:
组件 | 推荐型号 | 关键参数 | 参考价格 |
主控板 | ESP32-S3开发板 | 16MB Flash + 8MB PSRAM | 30-50元 |
麦克风 | INMP441 I2S数字麦克风 | 或双TDK ICS-43434 MEMS数字麦 | 5-15元 |
功放+扬声器 | MAX98357A I2S功放+ 3W 4Ω小喇叭 | D类功放,功耗低 | 10-15元 |
指示灯 | WS2812B RGB灯带 | 待机蓝、唤醒绿、对话紫、低电红 | 3-5元 |
电源 | 锂电池+ 充电模块 | BQ24250充电+ MAX2402稳压 | 10-20元 |
推荐买现成套件:如果不想逐个买零件,可以直接购买已集成好的开发板套件。乐鑫的EchoEar 喵伴套件已集成屏幕、麦克风、扬声器,适合快速上手。M5Stack 的AtomS3R + Atomic Echo Base 组合也很适合入门。
避坑提醒:ESP32-S3开发板务必选带PSRAM 的版本(8MB),推荐WROOM N16R8 模组,即16MB Flash 和8MB PSRAM 的配置。麦克风选I2S 数字麦克风,不要选模拟麦克风,I2S 接口的信噪比和抗干扰能力远优于模拟。
电路设计要点(来自实际复刻经验):INMP441 麦克风需要3.3V 偏置电压,需通过分压电阻提供稳定电压;MAX98357A 功放输出端需并联10μF 电容和0.1μF 瓷片电容,抑制高频噪声;PCB 布局时音频信号线需远离电源走线,采用差分对布局减少电磁干扰。
2.2烧录固件:新手推荐"免开发环境"方式
小智项目由虾哥开源,以MIT 许可证发布,允许任何人免费使用或用于商业用途。项目已支持70 多个开源硬件。
新手第一次操作,建议不要搭建开发环境,直接使用免开发环境烧录的固件。固件默认接入xiaozhi.me 官方服务器,个人用户注册账号可以免费使用Qwen 实时模型。
隐私提醒:使用官方服务器意味着你的语音数据会上传到第三方平台。如果你不想让语音数据经过外部服务器,跳到2.4 节看自建服务器的操作。
操作步骤:
Step 1 访问xiaozhi.me,注册账号。个人用户免费,可使用的模型包括Qwen 实时模型。
Step 2 在xiaozhi.me 控制台中,创建一个新设备,获取设备激活码。
Step 3 下载对应你开发板型号的固件文件(.bin 格式)。项目支持ESP32-C3、ESP32-S3、ESP32-P4 芯片平台。
Step 4 使用乐鑫官方的Flash Download Tool(Windows)或esptool.py(Mac/Linux)将固件烧录到开发板。开发环境推荐使用ESP-IDF v5.4.1,设置目标设备为esp32s3。
Step 5 烧录完成后,开发板会进入配网模式。连接开发板的WiFi 热点,在浏览器中填入你家Wi-Fi 的账号密码。
Step 6 设备重启后,默认唤醒词是"你好小智"(可自定义)。喊一声唤醒词,灯带从蓝色变为绿色,音箱回复"我在,有什么可以帮你的?"——你的手搓AI 音箱已经跑起来了。
2.3进阶:接入你喜欢的任何大模型
小智项目采用流式ASR + LLM + TTS 架构——语音输入,实时转文字,大模型处理,文字转语音,音频输出。LLM 层完全可替换。
接入DeepSeek:在xiaozhi.me 控制台的模型配置中,选择DeepSeek 作为LLM 后端。你需要填入DeepSeek 的API Key(从platform.deepseek.com 获取)。小智项目已内置对Qwen、DeepSeek、豆包等主流大模型的支持。
接入通义千问:选择Qwen 模型,填入DashScope API Key 即可。
接入GPT:需要自建服务器,参考xiaozhi-esp32-server 项目进行部署,支持WebSocket 和MQTT+UDP 两种通信协议。
2.4隐私优先:自建服务器,让语音数据不出门
如果你不想让语音数据经过xiaozhi.me 的服务器,可以自建后端服务。xiaozhi-esp32-server 项目提供了完整的开源服务端方案,支持Docker 一键部署。
部署条件:需要一台服务器(可以是你的电脑、NAS 或云服务器),建议配备8GB 以上显存的显卡用于语音模型推理。
操作步骤:
Step 1:下载一键部署脚本:
curl -L -o docker-setup.sh https://raw.githubusercontent.com/xinnan-tech/xiaozhi-esp32-server/main/docker-setup.sh
Step 2:赋予执行权限并运行:
chmod +x docker-setup.sh sudo ./docker-setup.sh
脚本会自动下载语音识别模型(约892MB)和配置文件。
Step 3:编辑data/.config.yaml文件,配置你的API 密钥。
Step 4:启动服务:
docker-compose up -d
Step 5:在ESP32 端,将固件配置中的服务器地址改为你的自建服务器地址。
自建服务器的优势:所有数据本地运行,不上传云端;可以自定义角色、音色克隆、接入知识库,甚至打造智能客服。服务端采用模块化设计,asr-server 负责语音识别,tts-server 负责语音合成,main-server 协调全流程。
2.5它能做什么:三个已验证的真实场景
场景一:语音对话与控制家电。喊唤醒词,音箱亮绿灯,说"帮我打开客厅的灯",通过MCP 协议控制智能家居设备。小智项目支持通过设备端MCP 实现设备控制(音量、灯光、电机、GPIO 等),通过云端MCP 扩展大模型能力。
场景二:声纹识别,认出是谁在说话。小智支持声纹识别功能,能识别当前说话人的身份。你可以设置"只有我的声音才能控制家电"或"不同家庭成员获得不同权限"。
场景三:短期记忆与自定义角色。支持对每轮对话进行总结,保持对话连贯性;支持提示词和音色设置,你可以自定义AI 的性格和声音。
2.6商用提醒:唤醒词的商标风险
"小智"作为唤醒词,目前已有多家公司申请了相关商标,主要集中在第9 类(计算机软件、智能硬件等类别)。如果你只是个人DIY 使用,没有任何问题。但如果你打算批量生产、销售基于此方案的产品,建议:
一 更换自定义唤醒词(小智项目支持自定义唤醒词)
二 在产品命名上避免使用"小智"二字
三 商业产品发布前咨询专业商标代理机构
三、树莓派方案:完全本地运行,隐私优先
如果你对数据隐私有极高要求,不想让语音数据经过任何云端API,树莓派+ATHENA 方案是更好的选择。
3.1核心架构
ATHENA是一个开源AI 智能语音助手音箱项目,目标是超越Amazon Echo 和Google Home,提供更高的隐私性、可定制性和智能化水平。它的核心理念是隐私优先,所有语音处理在本地完成,云端服务需要用户明确同意才启用。
技术栈:
语音识别:Whisper(本地运行)
智能处理:本地LLM(如TinyLLaMA)
语音合成:Piper(自然语音合成)
开发语言:Python 3.10+
框架:PyTorch、Transformers、FastAPI
3.2硬件清单(BOM总成本约275美元)
组件 | 规格 | 参考价格 |
树莓派4(8GB) | 主处理单元 | 55美元 |
ReSpeaker 6麦克风阵列 | 高质量语音采集 | 35美元 |
定制PCB | 音频放大+电源管理 | 25美元 |
扬声器系统 | 中音驱动+高音 | 45美元 |
3D打印外壳 | 声学优化 | 30美元 |
NeoPixel LED环 | 状态视觉反馈 | 8美元 |
可选显示屏 | 信息面板 | 35美元 |
以上数据来自ATHENA 项目官方项目文档。
3.3操作步骤
Step 1 安装树莓派系统。下载Raspberry Pi OS(64 位),烧录到SD 卡。安装完成后,通过SSH 或直接连接显示器进入系统。
Step 2 克隆ATHENA 项目。从GitHub 下载ATHENA 的代码仓库到树莓派本地(https://github.com/Kuberwastaken/ATHENA)。
Step 3 安装Python 依赖。项目使用Python 3.10+,需要安装PyTorch、Transformers、FastAPI、PyAudio 等依赖。
Step 4 下载本地模型。需要下载Whisper 语音识别模型(建议base 或small 版本)、TinyLLaMA(GGUF 格式)和Piper TTS 模型。
Piper TTS许可提醒:Piper TTS 的引擎本身从2025 年起采用GPL-3.0-or-later 许可证。但更关键的是,每个语音模型的许可证各不相同,取决于训练数据来源。部分模型是CC BY-NC 4.0(禁止商业使用),部分模型是MIT 或Apache 2.0(允许商用)。如果你只是个人使用,没有限制;如果用于商业目的,必须逐一检查所用语音模型的许可证。
Step 5 连接硬件。将ReSpeaker 6 麦克风阵列通过GPIO 连接到树莓派,将扬声器连接到音频输出接口。
Step 6 启动并测试。运行主程序,喊唤醒词"Athena",观察LED 环的颜色变化,测试语音对话功能。
项目状态提醒:ATHENA 项目的Skills 框架、硬件PCB 设计和3D 外壳建模仍在进行中。如果你想快速跑通,建议先用ESP32 方案,等ATHENA 更成熟后再迁移。
四、如果你想用OpenAI Realtime API 做实时语音
如果你希望音箱能像打电话一样实时对话,而不是"说完等回答",可以使用OpenAI Realtime API 方案。
硬件清单极其精简:ESP32-S3 开发板+ INMP441 麦克风+ MAX98357A 功放+ 3W 4Ω 喇叭+ 轻触按钮+ RGB LED。
核心操作步骤:
Step 1:克隆ElatoAI 项目:
git clone https://github.com/akdeb/ElatoAI.git cd ElatoAI
Step 2:在frontend-nextjs目录中创建.env.local文件,填入OpenAI API Key 和Supabase 密钥。
Step 3:启动Supabase 本地服务:supabase start
Step 4:启动前端和服务器:
cd frontend-nextjs npm install npm run dev
Step 5:烧录ESP32 固件。在Config.cpp中设置你的本地IP 地址,编译并上传固件。
Step 6:按下按钮开始说话,松开按钮结束。OpenAI Realtime API 会实时处理语音并返回语音响应。
隐私提醒:此方案会将语音数据实时发送到OpenAI 服务器处理。
五、三条路径怎么选
你的需求 | 推荐路径 | 成本 | 耗时 |
想最快跑通,成本最低 | ESP32 + 小智 | 50-80元 | 半天 |
完全本地运行,数据不出门 | 树莓派+ ATHENA | 约2000元 | 2-3天 |
像打电话一样实时对话 | ESP32 + ElatoAI | 约100元+ API费用 | 1天 |
想控制智能家居 | ESP32 + 小智(内置MCP协议) | 50-80元 | 半天 |
商用产品原型开发 | ESP32 + 小智(MIT协议,可商用) | 50-80元 | 1天 |
如果你只能选一个:从ESP32 + 小智开始。成本最低、社区最活跃、文档最完整、支持70 多个开发板。半天跑通之后,再决定是否升级到树莓派方案或自建服务器。
六、开源许可与合规摘要
组件/项目 | 许可证 | 个人使用 | 商业使用 |
小智(xiaozhi-esp32) | MIT | 自由使用 | 允许商用 |
ATHENA | 开源硬件+软件 | 自由使用 | 允许 |
Whisper | MIT | 自由使用 | 允许商用 |
Piper TTS引擎 | GPL-3.0 | 自由使用 | 允许(遵循GPL条款) |
Piper TTS语音模型 | 各模型不同 | 自由使用 | 需逐一检查(部分为CC BY-NC,禁止商用) |
"小智"唤醒词 | 已有多家公司注册商标 | 个人无风险 | 商用建议更换唤醒词 |
ESP32芯片 | Apache 2.0(ESP-IDF) | 自由使用 | 允许 |
七、你现在就可以做的三件事
第一件(今天,15分钟):打开xiaozhi.me,注册账号,查看你手头是否有ESP32-S3 开发板。如果有,下载对应固件直接烧录测试。如果没有,下单一块带PSRAM 的ESP32-S3 开发板(推荐WROOM N16R8 模组,约40 元),同时购买INMP441 麦克风和MAX98357A 功放模块。
第二件(本周内,2小时):零件到齐后,按面包板接线图连接麦克风、功放和扬声器,烧录小智固件,完成配网和首次唤醒测试。第一次测试时,先从最简单的功能开始——"你好小智"唤醒,问一个简单问题,听回答。
第三件(周末,半天):如果ESP32 方案跑通了,尝试自建服务器(按第2.4 节的Docker 一键部署)或接入你喜欢的模型(DeepSeek/通义千问),测试不同模型的对话质量。然后考虑是否要用3D 打印外壳把零件组装成型。
关注「AI趋势实验室」,每周两期,帮你把AI 用出真实的结果。
如果觉得这份手搓指南有用,请转发给那个喜欢折腾硬件、想做一个"自己的AI音箱"的朋友。