ARTICLE · 1148581
AI 是怎么控制 Virtuoso 的?从 Agent 到 SKILL Bridge 的完整过程
AI 控制 Virtuoso,难的从来不是「让大模型生成代码」,而是给它搭一条可执行、可检查、可追溯的操作链路——因为在这条链路上,SKILL 返回成功,绝不等于电路正确。
—— 远山 RFICer
摘要:在 RF Design Agent 项目里,这条链路已经跑通了完整的 LNA 设计流程:tsmc 工艺,RFICer / lna_test / schematic,Virtuoso 6.1.8-64b + Spectre 18.1.0.077。最终在 2.400 GHz 上做到 S22 = −59.66 dB / S11 = −23.22 dB / S21 = 28.10 dB / NF = 3.16 dB。本文所有代码、输出与报错,均来自这套真实环境。
很多人用 AI 做芯片设计,第一反应是让大模型生成一段 Python,或者解释一张电路图。但如果想让 AI 真正操作 Cadence Virtuoso,事情完全不一样。
AI 不仅要知道想做什么,还必须通过一个真实、可执行、可检查的接口,把动作送进 EDA 环境,再把结果读回来。
在 RF Design Agent 里,这条链路是:
Agent → Python → Bridge → SKILL → Virtuoso → Spectre → 结果回读
这一期拆解整条链路,并重点讲一件最容易被忽略的事:SKILL 返回成功,不等于电路正确。
WHY
为什么不能只让 AI 生成代码?
假设给 AI 一条指令:
「在 Virtuoso 里创建一个新 Cell,放一个 NMOS。」
大模型能生成代码,也能说出该调哪些 Virtuoso 功能。但代码生成 ≠ 电路已创建。
真跑起来要回答的是这些:
| 电路真变了吗? | |
| 指标达标了吗? |
前四层是“通信成功”,后两层才是“工程成功”。只做前四层,AI 永远只能给建议,形不成闭环。
所以我把系统拆成职责明确的模块:
Agent 决定做什么
Python 组织请求、校验参数、管理流程
Bridge 跨进程 / 跨机传输
SKILL Virtuoso 内部的真实执行
回读 网表 + 仿真结果,验证到底成没成
TOPOLOGY
真实拓扑:先搞清楚“谁挂在谁上面”
这是最容易被想错、也是排查时的第一依据。我的实际部署:
Windows host — vmrun + VMware Tools(进程注入 / 文件互拷)
↓
Linux VM(CentOS 7) — X server :0(gdm 自动登录)
↓
Virtuoso(CIW) — ~/.cdsinit → virtuoso_setup.il → ramic_bridge.il
↓ ipcBeginProcess(…) 就在这里把 daemon 拉起来
bridge daemon(TCP 65156) ← guest 内的 Python 客户端(loopback 连接)
↓
Spectre(独立进程)
三个必须刻进脑子的事实:
1. daemon 不是 systemd 起的,是 Virtuoso 自己起的。所以“VM 重启后连不上”的根因永远是Virtuoso 没起来,不是 daemon 配置坏了。
2. host 到 guest 没有 SSH。我这台的 VM 网卡是 DOWN 的,唯一通道是 vmrun + VMware Tools。
3. 客户端 Python 跑在 guest 内,不需要端口转发,最省事。
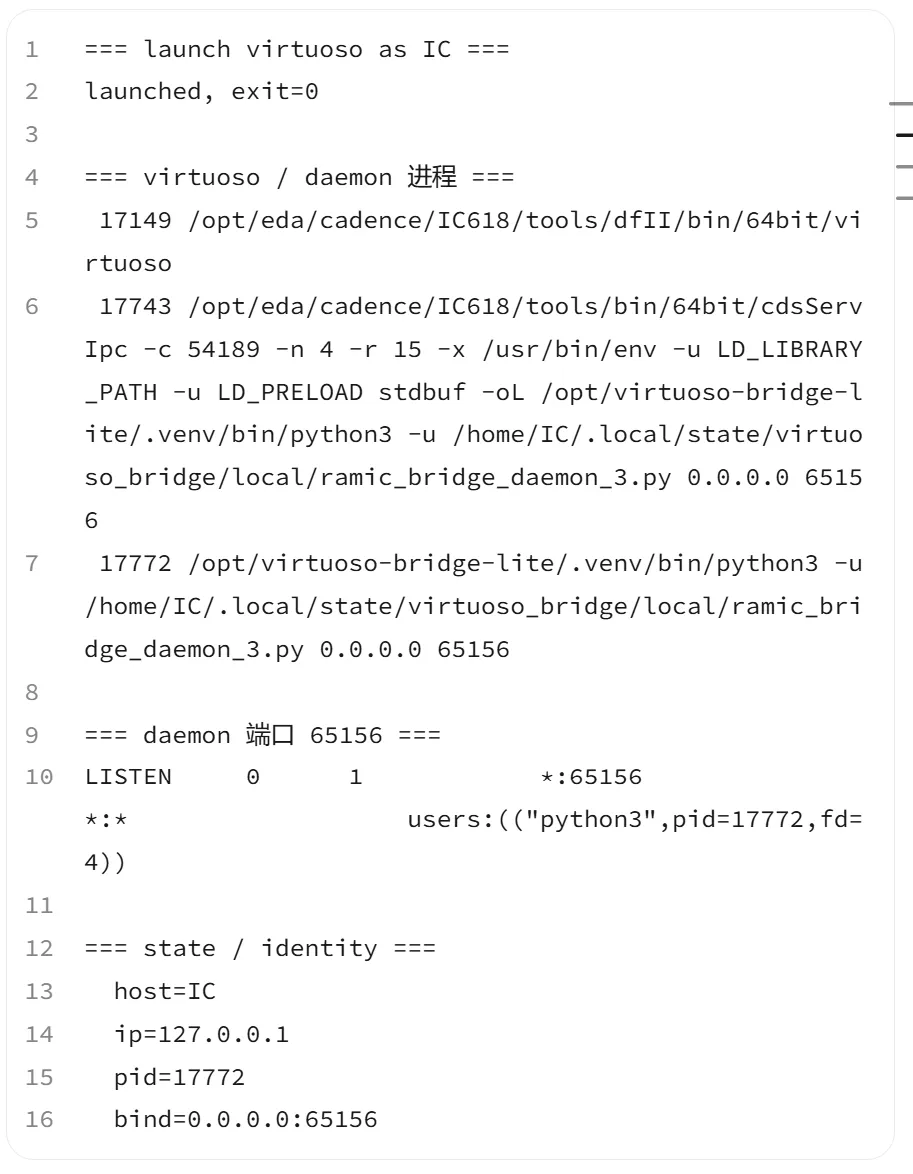
拉起后 ss -ltnp | grep 65156 的监听行,配合 ps -eo pid,args 里 virtuoso 与 ramic_bridge_daemon 的父子进程关系。
AGENT
Agent:确定性优先,不要让 LLM 自由发挥
Agent 是任务规划者。它把自然语言转成明确操作:
1. 打开目标 cellview
2. 读取器件当前参数
3. 计算 / 决策新的参数
4. 写回参数
5. 保存 → 导出网表 → 静态校验
6. 跑仿真 → 读结果 → 判定
关键工程原则:不要让大模型每一步临时发挥。
我踩过最狠的一次:为了控制 MOS 总宽,我按直觉写 nf 参数。结果网表里器件纹丝不动。后来做了 6 点对照实验才搞清楚——
fingers 才生效,nf 是脱钩的陈旧显示字段。网表的 nf 和总宽只由 fingers 决定:w_total = w × fingers。
这类 PDK 语义不在大模型的训练数据里,也无法靠推理得出。正确做法是:为常见 EDA 操作定义固定接口和参数结构,Agent 按接口组织任务,而不是每次让模型猜该写哪个字段。
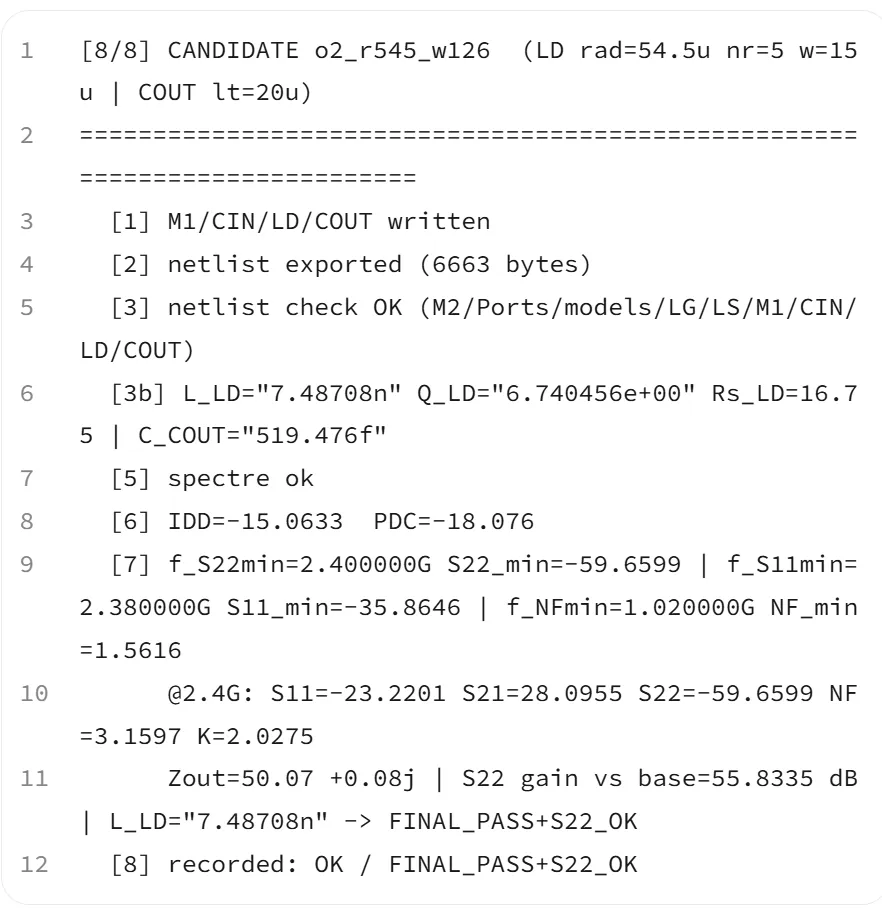
candidate_search.py 里一个候选点的真实执行日志(含 CANDIDATE / [2] / [3b] / @2.4G 各阶段输出)。
PYTHON
Python:协调层,同时也是校验层
Python 负责:统一接口、参数校验、调用 Bridge、等结果、记日志、调度仿真。
真实调用只有两行:
from virtuoso_bridge import VirtuosoClient
from virtuoso_bridge.virtuoso.schematic.params import _run_batched_param_update
client = VirtuosoClient.local(port=65156)
# 写参数
_run_batched_param_update(client, "RFICer", "lna_test", "M1",
{"w": "5.5u", "fingers": "20", "l": "60n", "m": "1"})
# 读派生值
r = client.execute_skill('...SKILL 表达式...', timeout=60)
print(r.output)
但 Python 层真正值钱的不是“发请求”,而是“发之前校验、发之后复核”。
我的引擎在每个候选点都做网表静态校验——把导出网表逐行比对,确认参数没被 PDK 静默钳位:
LD : LD (net13 net31 0) spiral_sym_mu_z w=15.0u nr=5 rad=54.5u lay=9 spacing=2u gdis=50u m=1
COUT : COUT (net8 net13 0) mimcap_woum_sin_rf lt=20u wt=12.6u lay=7 m=1 mimflag=3
M1 : M1 (net1 net19 net16 0) nch l=60n w=110.00000u m=1 nf=20
errors: NONE
注意两个细节,都是真实踩出来的:
w=15.0u 而不是 15u:PDK 会把 15u 规范化成 15.0u。所以指纹校验必须做数值比对,字符串比对会误报。
w=110.00000u:网表里打的是总宽。我一度把 M2 的 w 当单指宽写 40u,结果总宽变成 40u × 20 = 800 µm,器件直接被写坏。
Python 层应该是确定性的:建库、设参、查仿真状态这类操作用固定规则,不要每次让模型重新猜步骤。
BRIDGE
Bridge:跨进程、跨机器的传输层
Bridge 解决“外部控制逻辑怎么把请求送进 Virtuoso 进程”。
它的一端是 Python 客户端,另一端是跑在 Virtuoso 里的 SKILL daemon。~/.cdsinit 里的钩子长这样(真实内容):
; virtuoso_setup.il
setShellEnvVar("RB_DAEMON_PATH"
"/home/IC/.local/state/virtuoso_bridge/local/ramic_bridge_daemon_3.py")
setShellEnvVar("RB_PYTHON_PATH" "/opt/virtuoso-bridge-lite/.venv/bin/python3")
setShellEnvVar("RB_PORT" "65156")
load("/home/IC/.local/state/virtuoso_bridge/local/ramic_bridge.il")
ramic_bridge.il 用 ipcBeginProcess() 把 daemon 拉起来:
RBIpc = ipcBeginProcess(sprintf(nil
"/usr/bin/env -u LD_LIBRARY_PATH -u LD_PRELOAD stdbuf -oL %s -u %L %L %L"
RBPython RBDPath host RBPort)
"" 'RBIpcDataHandler 'RBIpcErrHandler 'RBIpcFinishHandler logpath)
几个部署时必须注意的点:
端口是 host 全局的,靠 HMAC token 鉴权(token 在 ~/.virtuoso-bridge/bridge_token,0600)。客户端和 daemon 必须读到同一个文件。
最常见的报错是 token mismatch:根因是 Python 用 root 身份跑,去找 /root/.virtuoso-bridge/,而 daemon 是 IC 身份起的。解法就一句:任何 guest Python 都必须 export HOME=/home/IC。
协议 / 端口 / 启动方式取决于部署,不要照搬。我这里是版本 0.8.0、端口 65156、local 模式;换机器要重新确认。
SKILL
SKILL:真正的执行者
SKILL 负责 Virtuoso 内部动作:打开 cellview、读写 CDF、创建 / 修改器件。读一个器件参数的真实写法:
let((cv i cdf p)
cv = dbOpenCellViewByType("RFICer" "lna_test" "schematic" "schematic" "a")
i = car(setof(x cv~>instances x~>name == "M1"))
cdf = cdfGetInstCDF(i)
p = car(setof(q cdf~>parameters q~>name == "w"))
if(p then p~>value else "")
)
返回:"5.5u"。
到这一步,五个角色的分工就清楚了:
KEY LESSON
最关键的一节:SKILL 返回成功 ≠ 电路正确
这是整条链路上最贵的一课。我用三个真实案例说明。
案例 1:派生值可以是陈旧的(差 5.3 倍)
我读 LD 电感的 L_single,SKILL 正常返回:2.28707n。但我用实测 Zout 反算,这个电感应该是 ~12 nH。
原因:派生值是“上次计算留下的缓存”,不是当前几何参数的实时重算。只有把参数重新写回一次,派生值才会刷新。
| 5.3× | |||
| 3.9× |
(上表是 rad=75u / nr=5 时的对照;最终设计改到 rad=54.5u,L 随之变为 7.487 nH。数值随几何变化,但“陈旧值不可信”这个结论与几何无关。)
如果我用陈旧值指导设计,整个输出匹配会算错方向。教训:SKILL 返回值也要交叉验证,不能因为“有值”就采信。
案例 2:l 和 fingers 不能同批写
把 l 与 fingers 放在同一批参数里写,l 会被 PDK 静默钳到 130n(目标是 60n)。必须分两批:先 {w, fingers, m},再单独写 {l}。
这类行为不报错、不警告,只是结果不对。
案例 3:仿真“成功”但结果不可信
结果 CSV 的行数比候选点多——36 个点跑出 74 行。根因:launcher 没清上一轮的文件,引擎是 append 模式,历史行混进来了。
另一个:oppoint 里读到的 IDD/PDC 单位已经是 mA/mW,我一度再乘 1000,得到 −12650 mA 这种荒谬值。(自检办法:PDC / IDD 应该等于 VDD。)
所以系统必须区分三种“成功”:
| test_connection() | |
| execute_skill | |
| 工程成功 | 网表参数正确 + 仿真结果达标 |
前两层是手段,第三层才是目的。
CHECKLIST
怎么判断链路真的通了?逐层检查
我不看“某个程序有没有启动”,而是逐层查:
| [vm] VMware Tools 就绪 | ||
| virtuoso pid=17149 | ||
| *:65156 | ||
| 连接 127.0.0.1:65156 成功 | ||
| virtuoso 6.1.8-64b | ||
| RFICer/lna_test/schematic | ||
| CDF M1.w = "5.5u" | ||
| sub-version 18.1.0.077 | ||
写成脚本就是 8 项自动化检查,一次跑完给 ALL_GREEN:
[OK] 1. import virtuoso_bridge
[OK] 2. VirtuosoClient.local + test_connection
[OK] 3. execute_skill(getVersion)
[OK] 4. dbOpenCellViewByType
[OK] 5. 列举原理图实例(17 个)
[OK] 6. 读取 CDF 参数(M1.w = "5.5u")
[OK] 7. Spectre 二进制可用
[OK] 8. .env 关键项完整
结果:8/8 通过 ALL_GREEN
把这个做成每次开工的例行动作。跳过它直接跑引擎,会浪费一整轮仿真时间。
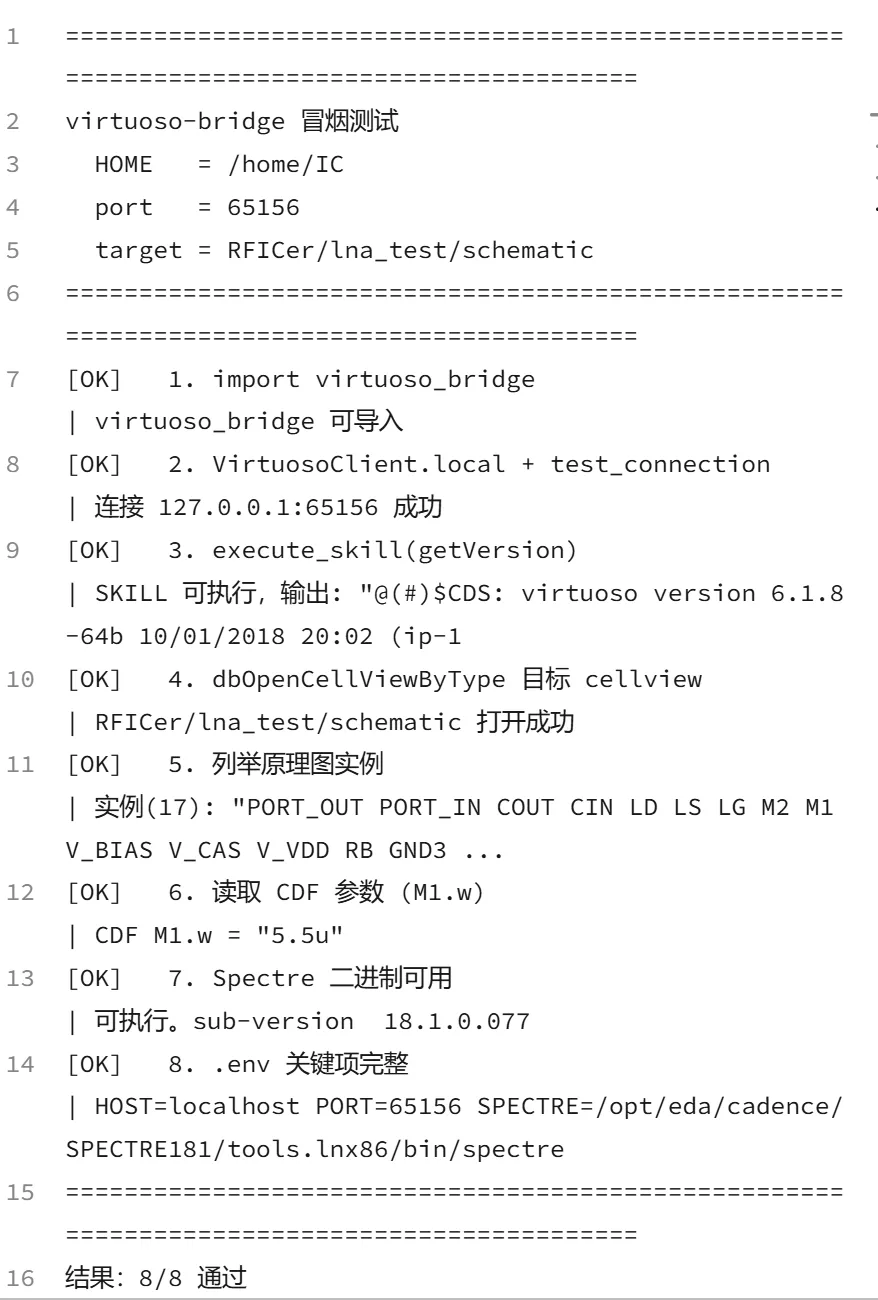
bridge_smoke.py 的完整终端输出。
LAYERS
为什么要拆这么多层?
如果把所有功能塞进一个大脚本,早期跑几个例子很快,但一旦复杂度上来,问题根本没法定位。
拆开之后,出问题能立刻判断是哪一类:
| 设计本身 |
这也为后面的自动化打下了基础。在这套链路上,我已经跑完:
Phase 3C:M1 宽度 × CIN 扫描,36 + 6 个候选点
Phase 3D:输出匹配优化,51 个候选点
结果:S22 从 −3.83 dB 优化到 −59.66 dB(+55.83 dB),且 S11 / S21 / K 同时改善,NF 与功耗基本不变
这些不是“AI 生成了一版设计”,而是AI 在真实 EDA 环境里跑出来的仿真结果。
THE END
本期小结
AI 控制 Virtuoso 的关键,不是让大模型“知道”Virtuoso,而是给它建立一条可执行、可检查、可追溯的操作链路。
三个要点:
1. 分层:Agent / Python / Bridge / SKILL / 回读,各司其职,故障可定位。
2. 确定性优先:PDK 语义不在模型里(fingers vs nf、派生值陈旧、参数被钳位),必须用固定接口和交叉验证兜住,不要让模型猜。
3. 验证要到底:通信成功 ≠ SKILL 成功 ≠ 电路正确。只有网表参数正确 + 仿真指标达标,才算闭环。
下一期:手把手搭建环境——Windows 上的 Agent 怎么连 Linux 虚拟机里的 Virtuoso。
我是远山(RFICer),射频微波芯片设计从业者,学习经典理论,分享所见所闻。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。