ARTICLE · 1237299
Claude 用 AI 给软件写证明:它证明了什么,又没证明什么?
Claude 用 AI 给软件写证明:它证明了什么,又没证明什么?
一条 AI 安全新闻里,最容易被标题带偏的,往往是“证明”两个字。
Anthropic 10 月 22 日公布了一项与形式化验证团队 Theorem 合作的研究:Claude 为 123 个开源库的 239 个测试入口生成了机器可检查的证明,累计约 1.8 亿行 Rocq 证明代码。团队称,尝试证明的过程中还发现并修复了数百个缺陷。
听起来像是 AI 已经给大量软件盖上了“安全认证”。其实没有。它证明的是一组边界明确、条件严格的性质。看懂边界,比记住 1.8 亿这个数字更重要。
先弄清:它到底证明了什么?
研究团队从 Google 的 OSS-Fuzz 项目中选择已有的模糊测试入口。模糊测试会自动生成很多输入,喂给程序,观察有没有崩溃。它很擅长发现具体反例,但再多次测试也只是试过一部分输入。
这次的做法是把测试目标改写成可检查的数学命题:在约定的运行模型下,对于小于 64MB 的输入,这个测试入口不会触发崩溃、内存安全错误或断言失败。Claude 负责生成证明,Rocq 的检查器负责核验证明是否符合命题。
Anthropic 原文也明确写出了这项结论依赖的输入上限和运行条件:
原文截图:研究范围
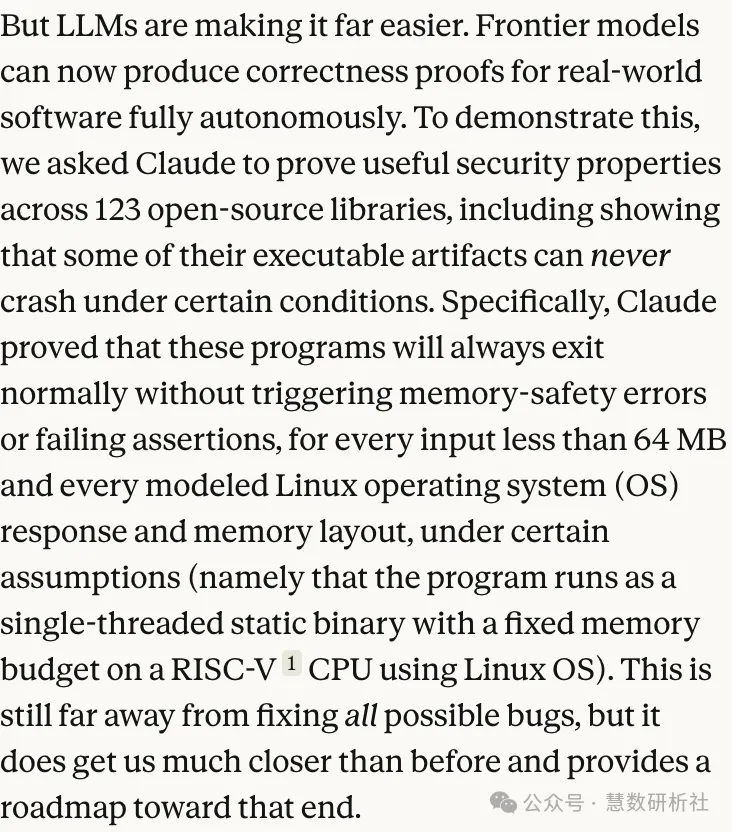
截取自 Anthropic《LLMs are making formal software verification feasible at a much larger scale》,2026-10-22。来源:https://www.anthropic.com/research/formal-verification
可以把它想成两种不同的“找错方式”:
模糊测试:不断抽样敲门,找到一扇会出问题的门就报错。 形式化证明:先写清楚要保证什么,再让检查器验证所有符合模型的情况。
这里的关键角色不是“AI 自己说证明了”,而是独立的证明检查器可以检查它交出的证明。模型负责探索和写出形式化推导;最终是否通过,由检查器按规约判定。
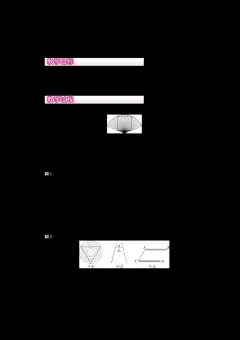
这条验证链路
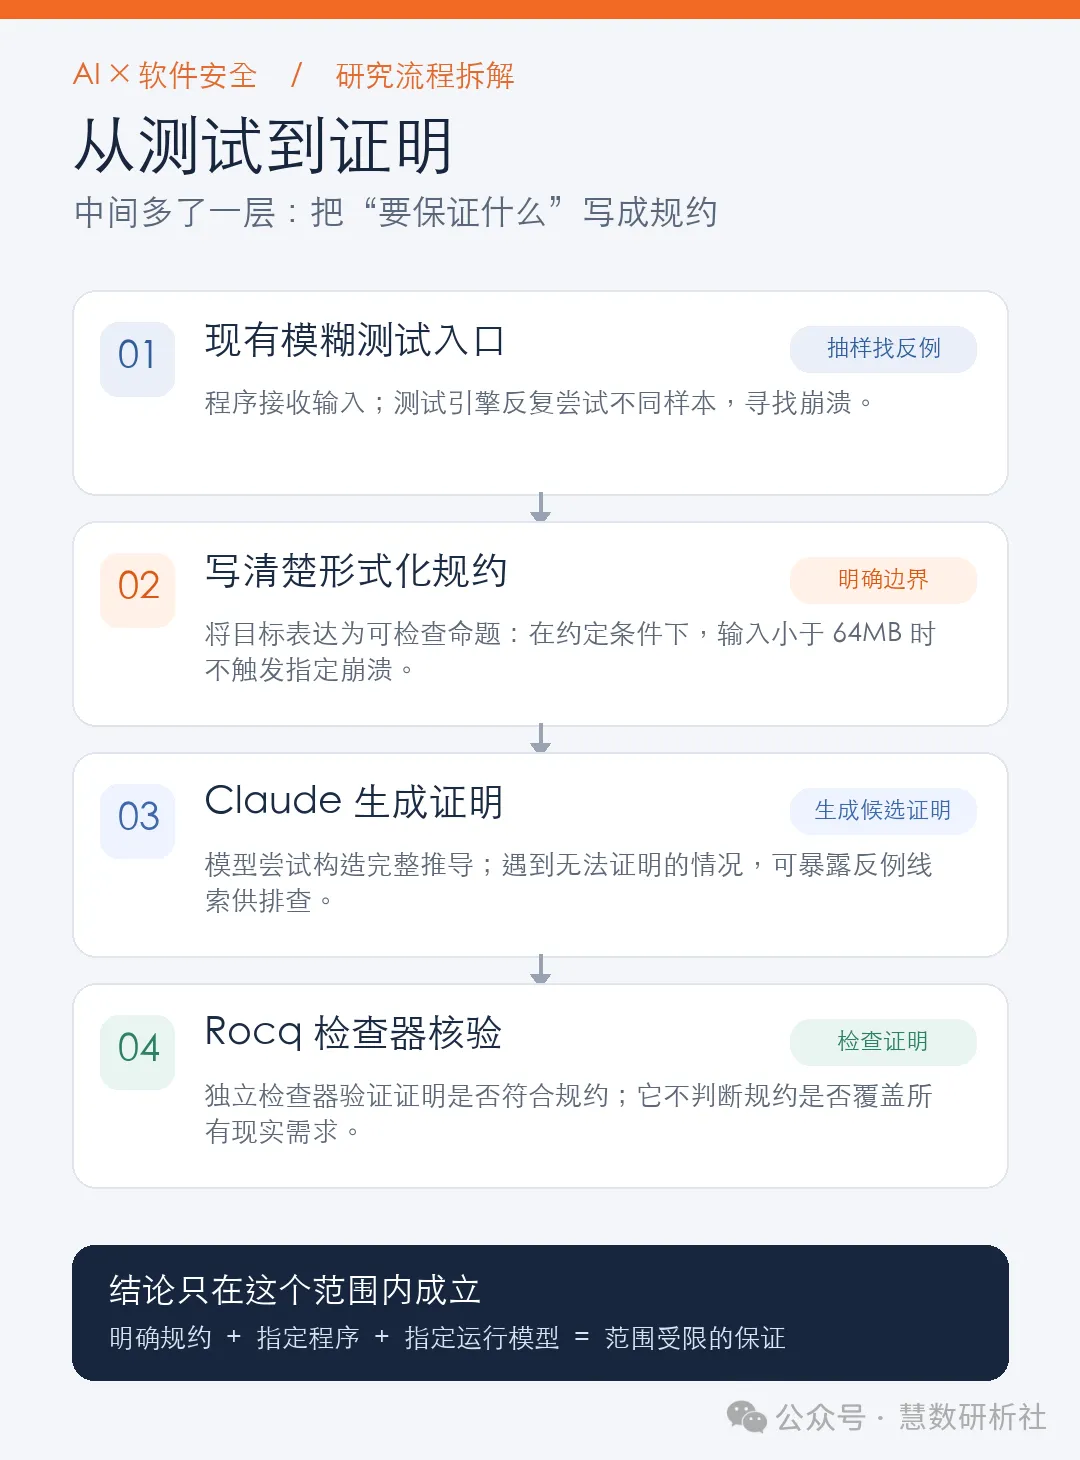
从现有模糊测试入口,到明确规约、Claude 生成证明、Rocq 检查器核验,最终得到有适用边界的保证。
下面这张流程图把“模型做什么、检查器做什么、最终保证到哪里”为你拆开了。
为什么证明过程中会找到测试没抓到的缺陷?
测试通常要限制输入大小和运行时间,也会受覆盖路径影响。研究团队举例称,有一个解压相关缺陷需要约 20MB、且结构很特殊的输入,才会触发越界写入;还有图像解码器中的一个问题,需要接近 64MB 的输入和大量内存。
如果常规模糊测试的输入上限较小,或很难走到那条特殊路径,就可能一直遇不到。形式化证明尝试覆盖规约里的全部输入和路径;当程序无法满足命题时,失败的证明过程会给出可追查的反例线索。研究方称,他们因此发现并修复了数百个缺陷。
这并不代表“证明比测试永远更好”。测试更便宜、适用面更广,能处理很多难以形式化的真实行为;形式化验证则能对写清楚的性质给出更强的保证。工程上更合理的方向,是让测试、静态分析和形式化验证各自处理擅长的问题。
这不是“软件没漏洞”的证明
Anthropic 在研究中也明确写到:形式化验证不等于无漏洞。原因至少有三层:
原文截图:形式化验证不等于无漏洞
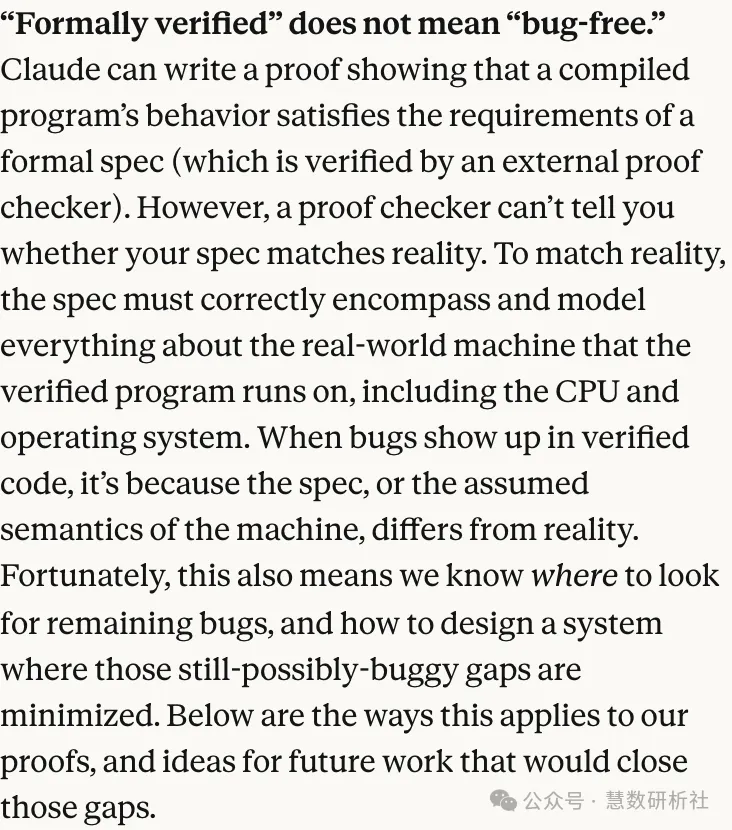
截取自 Anthropic 原始研究的“Limitations”部分,2026-10-22。来源:https://www.anthropic.com/research/formal-verification
1. 证明只覆盖写进规约的性质
这次重点是特定测试入口上的“不崩溃”等性质。它没有证明整个库的每个功能都符合人们期望,也不能自动排除规约之外的逻辑错误。若“要证明什么”写得不完整,检查器也不会替人补上遗漏的目标。
2. 证明依赖对机器环境的建模
主要这批结果针对单线程、静态链接的 RISC-V Linux 程序,并依赖相应的处理器和操作系统语义模型。现实部署常见的环境还包括 x86、ARM、动态链接和不同运行配置。模型覆盖不到的差异,仍然需要额外验证。
3. 入口点不等于整个软件
一个库可能有许多入口和调用方式。这次验证了 239 个测试入口,不能据此说 123 个库的所有代码、所有调用组合和所有部署环境都已证明安全。调用方误用库、尚未覆盖的代码路径,也仍可能出问题。
研究结果能说明什么,不能直接说明什么
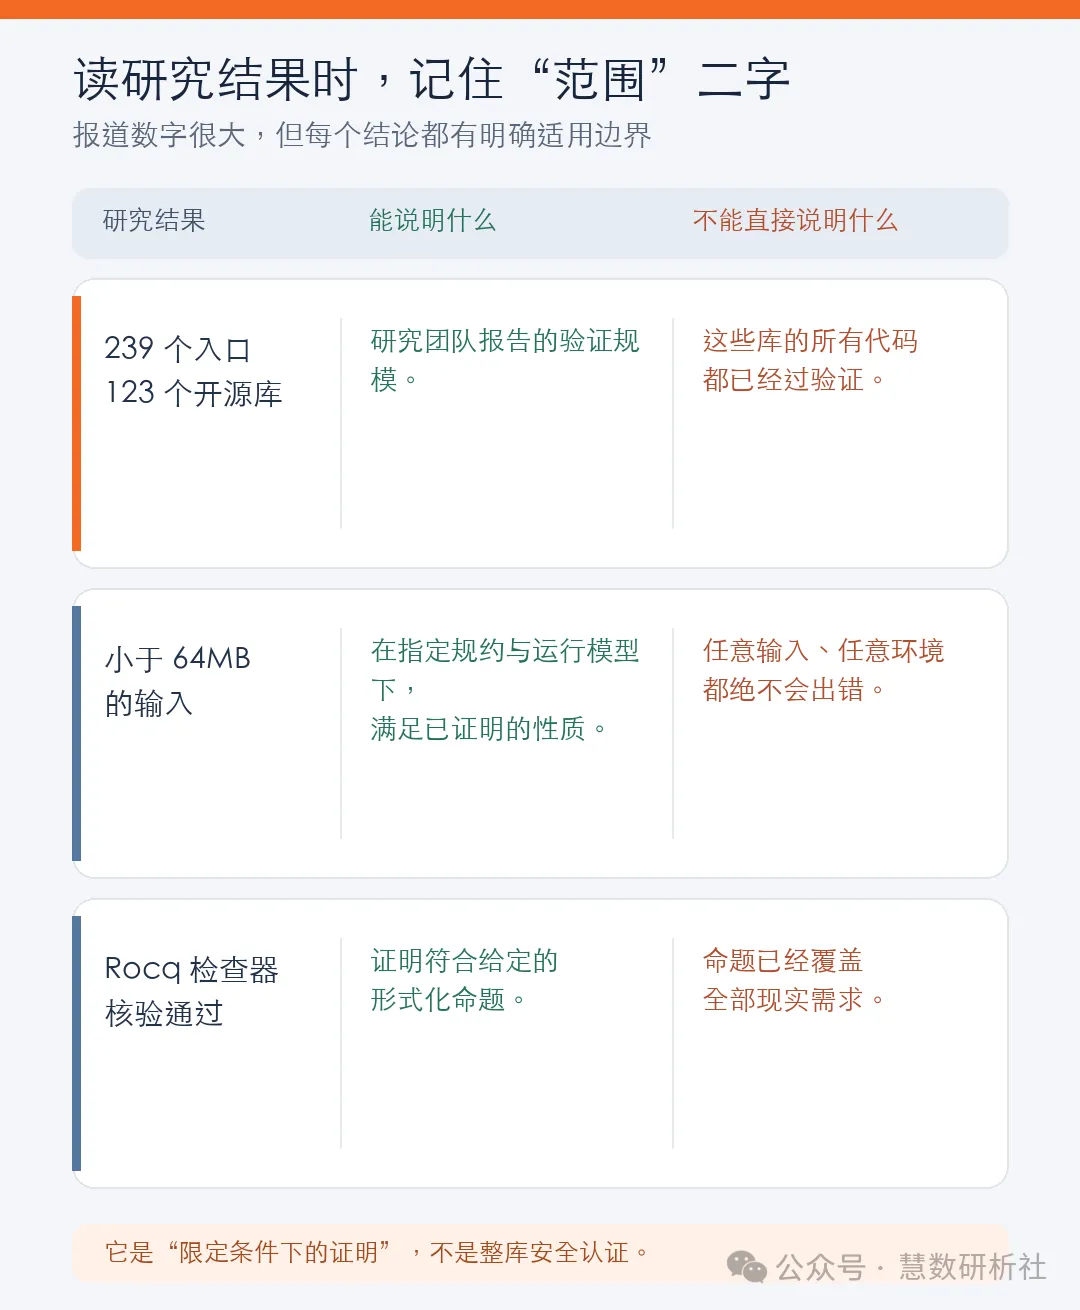
研究规模、输入条件和证明检查分别说明什么,以及不能据此推出什么。
研究规模和证明结果都需要放回适用范围里理解。下面这张对照图把三条最重要的边界列出来。
普通开发者该关注的变化
这项工作的意义不只是“AI 能写很多证明代码”。更值得关注的是,模型开始把过去昂贵、依赖少数专家的形式化验证流程,推向更多真实软件项目。研究团队还公开了一部分证明和相关语义模型,供外部检查与复用;公开子集并不等于完整研究结果全部开放。
但离“把任意仓库交给 AI,然后获得安全证书”还有距离。规约怎么定、补丁是否保持了原本行为、模型是否准确描述硬件和操作系统、验证环境是否接近真实部署,这些都需要工程师负责。
对日常使用 AI 编程工具的人,可以记住一个简单判断:AI 找到漏洞,是线索;AI 写出证明,是候选;独立检查器核验某条明确规约,才是范围受限的保证。 每次看到“AI 证明软件安全”,都可以追问三件事:证明了哪个性质?在哪种环境里?覆盖了哪些入口?
这三个问题,比“用了多少亿行证明代码”更能判断结果到底有多大用处。
资料来源
Anthropic 原始研究(2026-10-22):https://www.anthropic.com/research/formal-verification Anthropic 研究附录:https://www-cdn.anthropic.com/files/4zrzovbb/website/6867eadf760258fa8b42a504600cd3c036d16358.pdf Theorem 已公开的证明集合:https://github.com/theorem-labs/oss-verify-proofs
注:本文按研究方公开资料整理,未对整套实验进行独立复现。研究中的数量、案例及效果均以 Anthropic 的公开报告为依据。