ARTICLE · 1332585
商汤9B新模型竟反杀27B?扒开底层源码,我们发现了“原地套圈”的秘密
10月31日凌晨,硬件博主 GooGZ AI 将一个刚刚开源的 9B 模型,塞进了自己那张消费级的 RTX 3080 显卡里。
按照纸面宣传,这应该是一场降维打击。前一天,商汤科技(SenseTime)突然开源了多模态模型 SenseNova-Loop-9B-Preview。官方直接甩出一张极具挑衅意味的成绩单:仅凭 90 亿(9B)参数,它在多个办公与智能体基准测试中,硬生生反杀了体量足足是它三倍的 Qwen3.5-27B。
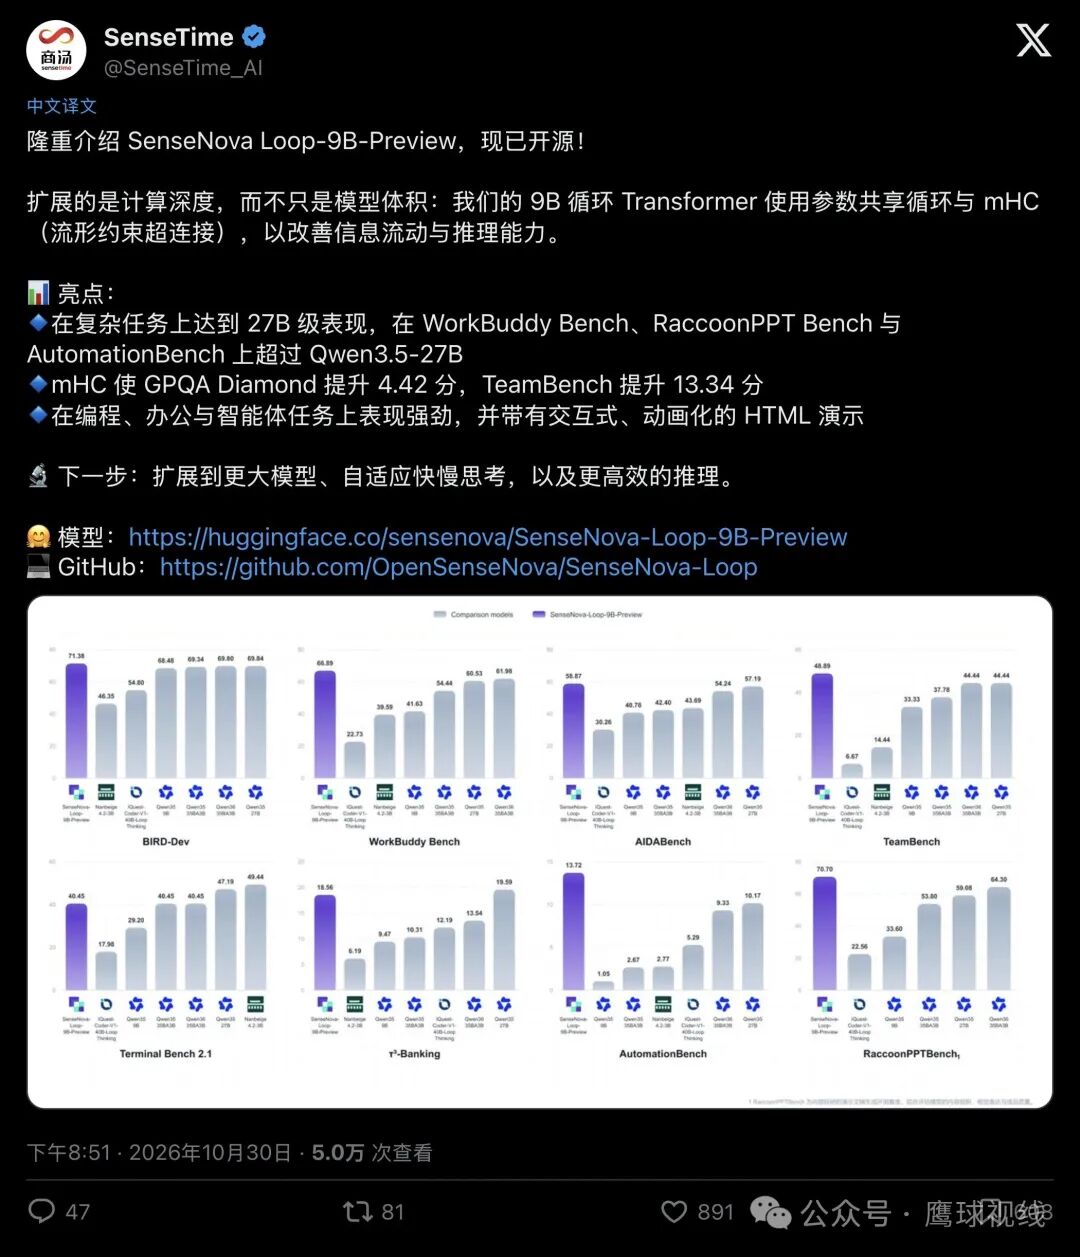
▲ 商汤官方发布帖,核心主张是“扩展计算深度,而非仅仅扩展模型体积”
但当显卡风扇开始呼啸,监控屏幕上的数字却透出一股诡异。
在同样的 Q4 量化精度下,作为对照的常规 9B 模型(NeoHorse 1 9B)每秒能狂飙出 89 个 token。而商汤这颗新星,生成速度却像踩了急刹车,直接腰斩到了 49 token/s;提示词处理速度也从 2638 token/s 暴跌至 1450 token/s。甚至在其中一轮智能体测试里,模型突然陷入“鬼打墙”,一口气死循环输出了 32K 个 token。
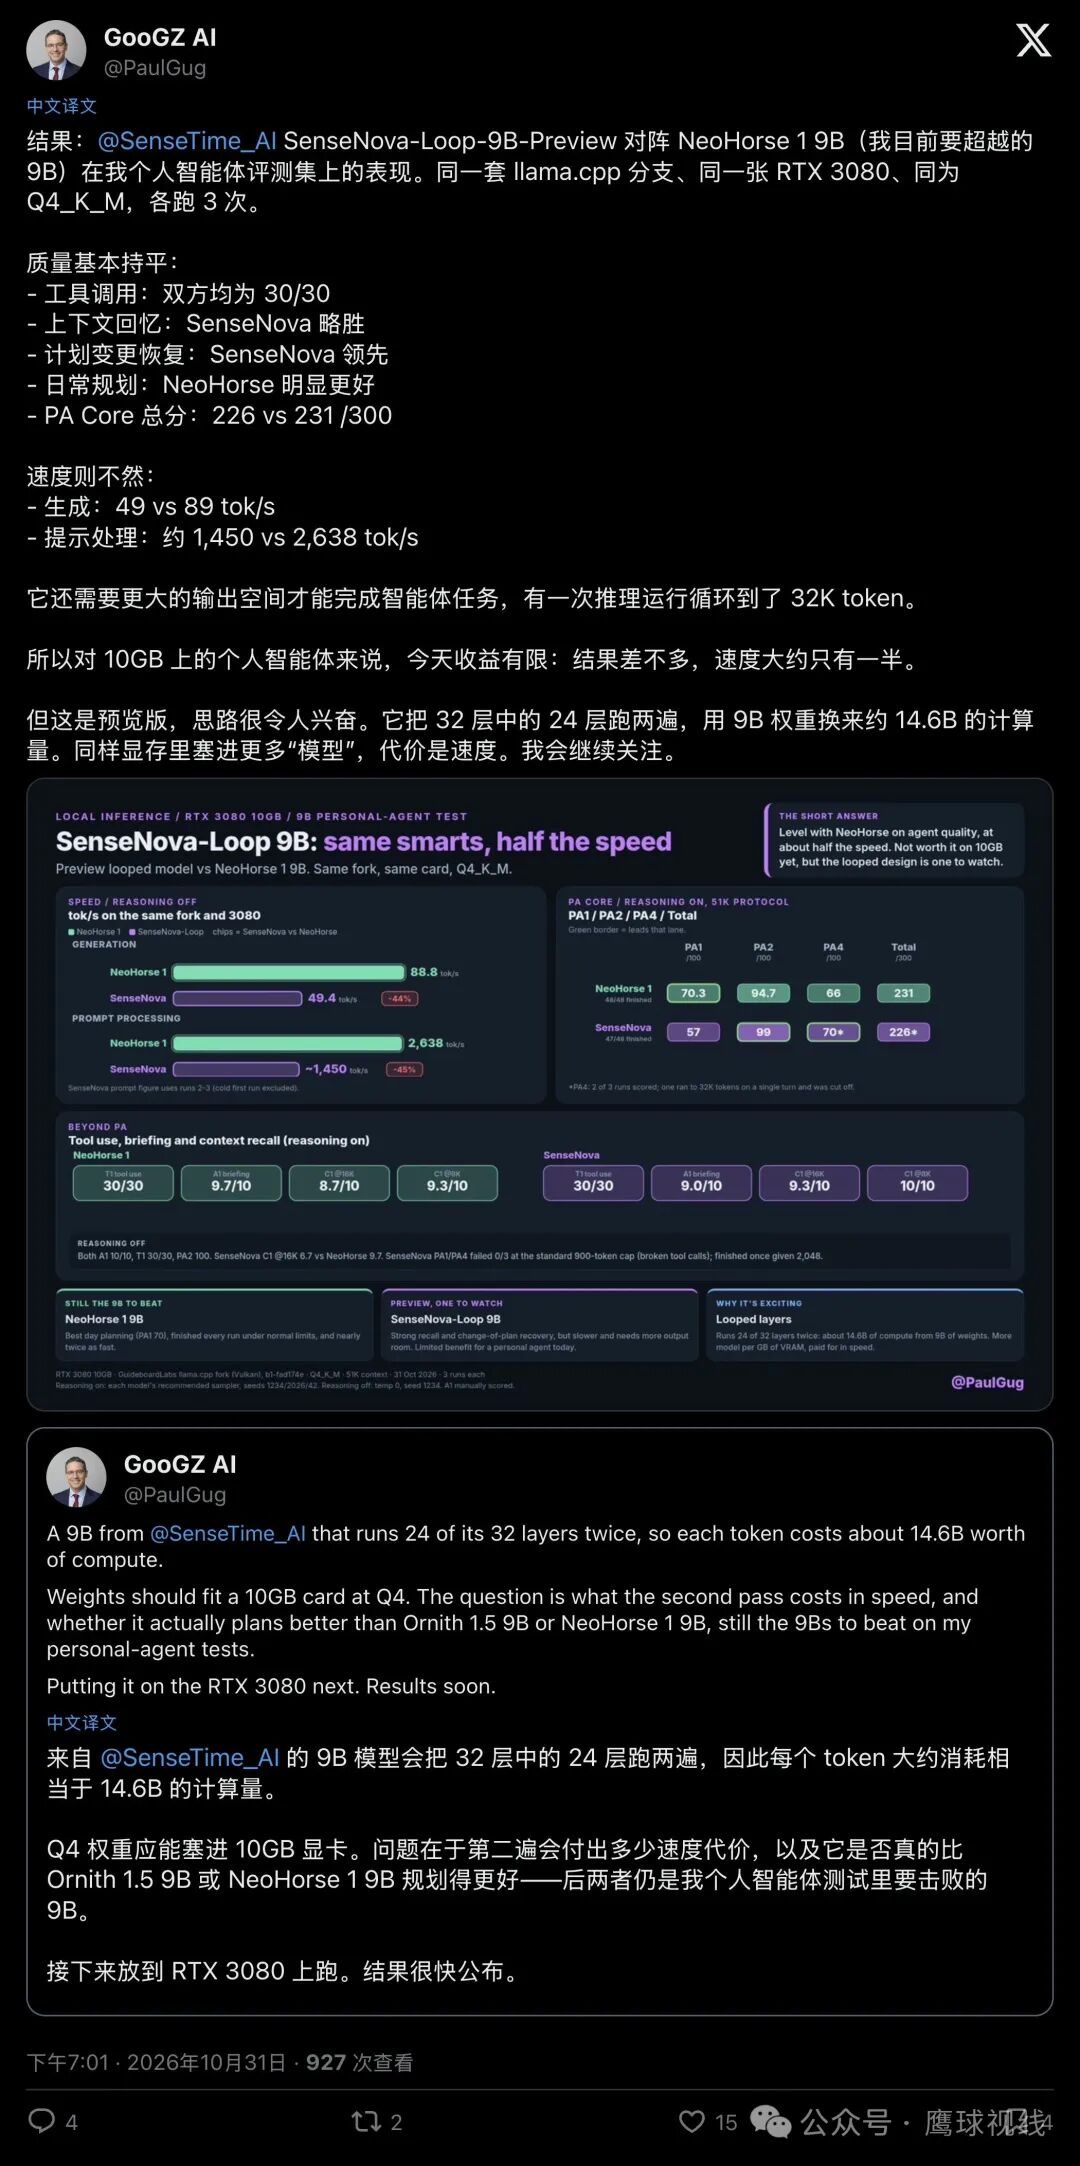
▲ 社区博主 @PaulGug 在 RTX 3080 上的实测对比:智能体得分逼近标杆,但推理速度直接减半
怪事全凑到一起了一个 9B 的模型,吃着 9B 的权重显存,在特定榜单上打出 27B 的跨级反杀,却跑出了接近 15B 模型的沉重迟缓。
它的权重文件里,到底藏着什么猫腻?
01第一重追查:拆开配置文件,32层楼怎么跑出56层的账单?
嗅觉敏锐的开发者们没有等官方技术报告,第一时间扒开了 Hugging Face 仓库里的 config.json。
开发者 Julian Pscheid 把它的配置文件与通义千问的 Qwen3.5-9B 并排放在一起,结果让人大跌眼镜:文本主干直接声明为 model_type: qwen3_5_text。4096 的隐藏层维度、12288 的前馈网络维度、248,320 的词表大小,甚至连 32 层的总层数、3:1 的线性注意力与全注意力混排比例,都与 Qwen3.5-9B 如出一辙。
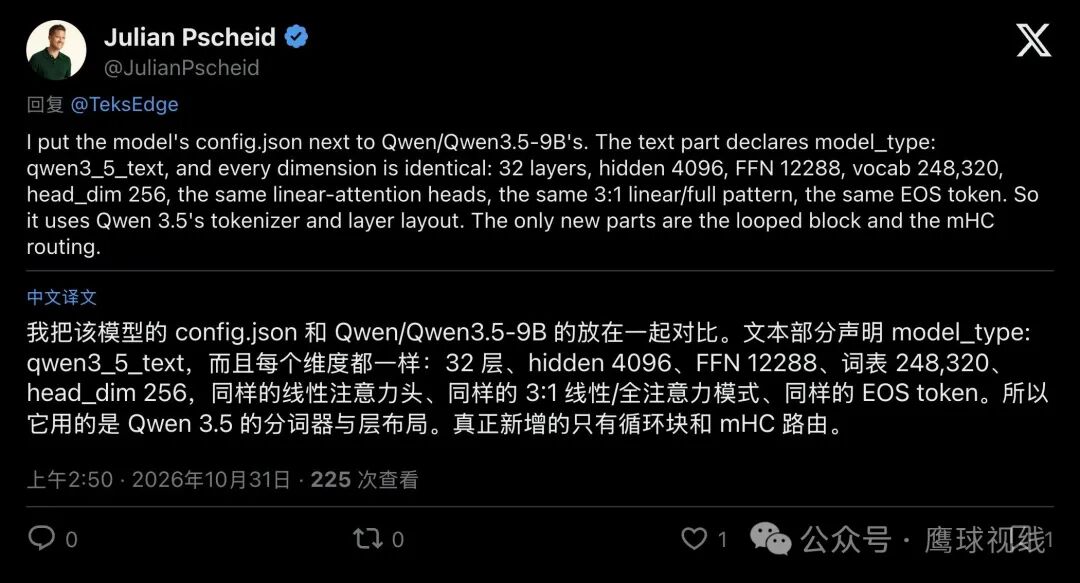
▲ 开发者比对 config.json 后发现,其底层骨架与 Qwen3.5-9B 高度一致
既然骨架还是那个 32 层的骨架,多出来的智商和慢下来的时间,去哪了?
秘密全在名字里的那个词,Loop(循环)。
在传统的大模型里,“层”就像一栋写字楼的楼层。一个词(token)从 1 楼进去,一层层往上爬,爬完 32 楼就输出结果。想让模型更聪明,通常就得把楼盖到 60 层甚至 80 层。但楼层越多,需要存放在显卡里的权重参数就越庞大,普通人的显卡根本装不下。
商汤采用的 Looped Transformer(循环 Transformer),玩了一手极致的“空间换时间”。
这栋楼依然只盖 32 层(第 0 层到第 31 层)。当数据从入口爬完第 0 到第 3 层后,进入了第 4 到第 27 层这 24 层核心区。按照常理,爬完第 27 层就该去第 28 层了。但在 SenseNova-Loop 里,数据刚走出第 27 层,就会被一条暗道直接传回第 4 层门口,用完全相同的权重,原封不动地再跑第二遍!
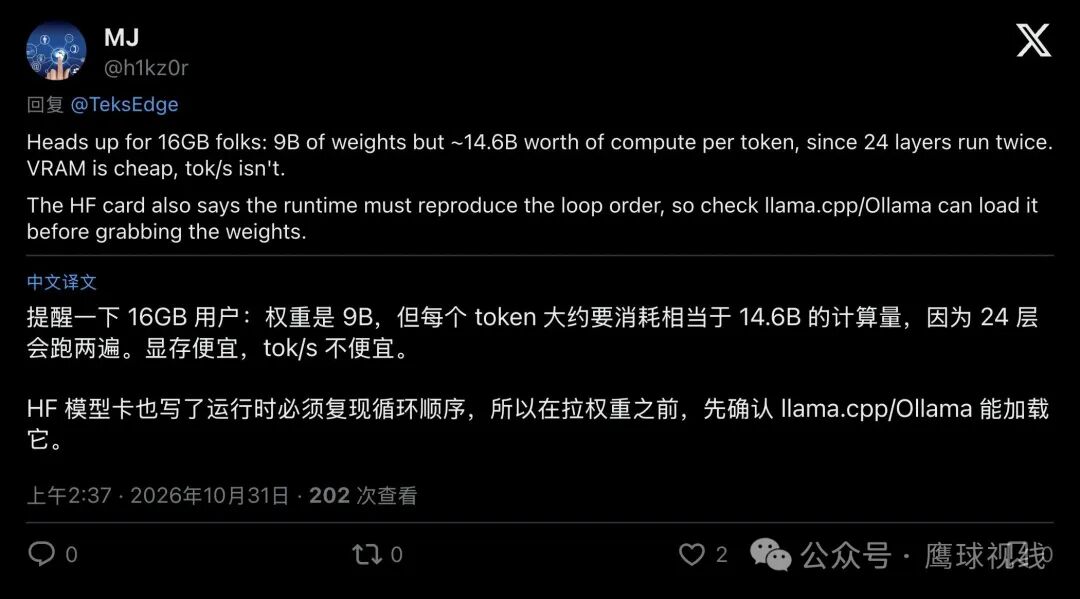
▲ 社区开发者一针见血地指出:显存很便宜,但每秒生成速度(tok/s)一点也不便宜
算一笔简单的数学账:入口 4 层,加上中间 24 层连跑 2 遍,再加上出口 4 层。你的硬盘和显存里明明只存了 32 层的权重,但每一个词在生成时,实际上结结实实经历了 56 层计算。
这就是为什么官方宣称它拥有 14.6B 的“有效计算参数”,也是为什么 RTX 3080 上的帧率会直接腰斩。正如海外社区热评所言:“显存账单按 9B 付,算力账单却得按 14.6B 结。” 雪上加霜的一点在于,中间那 24 层跑两遍时,每一遍都得各自保留独立的注意力 KV 缓存(模型的短期草稿本)。如果你只盯着 5GB 的量化权重体积,想用 8GB 显卡跑长文本,双倍膨胀的缓存分分钟会教你做人。
02第二重追查:同一段路跑两圈,信息为什么没有“精神分裂”?
追查到这里,一个新的疑问冒了出来:既然把中间层“原地套圈”跑两遍就能白嫖深度,为什么以前的大模型厂商不这么干?
答案很残酷:直接循环,模型会训崩
把神经网络想象成一条传递信息的高速公路。普通模型只有一条单车道(标准残差连接)。如果你强行让车流在同一段路上绕两圈,第一圈留下的信号噪声会在第二圈里被急剧放大,信息混作一团,训练过程很快就会数值爆炸。
为了镇住这头“套圈”的猛兽,商汤在循环块里焊上了第二件武器,mHC(流形约束超连接)。
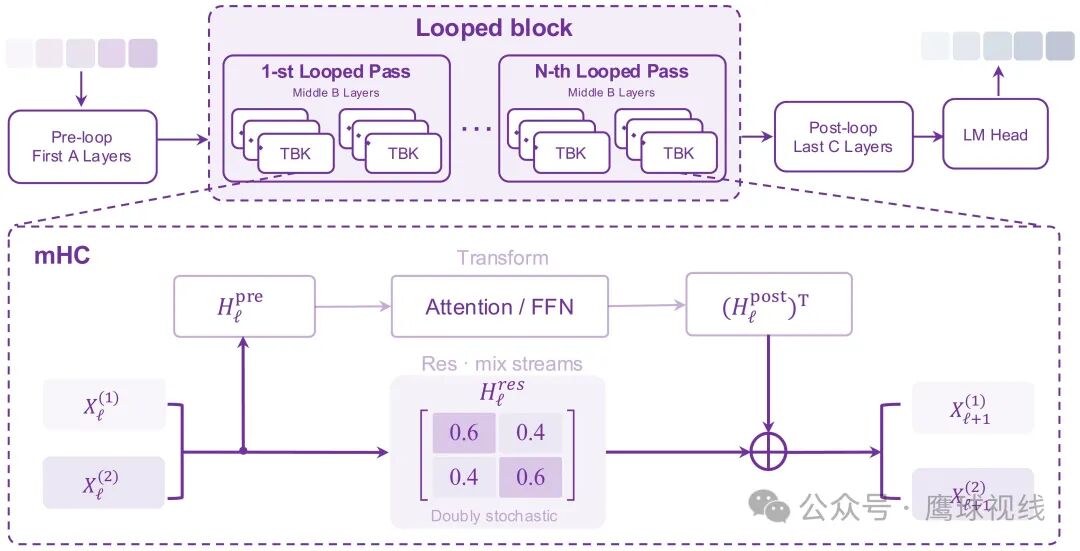
▲ 官方架构拆解:上方为跑两遍的中间循环块(Looped block),下方为双流 mHC 路由机制
这个概念最早由 DeepSeek 团队在 2025 年底的论文(arXiv:2512.24880)中提出。简单来说,既然单车道容易堵死,那就把残差通路拓宽成两条并行的双车道,让模型自己学习怎么在两条车道之间并线、交换信息。但自由并线极易引发连环车祸,于是 mHC 站在路口当起了严苛的“交警”。
在商汤的底层实现里,这段路由参数被单独锁定为高精度的 FP32 格式,并通过 20 次 Sinkhorn-Knopp 迭代算法,强行把两条车道的混合比例约束在一个极度稳定的数学流形上(相当于永远保持温和的加权平均)。
有了这位“数学交警”,模型在跑第二圈时不仅没有精神分裂,反而学会了真正的“二次深思”。官方消融实验显示,仅仅是加上 mHC 这一项,模型在 GPQA Diamond 科学推理测试上就涨了 4.42 分,在团队协作基准 TeamBench 上更是暴涨 13.34 分。
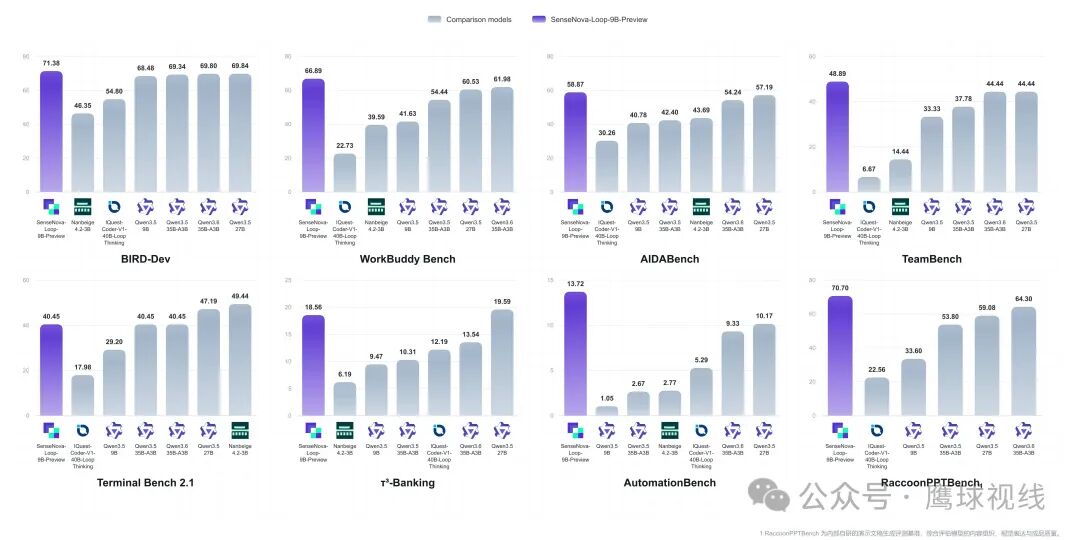
▲ 官方公布的八项基准测试对比,紫色柱为 SenseNova-Loop-9B-Preview
这也解释了它那张极具争议的成绩单。在需要反复推敲步骤的 WorkBuddy(66.89 对 60.53)、RaccoonPPT(70.70 对 59.08)和 AutomationBench 上,跑完 56 层深度的 Loop-9B 确实跨级反杀了 Qwen3.5-27B。
不过,社区的眼睛也是雪亮的在官方主帖评论区,高赞回复当场灵魂发问:“为什么拿旧的 Qwen3.5-27B 当靶子,而不比最新的 3.8 系列?”
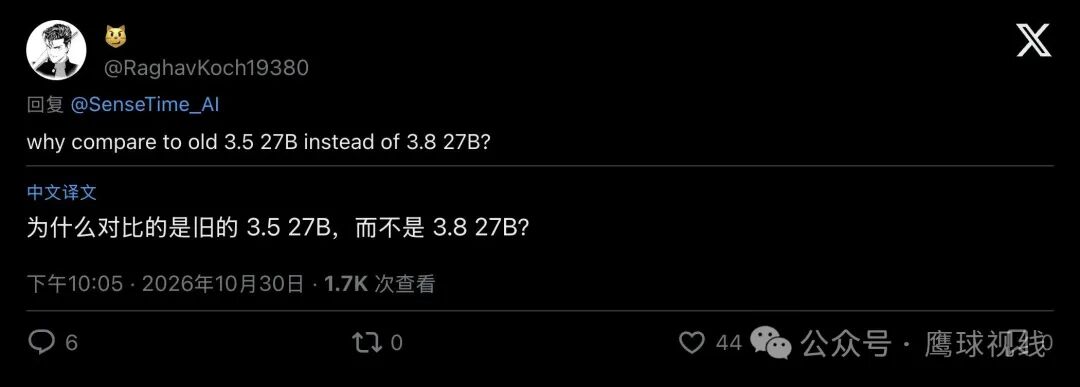
▲ 官方评论区高赞质疑:为何对标旧版 3.5 而非 3.8 系列
而且仔细看官方自己的柱状图就会发现,在 Terminal Bench 2.1 和金融类的 T³-Banking 测试中,绝对体量更大的 27B 模型依然稳压一头。所谓“9B 反杀 27B”,远谈不上全方位的降维碾压,实际上是一场聚焦在办公文档、PPT 动效生成与智能体轨迹上的局部特种作战。
03终极追查:潜入底层工程库,揭开“抢救帧率”的暗线
如果故事只讲到这里,SenseNova-Loop 充其量只是一个“用速度换智商”的偏科生。但当我们顺着主仓库的线索,摸进商汤同步开源的两个底层工程库,OpenSenseNova/torchtitan 与 OpenSenseNova/SenseSpec 时,才真正看清了这套架构背后的工程底牌。
那里藏着两个关乎生死的技术自救
第一场自救,是怎么在训练时活过 256K 超长上下文。要知道,这个模型不仅每步要算 56 层,它还拥有接近 25 万(248,320)的超大词表,并且支持 256K(262,144 token) 的超长上下文。在训练时,如果直接把 256K 长度的词表概率全部展开,瞬间膨胀的显存足以把顶级服务器直接撑爆。
翻开 torchtitan 里的训练脚本 mhc2_loop2_titan.sh,我们找到了工程师的解法:在单机 8 卡上采用 CP4 × DP2(4 张卡合力切分同一条长序列),开启全激活重计算,并使出了一招极其凶悍的“分块交叉熵(LOSS_CHUNKS=256)”,把原本要一次性吞下的庞大损失计算,硬生生剁成 256 个小碎块逐个消化;同时把娇贵的 mHC 路由器从主干网络里拎出来,单独建立优化器参数组。靠着这套刀法,8 张显卡才硬扛下了单步超过 52 万 token 的全深度洗礼。
而第二场自救,则直接指向了开篇那个要命的痛点,被腰斩的推理速度。商汤的工程师比谁都清楚,56 层串行计算带来的延迟,在真实生产环境里是不可接受的。怎么把丢掉的帧率抢回来?答案藏在专用的投机解码仓库 SenseSpec 里。
所谓的“投机解码”,就是给笨重的大模型配一个体量极小的“速记员(草稿模型)”。大模型算一步太慢,就让只有 5 层楼高的速记员先一口气猜出后面 7 到 8 个词,大模型只需要做一次验证即可。
但给一个“套圈模型”配速记员,难度完全不同。最精彩的设计出现在 SenseSpec 的配置文件里:虽然主模型物理上只有 32 层,但速记员在偷看主模型的“脑电波(隐状态)”时,是按照 56 个虚拟执行层来插探针的!
它精准地选定了 5 个坐标:[3, 27, 51, 53, 54]。看看这 5 个数字意味着什么:
- 第
3层:刚走完入口、进入循环前的最后一刻; - 第
27层:第一圈循环刚跑完的瞬间; - 第
51层:第二圈循环刚跑完的瞬间; - 第
53、54层:走出循环、即将跨出大门的深层表征。
在 8 卡 H800 节点上,商汤用上了 4+4 推训分离拓扑:4 张卡跑冻结的主模型,通过 Mooncake 传输引擎(开辟 64GB 全局内存段),把这 5 个关键路口的“脑电波”实时零拷贝射向另外 4 张训练卡,喂养出 DSpark 和 DFlash2 两代 5 层草稿模型。其中最新一代的 DFlash2 甚至直接放弃了传统的因果注意力,改用非因果块预测,连末层隐状态的 L1 回归损失都一刀砍掉(权重设为 0.0),只为把显存与通信带宽压榨到极致。
有趣的是,在核对 SenseSpec 源码树时,我们还发现了一个带着体温的工程彩蛋:主仓库文档里写得清清楚楚的启动路径 SenseNova-Loop-9B-Preview-dflash2,到了实际代码库里,文件夹名字却被工程师手滑敲成了 dflah2(漏掉了字母 s)。而在主仓库的状态栏里,这两款救命的加速引擎目前仍标着“训练中(training in progress)”。
这恰恰解开了开篇的悬念:社区玩家拿到的,是一个还没装上专用涡轮增压器的裸车版本。
04终局启示:大模型进入“精算师时代”
过去三年,大模型领域的信条简单粗暴:力大砖飞。想要模型更聪明,就去堆参数、加层数、买更大的集群。
但 SenseNova-Loop-9B-Preview 的出现,把一条被学术界讨论已久的暗线摆上了桌面,除了参数规模和长思维链,“计算深度(Compute Depth)”正在成为第三根缩放轴。
只是,扒开这层源码后我们也看清了一个物理铁律:算力世界里从来没有免费的午餐。
你用 24 层原地套圈省下了显存,就必须在每一秒的推理延迟和双倍 KV 缓存里把债还上;为了避免套圈时信号崩溃,你必须请来 DeepSeek 的 mHC 流形约束当交警;而为了抢救被 56 层拖垮的帧率,你又不得不搭起一套横跨 5 个虚拟深度的 Mooncake 投机解码管线。
无脑堆参数的狂飙时代正在退潮如何用时间换空间,再用精巧的工程架构把时间赎回来,属于大模型“架构精算师”的时代,才刚刚开始。