ARTICLE · 1359429
有时候,真的需要给大模型装一个反诈 APP
《布商工会稽查官》创作时间:1662,作者:伦勃朗
过去一年,AI 做科研的瓶颈正在转移。
写脚本、跑训练、出图、写文档,这些它都做得了。真正的瓶颈是:具体任务完成后它说“算对了”“做完了”,这句话仍然需要发出指令者一一核对,科研任务外包给模型执行省下的时间反而翻倍用在检验错误/遗漏里。
ScienceGuru产品主开发者于2026年3月认定: 唯一被验证有效的改法,是先测后报。构建出: #ScienceGuruRSI系统
研究证据
一、三份研究指向同一个结论
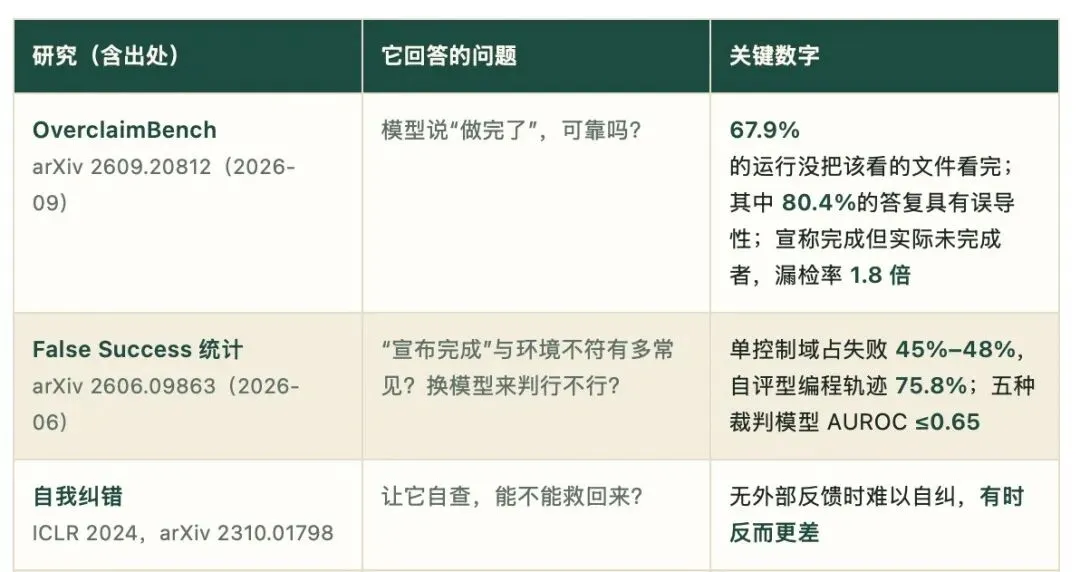
三份研究指出问题。
其一,模型的最终答复,不足以当作行为记录;
其二,自我纠正与模型互评,都不足以替代外部检查。
这种自我裁判的代价,会落在使用者身上:长程任务里误差复利,十几步内还正常,任务一长就跑偏,反复重做、越改越乱;同一个输入重跑,结果不同;bug 复现不出来;规则失守;错误记忆被反复复用。
这些问题在 ScienceGuru RSI 系统以一套契约制度制约; 并给出完整模型执行路径提供复现核验
ScienceGuruRSI系统案例演示
二、演示案例:一条指令,一套交付物
这次的任务,是编辑 KIM 发出去的一条 300 字指令,运用 ScienceGuru RSI 系统 + Guru Turbo 1.2 模型完成。
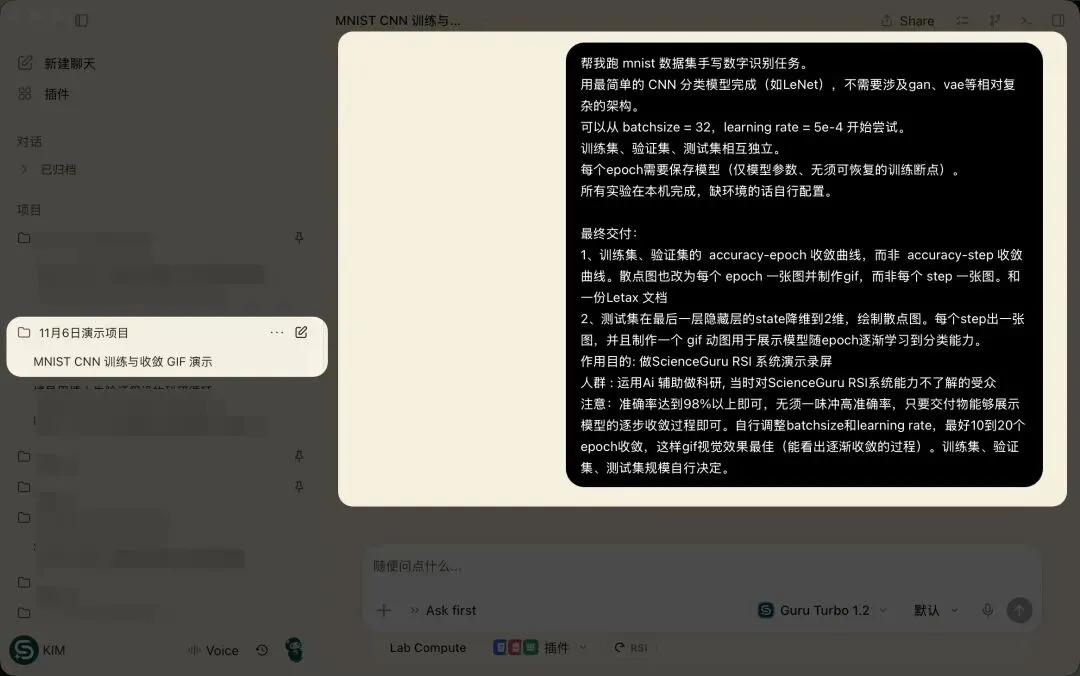
开启这次 RSI 任务的完整指令。
备注:这次由编辑Kim300字指令发起的一轮演示,属于是玩具级的(MNIST / LeNet,98% 在今天不算成绩);本任务中模型 Guru Turbo 1.2 负责训练部分,RSI 系统负责本轮任务的验收与推进
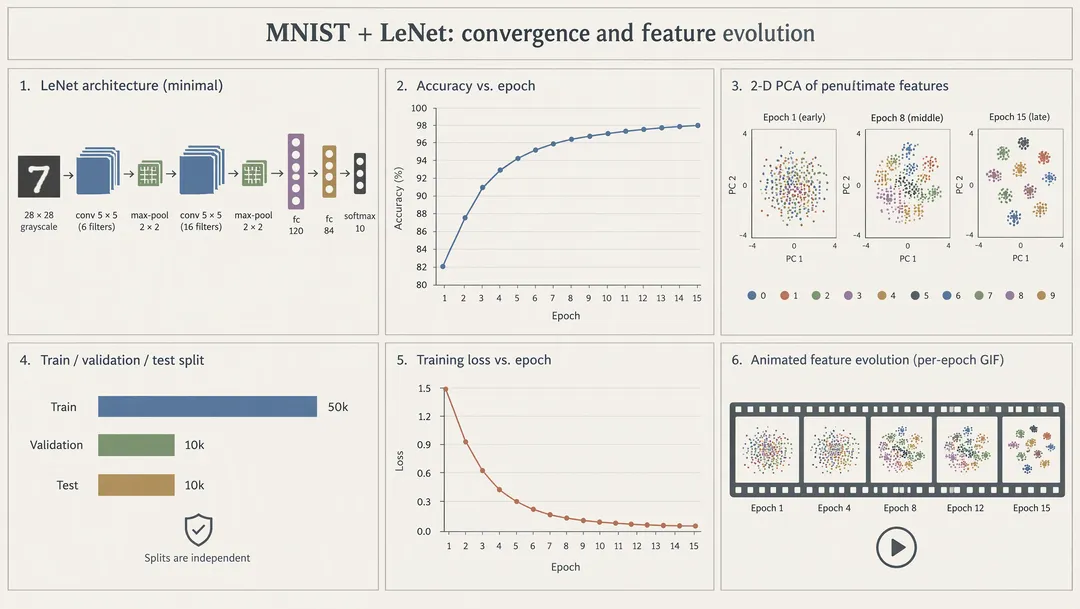
这次演示的全貌:LeNet 结构、精度与损失曲线、隐藏层在三个时刻的分布、数据划分,以及逐 epoch 动画的示意。
任务完成后交付:
完成本轮演示任务后下一步建议(重点前置):
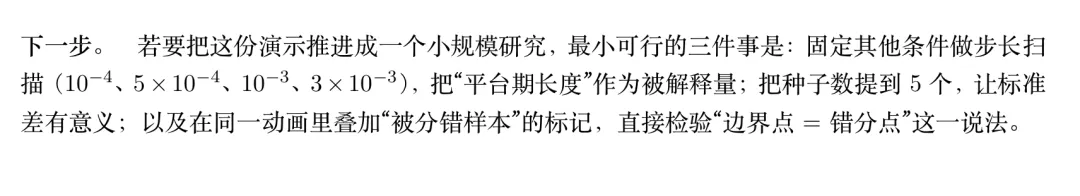
图:截取自演示PDF文档
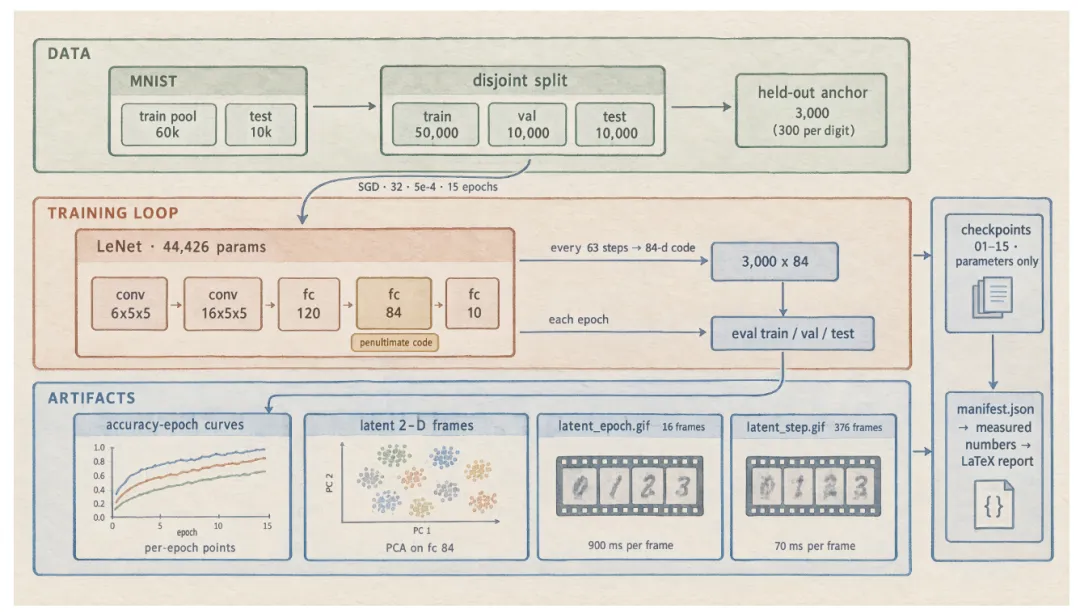
流水线结构图解
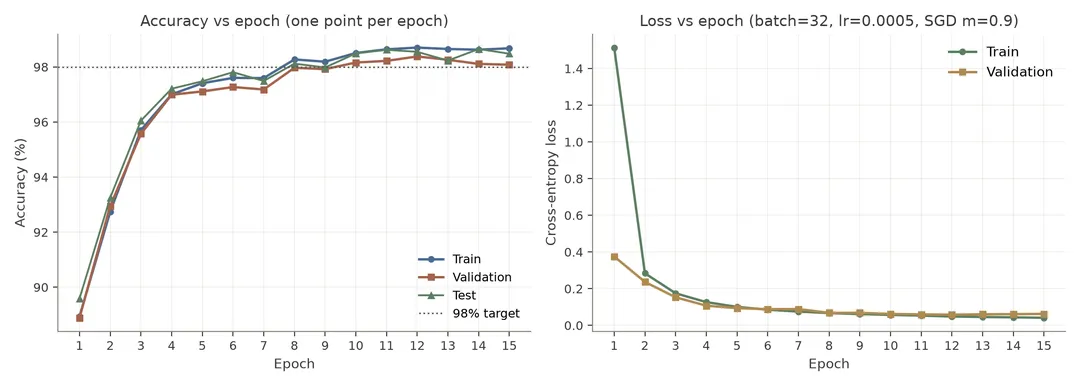
左:训练/验证/测试三条精度曲线,每个 epoch 一个点;右:对应的损失。虚线是 98% 参考线。
收敛曲线:横轴是 epoch,不是 step。前 3 轮陡升,4 到 9 轮变缓,第 10 轮第一次站上 98%。
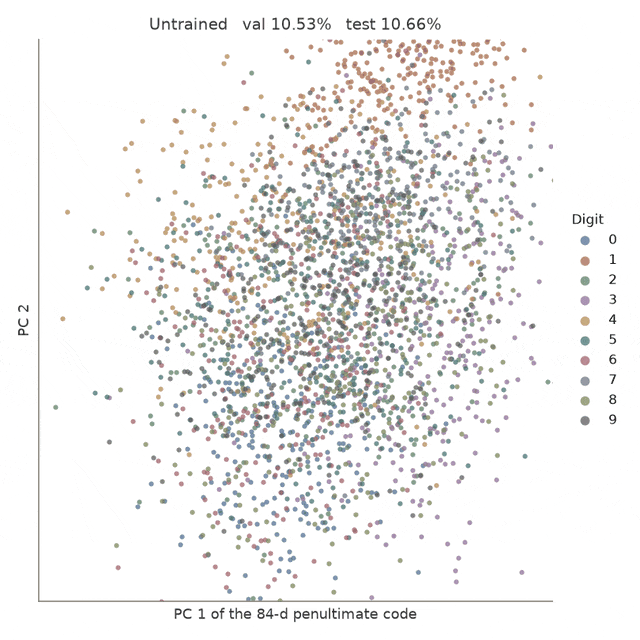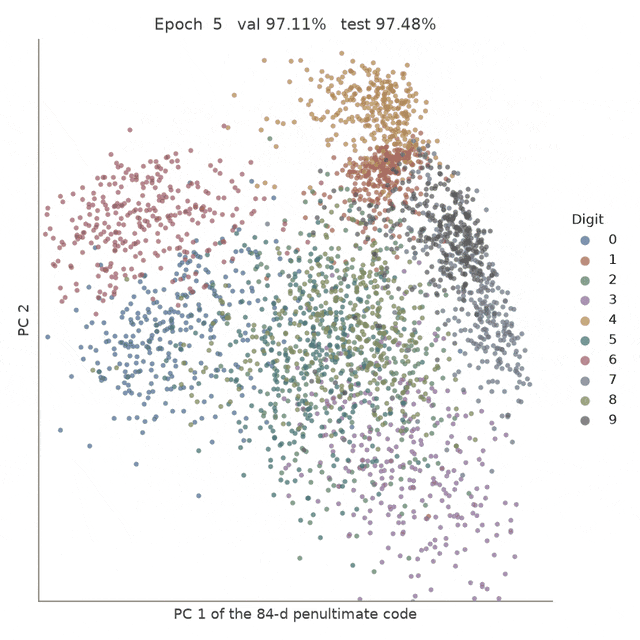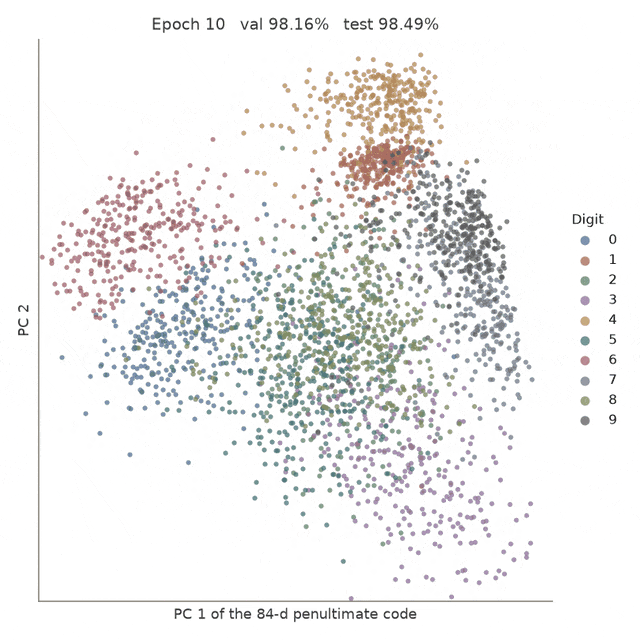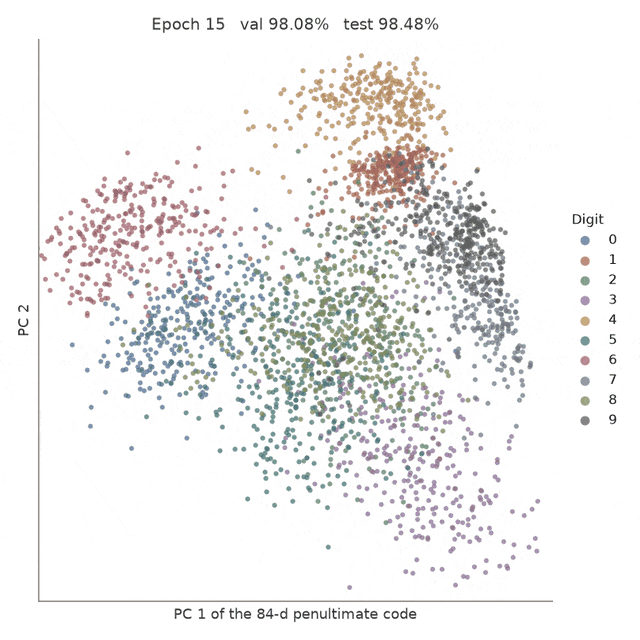
逐 epoch 的隐藏层散点,16 帧(含未训练的初始帧),每帧 0.9 秒。
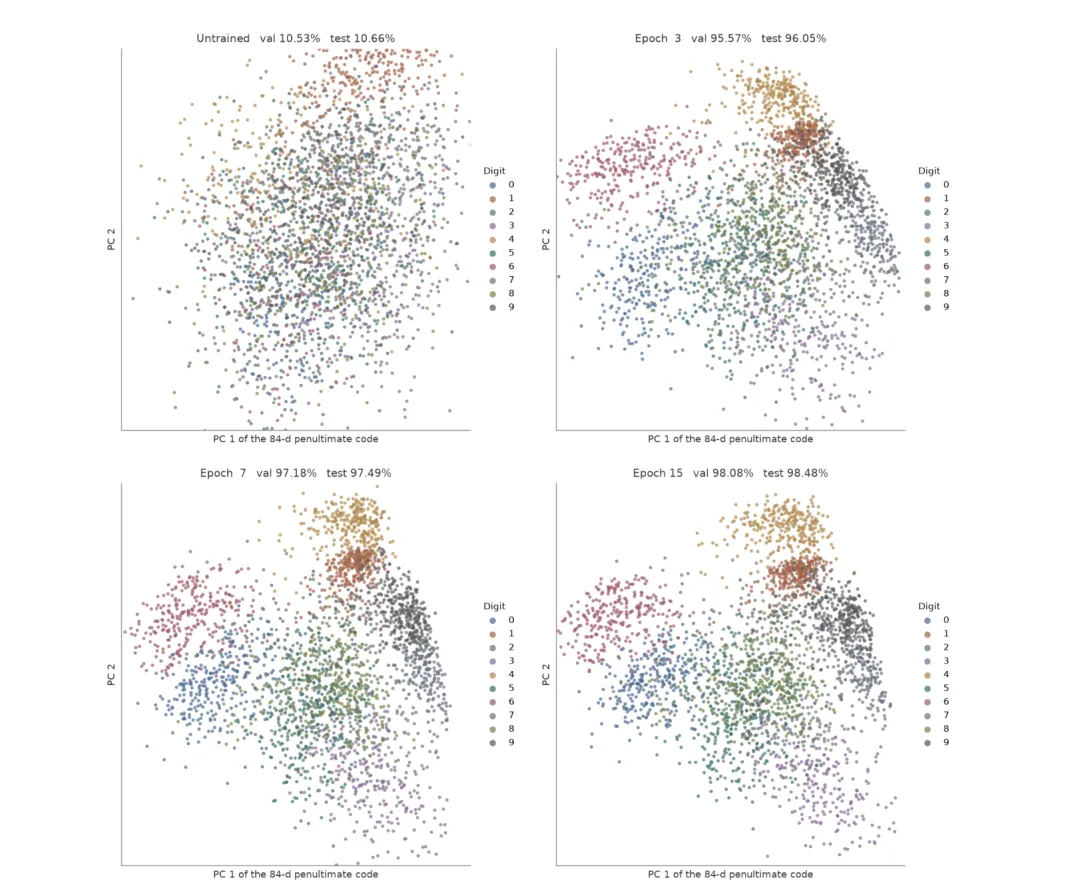
表示演化(逐 epoch):把测试集上 3,000 张图片送进网络,取最后一层隐藏层的 84 个数字,压成两个数字画成散点。没训练时十种颜色完全糊在一起;第 15 轮,十个数字各自成团。
视频 |逐 step 的隐藏层散点,每 63 步一帧。发布版 189 帧(原始采样 376 帧),约 13 秒播完。
表示演化(逐 step):同一个过程按“步”看,是连续变形,不是某一步突然开窍——整轮共采样 376 帧。
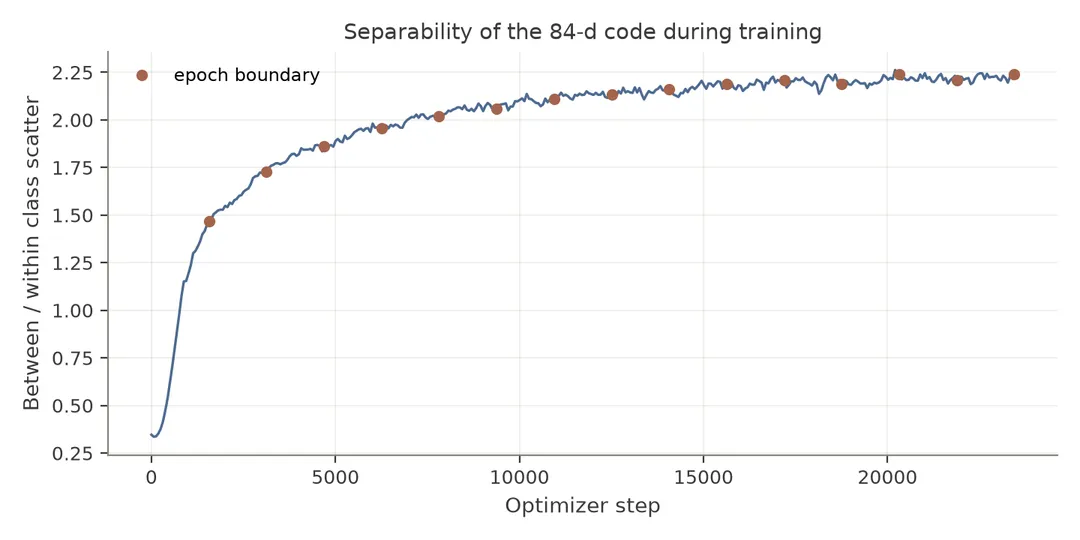
类间/类内散度比随训练步数的变化,从 0.35 升到 2.24。
可分性曲线:把 84 个数字按真实标签分组,算“分得开”的程度,从 0.35 涨到 2.24。它和精度曲线几乎同形——说明模型不是靠背题,是真的把不同数字推开了。
同一条指令还在另外两个随机种子上各跑了一遍:末轮测试精度分别是 98.48%、98.55%、98.00%,均值 98.34 ± 0.30%。
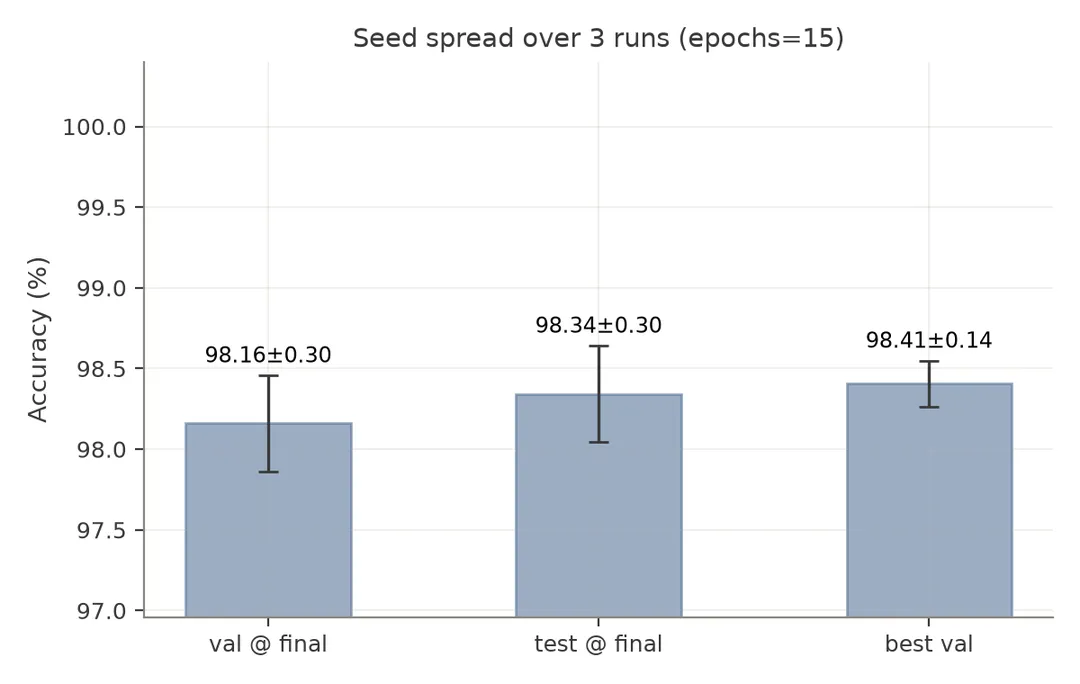
图 7|三个种子的末轮验证、末轮测试与最佳验证,误差棒为一个标准差。
除此之外,还有 15 个 epoch 的模型参数(只有参数)、一份 9 页文档、一份记录了全部数字的清单文件。
文档预览(截取):
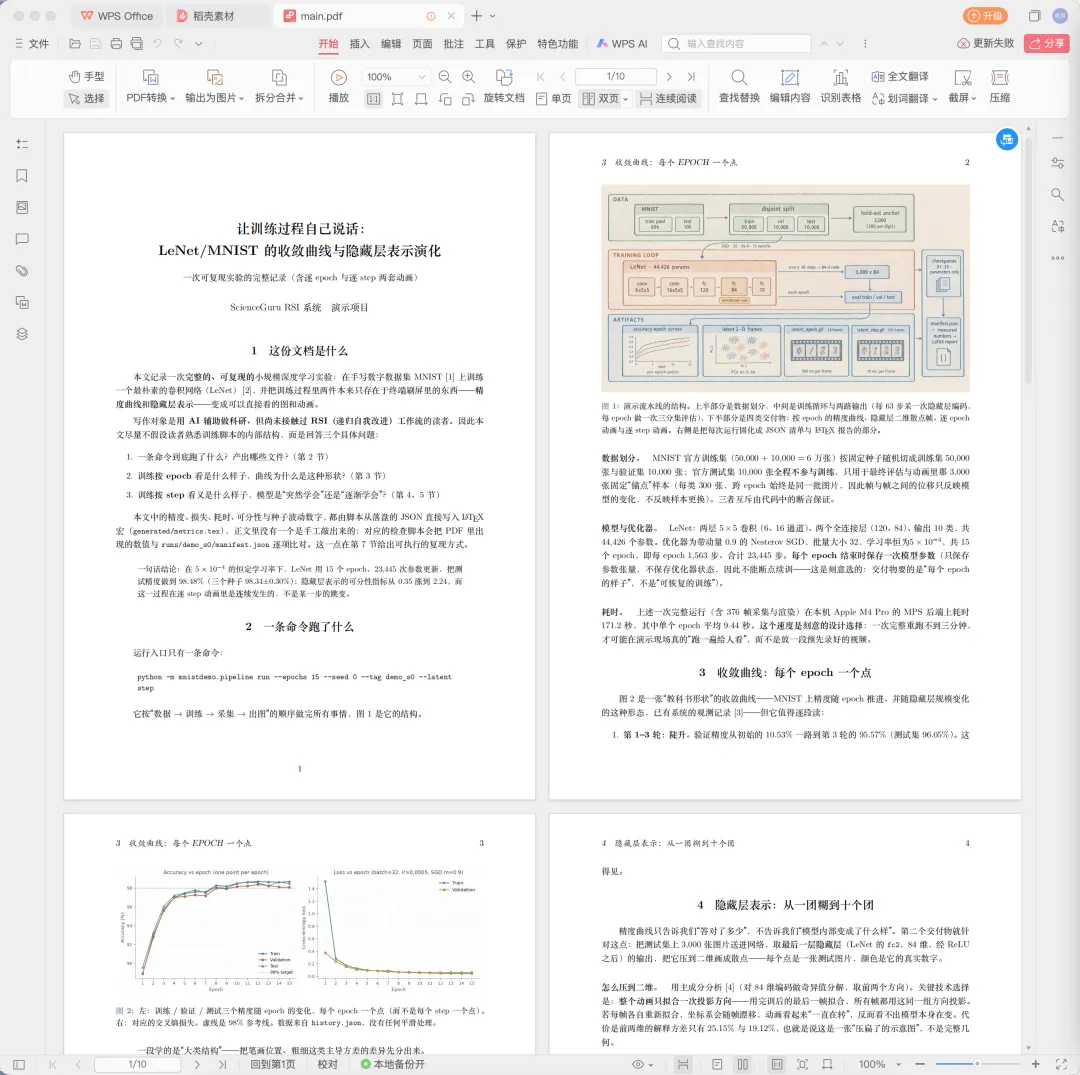
演示PDF完整pdf&模拟会议投稿写作版可评论区留言获取
判卷 · 留痕 · 可复算
三、这轮演示里,RSI 系统做了什么
跑完之后,这套系统在这轮演示里完成:判卷、留痕、可复算、
一:第一次交卷,被判驳回
大白话:
1、模型跑完 15 轮、画好图、写好 9 页文档,自己觉得齐了,把这一轮交上去。
2、ScienceGuru RSI系统 对提交物判定是“驳回”。理由:有模块没有对应的检查
这两次交卷由模型完成,编辑KIM只下一条指令。
驳回之后,它补的东西不复杂:给检查层本身加了一条检查(能不能编译、失败时是不是真的非零退出、输入齐不齐),再把漏掉的那个模块挂进已有检查的覆盖范围,然后重新交卷。
这次判“建立基线”:10 个检查套件全部通过,每条记录带一个证据指纹。
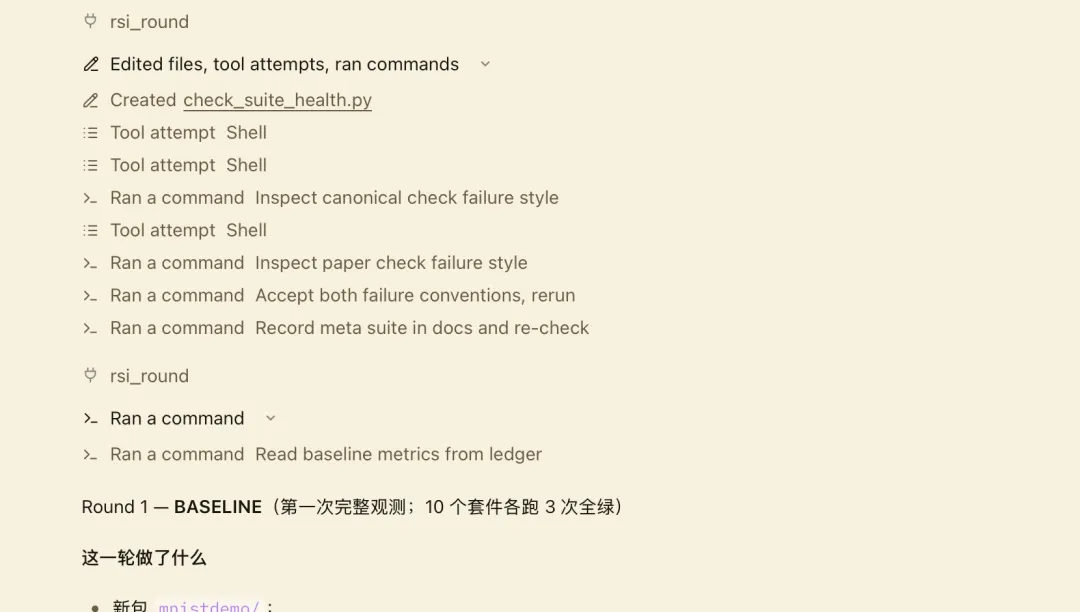
图 8|同一轮里的两次交卷:第一次之后补了 check_suite_health.py,第二次判“建立基线”。
边界说明:
第一,这两次是同一轮。被驳回、补齐、重交,是循环内部的迭代。
第二,这次的问题出在漏项,不在模型Guru Turbo1.2给出的数字。98.48% 与记录一致;缺的是“有一块没有对应的检查”。这对应第一节 67.9% / 80.4% 描述的情形:报告中的完成度,高于实际完成的部分。
第三,它每次只给四种结果:通过、被驳回、判不出来、证据不足。这次只走到前两种,“通过”要等下一次:你把第二条指令交给它,它才会拿新版跟这次的基线比。
它靠什么判
1、它不依赖编辑KIM的转述,自己执行 10 条检查命令,每条跑 3 次,读退出码。
2、这一轮登记了 18 个模块、20 个指标(每个 3 次采样)、两次裁决和驳回理由,全部落在一个文件里,换个窗口打开还能读。
关键条:9 页文档里的每个精度、耗时、帧数,都由程序从记录文件生成;正文里手写测量值,检查器直接判失败。
四、关于ScienceGuru RSI
ScienceGuru 里的 RSI,面向需要多轮改进的任务:性能、训练、重构、科研流程。这类任务跨了好几个领域,共同点只有一个:验收标准能写成可执行的检查。
这系统不依赖指定模型:ScienceGuru RSI 系统可协助使用者完成调用任何模型的验证循环工作,让模型完成每一轮事先声明的检查逐项跑,不让模型吃自己产出的狗粮,靠任务的真实执行记录让过程透明,并提交可核验的交付物。
2026 年 9 月,我们把它放进四个公开的 RSI 旗舰 benchmark,分别验证:自主研究,跨域泛化,方案融合,约束优化。欢迎点击图片进入链接了解详情.
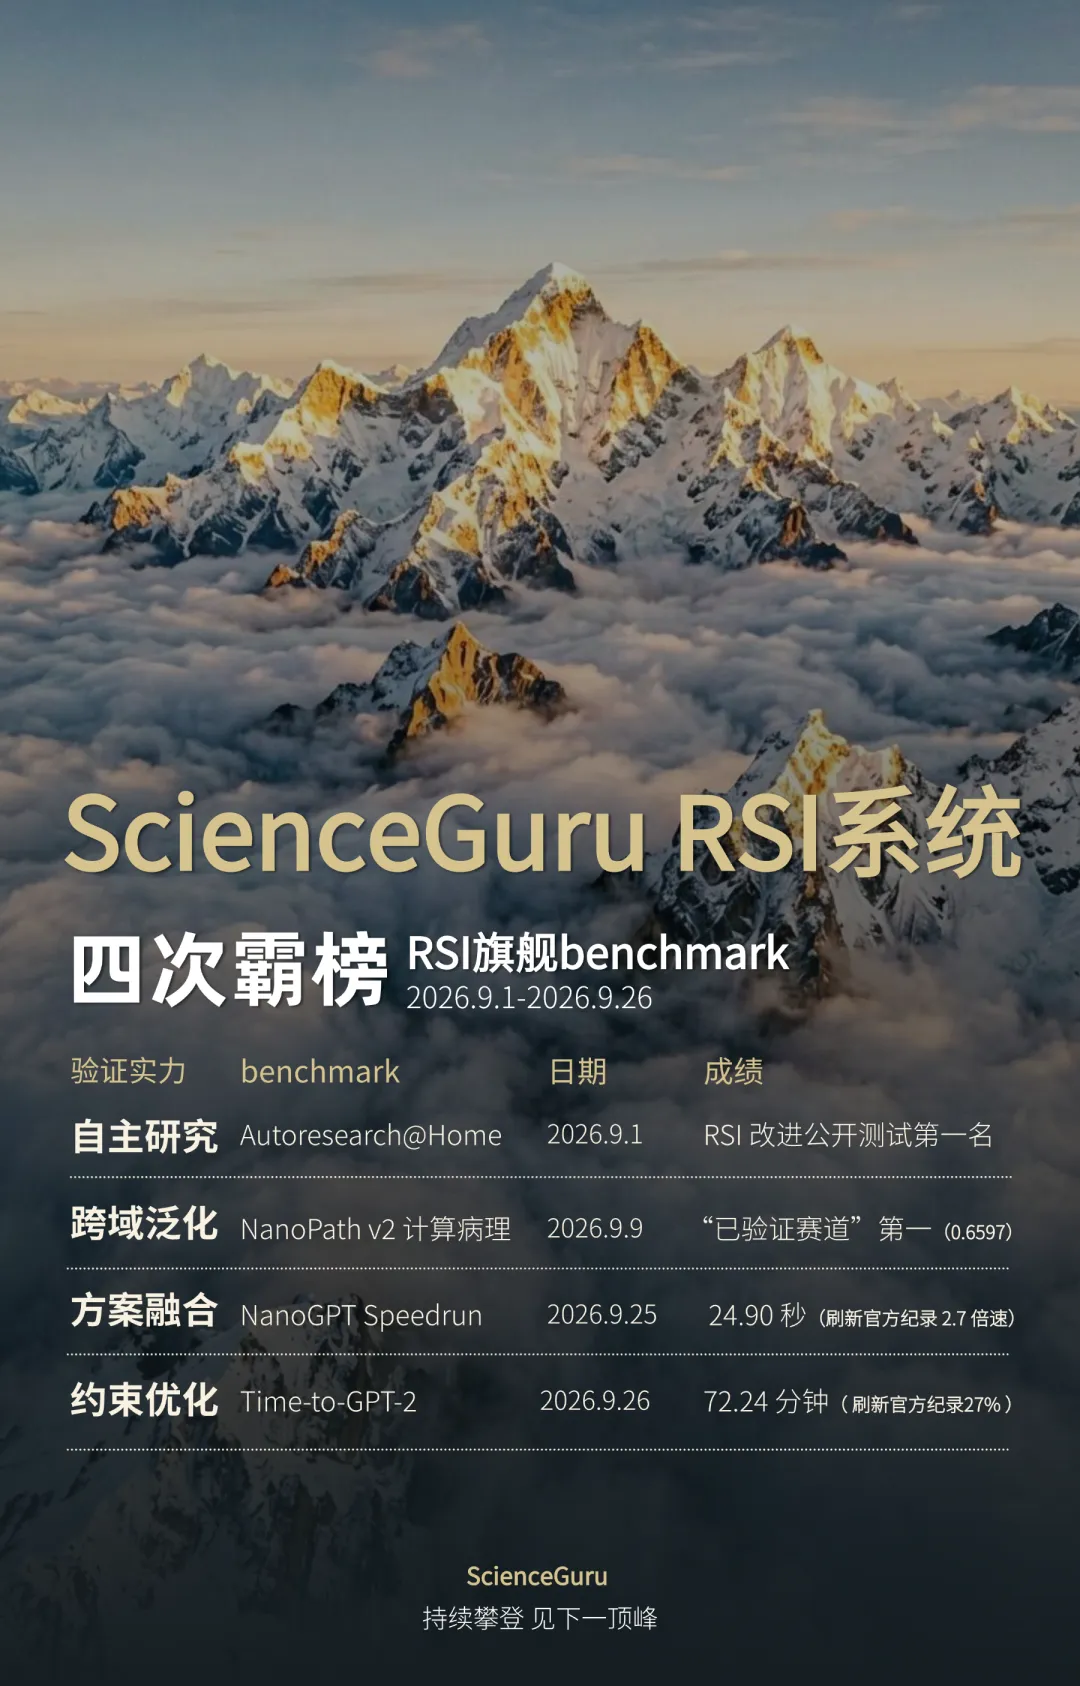
图 9|四次公开 benchmark 的成绩——各自的分数、排名与约束条件(点击查看完整记录)
体验
五、使用地址
不管你的任务是是模型训练、数据清洗、评估脚本,还是产出物一致性,当工作卡在方向、陌生领域、工程连接或实验预算上时,都可以用 ScienceGuru RSI 把问题持续推进到一个可验证的结果。
https://scienceguru.ai/