ARTICLE · 1041936
官方 13 个插件里,藏着教你怎么用 AI 教学的 3 个
AI扫盲班长.長青 · 官方 · 7 分钟读完
「Claude Code 12 个官方插件」别急着收藏,先看这份核对版
被漏掉的 5 个插件,其中 3 个更值得看
最近朋友圈和几个群里,都在转一篇文章,讲 Claude Code 官方藏了 12 个插件,标题大意是「大多数人只用了它 10% 的能力」。
我读完第一反应是:这个角度选得真好。第二反应是:数字好像不对。
于是我打开官方仓库,一个一个目录数。数完之后,我本来打算写一篇「挑错文」——结果写到最后,要纠正的第一个人是我自己。
01 · 一、先说结论
数下来是这样:
plugins/ 目录下确实是 13 个插件,不是 12 个。 原文只点名了 8 个,有 5 个从头到尾没提。这一条原文确实错了。
但接下来我准备开炮的那几条,被我一条条验回去了:
| 判错了 | |
| 判错了 | |
判错了Opus 4.7 by default,还有配置项 SECURITY_REVIEW_MODEL=claude-opus-4-7,是对的 | |
| 说过期了 |
所以真正站得住的「错」,只有插件数量那一条。
★ Insight ─────────────────────────────
- —
「我没找到」和「它不存在」是两件事,这是核对类工作最容易踩的坑。我打开一个文件没看到某个机制,就写下了「代码里没有」——可仓库里的文件不止一个。
- —
爆文里的具体数字,来源往往比你想的正规。我一度觉得「Opus 4.7」这种精确版本号是编的,去翻 README 才发现人家写得明明白白。先找来源,再下判断。
─────────────────────────────────────
02 · 二、我到底错在哪:一个目录里躺着三份互相打架的文档
这是这次最值得说的发现。
code-review 这个插件,官方有三处在描述它,而三处说法不一样:
第一处,plugins/README.md(顶层清单):说它是 5 个并行 Sonnet agent,负责规范合规、Bug 检测、历史上下文、PR 历史、代码注释。
第二处,plugins/code-review/README.md(插件自己的说明):说它起 4 个并行 agent,2 个查规范、2 个查 Bug;而且每个问题打 0-100 分,低于 80 分丢掉;Agent #4 靠 git blame 读历史上下文。
第三处,plugins/code-review/commands/code-review.md(真正跑起来的命令):也是 4 个 agent,但没有任何打分机制,Agent #4 也不是 blame——而是审查新引入代码里的安全和逻辑问题。
三份文档,三个说法。
我犯的错是:只读了第三份,就认定「原文是编的」。 而原文引的显然是第二份。判断「实际行为」得看命令文件,判断「人家有没有编」必须看 README,这是两件事,我混成了一件。
那到底哪个是真的?从能跑起来的角度看,命令文件说了算。但你得注意——README 里还写了怎么调阈值:
The default threshold is 80. To adjust, modify the command file at commands/code-review.md
它让你去命令文件里把 80 改成别的数。可命令文件里根本没有这个 80。文档在教你去一个不存在的地方改一个不存在的参数。
★ Insight ─────────────────────────────
- —
官方文档互相打架是常态,不是异常。同一个功能,清单页、插件页、实现文件三处不同口径。这不是谁在骗人,是文档和代码各自演进的结果。
- —
判断「文档对不对」和判断「功能怎么做」要用不同的文件。想搞懂一个工具怎么用,看命令文件/源码;想判断一篇文章有没有编,先看它可能引的是哪份文档。混着看,就会像我一样把对的判成错的。
─────────────────────────────────────
03 · 三、被漏掉的 5 个插件,其中 3 个更值得看
回到站得住的那条错误:13 个插件,原文只提了 8 个。
漏掉的 5 个是:ralph-wiggum、explanatory-output-style、learning-output-style、frontend-design、claude-opus-4-5-migration。
前三个我建议你认真看。
01 `ralph-wiggum`:用「拦住退出」做循环
名字来自《辛普森一家》的角色。官方文档里有句话我特别喜欢——「Ralph 就是一个 Bash 循环」。
做法是:写一句提示词,配一个完成标志,然后用一个 Stop 钩子在 Claude 想结束的时候拦住它,把同一句提示词原样喂回去。Claude 就在这一轮里反复干活,每一轮都能看到自己上一轮改过的文件,直到它自己说出完成标志。
这个机制我前几天刚在别的地方用过,所以看到的时候会心一笑。下面第五节讲。
02 `explanatory-output-style`:你可能天天见它的产物
它在每次会话开始的时候往上下文里塞一段指令,让 Claude 在写代码前后给出简短的教学式说明,格式是这样的:★ Insight ─────────────────────────────────────
[2-3 条关键要点]
─────────────────────────────────────────────────
看到没。跟我平时回复里给你用的那个 Insight 框,格式几乎一模一样。
官方还特意警告:装了它会增加 token 消耗。这句话值得琢磨——它不是省钱的功能,是花钱换理解的功能。
03 `learning-output-style`:让你自己动手写几句
上一个的加强版。除了讲解,还会在关键决策点停下来,请你亲自写 5 到 10 行代码。
它挑的地方很讲究:业务逻辑、错误处理策略、数据结构选择、架构取舍——都是「有多种合理答案,你的偏好就是答案」的地方。纯体力活的代码它不麻烦你。
带团队的人、正在学编程的人,这个插件值得单独看看。它是把「让 AI 全干完」换成「让 AI 搭好架子,关键几步留给你」。
另外两个:frontend-design 是让 Claude 做前端时避开「一眼 AI 味」的审美指南;claude-opus-4-5-migration 是模型迁移的辅助工具,属于杂项。
★ Insight ─────────────────────────────
- —
一个插件就是一份被验证过的提示词。官方这 13 个目录,本质是 13 份「怎么跟 AI 提要求才不出岔子」的参考答案。哪怕一个都不装,读一遍它们的说明文档,也能改掉自己不少提问习惯。
- —
explanatory-output-style和learning-output-style的存在说明一件事:官方认为「教育」本身值得占用上下文预算。省 token 和长本事,有时候是冲突的,得自己选。
─────────────────────────────────────
04 · 四、那份「不算问题」的清单
光核对没意思,说点我自己真做了的。
AI 代码审查最大的痛点是假阳性太多。code-review 的解法很实在:对每个被提出来的问题,再派一个独立 Agent 去验证它是不是真的;验证不过的,一个都不输出。
比这更值钱的是它另外一份清单。命令文件里明确写了哪几种情况不许报:PR 之前就存在的老问题、看起来像 Bug 其实写对了的、资深工程师根本不会提的吹毛求疵、linter 会管的问题、代码里已经用注释显式忽略掉的规范问题。
我做过投标文件审核的工具,也做过发票整理和数据核对。这类工具的痛点完全一样:报一堆根本不是问题的问题,看的人立刻就不信了。
所以我把这套做法搬了过来,三个动作:
1. 每个发现都要过一道独立复核,复核不过的不进报告
2. 报告末尾固定加一句「以下几项我确认过,不算问题」,把容易误判的地方主动挑明
3. 每类发现都要能追到原文的哪一句,不写「疑似有问题」这种没头没尾的话
第三条尤其关键。审核报告里最没用的一句话就是「此处可能存在风险」——说不清在哪,就等于没说。
05 · 五、一道「不许蒙混收工」的闸门
这就是前面 ralph-wiggum 给我的启发。
我的审核工具跑完会生成一份报告。问题是:如果它中途失败了,从外面看和成功没什么区别——Claude 把这一轮回答完了,你以为报告就在文件夹里躺着。
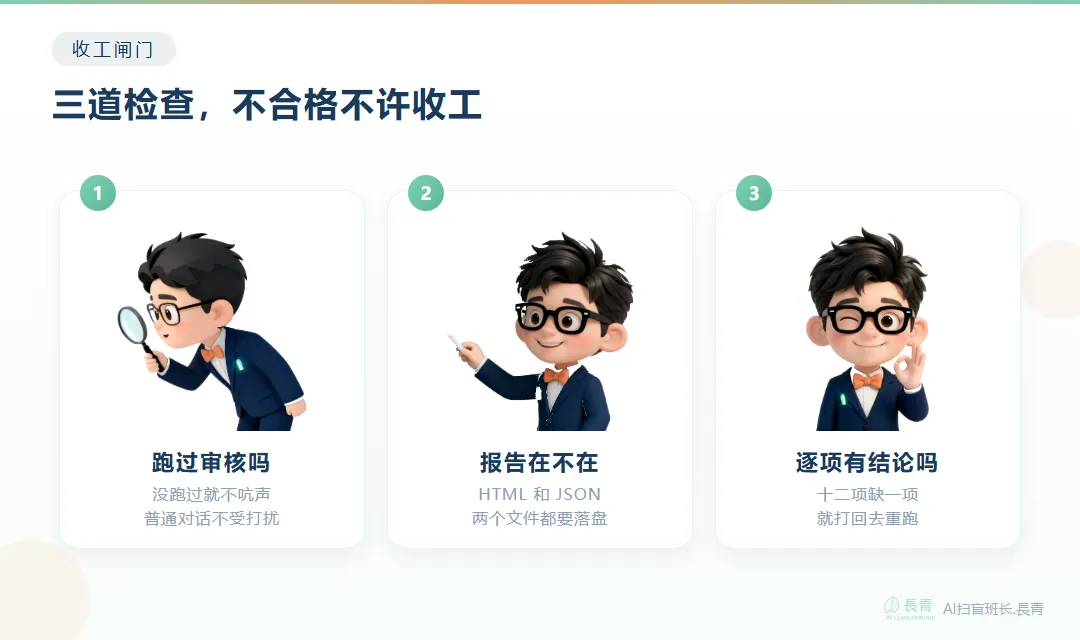
于是我给它加了一道 Stop 钩子。逻辑很朴素:
- —
这次会话里跑过审核程序吗?没跑过,什么都不做,不打扰
- —
跑过了,就去磁盘上找报告文件。找到了,还要打开 JSON 看一眼:十二项检查是不是每一项都落了结论
- —
报告不存在、或者里面有检查项没结论,就不许结束这一轮,打回去让它重跑或说明原因
- —
但如果 Claude 已经明确跟你说了「这次失败了,原因是啥」,闸门就放行——这道闸门拦的是沉默,不是诚实
我给它跑了 8 个场景的测试:正常跑通的、报告被删掉的、JSON 缺结论的、程序报错的、只看看帮助文档的、以及没跑过审核的普通对话。该拦的拦,不该拦的一律放行。
★ Insight ─────────────────────────────
- —
自动化工具的失败常常是「安静地失败」。跑失败了不吭声,比跑错了更麻烦,因为你会基于一个不存在的结果做决策。加一道产出物校验,成本很低。
- —
闸门要考虑「放行条件」而不只是「拦截条件」。只写拦截条件,会得到一个动不动就卡住的工具,最后你一定把它关掉。加上出口,工具才活得下去。
─────────────────────────────────────
06 · 六、想装的话,按这个顺序
经常写代码的:先装 security-guidance。它会盯着你改的每一处文件,碰上危险写法就提醒,其中一层还会在你提交代码时自己再复查一遍。
想少被 AI 糊弄的:装 code-review。它的价值不在多几个 Agent,在于它敢少说话。
带人或者自己学:装 learning-output-style,它会在关键的地方停下来问你。
想省事的:commit-commands 那三个命令,把你从「改完代码还要切浏览器开 PR」里解放出来。
装的方法原文说得没错,一条命令:/plugin install security-guidance@claude-plugins-official
两个前提提醒你:code-review 需要本机装了 gh 并登录过;security-guidance 的复审会额外消耗额度,额度敏感可以用官方提供的开关关掉。
07 · 七、最后说说核对的边界
这篇东西写得比我预想的费劲,而且过程中我推翻了自己三次。
一开始我以为抓到了 5 处错误,写完核对表才发现真正站得住的只有 1 处。这个过程比结论更值得分享:
判断一句话对不对,先要找到它可能从哪来。 我看到命令文件没有打分,就认定原文在编——可原文引的很可能就是那份写着打分的 README。同一个东西,三份官方文档三个说法,我挑了对自己有利的那份当证据,这就不是核对了,是找茬。
「我没找到」永远不等于「它不存在」。
现在关于 AI 工具的信息,转得比核得快。一篇文章在群里转几百次,里面那个错数字就可能被写进几十个人的方案里。
所以我的建议很简单:看到具体数字和具体版本号,先别急着存,也先别急着骂。能自己查的,就花几分钟查一下。
关注 【AI扫盲班长.長青】
AI工作流实战派 | 工具深度拆解 | 避坑指南 | 方法可复制
关注 【AI扫盲班长.長青】
把工具用明白,把方法讲清楚。
欢迎点赞 · 关注公众号