ARTICLE · 1043666
高中数学的底层逻辑:概率与统计到底在学什么?
高中数学的底层逻辑:概率与统计到底在学什么?一、概率与统计—— 对付 "数学搞不定的事" 在学概率统计之前,你接触的所有数学,本质上都是确定性数学。 代入 x,就有唯一确定的 y。 解一个方程,答案就是那几个数。 但现实世界呢? 抛硬币会不会正面朝上? 明天会不会下雨? 蒙一道选择题能不能对? 这些事,确定性数学解决不了。 于是就有了统计和概率。 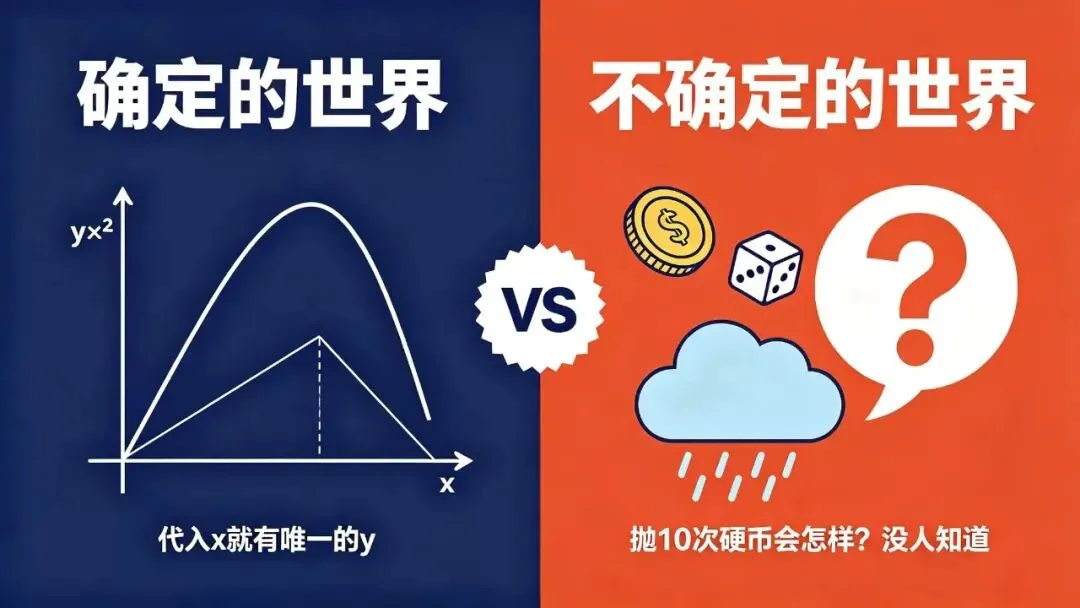
统计:从一堆乱数据里 "抠规律" 说白了就是事后总结。 📌 举个例子:全班 50 个人的数学成绩,就是 50 个杂乱的数字。但算出平均分、中位数、标准差之后,你立刻知道 —— 班级整体怎么样?两极分化严不严重?你排在哪? 概率:用规律去 "猜未来" 说白了就是事前预判。 📌 举个例子:知道均匀硬币正反各 50%,就能预测抛 100 次大概 50 次正面;知道二项分布,就能算出 "蒙 10 道选择题对 6 道" 的概率。 一句话记牢:概率统计,就是数学从 "描述确定世界",拓展到 "描述不确定世界" 的产物。 它不是为了考你排列组合。 是为了让你在充满随机的现实里, 也能做个理性人。 二、出题人最爱挖的坑?—4 个边界条件 每个数学概念都有自己的适用范围。 超出边界, 就错。 而概率统计里的边界, 恰恰是选择题最爱挖坑的地方。 坑 1:古典概型 ——"有限 + 等可能",少一个都不行 很多同学只记得 "P = 有利结果数 ÷ 总结果数"。 却忘了它有两个严格前提: • 所有结果必须有限个; • 每个结果发生的可能性完全相等。 ✅ 正例:掷一枚均匀骰子,6 种结果,每种 1/6,没毛病。 ❌ 反例 1:抛图钉,只有 "钉尖朝上" 和 "钉尖朝下" 两种结果,但根本不等可能。直接说 1/2,错。 ❌ 反例 2:掷两枚骰子,求 "点数和为 2" 的概率。有人说 "点数和从 2 到 12 共 11 种,所以 1/11"——大错特错。 因为这 11 种和的概率根本不一样: • 和为 2,只有 (1,1) 这 1 种; • 和为 7,有 (1,5)(2,4)(3,3)(4,2)(5,1) 这 5 种。 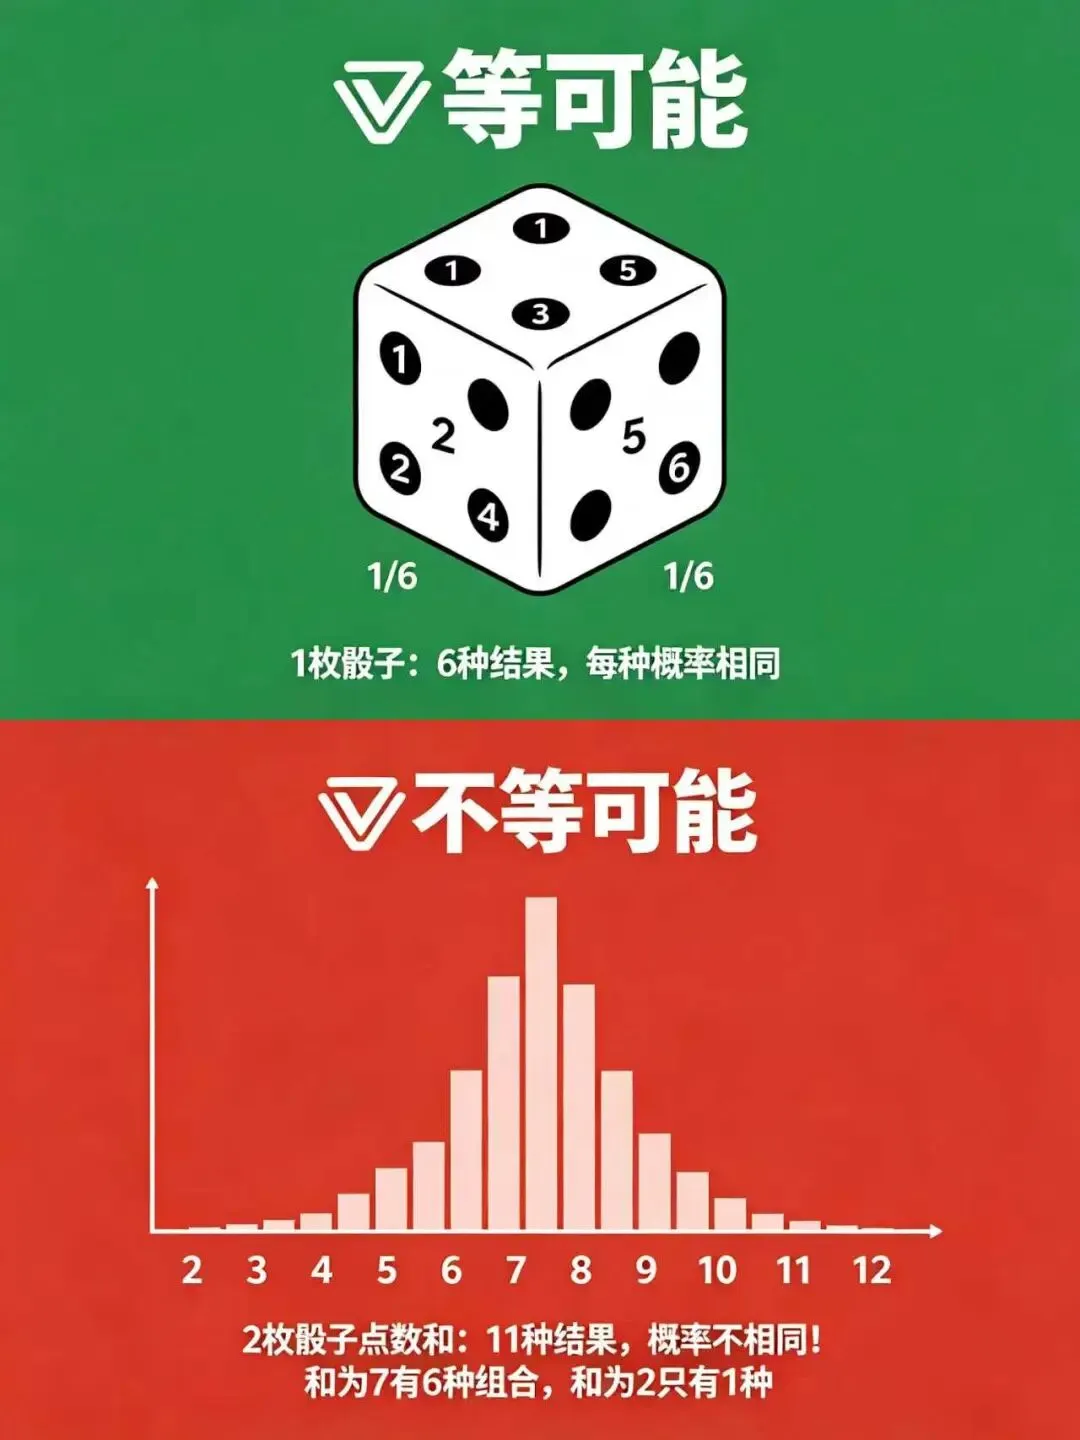
一句话记牢:做古典概型题,先别急着数个数,先问自己 —— 这些结果是等可能的吗? 坑 2:互斥 ≠ 独立,完全是两回事 这是选择题最高频的易混点。 • 互斥事件:A 和 B 不能同时发生,P (AB)=0。 • 独立事件:A 发生不影响 B 发生的概率,P (AB)=P (A)・P (B)。 很多同学以为 "互斥就是独立"。 恰恰相反:互斥的事件,一定不独立。 📌 抛一次硬币,"正面" 和 "反面" 是互斥的 —— 出了正面就不能出反面。但它们显然不独立:正面发生了,反面就一定不发生,互相影响极大。 📌 抛两次硬币,"第一次正面" 和 "第二次正面" 是独立的 —— 第一次的结果不影响第二次。但它们不互斥:可以两次都是正面。 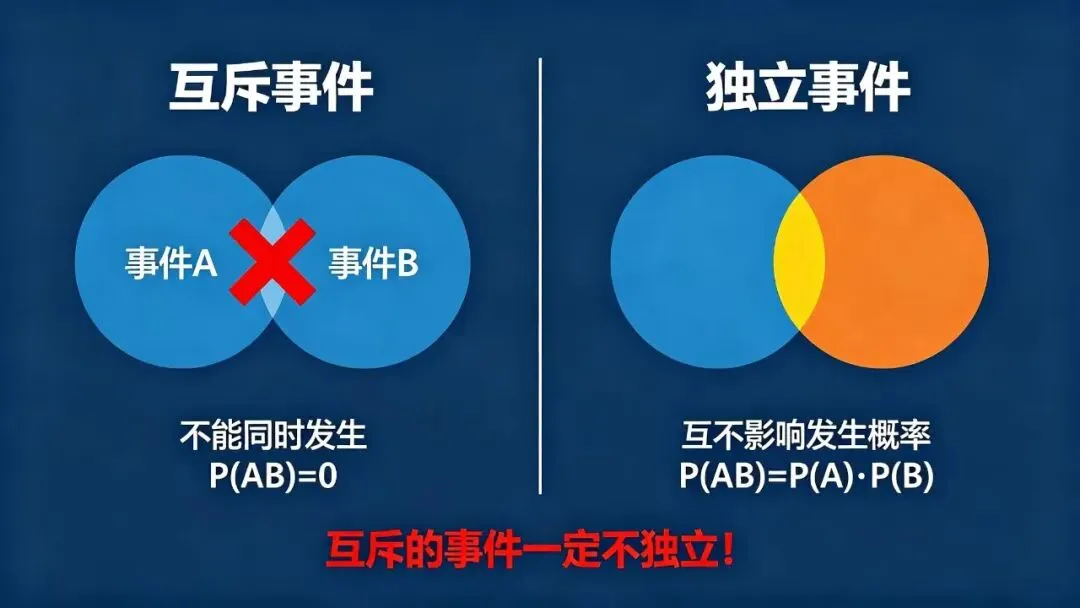
一句话记牢: 互斥是 "不能同时发生", 独立是 "互不影响概率", 完全是两个维度。 坑 3:样本有偏,结论全废; 相关 ≠ 因果 统计里的坑,更多是逻辑坑。 📌 抽样的边界:你想调查全校平均身高,只抽篮球队,结果肯定偏高。样本选得不对,算得再精准也没用。 📌 相关性的边界:统计发现,冰淇淋销量越高,溺水死亡的人越多。难道冰淇淋导致溺水? 当然不是。 是因为夏天气温高,冰淇淋卖得多,游泳的人也多。两者只是相关,没有因果。 一句话记牢:回归分析、独立性检验,找的都是 "相关",别张嘴就说 "因果"。 坑 4:频率 ≠ 概率,别拿偶然当必然 • 概率是固定的理论值,硬币正面朝上就是 0.5。 • 频率是实际实验的比值,会波动。 📌 你抛 10 次硬币,可能 7 次正面,频率 0.7。但概率还是 0.5。抛 1000 次,频率才接近 0.5。 一句话记牢:大数定律说的是 "次数足够多,频率才稳定到概率"。有限次实验里,什么极端情况都有可能。 三、凭什么这么定义?—— 概率定义的 3 次进化 很多同学会问:概率的定义谁规定的?换一种不行吗? 其实,课本里的定义不是数学家一拍脑袋想出来的。 是经过了好几代人的迭代和修正。 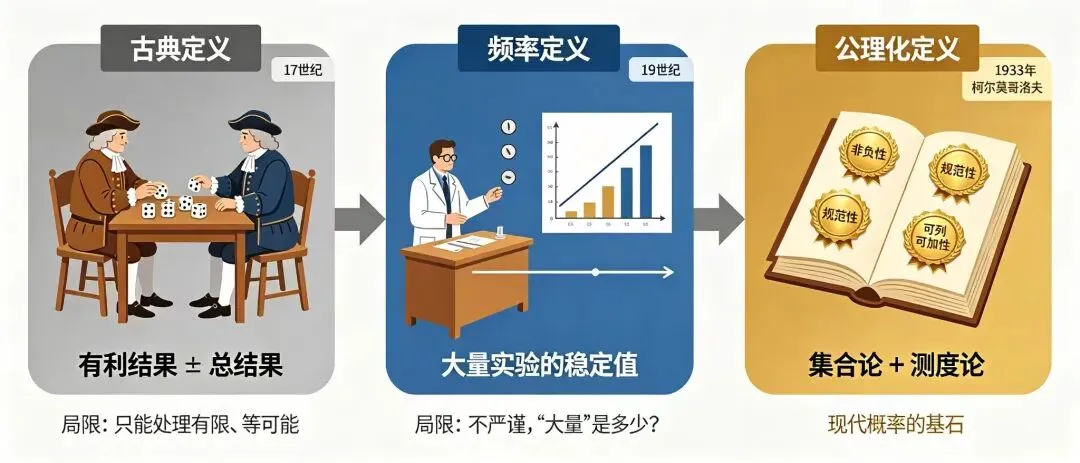
第一代:古典定义(有利结果 ÷ 总结果) 最早的概率就是这么来的,用来解决赌博问题。 简单好懂,但局限极大 —— 只能处理 "有限、等可能"。 问题来了:在一条线段上随便取一个点,取到中点的概率是多少? 总结果无限多,古典定义直接失效。 第二代:频率定义(大量实验的稳定值) 人们发现,重复实验很多次,频率会稳定在一个数附近。 这个定义很贴近现实,但不够严谨。 "大量" 是多少?1000 次还是 10000 次?"稳定" 怎么用数学语言严格描述? 没法严格定义,就没法做严谨的数学证明。 第三代:公理化定义(柯尔莫哥洛夫,1933 年) 直到 20 世纪, 数学家才用集合论和测度论,给概率下了严格的公理化定义: 把事件当成集合,概率就是集合的 "测度"(可以理解成面积、体积),只要满足三条公理: • 非负性:概率不能是负数; • 规范性:必然事件的概率是 1; • 可列可加性:互斥事件的概率可以相加。 ❓ 那高中为什么不学这个? 因为太抽象。课本从古典概型、频率讲起,是符合认知规律的 —— 先学具体的,再接触抽象的。 ❓ 换一种定义行不行?比如把概率定义成 "我觉得这件事有多大可能"(主观概率)? 不行。 数学必须客观、可验证、能逻辑推导。主观概率没法做严谨运算,也就成不了数学分支。 一句话记牢:能被验证的,才叫数学。 顺便说:为什么要有平均数、中位数、众数? 不是数学家没事找事,是它们分别描述数据不同的中心趋势。 • 平均数:用到所有数据,最精准,但容易被极端值带偏。适合数据分布均匀的场景。 • 中位数:只看中间位置,不受极端值影响。统计社会收入时,中位数比平均数更能代表普通人。 • 众数:看出现次数最多的数。鞋店进货要知道卖得最好的鞋码,这时候用众数。 一句话记牢:三个 "中心",解决三种不同的问题。 四、它和前面学的东西有啥关系? —— 一张图看懂逻辑链 高中数学是一条完整的链。 概率统计不是飘在外面的孤岛。 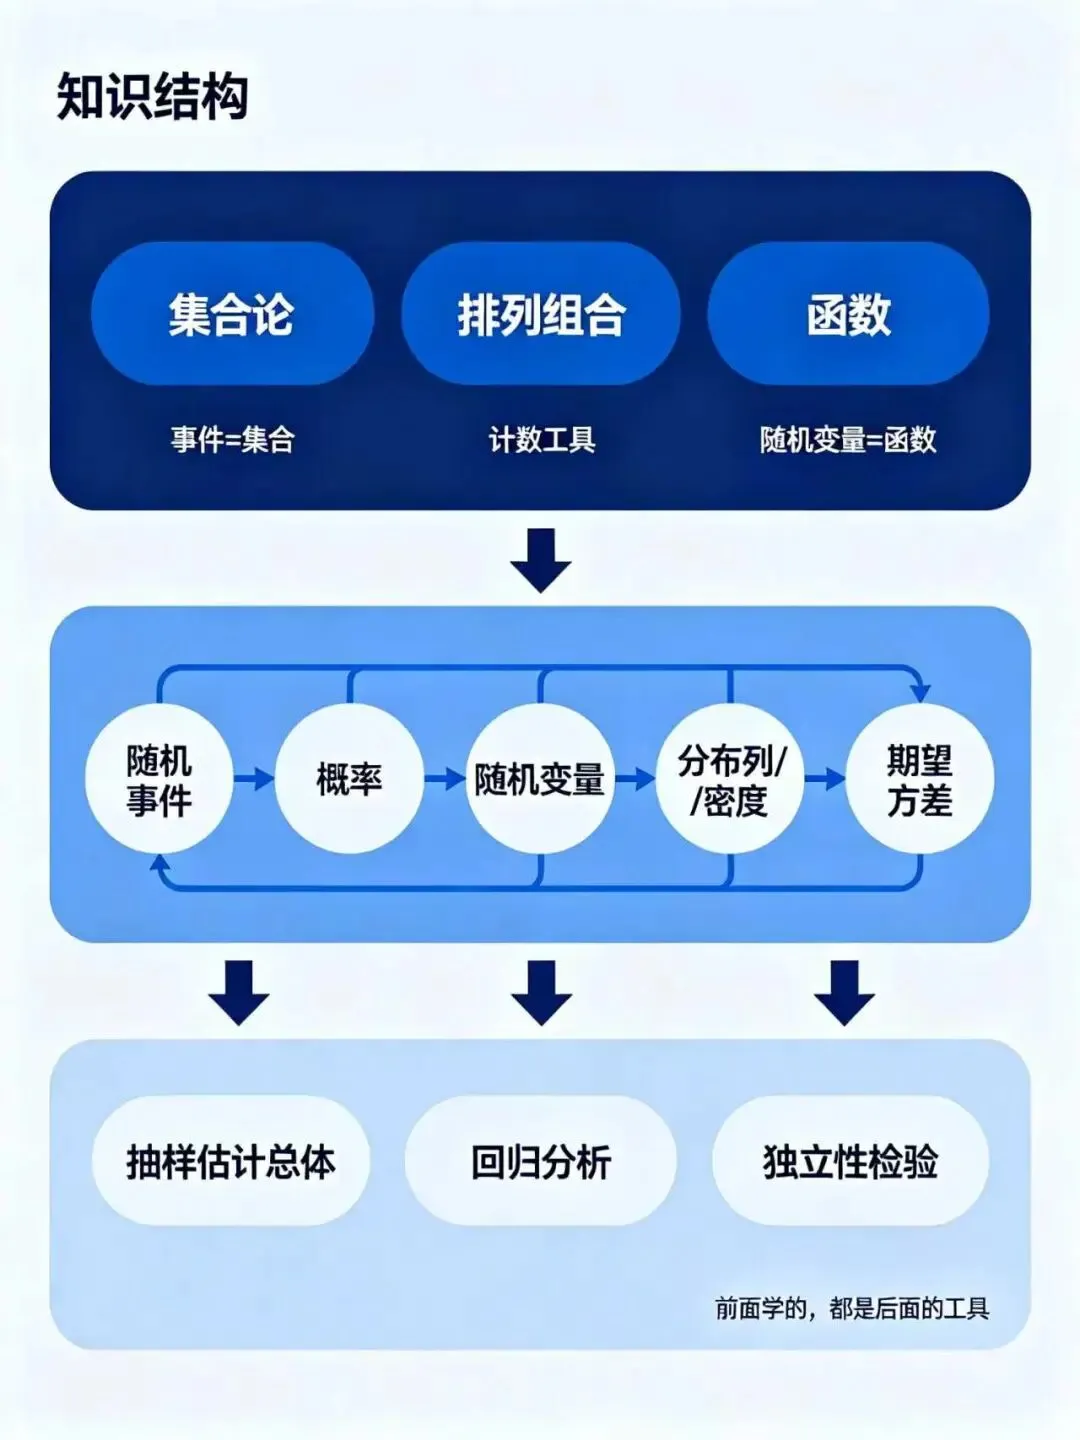
前置知识: 你概率题总做错,根源可能在前面 很多同学觉得概率难, 其实不是概率本身难。 是前置知识没掌握牢: • 集合:事件的关系与运算,本质就是集合的交、并、补。互斥事件 = 交集为空,对立事件 = 互为补集。 • 排列组合:古典概型的核心就是 "计数"。总情况数、有利情况数算不对,概率肯定错。 • 函数与实数:随机变量本质上就是 "把事件映射成数字" 的函数;期望、方差本质上就是加权平均。 内部逻辑链:从事件到统计 整个概率统计模块,顺着这条线一步步推进: 随机事件 → 概率的定义与运算 → 随机变量 → 分布列 / 密度函数 → 期望、方差 → 抽样方法 → 用样本估计总体 → 回归分析与独立性检验 前面每一步,都是后面的基础。 二项分布学不好, 往往是独立事件、n 次重复试验没理解透。 统计题只会套公式, 往往是没理解 "用样本估计总体" 这个核心思想。 它是超多领域的基础 别觉得高考完就没用了。 它是大学超多专业的核心基础: • 理工科:人工智能、机器学习、统计物理、信号处理; • 商科:金融风险、保险精算、数据分析; • 文科:社会学调查、心理学实验、计量经济学。 一句话记牢:前面学的,都是后面的工具;别孤立地学。 学概率统计,到底学的是什么? 
概率统计教你的不是怎么算排列组合。 也不是怎么背公式算方差。 它教你的是一种在不确定中理性思考的能力: • 看到 "90% 概率",不会当成必然事件; • 看到 "统计数据",会先想想样本合不合理; • 遇到随机事件,不会被直觉和运气牵着走。 这才是底层逻辑。 也是数学真正留给你的东西。