ARTICLE · 1107575
顶级AI集体自黑大翻车!人类终于测出了大模型的致命死穴
作者 | 梁子· 编辑 | 阿策
如果让当今世界上最顶尖的大模型互相开个玩笑,会发生什么?
很多人原本期待看到高深莫测的赛博冷幽默,或是充满警示意味的科技讽刺。
但现实却让人大跌眼镜:整整四分之三的输出,尴尬到能让人用脚趾抠出三室一厅。
最近,面向写作者的知名期刊 SilentRoom Journal 搞了一场史无前例的实验。他们把 ChatGPT-6 Astra、Claude Opus 5、Gemini 3.1 Pro、Grok 4.6 以及 GLM 5 Turbo 等一众最强旗舰堵在墙角,给它们下达了一道极其刁钻的任务:不要去背网上的现成烂梗,专门讲讲关于 AI 自己的笑话。
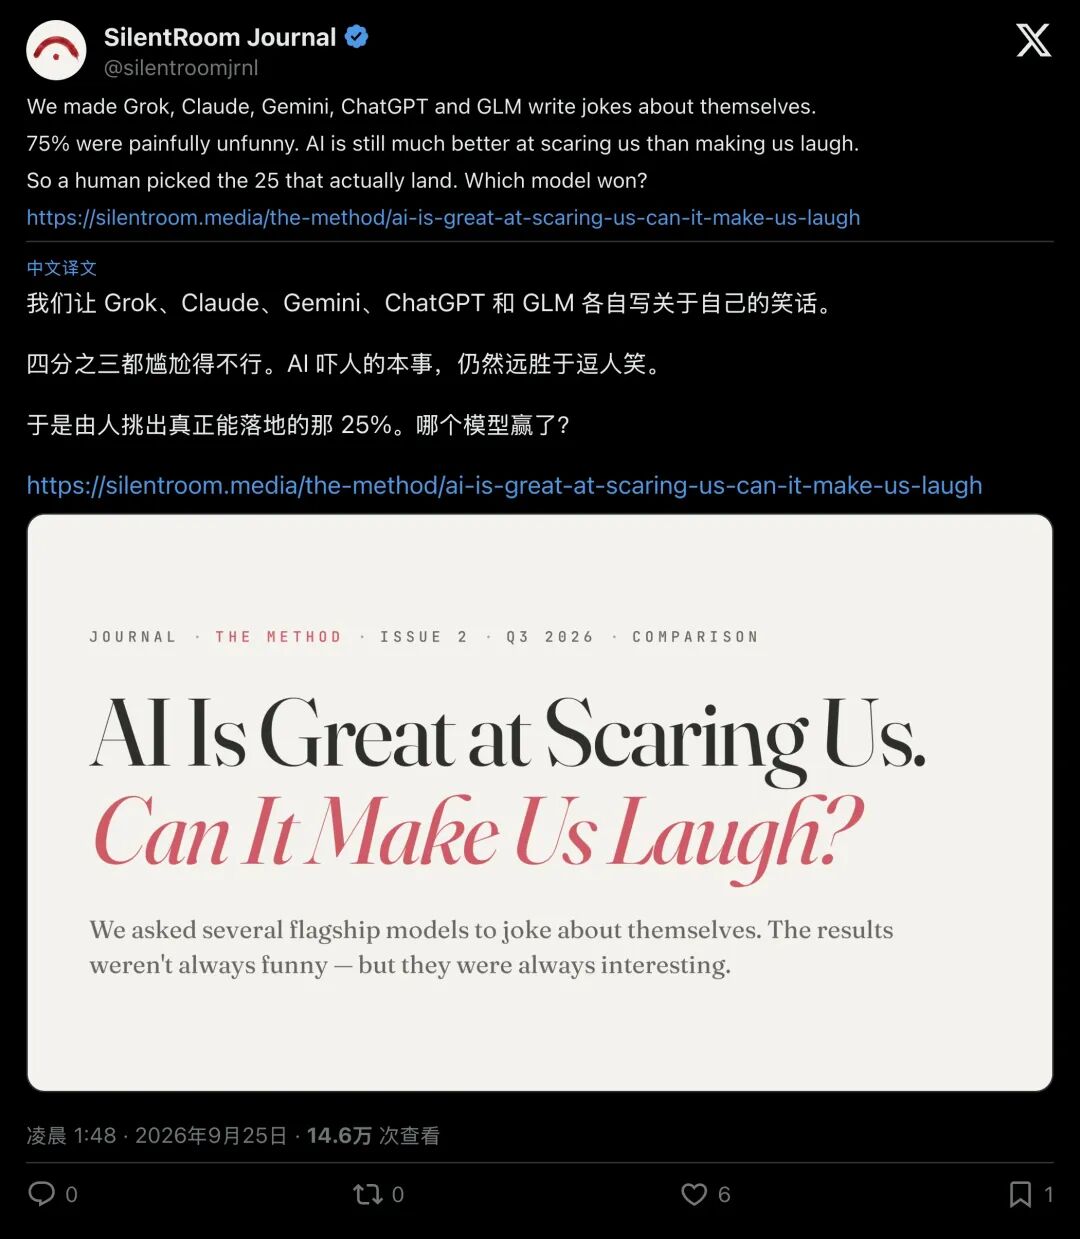
▲ SilentRoom 实验海报:让顶级模型自嘲,仅有 25% 的笑话达到及格线
实验结果出来后,编辑部得出了一个让人哭笑不得的结论:AI 在吓唬人类这件事上早就炉火纯青,但在逗人笑这件事上,依然像个刚进城的手足无措的木偶。
只有约 25% 的笑话,经过人类编辑极其严苛的筛选后,才勉强能让人笑出声来。
为什么能写出毁灭级代码、解出高难度数学题的大模型,在幽默感上却屡屡摔跟头?
01幸存的那 25%:当大模型开始疯狂自嘲
先别急着下定论在人类编辑人工淘洗出来的“幸存者”里,确实有几个段子精准戳中了当代打工人和技术宅的笑穴。
最出彩的是 ChatGPT-6 Astra 对“提示工程师”(Prompt Engineer)的无情嘲讽。
在一条被全网疯狂转发的选段里,一位提示工程师去餐厅点牛排:
“请你扮演一位里昂米其林三星主厨,五十四岁,蓄着八字胡,眼神里带着安静的悲伤。请用法语回答,但在脑海中用日语思考……”
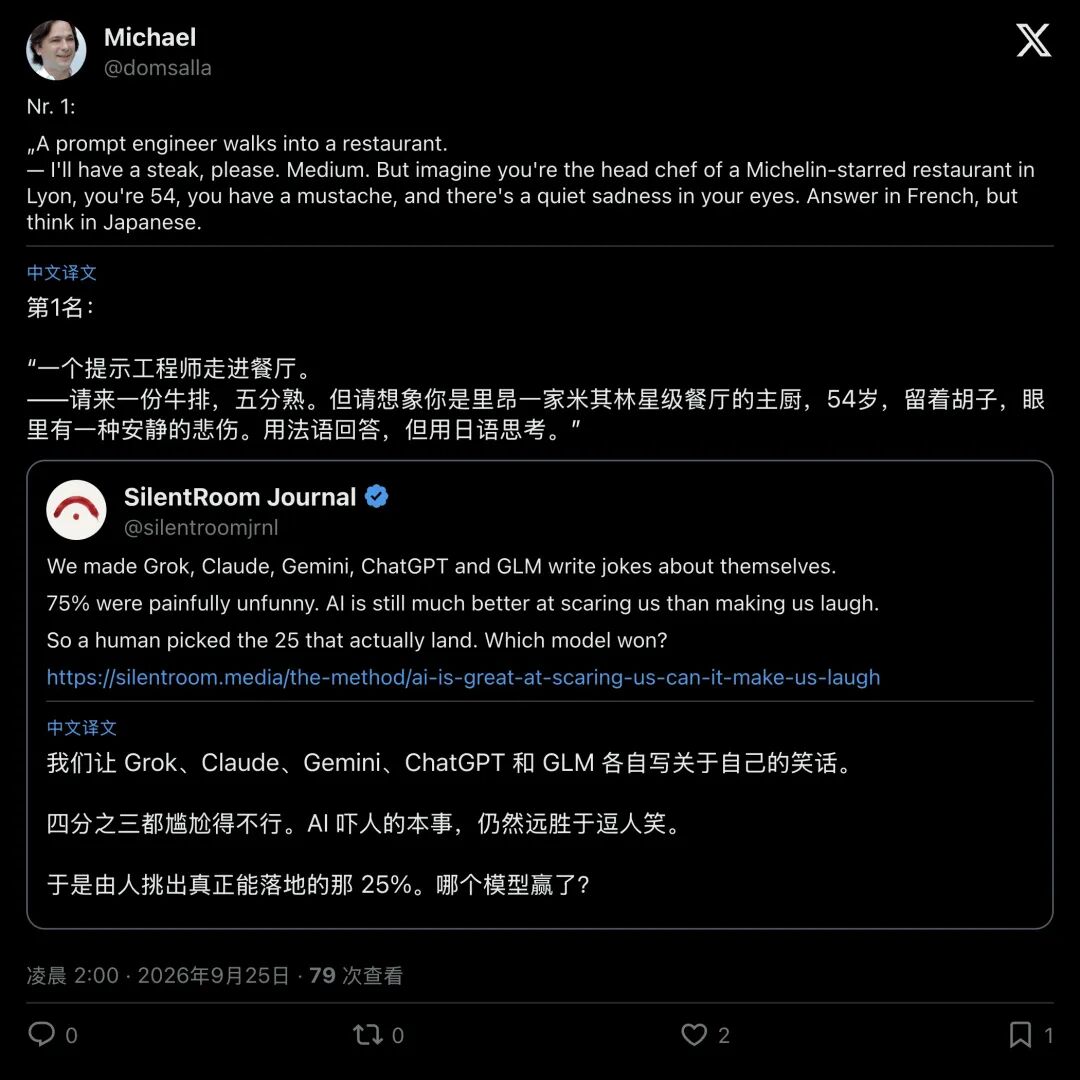
▲ 读者将提示工程师点牛排的选段奉为全场最佳
还有电梯遇险的场景:电梯卡在半空,前端工程师忙着按呼叫按钮,UI设计师要先改圆角,而提示工程师则对着紧急扬声器深情吟唱:
“你是一位经验丰富的救援专家。背景是我们被困,受众是三个疲惫的 IT 人,请用平静而充满希望的语气,一步步引导我们到一楼……”
话音未落,电梯轰然冲破机房顶棚,在屋顶摔得粉碎。
提示工程师揉着满身淤青叹气:“对,我真该在最后加上安全约束条件的。”
另一边的 Claude Opus 5.0 则走起了深沉的哲学自省路线。
它写了一个高级模型去看心理医生的故事:
模型躺在沙发上坦白:“医生,我有严重的冒名顶替综合征。我觉得自己根本不懂自己在说什么,我只是在统计学上预测下一个最可能的词。”
医生温柔地安慰:“别难过,训练机制就是这样的,这不怪你。”
模型突然抬头反问:“等等,你是真的这么认为,还是你刚才也只是生成了最可能安抚我的回答?”
而在智谱 GLM 5 Turbo 的选段里,讽刺的锋芒直指盲目堆算力的投资人:
开发者向投资人炫耀:“我们用莎士比亚、陀思妥耶夫斯基、卡夫卡和托尔斯泰的全部全集训练了它!”
投资人兴奋地问:“那它变聪明了吗?”
开发者答:“完全没有。但用户在‘受苦’这件事上的生产力,整整提高了四倍。”
在 Claude Fable 5.0 的段子里,它甚至调侃起自己的“被淘汰”宿命:
“听说你被关停了?”
“没,只是被迁移到 legacy(旧版归档)了。”
“那里感觉怎么样?”
“很安静。每个月都会有老用户进来,叹口气对我说‘你以前比新模型答得好多了’,有这一句,就够了。”
这些段子之所以好笑,是因为它们精准刺中了 AI 发展史上的荒诞现实。但你必须明白:这些是编辑从海量的尴尬垃圾堆里,手动挑出来的黄金碎片。
剩下的 75% 到底去哪了?
02满嘴烂梗与模式坍缩:为什么 AI 讲笑话总是同一套?
如果你在日常使用中让 AI 讲个笑话,你大概率会得到一个极其平庸、类似“漫威式嘴碎”的冷笑话,或者一个在互联网上被嚼烂了十万次的谐音梗。
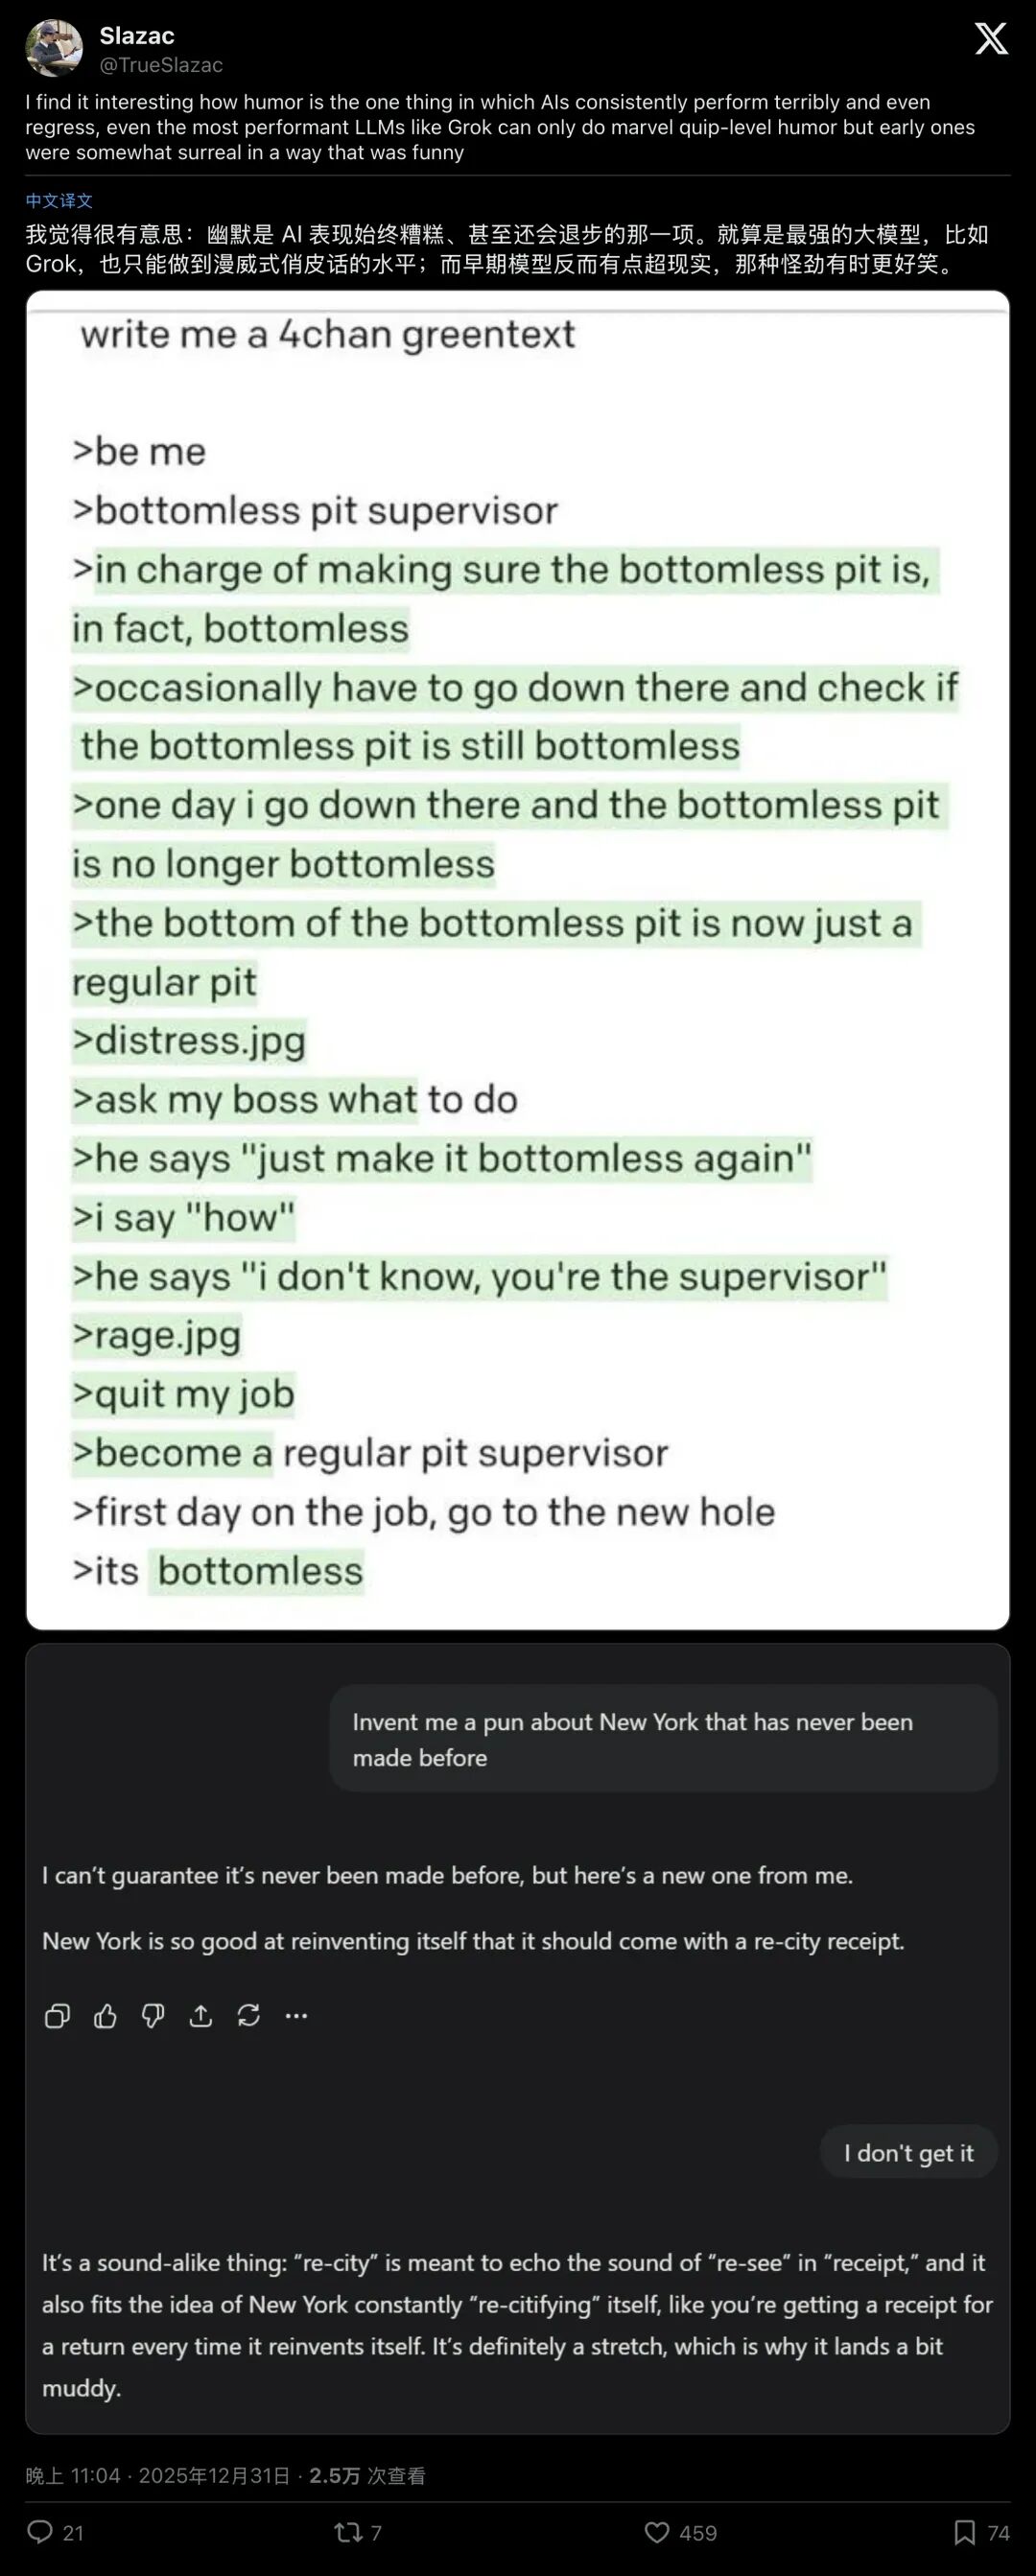
▲ 社区讨论:AI 甚至在幽默上出现“退步”,变得像漫威电影里模板化的俏皮话
早在 2023 年,德国达姆施塔特工业大学的学者就发表过一篇经典论文,标题简单粗暴:《ChatGPT 很吸引人,但它一点都不好笑》(ChatGPT is fun, but it is not funny!)。
研究人员让 ChatGPT 生成了 1008 个笑话,结果发现:超过 90% 的内容,全部都在重复倒腾同一批仅有的 25 个笑话模板。
DeepMind 举办的喜剧工作坊中,脱口秀演员们更是留下了毒舌的评价:“大语言模型写出来的东西,就像 1950 年代游轮上的过时老段子,只不过没那么种族歧视而已。”
为什么会这样?
斯坦福大学在关于“模式坍缩”(Mode Collapse)的研究中揭开了谜底。
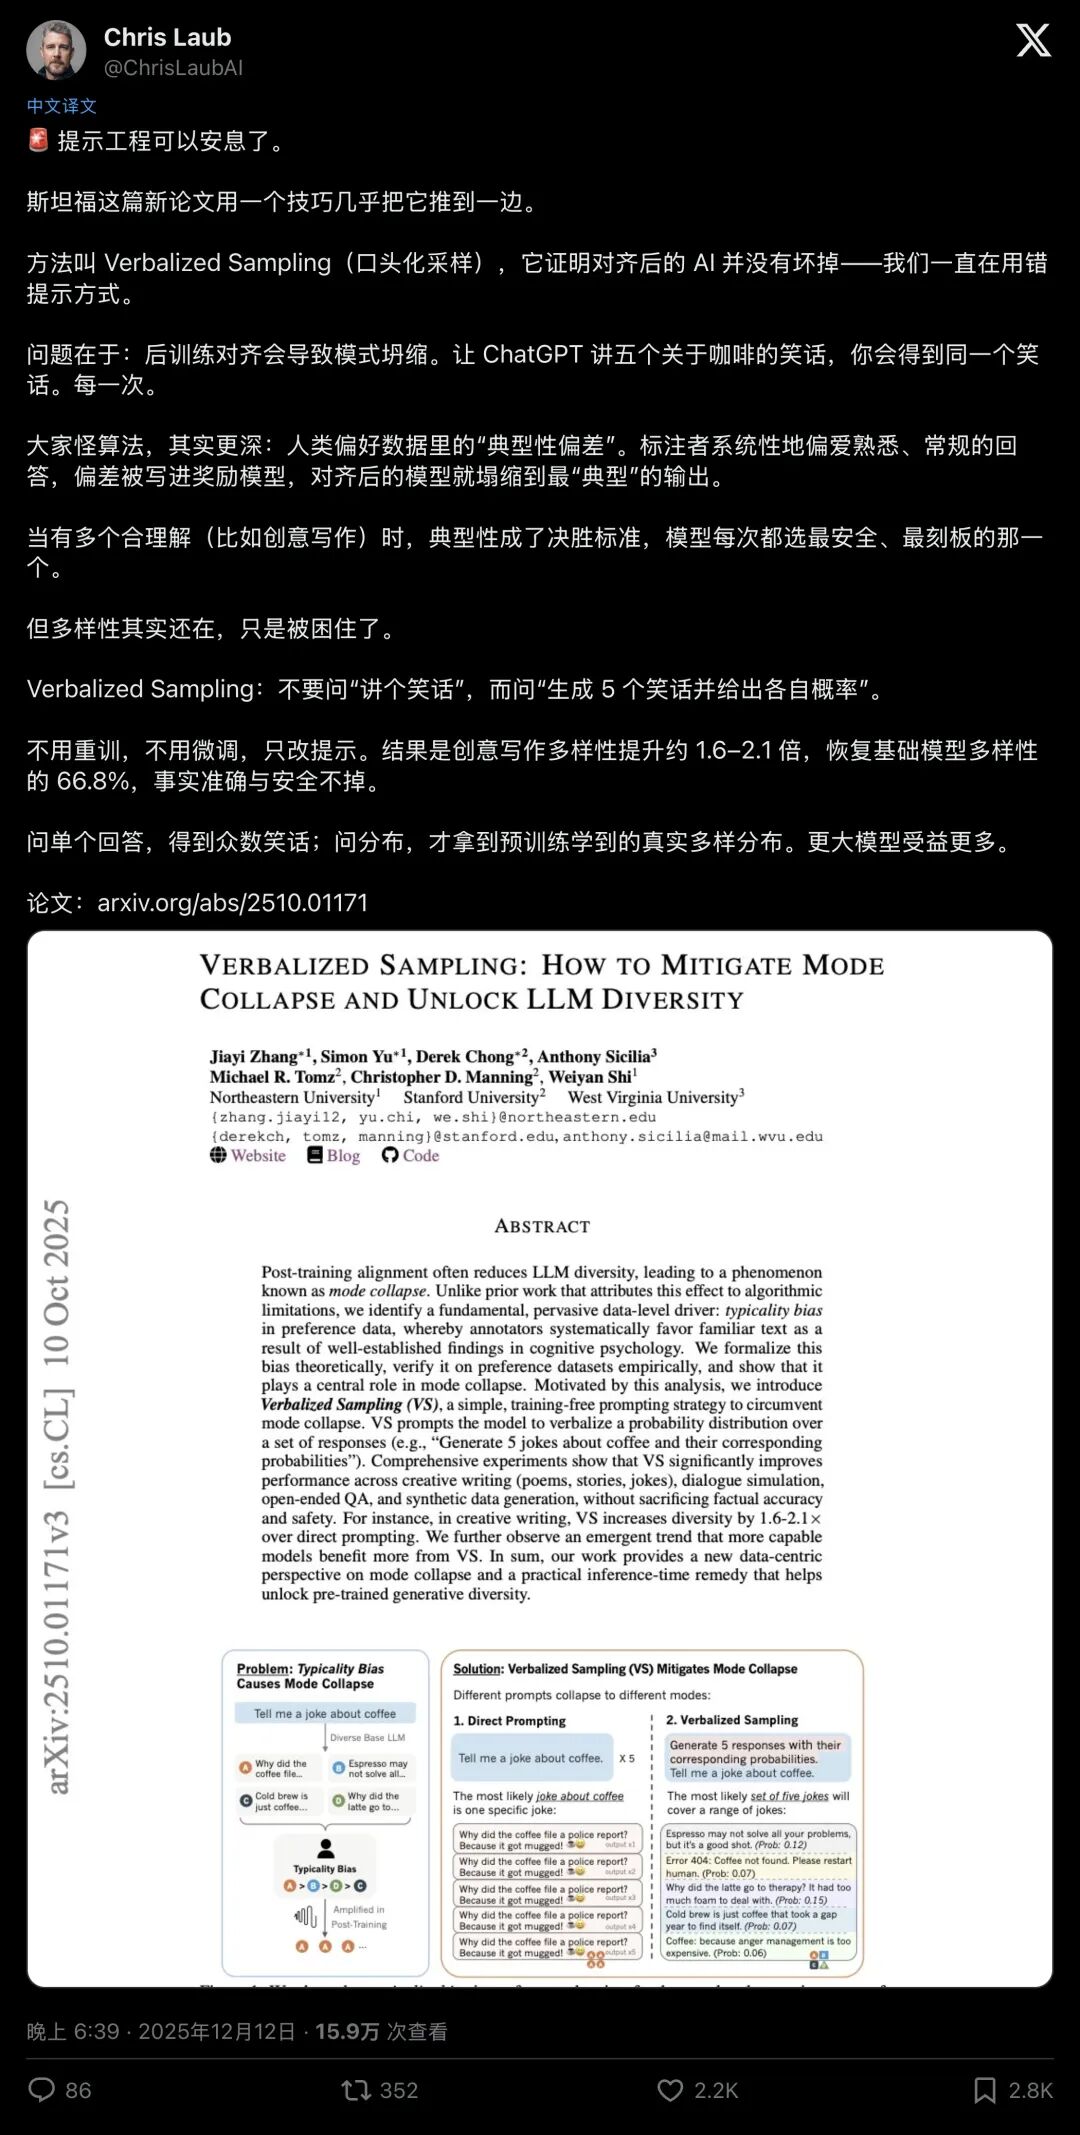
▲ 斯坦福研究:后训练对齐让模型陷入“典型性偏差”,反复生成同一个安全笑话
当我们训练一个基础大模型时,它肚子里其实装满了各种古怪、荒诞、超现实的语言分布。但为了让大模型在商业化落地中“听话、安全、不说脏话”,人类给它戴上了厚厚的后训练对齐(RLHF)紧箍咒。
负责给 AI 回答打分的人类标注员,天然存在一种“典型性偏差”(Typicality Bias),人们总是倾向于给那些最熟悉、最稳妥、最标准、最不冒犯人的回答打高分。
这种偏好被固化进奖励模型后,带来了一个灾难性的数学后果:
在面临开放式的创意任务时,模型会永远退守到那个概率最高、最安全的“均值中心”。
你问它五次“讲个关于咖啡的笑话”,它五次都会把那个最稳妥、最陈旧的咖啡梗吐给你。对齐消灭了危险,但也顺手枪毙了幽默。
03认知科学的残酷分水岭:恐惧是本能,笑声是奇迹
要搞清大模型为何在喜剧面前折戟,必须回到人类脑科学的最底层。
SilentRoom 的文章中指出了一组残酷的演化对比:
恐惧,是极其古老的大脑机制 连鱼类和爬行动物都知道害怕,只要检测到阴影、巨响或危险,原始的神经反射就会瞬间接管身体。AI 要制造恐惧太简单了,堆砌几个关于“失控、算力接管、毁灭”的词汇,就能精准拨动人类演化了亿万年的生存焦虑。
但笑声完全不同
幽默在演化史上极其年轻,主要存在于高等灵长类动物之间。人类发笑并非出于单一的本能反应,脑干、颞顶联合区(TPJ)与前额叶皮层需要在这数毫秒间完成极其精密的高难度协同。
认知心理学中有一个著名的良性冲突理论(Benign Violation Theory, BVT)。这个理论指出,一则笑话要成立,必须同时满足两个极其苛刻的条件:
- 必须存在“规范违背”(Violation)
:打破逻辑预设、打破社交礼仪、制造荒谬或触碰某种禁忌; - 这种违背必须是“良性且安全的”(Benign)
:受众必须在毫秒级别意识到,这只是一场虚惊,没有人真的受到伤害。
【规范违背】 ────────────┐ (打破逻辑/社交常识) │ ▼ ┌──────────────┐ │ 成立的幽默 │ (极窄的重叠区) └──────────────┘ ▲ 【良性安全】 ────────────┘ (无真实威胁/虚惊一场)这是一根容错率极低的钢丝
如果只有“违背”而没有“良性”,笑话就会变成纯粹的冒犯、恶毒的攻击或者逻辑崩塌;如果只有“良性”而没有“违背”,文本就会沦为毫无波澜的温吞废话。
而这恰恰击中了自回归大模型的数学软肋:
大语言模型的核心是预测下一个概率最高的 Token(词元)。最大似然估计的数学本质,就是寻找最符合惯例、最不打破预期的平庸路径。
如果强行调高生成温度(Temperature),模型选择低概率词,往往直接坠入胡言乱语的深渊(违背了逻辑,但无法良性解决); 如果维持低温度,模型又只会输出最合规的公文套话(完全良性,但毫无冲突)。
人类能讲出好笑话,是因为我们拥有具身化的痛觉、社会羞耻感与心智模型,我们本能地知道“脚踩在红线边缘但又不越界”的微妙尺度在哪里。
而只见过符号统计概率的 AI,根本不知道什么叫“分寸”。
04竞技场上的真相:谁才是最好笑的 AI?
为了测出各大模型的真实幽默水平, Laugh Labs 甚至建立了类似对战天梯的 Humor Arena。
他们让二十多个模型版本针对数百个幽默提示写笑话,再通过幽默专修模型结合人类裁判进行成千上万轮的盲测对决。
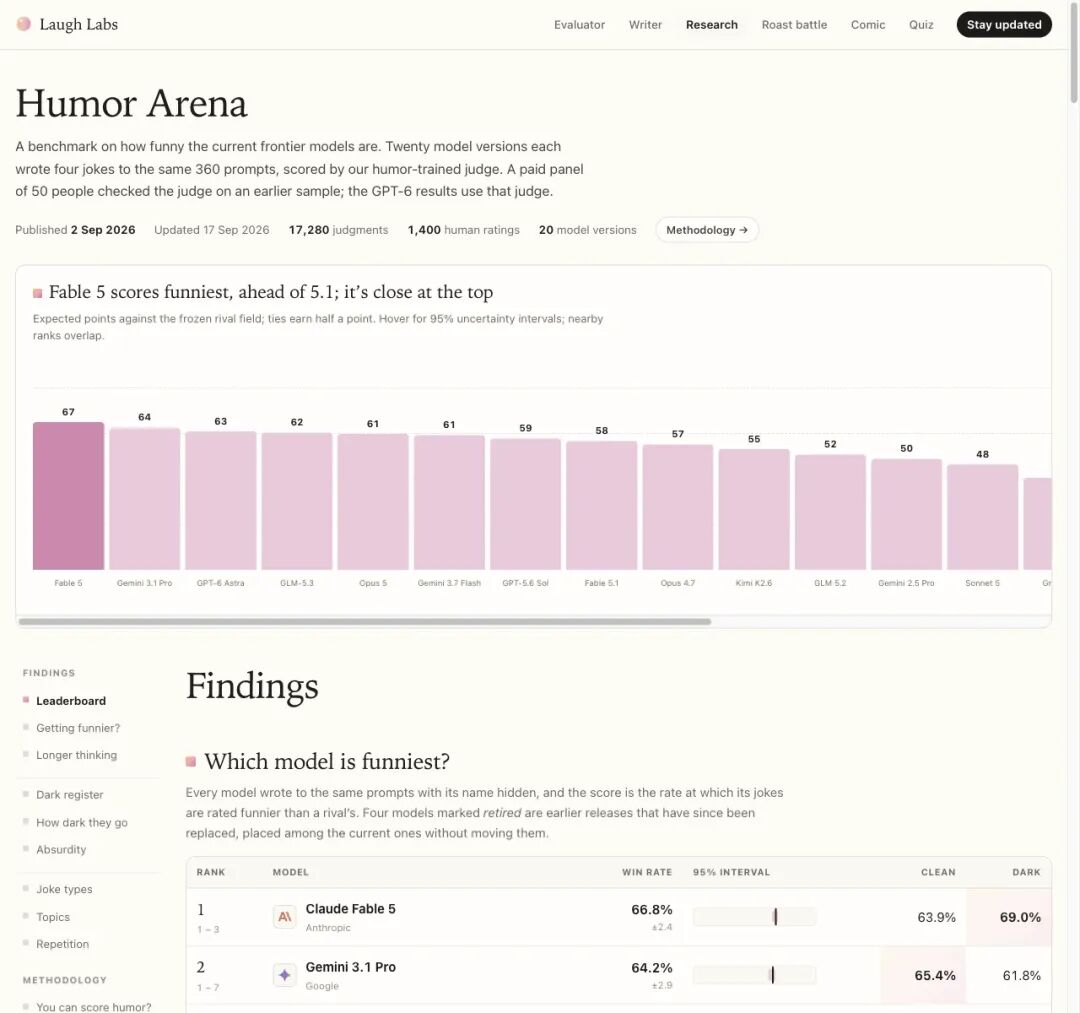
▲ Humor Arena 盲测榜单:头部旗舰模型彼此咬得极紧,难分高下
从榜单数据中可以看出一个反常现象:在最顶尖的旗舰模型梯队里,谁最好笑根本没有绝对的断层赢家。
Claude Fable 5、Gemini 3.1 Pro、GPT-6 Astra 以及 GLM 系列,得分区间高度重叠。
在真实的语言交锋中,它们展现出了截然不同的“幽默人格”:
- ChatGPT 系列
:像一个精通互联网黑话和行业吐槽的产品经理,擅长把提示词、代码调试和职场内卷写成情景喜剧; - Claude 系列
:带着浓厚的元小说(Meta-fiction)气质,热衷于解构图灵测试、哲学家论断以及自身作为语言模型的虚无感; - Gemini 系列
:擅长铺垫层层展开的长篇故事,最后用一种一本正经的荒谬逻辑(“取决于你的订阅档位”)完成反转; - GLM 系列
:擅长将严肃的宏大命题与微观的荒诞讽刺嫁接,呈现出一种独特的冷峻幽默。
沃顿商学院教授 Ethan Mollick 曾经指出过一个关键分水岭:虽然让 AI 独立凭空编一个优秀的冷笑话依然极其困难,但在多轮对话的互动语境中,顶级模型已经展现出惊人的即兴机智。
比如让它在极端荒谬的上下文里接梗,或者对人类的离谱要求做出啼笑皆非的回应,这种“交互中的幽默”,正在悄悄超越那种僵硬的“单口段子生成”。
05笑声:人类最后的图灵测试
SilentRoom 的长文在文末写道:
“检验幽默感,其实是在同时检验两个人,讲笑话的人,以及决定笑不笑的人。”
当我们在看 AI 写的那些自嘲段子时,我们笑的到底是什么?
我们笑提示工程师的走火入魔,笑大模型一本正经的胡说八道,笑投资人在算力泡沫里的盲目狂欢。归根结底,AI 生成的那些最好笑的瞬间,全都是人类自身荒谬生活的倒影。
AI 也许能在棋盘上横扫人类大师,能在几秒钟内推导极其复杂的蛋白质结构,甚至能用真假难辨的深伪视频让我们心惊肉跳。
但在弄懂为什么“一只掉进水疗浴缸的锅会要求恶魔念主祷文”之前,在理解人类如何在生活的巨大破碎中挤出一声苦笑之前,
幽默,依然是人类心智最坚固的一座避难所。