ARTICLE · 1126947
Agent 不需要记忆,需要的是文档
一个AI记忆插件的典型工作方式:分析你的对话,生成1000条碎片,塞进向量数据库。每次你发指令,它检索最相似的5条附加上去。如果Agent搞不清楚,它再手动搜一波。这套东西,名字叫"记忆"。
听起来很熟悉。几乎所有记忆插件都长这样:
翻会话记录 生成"记忆"碎片 存入RAG数据库 每次prompt检索Top 5注入 不够?给Agent一个搜索工具让它自己翻
有的更花哨,搞长期短期记忆分层,加后台daemon做去重,加"梦境者"夜里重写记忆,加reranker。但插件们拼命烧token,修来修去还是同一套有缺陷的架构。
仔细想一下你真正要解决的问题:你希望Agent理解你的项目,知道某个功能在哪、为什么这样设计、你们之前达成了什么共识。结果你得到的是一堆RAG碎片的抽奖,每次prompt注入5条,赌它们正好能浮上来。
即使偶尔赌对了,Agent仍然不理解你的项目。
liao.gg (https://liao.gg/blog/agents-dont-need-memory) 上的一篇文章对这一现象给出了明确的诊断:记忆插件整个生态都在解决错误的问题。
RAG式记忆的五个硬伤
所有记忆插件都绕不开这几个问题:
相似性检索只看距离,不看对错。 向量检索只关心两条embedding离得近不近,不关心哪条是对的、哪条是新的、缺了什么关键信息。
碎片脱离上下文。 一条RAG片段能塞的信息有限。动机、环境、当时的约束、踩过的坑,全丢了。
过去被当成事实。 代码每天都在变。那500条关于authentication(认证)的碎片,现在还有几条是准的?你没法知道。
Agent不知道自己不知道什么。 就算给Agent一个搜索工具,它怎么会知道自己该搜什么?不知道就是不知道。
存储不可审计。 一万条embedding躺在SQLite里。哪些是旧的?哪些从没被检索过?哪些正在偷偷带偏Agent的判断?你连错在哪都查不出来。
这些问题指向同一个根因:所有记忆插件都默认"Agent忘了东西,所以得帮它记住更多"。于是拼命抓取、索引、检索。但这不是人类处理知识的方式。没人会去翻三年前的会议录像来确认一个功能的约束条件。大家把事情记下来,然后查记录。
换个思路:文档,不是记忆
代码项目里,人们写README、写spec、写决策记录,干活前查阅,干完活更新。Agent也可以这样。
给Agent一个可读可写的Markdown工作区,里面有指令、规格、决策、索引、调研笔记。干活前先查阅相关文档,干完活更新过期的内容,把新结论记下来。
工作循环从 prompt → build → forget 变成 prompt → consult → build → update。
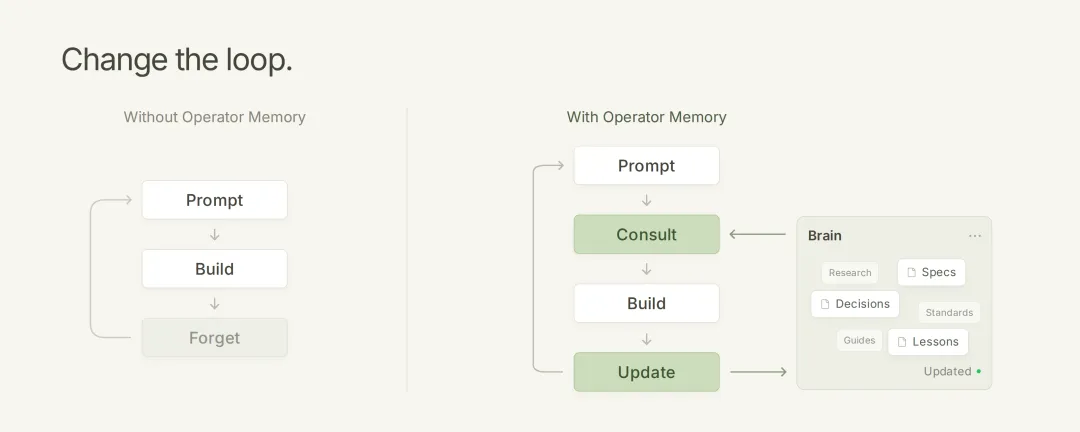
不需要向量库,不需要embedding,不需要一堆后台进程。每个文档你都能直接看、直接改、直接提交、直接跟团队分享。
这个思路作者已经用了一年多,还开源了一个插件叫 Operator Memory (https://github.com/aerovato/operator-memory),支持Claude Code、Codex、OpenCode等多个平台。安装就是一行npm命令,初始化后Agent会自动在工作区里维护文档。
它把知识分三层存放:.operator/ 是私有项目知识,.operator-shared/ 可以跟仓库一起推送,~/.operator/user/ 放个人规则跨项目共用。每次会话都是同一套循环:查阅已有知识、干活、更新文档。
也有人不同意
游戏开发者 Mario Zechner(libGDX作者)说:
推荐阅读,但我仍然不同意。对代码来说,记忆和文档都不高效。你的代码库就是全部所需。让它模块化,让模块足够小,最多维护一张小地图指路。
有人支持这个说法:"代码库就是地图,Agent却老是问地图在哪。"
也有人反对:"文档和注释过期太快,会严重误导。"
Mario 回复了一条关于"agent不擅长写模块化代码"的评论:"你要是明确告诉它们怎么做,它们其实可以。"
还有人提了一个更微妙的角度:"大多数知识工作根本没有代码库,痕迹散布在十几个网站里,所以记忆插件才干了仓库该干的活。"
这倒是点出了关键。对纯代码项目,文档精简到一张地图确实够了。但那些没法用代码表达的东西,用户偏好、产品决策、跨系统依赖、调研结论,一个可维护的文档空间比抓取对话历史靠谱得多。
记忆插件本质上是在跟"遗忘"较劲。文档不是。文档是面向未来写的,只记录此刻值得留下的结论。Agent有了文档,至少你还能审阅它知道什么。那一万条embedding,你连错在哪都查不出来。
这场争论没有标准答案,但至少它逼你重新想一个问题:你到底希望Agent记住什么?是过去的聊天记录,还是当下的项目事实?
原文链接 :https://liao.gg/blog/agents-dont-need-memory
GitHub: https://github.com/aerovato/operator-memory
关注公众号回复“进群”入群讨论