ARTICLE · 1138284
React Hooks 源码深入解析:链表架构、双阶段更新与 5 条核心机制
面试常问:为什么 useState 不能在条件语句里调用?
答案藏在 React Hooks 的底层实现里——它是一条单向链表,React 靠"调用顺序"把状态和 Hook 节点一一对应。这篇我们一起拆源码:Hook 链表结构、Mount/Update 双阶段、useState/useEffect 实现原理、Hooks 规则的底层依据。
React Hooks 是 React 16.8 引入的功能,它允许函数组件使用状态和其他 React 特性,无需编写类组件。Hooks 提供了一种更直接的 API 来访问 React 的核心概念:状态、生命周期、上下文等。
理解 Hooks 的关键,是明白它和类组件的本质差异:类组件把状态和方法挂在 this 上,天然按实例组织;函数组件没有 this,每次渲染都是一次全新的函数调用,所以 React 必须有一套机制在"多次渲染之间"记住每个 Hook 的状态——这套机制就是链表。
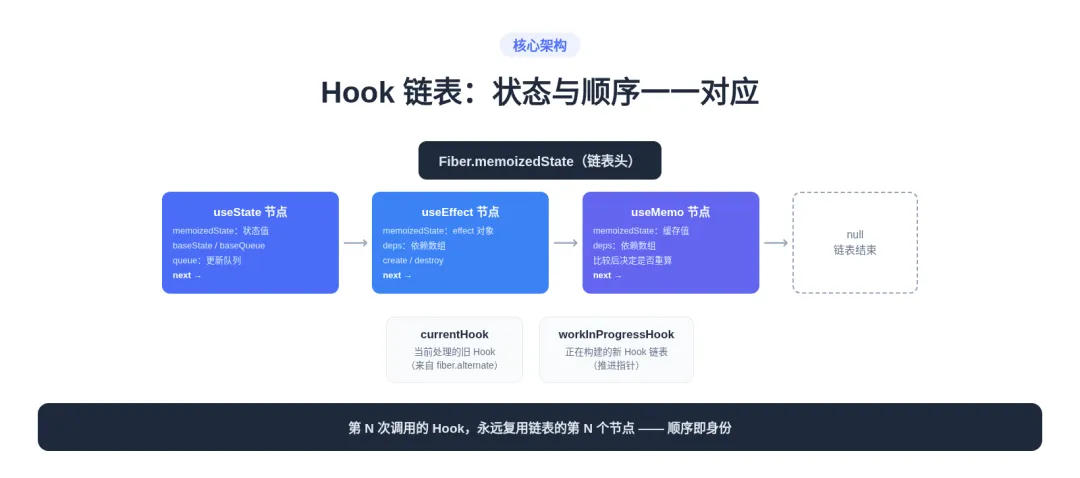
React Hooks 的底层实现基于链表数据结构。每个 Hook 都是链表中的一个节点,包含当前状态和指向下一个 Hook 的引用。每个 Hook 节点包含以下核心字段:
对应到源码,Hook 节点类型定义如下:
export type Hook = {
memoizedState: any,
baseState: any,
baseQueue: Update<any, any> | null,
queue: any,
next: Hook | null,
};
React 使用两个全局变量来管理这条链表:currentHook 指向当前正在处理的 Hook,workInProgressHook 指向正在构建的新 Hook 链表。渲染过程中,组件 fiber 的 memoizedState 字段就持有这条链表的头节点。
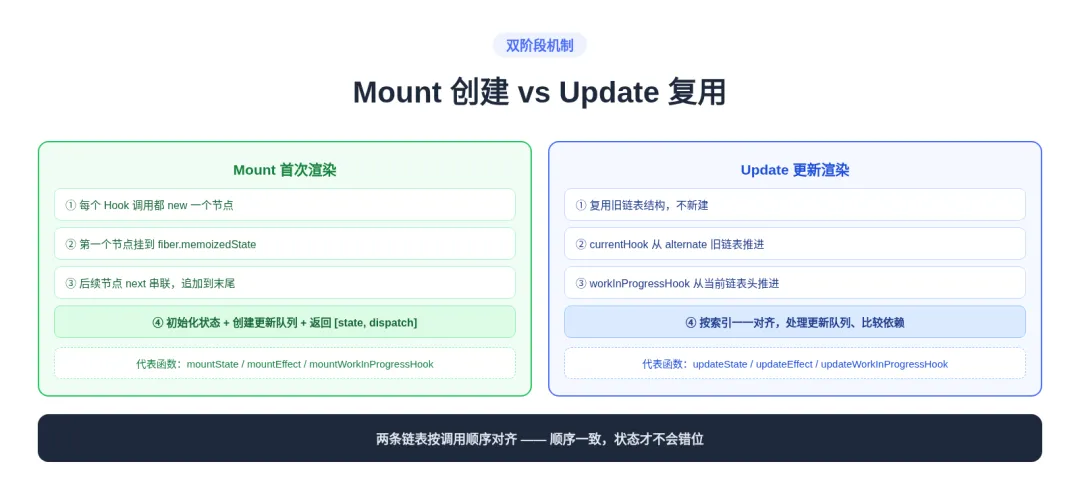
Mount 阶段(首次渲染):每个 Hook 调用都会创建一个新的 Hook 节点,追加到链表末尾。首次调用时头节点挂在 fiber 的 memoizedState 上:
function mountWorkInProgressHook(): Hook {
const hook: Hook = {
memoizedState: null, baseState: null,
baseQueue: null, queue: null, next: null,
};
if (workInProgressHook === null) {
// 第一个 Hook:挂到 fiber.memoizedState
currentlyRenderingFiber.memoizedState = workInProgressHook = hook;
} else {
// 追加到链表末尾
workInProgressHook = workInProgressHook.next = hook;
}
return workInProgressHook;
}
Update 阶段(更新渲染):React 复用现有的 Hook 链表结构。currentHook 为空时从 fiber.alternate 上取旧链表头,否则取 currentHook.next;workInProgressHook 同理从当前 fiber 的 memoizedState 开始依次推进——两条链表按索引一一对齐,保证 Hook 调用顺序一致。
状态管理类:useState。Mount 阶段创建 Hook 节点、初始化状态(支持函数式懒初始化)、创建更新队列,并返回状态值和 dispatch 函数;dispatch 通过闭包绑定 fiber 和 queue,触发更新时把 action 推入更新队列:
function mountState(initialState) {
const hook = mountStateImpl(initialState);
const queue = hook.queue;
const dispatch = dispatchSetState.bind(
null, currentlyRenderingFiber, queue,
);
queue.dispatch = dispatch;
return [hook.memoizedState, dispatch];
}
Update 阶段则调用 updateReducer(basicStateReducer)处理待更新队列、计算新状态。一个值得记住的实现细节:useState 内部就是基于 useReducer 实现的——useReducer 是更通用的版本。
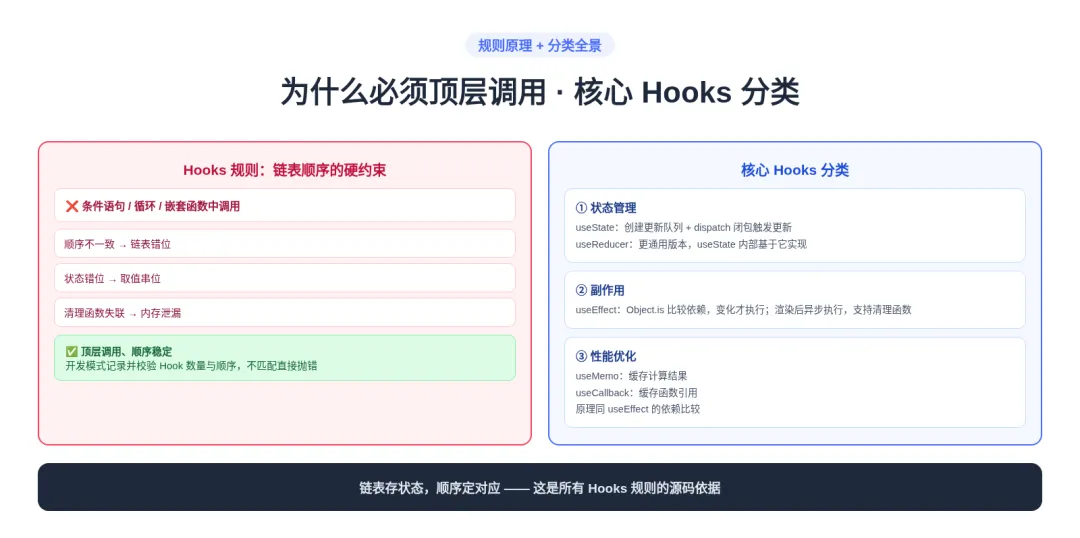
副作用类:useEffect。Mount 阶段创建 effect 并把它推入 effect 链表,同时给 fiber 打上副作用标记;Update 阶段用 Object.is 逐项比较依赖数组,依赖变了才重新执行 effect,没变则跳过。Effect 在组件渲染完成后异步执行,且支持返回清理函数,在下次执行前或组件卸载时调用。
为什么 Hooks 必须在函数组件顶层调用?因为 Hooks 基于链表实现,React 依赖 Hook 的调用顺序把状态与 Hook 节点一一对应。如果 Hook 出现在条件语句、循环或嵌套函数里,会导致三类问题:
开发环境下,React 会记录每次渲染的 Hook 调用顺序,并在后续渲染中验证一致性,一旦发现不匹配直接抛出错误(如 "Rendered more hooks than during the previous render")。
性能优化:useMemo / useCallback。useMemo 缓存计算结果、useCallback 缓存函数引用,实现原理类似 useEffect——通过比较依赖项数组决定是否重新计算或重建引用。不同的是它们不走副作用调度,而是在渲染阶段直接返回缓存值。
六个必背考点
Hook 链表结构(每个 Hook 是链表节点,含 memoizedState / baseState / queue / next);Mount vs Update 双阶段逻辑;useState 通过 dispatch 闭包触发更新、内部基于 useReducer;useEffect 异步执行与清理机制(Object.is 比较依赖);Hooks 规则源于链表顺序依赖;useMemo / useCallback 依赖比较原理。
Q1:React 是怎么保证每次渲染中 Hook 的状态不错位的?
靠链表的顺序对齐。每个 fiber 的 memoizedState 持有 Hook 链表头,渲染时用 workInProgressHook 从链表头开始逐个推进;更新时 currentHook 从 fiber.alternate 的旧链表头开始,两条链表按索引一一对应。只要每次渲染调用顺序一致,第 N 个 Hook 永远复用第 N 个节点,状态自然不错位。这也是 Hooks 规则(顶层调用、顺序稳定)的底层原因。
Q2:为什么 useState 不能在条件语句里调用?从源码角度讲。
条件为真时这个 Hook 被调用、链表多一个节点;条件为假时不调用、链表少一个节点。下次渲染时 workInProgressHook 按新顺序对齐旧链表,后续所有 Hook 的状态全部错位——比如第二个 useState 可能读到第一个的旧状态。React 在开发模式用 Hook 数量校验捕获这个问题,直接抛错;但生产环境没有校验,表现就是状态错乱、数据串位。所以规则不是约定俗成,而是链表实现的硬约束。
落地总结
Hooks 的源码主线就是一条链表加两个阶段:链表存状态,顺序定对应;Mount 建节点,Update 对齐复用;useState 走更新队列,useEffect 比较依赖异步执行。面试时把"链表 + 顺序"这条主线讲清楚,再用条件调用导致的错位场景举例,源码题就能答出深度。
关注我们,一起把技术讲明白(寻码札记)