ARTICLE · 1164939
AI 说我的App 有近亿市场,我重算后只剩五十分之一
我一直是这样。直到我无意中看到三个字:费米估计。
那天我顺手让它算了一下我自己 App 的潜在市场。算完我愣住了。不是因为数字,是因为它拆问题的那个动作——拆解、估数量级、再乘回去——我做了太多年,从本科读应用物理开始就在做,可我从来不知道,这个动作早就有正式的名字。
于是就有了这篇。前半篇讲费米估计怎么帮我把一个"近亿市场"砍到只剩五十分之一;后半篇顺着它往下摸,摸出一整张思维地图——你会发现,你收藏过的那些"思维模型大全",一大半其实是一家人。
如果你也读过点理工科,或者只是喜欢把问题想清楚,这篇是写给你的。
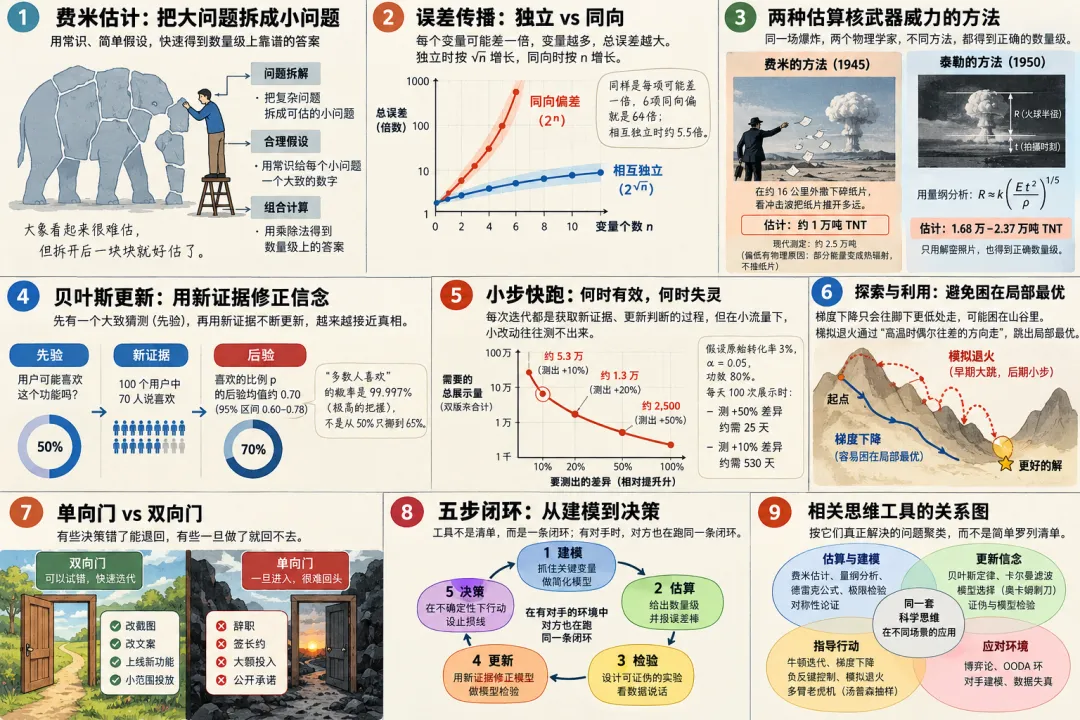
01 费米估计:为什么"瞎猜"能猜准,又在哪里会翻车
我问你一个问题:芝加哥有多少个专门调钢琴的师傅?
不知道,对吧。正常人也答不上来。
但费米估计说:别急着答,先拆。
芝加哥人的费米拆法
芝加哥大约有 900 万人(这是大都会区口径,市区约 270 万,这里用近似的 900 万)。
平均每户 2 人,所以大约 450 万户。
假设每 20 户里有 1 户会定期请人调琴,也就是约 22.5 万台钢琴需要调音。
这些钢琴平均一年调一次,一年就是 22.5 万次服务。
一个调音师每次上门(含路上时间)大约 2 小时;每天工作 8 小时、每周 5 天、每年 50 周,一年能调大约 1000 次琴。
22.5 万除以 1000——约 225 位调音师。
实际芝加哥的调音师大约 290 人。不精确,但数量级完全吻合。
这就是费米估计:把一个大到没法下手的问题,拆成几个小到有感觉的问题,各自估一个数,再乘回去。
它灵,不是因为误差会互相抵消
网上流传的说法是"变量越多,误差越稳定"——这话是错的。
拆开之后能估准,是因为每一项都比整体好估得多。芝加哥有多少调音师不好猜,但"多少户人家""多少户会买钢琴""一架钢琴多久调一次",每一项你都有一点感觉。
误差只在各项相互独立时才部分抵消;一旦同向偏,它会成倍放大。
两个物理学家,同一场爆炸
1945 年特里尼蒂核试验,费米在十六公里外撒了一把碎纸片,看冲击波把纸片推开多远,当场估出当量约一万吨 TNT。现代放射化学测定约 2.5 万吨——他估到四成,偏低有物理原因:一部分能量变成了热辐射,根本没去推纸片。
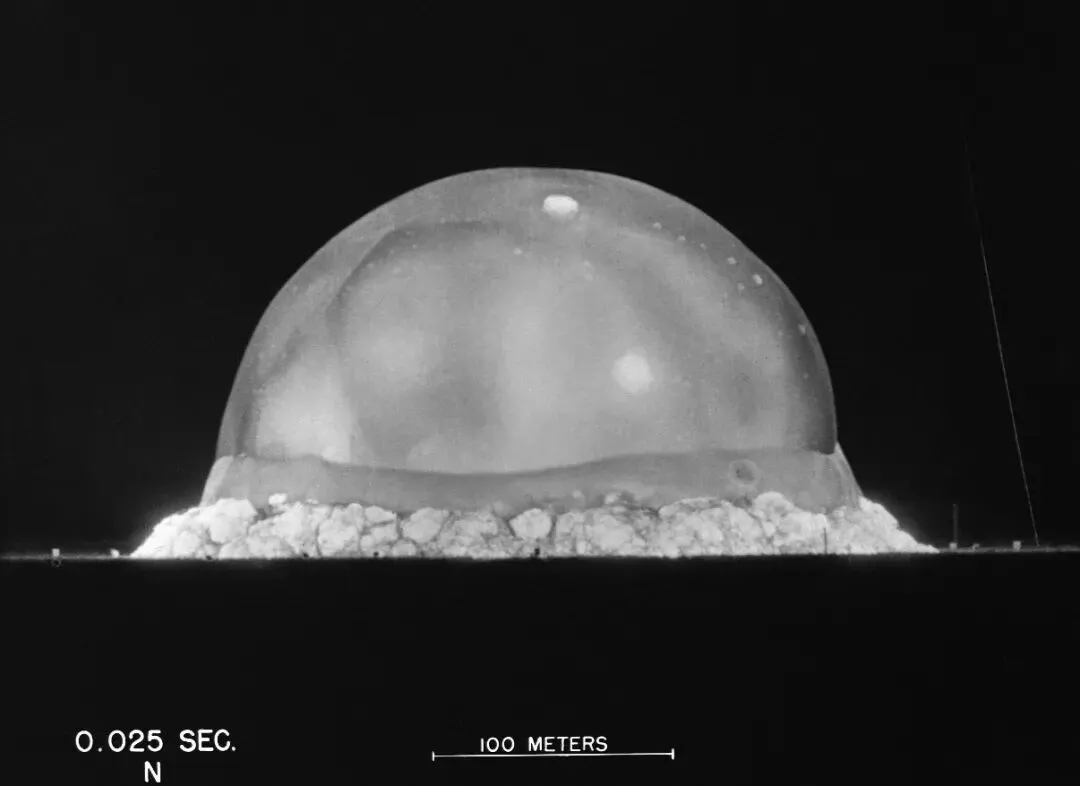
五年后,英国物理学家泰勒手里只有几张解密照片:火球半径和拍摄时刻。他用量纲分析论证,半径只能由能量 E、时间 t、空气密度 ρ 决定,单位一凑,公式只剩一种写法:
R ≈ k·(E·t²/ρ)^(1/5)
他由此估出 1.68 万到 2.37 万吨。
一个靠拆解,一个靠单位约束。都没有精确数据,都落在正确的数量级上。
误差在对数里走路
假设每一项都可能差一倍。6 项误差相互独立时,总误差约为 2 的根号 6 次方,也就是 5.5 倍;6 项同向偏时,是 2 的 6 次方,64 倍。
模拟 40 万次的结果:独立时,结果落在真值 10 倍以内的概率约 83%;同向时,只有 42%。
这两条线之间的距离,就是"各项误差互相独立"这个假设值多少钱。
所以真正的收益不在"抵消",在拆解本身。你对"有多少户人家"的把握,远好于对"有多少调音师"的把握。
它有三种翻车方式
一是误差同向。估自己的生意时,乐观是系统性的:渗透率、留存、付费率往往一起往好里猜,误差相乘而不抵消。下面那个案例就栽在这。
二是某一项连数量级都不知道。德雷克公式里"生命出现的概率"可能差几十个数量级。Sandberg 等人 2018 年把点估计换成概率分布后,算出银河系里只有我们的先验概率约 52%——所谓"费米悖论",大半是点估计制造的假确定性。
三是肥尾分布。收入、下载量服从幂律,平均数几乎没有代表性。用行业平均 ARPU 估一个新 App 的收入,就像用全国人均存款估一个路人的存款。
超级预测者的处方一模一样。Tetlock 的十条戒律里,第二条是把难题拆成可估的子问题;第三条紧跟着说:先问"这类事通常多久发生一次",再用细节去调整。
拆开看是个好习惯,但拆完不检查独立性和量级,它照样能给你一个很自信的错答案。
02 案例陷阱:AI 说我有近亿市场,我重算后只剩五十分之一
回到开头。AI 用费米估计告诉我:按 20-20-20 法则做护眼提醒的 App,在中国一年有 0.4 亿到 1 亿元的市场。
(20-20-20 法则:每用眼 20 分钟,看 20 英尺、约 6 米外的东西 20 秒。)
数字很好听。但物理背景的我,第一反应不是高兴,是两个问题:误差棒有多宽?如果它错了,我怎么会知道?
AI 的拆法本身没问题
14 亿人 → 5.6 亿重度用屏 → 6000 万到 8000 万有护眼意愿 → 600 万到 800 万下载 → 180 万到 240 万长期活跃 → 每人每年贡献 20 到 40 元。
每一步都合理。问题在于,有三个假设同时往好里偏。
只修正这三处同向的乐观假设:700 万次下载里 iPhone 约 140 万;2.2% 付费约 3 万人;年费 68 元、首年续订 44%,一个付费用户总共贡献约 120 元。这池下载按三年攒成,每年约 125 万元。
不到原估计中值的五十分之一。原估计的下限 3600 万元,在 100 万次模拟里只出现了约 0.1%。
每个参数换成一个区间,再跑 100 万次蒙特卡洛:中位数 125 万元一年,80% 区间 30 万到 520 万元。
同向误差不会抵消,所以要把区间摆出来,而不是只报一个点。
品类天花板,不是我的收入
外部视角要问的不是"市场多大",而是"像我这样的 App,通常第一年挣多少"。
RevenueCat 的统计里,新上线的订阅 App 第一年收入,前 5% 约 8,888 美元,后 25% 不超过 19 美元,头尾相差 400 多倍。
证据本身也在提醒同一件事。一项 2022 年的研究让 29 名有症状的电脑用户按 20-20-20 提醒休息两周,眼疲劳和干眼症状都减轻了;但停用一周后,效果就消失了。护眼 App 的价值只在持续使用时存在,而这个品类 30 日留存约 3%——产品有没有效,和生意能不能留住人,是同一个问题。
替代品还在旁边。iPhone 自带的"屏幕距离"从 iOS 17 起就在"屏幕使用时间"里,手机长时间离眼睛不到 30 厘米就提醒,而且免费。
一个漂亮的数字,和一条可以被推翻的预测,中间隔着三个假设的检查。
03 顺藤摸瓜:费米估计的亲戚,比你想象的多
算完那个数字,我起了一身鸡皮疙瘩——不是因为它准,是因为它太熟了。
我一直在用这套东西,却不知道它叫费米估计。于是我就想:那别的呢?我平时那些"凭直觉就这么做了"的思维,是不是也早有名字?
顺着摸下去,果然。它们大体归成两族。
第一族:一次性合理估算
费米估计是老大。往下是同门的:德雷克公式(估算银河系里可能的外星文明数量)、量纲分析(不用做实验,先看单位能不能凑对)、极限情况检验(把变量推向极端值,看结果符不符合常识)、对称性论证(抓主要结构,忽略次要细节)、包络估算(工程师版,一张信封背面就算完)。
共同点:信息不全,用简化模型做静态的数量级猜测。大多数直接源自物理学。
第二族:误差反馈迭代
这个家族更大。核心是贝叶斯定律——先有个大概的猜测(先验),每拿到一条新信息就用它修正(后验),后验又成为下一次的先验,循环往复,越来越逼近真相。
同一个骨架的,还有卡尔曼滤波(导航、卫星轨道估计)、牛顿迭代法(数值求解)、梯度下降(机器学习)、负反馈控制(空调温控器)。它们共用一个结构:
当前估计 → 获取新信息/误差 → 修正 → 更接近真相的新估计 → 循环
而"小步快跑,快速迭代"、精益创业的"构建-测量-学习"、PDCA、OODA——这些管理学的词,本质上是同一个误差反馈闭环,只是披上了商业语言的外衣。
我的 App 就是这么干的
我做App,一开始就是拍脑袋定个方向,上线一个简陋版本,看数据,改,再上线。我一直以为这叫"敏捷"。
后来才反应过来:这不就是贝叶斯更新吗?我把"用户喜不喜欢这个功能"当成一个信念,每一次版本迭代都是一次证据采集,用它去修正我的判断。版本迭代得越快,我获取证据、修正信念的频率就越高。
原来我做的不只是敏捷开发,是贝叶斯理念的应用。
这里有个我踩过的坑,值得单独说
我一开始以为"小步快跑"是个万能的正确答案。但把贝叶斯真正算一遍,会发现它只对了一半。
先把原对话里一个算错的例子修掉。它说:先验"用户 50% 可能喜欢",100 个用户里 70 人说喜欢,于是更新到"65% 左右"。这个数是编的,还把两件事混在了一起:一是喜欢的用户比例 p,二是"多数人喜欢"这个判断有多可信。
用均匀先验算,p 的后验均值约 0.70,95% 区间 0.60 到 0.78;"多数人喜欢"的概率是 99.997%。哪怕先验很保守,相当于事先已见过 50 人喜欢、50 人不喜欢,这个概率也有 99.8%。从 50% 只挪到 65%,不是谨慎,是更新不足。
真正的风险不在算术,在样本:这 100 个人是谁?早期用户多半是朋友、粉丝和同类人。似然函数错了,后验算得再精确也是错的——贝叶斯修不了有偏的样本。
信什么,不等于做什么
把"小步快跑"形式化,更贴切的模型是多臂老虎机:几台老虎机胜率未知,每拉一次杆既是赚钱也是学习。1933 年提出的汤普森抽样给了一个漂亮的解法:按"这台机器是最好的"后验概率去分配拉杆次数。
推论很朴素:臂越多、每个臂拉得越少,越分不清谁好谁坏。我电脑里有 13 个项目文件夹,就是 13 个只拉过几次的臂。
小步会被噪声淹没
假设产品页转化率 3%。要有 80% 的把握测出 +50% 的差异,原版和新版各需约 2,500 次展示;要测 +10%,各需约 5.3 万次。
对小流量产品,"小步"的改动在统计上是隐形的——你以为在迭代,其实在噪声里打转。
正确的打法是"小成本、大步幅":一次只试预期差异足够大的方案。想在一个测试周期里看到结论,要么把改动做大,要么先把展示量做上去。
小步会困在局部最优
梯度下降最著名的失败,就是只会往脚下更低处走,困在山谷里出不来。
物理学的解法是模拟退火(Kirkpatrick 等,1983):像金属退火一样,早期"温度"高,允许偶尔往更差的方向走,跳出当前山谷;温度慢慢降下来,再转为小步收敛。早期大跳、后期小步,正是探索与利用的时间表。
有些门只能进一次
小步快跑的前提是可逆,错了能退回来。辞职、签长约、公开承诺这类单向门,迭代的代价就是全部代价,应该慢下来想;改截图、改文案这类双向门,想太久才是浪费。
你收藏的"思维模型大全",一大半是一家人。
这不是说它们没用,是说它们没必要各占一行。认清骨架,你才知道哪一把钥匙开哪一把锁。
04 重新归类:所有工具,最后都在回答同一个问题
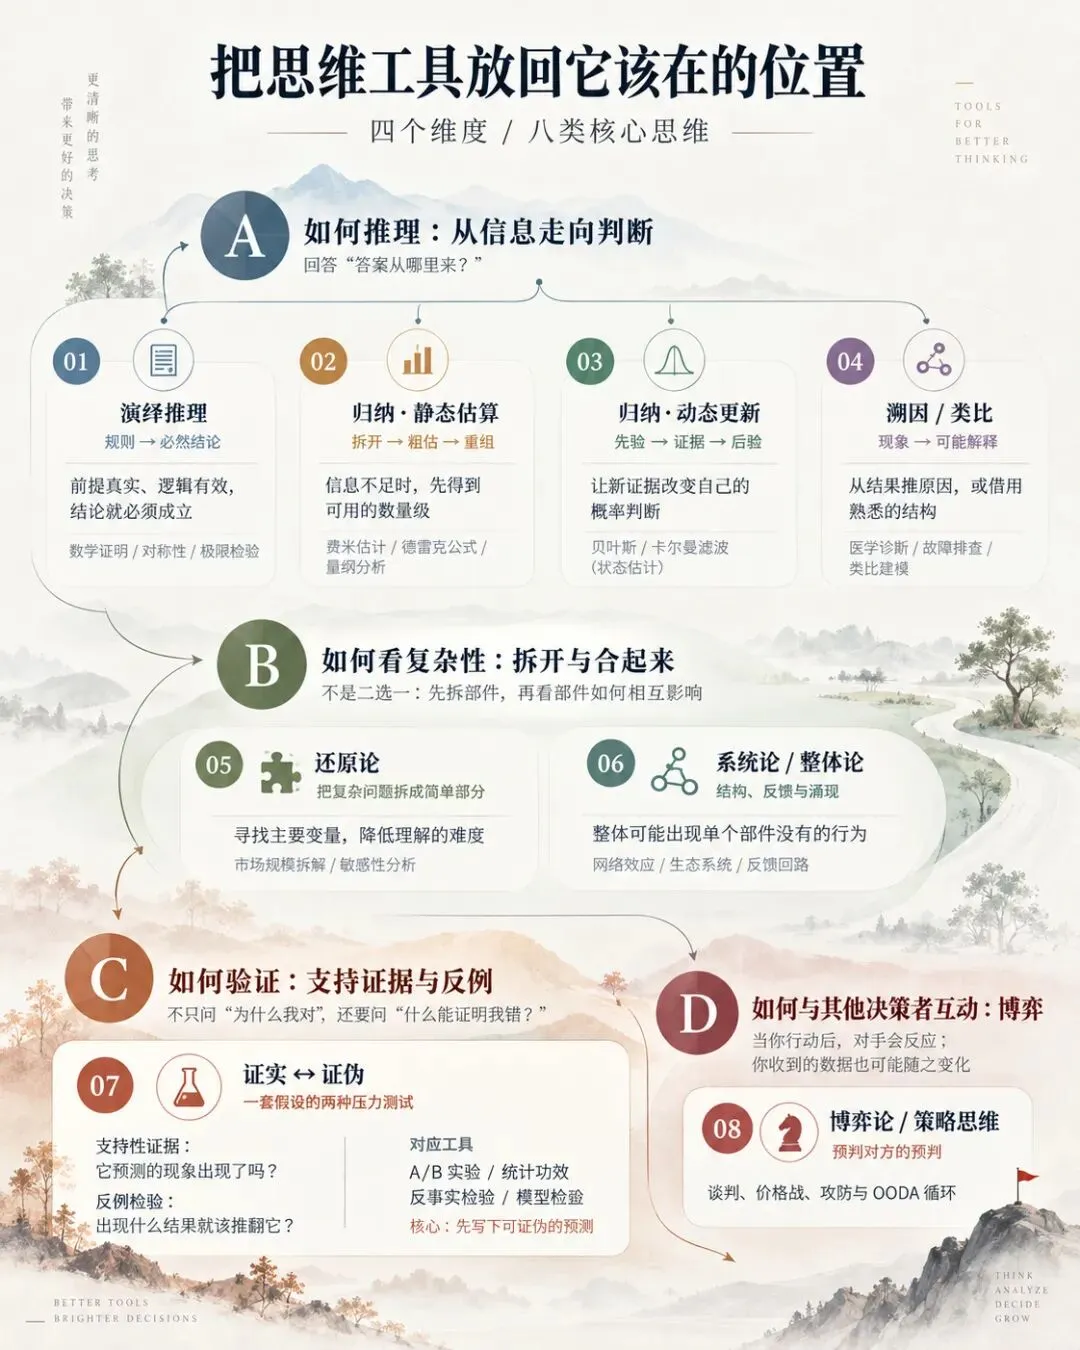
顺着往下摸,会发现传统分类是乱的。演绎、归纳、溯因,还原与系统,证实与证伪,再加博弈——听着很全,但不好用。
原对话最后按推理形式分类。按"它在帮你干哪一步活"来分更好用:
建模、估算、检验、更新、决策。
有对手时,对方也在跑同一条闭环。
每一环都配着一个"我错了怎么知道"的检查:建模查量纲和极限,估算报误差棒,检验写下推翻条件,更新做模型检验,决策设止损线。
按这张图回看原对话,有五处要挪位置。
奥卡姆剃刀归入"更新"。它可以由贝叶斯推出:复杂模型能解释的结果太多,分到每个结果上的概率就薄,自动吃亏。
证实和证伪不是两派。似然为零时,贝叶斯更新就是证伪;Gelman 和 Shalizi 认为,成功的贝叶斯实践本质上是"提出模型、检验、推翻、再改"。
牛顿迭代、梯度下降、负反馈归入"决策"。它们和贝叶斯共享闭环,但改的是动作和参数,不是信念;混成一家,就看不见上一节那些失灵。
OODA 环归入"博弈"。博伊德的要点是比对手更快转完这个环,它不是商业版的 PDCA。
二八法则并非与物理无关。它是幂律分布的经验版,而幂律和标度不变是统计物理的核心课题;第一节说的"平均数失效",根源就在这里。
做安全攻防的人对最后一环体会最深:你上线一条检测规则,攻击者就换手法。贝叶斯默认世界不理你,对手不是这样——在有对手的地方,数据会对你的模型做出反应。
顺便说三个被用坏的物理词
讲"物理思维"的文章很多,误用也很多。判断一个物理比喻值不值得信,用本文的老办法:它能推出什么可以被检验的结论?推不出来,就只是修辞。
熵增。热力学第二定律说的是孤立系统的熵不减。人、公司、城市都是开放系统,一直在吸收能量、向外排熵;薛定谔 1944 年在《生命是什么》里就说,生命以负熵为生。"人生熵增,所以要自律"是比喻,不是定律。
第一性原理。在物理和材料计算里,它指从量子力学基本方程出发、不依赖经验参数的计算。物理学家用它算完的第一件事,是拿去和实验对账;口号版的"第一性原理",却常被用来跳过对已有证据的检查。
量子。叠加和纠缠描述的是微观粒子的行为。"量子思维""量子管理"里,这两个词通常只负责让句子听起来更深。
工具不是清单,是一条闭环。
结尾:如果我错了,我怎么会知道
把这些工具摊开,它们最后都指向同一个问题:如果我错了,我怎么会知道?
费米估计要配误差棒,贝叶斯要配模型检验,"小步快跑"要配统计功效;少了这一步,它们都能给任何结论背书。
这篇的原材料是一次和 AI 的对话。AI 很会给出一个漂亮的数字;把数字变成一条可以被推翻的预测,是我自己的活。
写完这篇,我最大的收获不是学会了几个新词。是那种感觉——我用了十几年的直觉,终于在对的抽屉里,找到了自己的名字。
愿你也能找回那些你一直在用、却还不知道名字的直觉。它们一直都在,只是终于有人喊出了它们的名字。
延伸阅读
Philip Tetlock、Dan Gardner《超预测》:费米化、外部视角、按证据更新,在预测锦标赛里逐条检验过。 Brian Christian、Tom Griffiths《算法之美》:探索与利用、最优停止、模拟退火,写给普通人的版本。 E.T. Jaynes《概率论沉思录》:一位物理学家写的贝叶斯,把概率当作推理的逻辑。 P.W. Anderson,"More Is Different"(Science,1972):一位物理学家讲还原论的边界。
参考来源(文中数字均取自以下页面,公众号正文外链不可点,此处文字标注)
J.I. Katz,Fermi at Trinity 亚利桑那大学物理系,Estimating the Yield of the "Trinity" Atomic Explosion from Photographs Sandberg、Drexler、Ord,Dissolving the Fermi Paradox Good Judgment,Philip Tetlock's 10 Commandments of Superforecasting RevenueCat,State of Subscription Apps 2025 Business of Apps,Health & Fitness App Benchmarks 界面新闻,IDC 2025 年中国手机出货量 Contact Lens & Anterior Eye(2022),Testing the 20-20-20 rule Apple,What is Screen Distance? Gelman、Shalizi,Philosophy and the practice of Bayesian statistics
说明
文中涉及市场规模的数字均为估算,仅供交流参考,不构成任何经营或投资建议。文中将多种思维工具做了简化归类,是为了便于理解,现实中的边界比文中更模糊。