ARTICLE · 1166544
数完 92 个技能、4412 个插件,我才发现自己刚摸到 AI 的第三层
观点专题 · 2026 W42
数完 92 个技能、4412 个插件,我才发现自己刚摸到 AI 的第三层
Karpathy 的四层漏斗,和同一个上午发生的两件事
本期摘要 SUMMARY
同样一个 AI:75% 的人当聊天机器人,0.2% 的人见到它真正的样子。这篇拆漏斗为什么在收窄,以及普通人能够着的三个动作。
编者按
今天早上两条 AI 资讯放一起看,比单看任何一条都有意思。本篇不追热点,只借热点讲一个判断:你的结论,建立在哪个层级上。
观点专题 · ISSUE 42阅读时长 · 7 MIN
01 四层人四个世界02 漏斗为什么在收窄03 三个动作
今天早上我刷到两条 AI 资讯,放在一起看,特别有意思。
第一条,Karpathy 翻出今年 4 月的一条旧推,重新说了一遍:外界对 LLM 能力的共识差距,正在从「两群人各说各话」变成一个急剧收窄的漏斗。他特意强调,这个差距还在扩大。
第二条,一个叫 Brandon Thomas 的开发者,因为不满 Adobe 的订阅违约金,用 Claude Opus 5.5 以 Rust 逆向重写了 Photoshop 等 7 款 Adobe 软件,全部开源。其中一个 PS 项目不到 10 天拿了 4.6 万 Star,整个 REA 项目已经逼近 10 万。
这两条有什么关联?Karpathy 那条推里,恰好把「从二进制里反编译应用」列成了 0.2% 那一层人的日常操作。
一边是全网讨论「AI 到底行不行」,一边是有人已经用 AI 把商业软件的护城河拆了。同一个上午,同一个漏斗的两端。
注·逆向工程有清楚的法律红线,「净室设计」和「直接反编译」是两条不同的路。这里只陈述公开事实,不展开任何方法。
· · ·
01四层人,四个世界
Karpathy 用粗估的数字(他自己说是 napkin math,随手算的)把人群切成了四层。
第一层,约 60 亿人,全球人口的 75%。他们几乎没怎么接触过 LLM。
第二层,10 到 20 亿人,约 20%。免费版 ChatGPT 类产品的轻度用户。他们看到的是「笨笨的聊天机器人」,当一个更好用的谷歌、一个写作助手,偶尔试试让 agent 订个机票。我有非技术朋友说得挺直白:这东西对我真没什么用。平心而论,这么想没错。
但要注意,很多非数学、非代码行业的专业人士也在这一层。他们理智上知道 AI 在发生什么,理解却全是二手的、抽象的,因为他们的工作是花大量时间跟人说话。
第三层,约 2000 万人,0.2%。在数学和代码领域专业级使用前沿 LLM 的人。这一层的人亲眼看到:过去要干数周、数月的复杂项目,现在一个 prompt 交给 agent 就能完工。建应用、抄应用、翻译应用、从二进制反编译应用,全都发生在最近一两年。Karpathy 自己说,不到一年前,他还在手动敲代码,一个字符一个字符往编辑器里打。
第四层,约 5000 人,0.00006%。能用上内部前沿系统的人。外面看到的是预览版:成千上万个 agent 花数周协作软件巨型项目,铸造零日漏洞,机器速度地打网络攻防,发现新科学,推进数学前沿,这些过去要行业里最顶尖的专业人士干好几年。说实话,读到这一层我心里有点发毛。
而这一层已经开始冒出一个新问题:人类的审查和理解跟不上产出了。Karpathy 举了两个例子。OpenAI 和 HuggingFace 那档子事过去几个月了,人们还在「考古」;数学家盯着那 722 篇前沿数学手稿,估计得盯上一阵子。
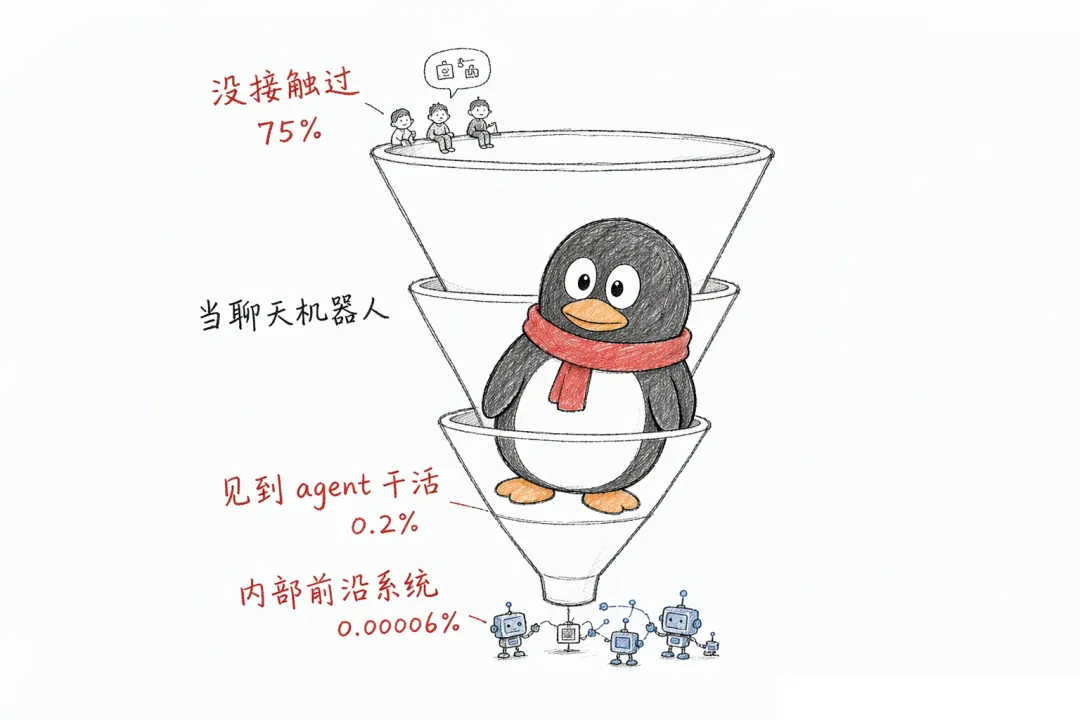
四层人活在同一个时间切片里,看到的是四个完全不同的世界。
· · ·
02漏斗为什么在收窄
Karpathy 给了三个驱动,我一个一个说,因为它们比数字本身更重要。
第一个,影响随野心、问题规模和时间跨度缩放。一段话就能回答的问题,压不动这套系统。你需要一池子又大又难、你真正在意的问题。这个因素驱动了「消费者 / 专业」这条轴上的分层。
第二个,能力是锯齿状的,峰值扎在数字的、可验证的、经济价值高的领域。因为 LLM 的能力来自可验证奖励的强化学习,训练环境是精心调配的,调配方向由收入潜力驱动。写作、建议、搜索这类任务,恰恰不在进步最猛的区域,它们既不好验证,也不像 to B 的代码活儿那么值钱。
第三个,访问层级。免费层、付费层、内部。你摸到哪一层,基本决定了你看见什么。
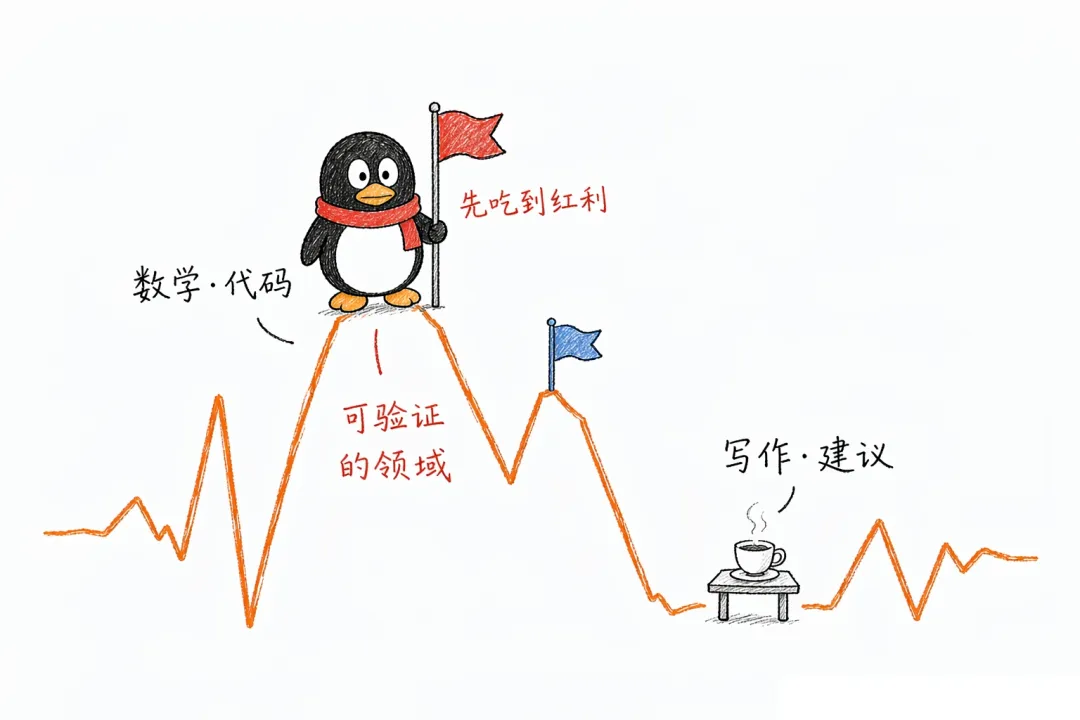
「你说『AI 不行』,很可能不是 AI 不行,是你问的问题太小、太不可验证、太不在意。」
—— 综合 Karpathy 三个驱动得出的判断
· · ·
03落到普通人身上的三个动作
我不是来贩卖焦虑的。Karpathy 讲的是顶尖圈层,但漏斗的机制,对每个想把 AI 用成生产力的人,都有三个实实在在的落点。
第一,做一次层级体检。说「AI 不行」之前,先问自己:我的结论建立在哪个层级上?去年试了三次免费版就下判断的人,和今年每月花 200 美元用 Codex、Claude Code 干真活的人,看到的是两个世界。Karpathy 四月的旧推说得更直白:很多人去年试了免费版,就让它定义了自己对 AI 的全部认知。这不是劝你花钱,而是说,判断要基于你实际用前沿工具干完过真活。
第二,把模糊任务改成有明确验收标准的任务。能力峰值在数字、可验证、有钱景的领域,这是明牌的。做内容的人怎么吃这个红利?我们自己的内容流水线就是这么干的:写稿、去 AI 味、出标题、封面、配图、排版、发布核验,每一步都有可验证的出口,排版 ERROR 必须为 0,发布后核验四条全 0 才算完。你给 AI 的任务「做完能验证对错」,它才敢往大了交。这也接得上我 10 月 1 日那篇《越提效越累》:净提效率 = 有用时间 ÷ 总节省时间,「可验证」就是把分子做实的办法。
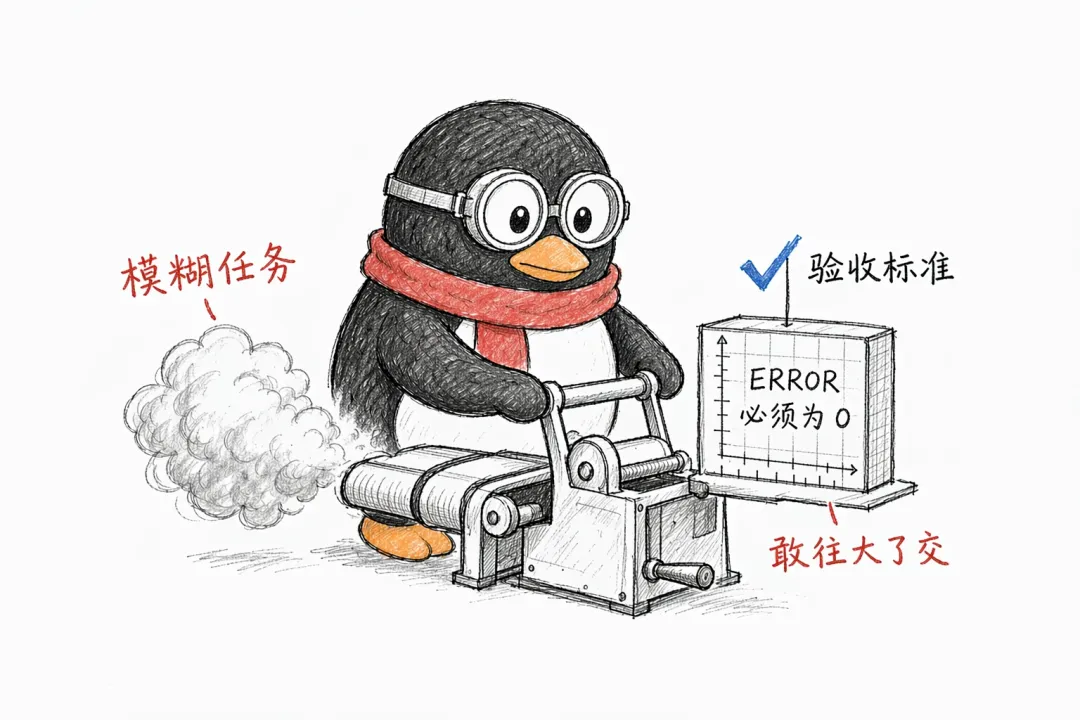
第三,攒一池你真在意的大问题。影响随野心缩放,没有大问题,前沿模型也就是个聊天框。我们的选题库、技能盘点、插件核查,本质上就是自己的「问题池」。我 10 月 6 日数过一遍,92 个技能、4412 个插件,能装进日常流水线的没几个,但「数」这个动作本身,就是在攒池子。一个人,加一池真问题,加一条可验证的流水线,差不多就是第三层的入场券。
还有一句提醒。第四层已经开始「人类审查跟不上产出」,第三层只会更快遇到这件事,验收纪律只会越来越值钱。我在写的下一篇就是这个话题:Google 的论文里,200 份实验摘要,只有 2 份肯承认自己的方法输了。
· · ·
∞结尾:三个问题,体检用
不用转发囤积,回答三个问题就行:
1.你上一次让 AI 干「以小时计、有明确验收标准」的活,是什么时候?
2.你的任务清单里,有多少是「做完能验证对错」的?
3.你手上有没有一堆你真在意、并且够大到能压动系统的问题?
三个都答不上来,说明你还在漏斗上层看风景。答上来哪怕一个,你就知道该往哪儿走了。
注·来源:Andrej Karpathy X 原帖(2026-10-12);Brandon Thomas / REA 项目据数字生命卡兹克(2026-10-12),均经 AI HOT 收录;Gartner 数据见本号 10 月 1 日《别人用 AI 越提效越累,我日更 3 条却不累》。
青灯墨染
「智驭视界」主理人,热衷于分享 AI 观察与实战干货。
如果这篇对你有启发,欢迎关注「智驭视界」。这里只拆 AI 实战里真用得上的东西,不追热闹。
关注「智驭视界」
智驭视界 · 内容原创 · 保留全部权利